一、上下文窗口是最大的隐形瓶颈
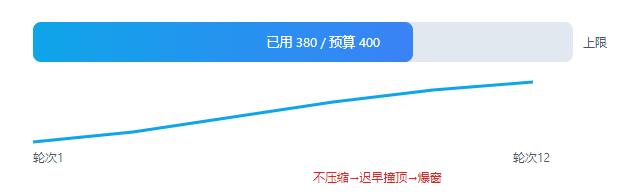
上篇立好了循环骨架,但有个现实问题马上出现:每转一轮,感知到的状态、推理过程、工具返回都会塞进上下文窗口。轮次一多,token 数蹭蹭往上涨,撞上模型上限后,要么直接报错,要么被迫截断------而截断往往正好砍掉最关键的早期信息。我把上下文窗口称为 Loop 工程里最大的隐形瓶颈:它不报错时你看不见,一报错就是整个任务崩。
我见过一个真实案例:一个客服 Agent 处理长对话,第 30 轮时窗口满,框架把最早的"用户身份"和"订单号"截断,Agent 随后把退款打给了错误账户。上下文不是抽象概念,管不好它会直接造成资损。所以记忆管理不是性能优化,是正确性保障------尤其在涉及身份、金额、权限的链路里,窗口里必须始终留着这些不可丢弃的锚点。
二、双层记忆:工作记忆 + 长期记忆
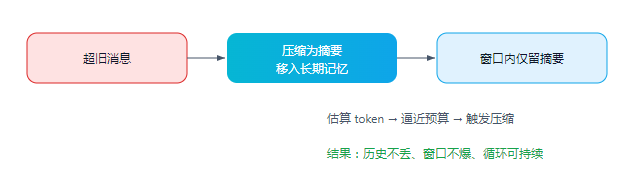
解决思路是双层记忆。把"近期、还要马上用"的内容留在工作记忆(直接进窗口);把"早期、已不重要细节"压缩成摘要,挪到长期记忆。下一轮推理时,窗口里只放工作记忆 + 长期记忆的摘要索引,既保留历史脉络,又不撑爆窗口。这和人脑很像:你不会把上周每天的对话逐字记着,只记得"那周在谈合同"的要点。
# -*- coding: utf-8 -*-
"""
agent_loop_context.py --- 上下文窗口与记忆管理
零依赖(仅标准库)。解决"轮次一多,上下文就爆"的真实痛点。

做法:
  - 用一个简单启发式估算 token 数(中文按字、英文按词,约 1 token/词)。
  - 维护"工作记忆"(近期消息)+"长期记忆"(压缩后的摘要)。
  - 当工作记忆逼近预算上限,把最旧的一批消息压缩成摘要存入长期记忆,
    从工作记忆中淘汰,腾出空间------这就是为什么循环能跑很久而不爆窗。

运行:
  python agent_loop_context.py
"""
BUDGET = 400  # 工作记忆 token 预算(演示用,真实模型约 8k~128k)


def est_tokens(text):
    # 极简估算:中文每字~1 token,英文/数字每连续词~1 token
    import re
    cjk = len(re.findall(r"[一-鿿]", text))
    en = len(re.findall(r"[a-zA-Z0-9]+", text))
    return cjk + en


class ContextManager:
    def __init__(self, budget=BUDGET):
        self.budget = budget
        self.working = []   # 最近消息
        self.long_term = [] # 压缩后的摘要

    def add(self, role, text):
        self.working.append({"role": role, "text": text})
        self._compact_if_needed()

    def _used(self):
        return sum(est_tokens(m["text"]) for m in self.working)

    def _compact_if_needed(self):
        while self._used() > self.budget and len(self.working) > 2:
            # 淘汰最旧的一条,压缩进长期记忆
            old = self.working.pop(0)
            summary = f"[摘要] {old['role']} 早期回合:{old['text'][:24]}..."
            self.long_term.append(summary)

    def snapshot(self):
        return {
            "working": len(self.working),
            "long_term": len(self.long_term),
            "used": self._used(),
            "budget": self.budget,
        }


def run():
    cm = ContextManager()
    print(f"上下文预算 = {BUDGET} tokens")
    # 模拟 12 轮对话,每轮约 60 token
    for i in range(1, 13):
        cm.add("user", f"第{i}轮:请查询订单{1000+i}的状态并核对物流信息明细")
        cm.add("agent", f"第{i}轮:订单{1000+i}已发货,预计明天送达,已记入工单")
        s = cm.snapshot()
        flag = "压缩中" if s["long_term"] else "充裕"
        print(f"  轮次{i:>2} 工作记忆={s['working']:>2}条 "
              f"长期记忆={s['long_term']:>2}条 已用={s['used']:>3}/{s['budget']} [{flag}]")
    print("\n最终:早期回合被压缩进长期记忆,工作记忆始终在预算内------")
    print("循环得以长期运行而不爆窗,且关键历史并未丢失,只是转为摘要。")


if __name__ == "__main__":
    run()
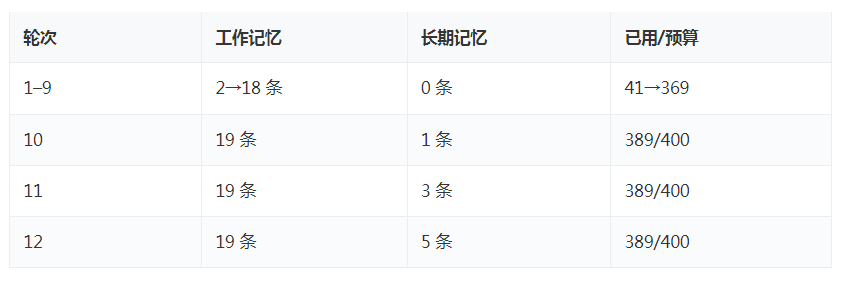
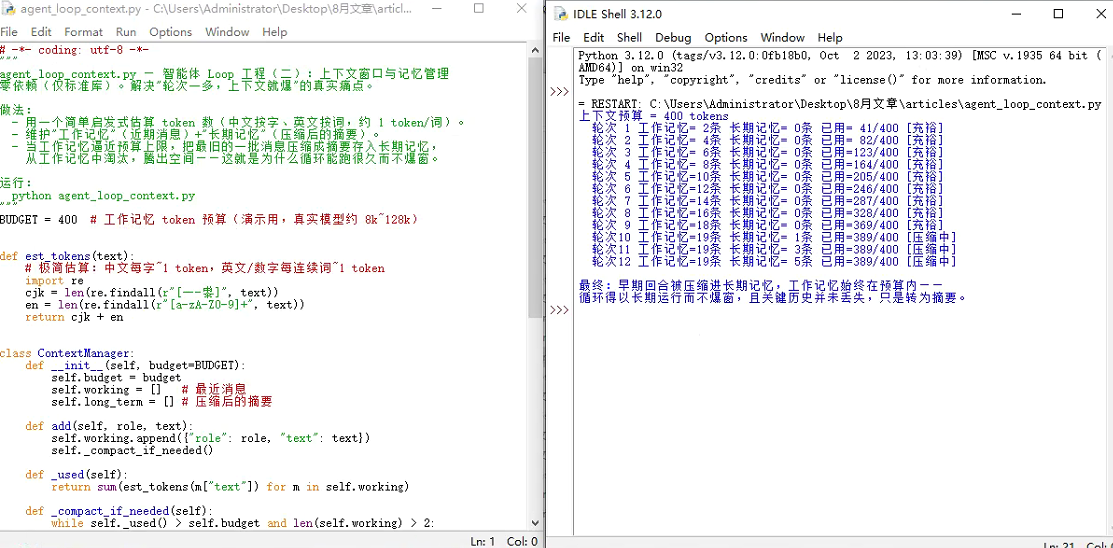
运行 python agent_loop_context.py 会模拟 12 轮对话。可以看到前 9 轮工作记忆线性增长,第 10 轮起触发压缩:最旧的消息被提炼成"摘要"存入长期记忆,工作记忆条数被压回稳定值,已用 token 始终不超过 400 预算。这正是"循环能长期跑而不爆窗"的工程秘密。
实际工程中,长期记忆往往不是"压缩全文",而是外接向量库:早期对话先切片入库,需要时再按当前问题检索最相关的几条回贴进窗口(即 RAG)。这比"全量压缩"更精准------Agent 只在当下真的需要某段历史时才把它拉回来,窗口利用率最高。demo 用摘要是为了让逻辑可见、可零依赖运行;生产里把摘要层换成检索层,思路完全一致。
避坑:压缩不是简单"删旧的"。要保留可回溯的锚点(如"第3轮决定了X"),否则长期记忆会变成没有出处的模糊印象,Agent 后期容易"记错前提"。摘要里最好带上轮次号和关键决策。
三、Token 估算与淘汰策略
压缩触发前要先"称体重"------也就是估算当前上下文的 token 数。生产环境用模型 tokenizer 最准;demo 用启发式(中文按字、英文按词)足以驱动逻辑。淘汰策略也有讲究:最简单的 FIFO(先进先出)按时间丢;更优的是按"重要性"丢(工具调用结果 > 闲聊),把有限窗口留给高价值信息。
一个进阶技巧是"分层预算":给系统提示、工具定义、近期对话、检索历史各划一块配额。哪块超了就在哪块内部先压缩,互不挤占。这样能保证"工具定义"永远在窗内(否则 Agent 根本不知道自己会什么),而闲聊可以最先被牺牲。分层预算把"记忆管理"从单点压缩升级成全局调度,是长任务 Agent 稳定运行的关键设计。
四、总结
上下文与记忆管理,是让循环"跑得久"的关键。用工作记忆+长期记忆双层结构,配合 token 估算和压缩淘汰,Agent 就能在有限窗口里保留无限历史的脉络。注意压缩要留锚点、淘汰要按重要性,别把关键前提弄丢。