LangGraph 面试复习总览
本文是 5 份本地 LangGraph Markdown 教程的面试版压缩笔记。目标不是替代教程,而是帮助你在面试中用一条稳定的主线回答:状态如何流动,流程如何控制,执行如何恢复,多个 Agent 如何组合,以及系统如何上线。
资料范围
- 输入源:
Day1到Day5共 5 份 Markdown 教程。 - 内容覆盖:LangGraph v1 基础图模型、状态与 Reducer、条件路由与并行、持久化与人在回路、多 Agent 与生产部署。
- 版本口径:教程中的 API 结论来自本地教程的实测记录;具体版本升级后,以官方文档和当前环境验证结果为准。
1. 60 秒总答
LangGraph 是什么
LangGraph 是一个面向有状态 Agent 和工作流的图运行时。它把流程拆成:
- State:节点之间共享、按字段流转的数据。
- Node:读取 State 并返回局部更新的 Python 函数。
- Edge:决定下一个执行节点,既可以是固定边,也可以是条件边。
- Runtime:负责调度、并行超步、流式输出、检查点、暂停恢复和错误边界。
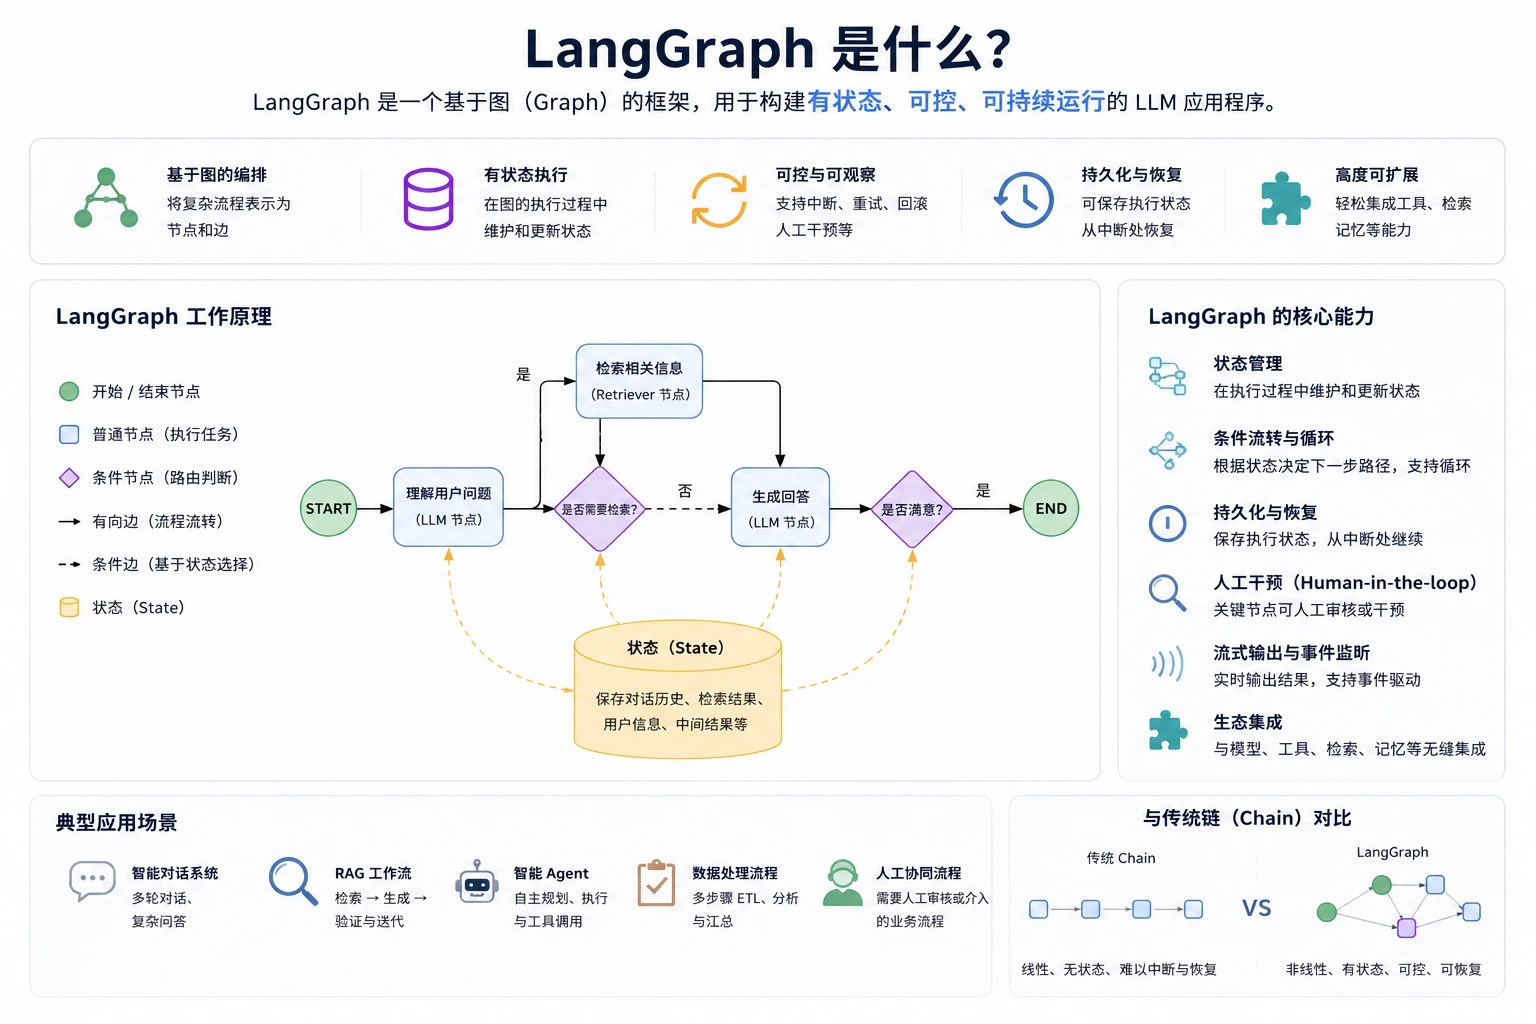
一句话概括:LangGraph 就是帮大模型写 "带判断、能循环、能中途暂停" 的办事流程的工具。 以前的 LangChain Chain 像一条只能往前走的直跑道;LangGraph 是可以分叉、绕圈、停下来等人干预的迷宫路线。
顶部:LangGraph 是什么
LangGraph 是一个框架,用来做大模型 AI 应用,它有几个特点:
- 基于图编排:把任务拆成一个个节点(办事步骤),节点之间画线代表怎么走
- 有状态执行:全程记着所有信息,不会做着做着忘记前面聊了啥
- 可控可观察:跑一半可以暂停、重来、回退,人可以插手改结果
- 持久化恢复:程序崩了,能从刚才中断的地方接着跑,不用从头再来
- 高度可扩展:很容易接上检索工具、数据库、记忆模块
中间:LangGraph 工作原理(流程图,重点!)
黄色的
State状态就像一个记事本,全程保存聊天记录、查到的资料、用户信息,所有节点都可以读、可以改这个本子。流程一步一步走:
- START 开始 → 【LLM 节点:理解用户问题】 AI 先看懂你想问啥,把信息写到记事本。
- 【菱形判断:是否需要检索资料?】
- ✅是:跑去检索节点,查资料,查到的内容写到记事本,然后回到这个判断点
- ❌否:直接跳到生成回答
- 【LLM 节点:生成回答】 AI 结合记事本里的内容写出答案。
- 【菱形判断:是否满意?】
- ✅是:结束 END
- ❌否:回到前面,重新理解问题,再来一遍(循环!)
图例小说明:
- 绿色圆圈:起点 / 终点
- 蓝色方框:干活的步骤(节点)
- 紫色菱形:做选择、判断分支
- 实线箭头:固定往下走
- 虚线箭头:读取 / 修改那个记事本(State 状态)
右侧:LangGraph 核心能力
- 状态管理:全程维护记事本,保存中间所有信息
- 条件流转与循环:可以判断,满足条件就循环跑,这就是 Agent 反复思考的基础
- 持久化与恢复:保存进度,中断之后继续跑
- 人工干预(Human-in-the-loop):流程跑到关键地方,可以停下来交给人审核,人确认完再继续
- 流式输出、事件监听:一边跑一边吐出结果,实时看运行情况
- 生态集成:轻松对接大模型、检索工具、记忆库
左下角:能用在哪些场景
- 智能对话:多轮聊天,复杂问答
- RAG:查资料→生成答案→反复校验迭代
- 智能 Agent:AI 自己规划任务,调用工具干活
- 数据处理:多步骤的数据清洗、汇总分析
- 人工协同流程:需要人中途审核的业务流程
右下角:对比传统 Chain
- 传统 Chain:一条直线,一步接一步,不能回头、没有记忆、不能中断,走完就结束。
- LangGraph:非线性,有分支、有循环,带着 "记事本",可以暂停、回退,可控。
最简单类比
传统 Chain:食堂流水线,菜按顺序走一遍,不能回头。 LangGraph:你派一个助理办事。 助理拿个记事本(State),接到问题先判断要不要查资料;写完答案还要检查行不行,不行就重新查、重新写;甚至做到一半喊你过来看看,你点头了再继续。
一句面试版回答:
LangGraph 用图来表达 Agent 的控制流,用 State 表达业务数据,用节点承载具体动作,用边表达顺序和路由。相比一串
if-else,它把状态更新、并行合并、暂停恢复和执行轨迹变成了可观察、可持久化的运行时语义。
五天压缩成一句话
Day 1 画图,Day 2 解释数据怎么合并,Day 3 控制流程怎么分支/循环/并行,Day 4 让流程能记住并等待人,Day 5 把 Agent 组合起来并部署。
最重要的六个词
| 词 | 面试中要说明什么 |
|---|---|
| State | 图中流转的业务数据,不是随手传参的黑盒字典 |
| Reducer | 同一字段多次写入时的合并规则 |
| Conditional edge | 根据状态选择下一条路径 |
| Send | 运行时动态创建多个并行 worker |
| Checkpointer | 把执行状态保存成可恢复的检查点 |
| Interrupt | 把控制权交给人,再用 Command 恢复 |
2. 五天知识地图
| 阶段 | 核心问题 | 关键 API | 能完成的项目 |
|---|---|---|---|
| Day 1 基础 | 怎么把流程画成可执行图 | StateGraph、START、END、add_node、add_edge、compile |
多节点文本处理流水线 |
| Day 2 状态 | 数据为什么覆盖、累加或冲突 | TypedDict、Annotated、Reducer、add_messages、RunnableConfig、stream_mode |
多源信息汇总 Agent |
| Day 3 控制流 | 流程如何选择、循环、并行和嵌套 | add_conditional_edges、recursion_limit、Subgraph、Send、Command |
研究管线、质量检查和重试 |
| Day 4 持久化 | 流程如何记忆、暂停、恢复 | checkpointer、thread_id、get_state、interrupt、update_state、@task |
带人工审批的发布工作流 |
| Day 5 生产化 | Agent 如何组合并部署 | create_agent、Supervisor、langgraph.json、langgraph dev、LangSmith |
多专家报告生成系统 |
更适合复述的依赖关系:
text
StateGraph
  -> State + Node + Edge
  -> Reducer 解决多次写入
  -> Conditional Edge / Send 解决动态控制
  -> Checkpointer + thread_id 解决跨调用状态
  -> interrupt + Command 解决人在回路
  -> Subgraph / create_agent 解决 Agent 组合
  -> langgraph.json + tracing 解决上线与运维
可单独渲染的知识地图见 assets/knowledge-map.mmd。
3. 核心心智模型
3.1 图的三要素
python
from typing_extensions import TypedDict
from langgraph.graph import StateGraph, START, END


class State(TypedDict):
    text: str
    summary: str


def summarize(state: State) -> dict:
    return {"summary": f"文本长度: {len(state['text'])}"}


builder = StateGraph(State)
builder.add_node("summarize", summarize)
builder.add_edge(START, "summarize")
builder.add_edge("summarize", END)

app = builder.compile()
result = app.invoke({"text": "hello", "summary": ""})
回答时不要只背 API,要说清职责:
StateGraph(State)声明图有哪些数据通道。add_node注册动作,不决定业务顺序。add_edge决定依赖和执行顺序。compile()把声明式图变成可调用对象,并做结构校验。invoke()适合拿最终结果,stream()适合观察过程。
3.2 节点不是"返回完整状态"
节点通常只返回本次要更新的字段:
python
def clean_node(state: State) -> dict:
    return {"text": state["text"].strip().lower()}
这叫"返回即更新":
- 返回的键会写回 State。
- 没返回的键保持原值。
- 不应直接依赖原地修改
state来表达更新。 - 默认写入语义是覆盖;想累积必须显式声明 Reducer。
3.3 建图、运行、排错三步
- 建图:先用纯函数节点验证拓扑和 State 字段。
- 运行 :用
invoke()验证最终值,用stream()验证每个节点到底写了什么。 - 排错:先查 State schema,再查节点返回键,再查边和 Reducer,最后才查模型提示词。
这个顺序能快速区分"流程错""数据合并错"和"模型输出错"。
4. State、Reducer 与数据流
4.1 默认覆盖 vs 显式合并
python
from operator import add
from typing import Annotated
from typing_extensions import TypedDict


class State(TypedDict):
    draft: str
logs: Annotated[list[str], add]| 场景 | 没有 Reducer | 配置 Reducer |
|---|---|---|
串行节点连续写 draft |
后写覆盖先写 | 按自定义规则合并 |
并行节点同时写 logs |
InvalidUpdateError |
按 Reducer 合并 |
| 消息列表 | 容易丢历史或误更新 | add_messages 支持追加、按 ID 更新和删除 |
Reducer 的统一视角:
python
def reducer(current_value, update_value):
    return new_value
面试一定要说出参数顺序是"旧值、新值",并解释为什么它是并行写入的确定性边界。
4.2 add_messages 与 MessagesState
消息状态不要简单使用普通列表拼接。add_messages 能处理:
- 新消息追加。
- 带相同 ID 的消息更新。
RemoveMessage删除已有消息。- 消息对象和简短字典形式的兼容。
python
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages


class ChatState(TypedDict):
    messages: Annotated[list, add_messages]
如果状态只有消息,可以使用官方预建的 MessagesState;如果还有业务字段,再显式扩展自己的 schema。
4.3 config 与 state 的分工
| 维度 | state |
config |
|---|---|---|
| 含义 | 流程中的业务数据 | 本次调用的运行时上下文 |
| 例子 | query、draft、messages |
thread_id、user_id、租户、运行参数 |
| 是否进入业务结果 | 通常会 | 通常不会 |
| 读取方式 | state["query"] |
config["configurable"]["user_id"] |
口诀:
state 是"流程正在处理什么",config 是"这次运行由谁、按什么方式处理"。
4.4 并行与超步
无依赖边的节点可以被放进同一个超步执行。多个节点在同一超步写同一个键时:
- 没有 Reducer:框架拒绝猜测,抛出并发更新错误。
- 有 Reducer:按明确规则合并。
- 串行写同一键:通常不会报错,但可能静默覆盖,仍然要检查业务语义。
因此看到"并行 + 共享字段",第一反应应该是检查该字段是否声明了正确 Reducer。
5. 控制流:分支、循环、子图和并行
5.1 固定边与条件边
固定边:
python
builder.add_edge("load", "transform")条件边:
python
def route(state: State) -> str:
    return "retry" if state["score"] < 0.8 else "finish"


builder.add_conditional_edges(
    "check",
    route,
    {"retry": "draft", "finish": END},
)
路由函数返回的是映射表中的 key,不一定是节点名。这样可以把"业务判断值"和"图节点命名"解耦。
5.2 循环与 recursion_limit
循环本质上是条件边回到上游节点:
text
draft -> check
  ^       |
  |-------+  score 不够
循环必须同时具备:
- 明确的业务退出条件。
- 运行时保险丝
recursion_limit。 - 达到上限时可识别、可恢复或可降级的错误处理。
recursion_limit 不能代替退出条件。它只是防止 bug、异常模型输出或数据污染把图无限运行下去。
5.3 Subgraph
子图是一个已经编译的图,可以作为父图的节点:
python
expert_app = expert_builder.compile()
parent_builder.add_node("researcher", expert_app)
它适合:
- 把复杂业务隔离成独立模块。
- 对专家图单独测试。
- 在父图中复用同一套流程。
- 让多 Agent 系统保持清晰边界。
父图和子图之间只有双方都声明的字段才能自然穿透。子图私有字段不会自动泄漏到父图;需要上报的字段要在两侧 schema 中对齐。
5.4 Send:动态 map-reduce
Send 适用于运行时才知道要创建多少 worker 的场景:
python
from langgraph.types import Send


def fan_out(state: State):
    return [
        Send("worker", {"item": item})
        for item in state["items"]
    ]
要点:
Send走条件边通道。- 第一个参数是目标节点名。
- 第二个参数是该 worker 的局部输入。
- 多个 worker 的结果通常要写入带 Reducer 的汇聚字段。
Send解决的是动态并行,不是普通固定边。
5.5 Command
Command 可以同时完成两件事:
- 更新 State。
- 指定下一步
goto。
这适合审批节点、动态分流节点和需要把判断结果与状态更新绑定在一起的流程。
python
from langgraph.types import Command


def decide(state: State) -> Command:
    if state["approved"]:
        return Command(goto="publish", update={"status": "approved"})
    return Command(goto="cancel", update={"status": "rejected"})
6. 持久化、人在回路与 durable execution
6.1 Checkpointer 与 thread_id
最小关系:
text
checkpointer = 状态账本
thread_id    = 账本钥匙
checkpoint   = 某个执行时刻的快照
编译时挂入 checkpointer,调用时提供线程 ID:
python
from langgraph.checkpoint.memory import InMemorySaver

app = builder.compile(checkpointer=InMemorySaver())
config = {"configurable": {"thread_id": "ticket-001"}}
app.invoke({"text": "hello"}, config)
关键边界:
- 没有 checkpointer:两次调用通常互相独立。
- 有 checkpointer 但没有
thread_id:运行时不知道读哪本账。 InMemorySaver适合课堂和测试,进程退出后数据会丢。- 生产场景需要持久后端,并验证跨进程恢复。
6.2 读取和改写检查点
常用观察接口:
get_state(config):查看当前快照。get_state_history(config):查看历史链。snapshot.values:快照中的状态值。snapshot.next:恢复时下一步要执行的节点。update_state(config, values, as_node=...):在断点处改写状态。
6.3 动态中断与静态断点
| 方式 | 写在哪里 | 适用场景 |
|---|---|---|
interrupt(payload) |
节点内部 | 运行到业务条件才请求人审批 |
interrupt_before |
编译/调用配置 | 不改节点代码,统一在危险节点前拦截 |
interrupt_after |
编译/调用配置 | 节点执行后先审查结果 |
动态审批的基本流程:
python
from langgraph.types import Command, interrupt


def ask_approval(state: State):
    decision = interrupt({
        "prompt": "是否发布?",
        "draft": state["draft"],
    })
    return {"approval": decision}


# 暂停后,由外部系统或人工决定:
app.invoke(Command(resume="approved"), config)
6.4 最容易答错的"恢复"语义
再次
invoke不是恢复;暂停后使用Command(resume=...)才是恢复路径。
原因是恢复时框架会从检查点重放流程。interrupt() 之前的节点代码可能再次经过,因此副作用不能裸写在中断前面。
推荐做法:
- 把外部请求、写文件、扣款、发送通知等副作用包进
@task。 - 把节点写成可重放、可观察、结果明确的单元。
- 对任务设置合适的 retry、timeout 和降级策略。
- 恢复时使用同一个编译后的 app 和同一个
thread_id。
6.5 @task 的生产含义
@task 不是"给函数加一个装饰器"这么简单,它是 durable execution 的执行单元。面试时要说清:
- checkpointer 保存进度。
thread_id标识一条执行链。@task保存副作用步骤的结果,重放时避免重复执行。
教程中的实测提醒:
@task(timeout=...)在当前教程环境中只对 async 任务有效。- sync / async 组合要以当前版本验证。
retry_policy解决可重试错误,不能掩盖永久性业务错误。- 降级比无限重试更重要。
7. Agent、多 Agent 与生产部署
7.1 create_agent 与手写 StateGraph
| 方式 | 优点 | 适合 |
|---|---|---|
create_agent |
快速得到模型与工具循环,默认行为完整 | 标准 Agent、快速原型 |
手写 StateGraph |
每个节点、边、状态和审批点都可控 | 复杂业务流程、并行、精细治理 |
| 子图 + 父图 | 模块化、可复用、可单测 | 多 Agent 和领域专家组合 |
推荐表述:
create_agent是高层入口,底层仍然可以理解为 LangGraph 的状态图。标准 Agent 先用高层入口提高开发速度;需要控制循环、并行、审批或特殊状态时,再下钻到手写StateGraph。
旧资料中的 create_react_agent 需要谨慎对待。教程记录它已被 create_agent 取代,新项目应优先采用当前官方入口。
7.2 三种多 Agent 协作模式
模式 A:子图作为节点
父图直接挂载专家子图:
python
parent_builder.add_node("researcher", researcher_app)
parent_builder.add_node("writer", writer_app)
优点是边界清晰、图可视化、专家可独立测试。
模式 B:Supervisor
主编或协调 Agent 负责决定下一位专家:
text
supervisor -> researcher -> supervisor
                     -> writer -> supervisor
                     -> finish
适合任务顺序不固定、需要动态派单的场景。代价是协调逻辑和上下文传递更复杂。
模式 C:把专家包装成工具
把专家 Agent 暴露成工具,由模型自主决定是否调用。灵活,但必须明确:
- 专家输入输出格式。
- 上下文是否完整。
- 失败和超时如何回传。
- 什么时候应该改成显式子图以获得更强控制。
7.3 langgraph.json
部署清单至少要让平台知道三件事:
| 字段 | 作用 |
|---|---|
dependencies |
安装哪些 Python 包 |
graphs |
对外暴露哪些图,格式通常是 文件路径:导出变量 |
env |
需要注入哪些环境变量 |
常见坑:
graphs写了module:graph,但模块中没有真正导出graph。- 把
langgraph主包和 CLI 混为一谈,langgraph dev可能需要单独安装 CLI。 - 本地能导入不代表部署环境依赖完整。
InMemorySaver能演示,不等于生产可用。
部署排查顺序:
- 先本地 import 目标模块。
- 再验证
graphs指向的对象存在。 - 再检查依赖和环境变量。
- 最后运行本地 dev 服务和真实 API 调用。
7.4 生产级设计检查
- 小节点:一个节点做一件容易观察和重试的事。
- Reducer:所有可能被多处写入的字段都明确合并规则。
- 流式:长任务优先提供
stream,尽早反馈进度。 - 持久化:审批、长任务和跨进程恢复不能依赖内存保存。
- 容错:重试、超时、降级和人工接管要有明确边界。
- 可观测:记录节点耗时、模型调用、token、重试和错误上下文。
- 测试:先测试纯函数节点,再测试图拓扑,最后测试模型和外部服务。
8. 高频面试题与答题要点
Q1:LangGraph 和 LangChain 是什么关系?
答题要点:
- LangChain 更偏模型、工具、消息和 Agent 组件。
- LangGraph 更偏有状态流程的图运行时。
- LangChain 的模型或工具可以作为 LangGraph 节点使用。
- 真实项目通常是两者组合,而不是二选一。
Q2:State、Node、Edge 分别负责什么?
答题要点:
- State 定义共享数据和字段语义。
- Node 做动作并返回局部更新。
- Edge 表达依赖、顺序和路由。
- 运行时负责调度、合并、流式和持久化。
Q3:为什么节点返回 dict,而不是直接修改 state?
答题要点:
- 返回局部更新让框架知道本次写了哪些字段。
- 没返回的字段可以保持不变。
- 显式更新更容易做检查点、重放、流式和审计。
- 原地修改会模糊写入边界,也容易引入副作用。
Q4:字段默认是覆盖还是累积?
答题要点:
- 默认覆盖。
- 需要累积时用
Annotated[field_type, reducer]。 messages通常用add_messages。- Reducer 的签名是
(current, update) -> new。
Q5:两个并行节点同时写一个没有 Reducer 的字段会怎样?
答题要点:
- 同一超步发生多个更新,框架无法判断合并顺序。
- 会抛出并发更新错误,而不是随机选择一个结果。
- 给字段配置合适 Reducer,或者改图让写入串行化。
Q6:updates 和 values 有什么区别?
答题要点:
updates看每个节点写了什么增量。values看每一步的完整 State 快照。- 排查覆盖问题优先看
updates。 - 做 UI 或恢复状态展示时常看
values。
Q7:固定边和条件边有什么区别?
答题要点:
add_edge代表固定依赖。add_conditional_edges通过路由函数选择路径。- 路由函数返回映射 key,映射再指向真实节点。
- 条件边适合分支、循环和动态结束。
Q8:recursion_limit 能不能代替循环退出条件?
答题要点:
- 不能。
- 退出条件是业务正确性。
recursion_limit是运行时安全阀。- 两者都要有,达到上限还要有可识别的错误处理。
Q9:Subgraph 解决什么问题?
答题要点:
- 把复杂流程封装为可复用、可单测的图。
- 父图可以把编译后的子图当节点。
- 父子之间通过共享字段传递数据。
- 私有字段不会自动泄漏,schema 不对齐时可能静默丢失。
Q10:Send 和普通节点返回 State 有什么区别?
答题要点:
- 普通节点返回 State 更新。
Send在运行时生成多个目标节点实例和局部输入。- 它适合动态 fan-out。
- worker 结果写回共享字段时必须考虑 Reducer。
Q11:Command 有什么价值?
答题要点:
- 一个返回值同时表达状态更新和下一步去向。
- 适合审批、动态 goto 和状态驱动路由。
- 它把"做了什么"和"下一步去哪"绑定在一个业务决策中。
Q12:thread_id 是什么?
答题要点:
- 它是 checkpointer 查找一条执行链的键。
- 同一个线程可以恢复之前的状态。
- 换线程通常就是新会话或新任务。
- 生产中应让它对应明确业务实体,例如工单、报告或订单。
Q13:再次 invoke 和 Command(resume=...) 有什么区别?
答题要点:
- 再次
invoke通常表示启动一次新的运行,任务可能重跑。 Command(resume=...)是从 interrupt 检查点恢复。- 恢复涉及重放,因此副作用必须用
@task或其他持久化边界保护。
Q14:interrupt() 和静态断点有什么区别?
答题要点:
interrupt()写在节点内部,条件满足时才暂停。interrupt_before/after是外部插桩,不改业务节点。- 内容审批更适合动态 interrupt。
- 统一审查危险节点更适合静态断点。
Q15:为什么 interrupt 前的代码可能执行两次?
答题要点:
- 恢复时节点从入口重放,而不是从 Python 代码的某一行继续。
- interrupt 前的普通代码会再走一遍。
- 有副作用的操作要移到
@task或中断之后,并设计幂等性。
Q16:durable execution 的三个条件是什么?
答题要点:
- 有 checkpointer。
- 调用时提供
thread_id。 - 非确定性或有副作用的工作包进
@task。
Q17:create_agent 和手写 StateGraph 怎么选?
答题要点:
- 标准模型工具循环先用
create_agent。 - 需要精细控制状态、并行、审批、循环和节点边界时手写图。
create_agent不妨碍继续使用 LangGraph 的流式、持久化和子图能力。
Q18:多 Agent 为什么需要 Supervisor?
答题要点:
- Supervisor 负责拆解任务、选择专家、汇总结果。
- 专家负责领域动作,减少单个 Agent 的上下文和工具负担。
- 代价是路由、共享状态和失败传播更复杂。
- 如果顺序固定,显式子图串联可能比 Supervisor 更简单。
Q19:langgraph.json 的 dependencies 和 graphs 各管什么?
答题要点:
dependencies管安装什么。graphs管平台加载哪个模块中的哪个图对象。- 还要检查模块中确实存在导出变量。
- 环境变量配置不能代替图对象导出。
Q20:如何设计一个生产级 LangGraph 系统?
答题要点:
按四层回答:
- 建模层:State schema、Reducer、节点边界。
- 控制层:条件边、循环、并行、子图和审批。
- 运行层:checkpointer、thread、stream、task、重试和超时。
- 运维层:部署清单、环境变量、日志、trace、指标和回归测试。
9. 综合项目:多专家报告系统
这是最适合面试现场讲解的综合例子:
text
输入主题
   |
研究专家子图
   |
写作专家子图
   |
校对专家子图
   |
人工审批 interrupt
   | approved                 | rejected
保存终稿                     取消并记录原因
面试讲解顺序建议:
ReportState存主题、研究结果、草稿、最终报告、审批状态和消息。- 三个专家分别是可单测的子图。
- 子图之间通过父图共享字段传递结果。
proof完成后进入interrupt,把草稿预览交给审批人。Command(resume=...)恢复后用Command(goto=...)分流。checkpointer + thread_id让审批任务可跨调用恢复。stream_mode="updates"让前端看到每个专家完成进度。langgraph.json导出最终图,生产环境替换内存检查点并开启 tracing。
一张更适合讲项目的流程图见 assets/interview-project-flow.mmd。
10. 排错清单
结果字段为空或被覆盖
- State schema 是否声明了该字段?
- 节点返回的 key 是否拼写一致?
- 字段是覆盖语义还是需要 Reducer?
- 是否有并行节点同时写入?
- 用
stream_mode="updates"找到最后一个写入者。
对话没有记忆
- 是否编译时传入 checkpointer?
- 每次调用是否复用了同一个
thread_id? messages是否配置了add_messages?- 是否错误地重建了 app,导致拿到新的内存账本?
恢复后重复调用外部服务
- 是否把副作用放在了 interrupt 前?
- 是否使用了
@task? - 是否把"再 invoke"误当成"resume"?
- 外部接口是否具备幂等键?
部署加载失败
langgraph.json是否存在且格式正确?graphs是否是正确的文件:变量?- 目标模块是否真的导出了
graph? - 依赖包是否在
dependencies中? - 必要环境变量是否注入?
11. 一页式复习顺序
第 1 轮:说清框架
- 背出 State、Node、Edge 的职责。
- 手写最小
StateGraph。 - 解释
invoke()和stream()。
第 2 轮:说清数据
- 默写 Reducer 签名。
- 解释默认覆盖和并行冲突。
- 解释
add_messages、config和state。
第 3 轮:说清控制
- 手写一个条件边。
- 解释循环退出和
recursion_limit。 - 解释 Subgraph、
Send、Command的边界。
第 4 轮:说清可靠性
- 解释 checkpointer、
thread_id、get_state。 - 解释 interrupt 的暂停与恢复。
- 解释为什么副作用要进
@task。
第 5 轮:说清生产
- 比较
create_agent和手写图。 - 讲一种多 Agent 协作模式及取舍。
- 讲清
langgraph.json和 tracing。 - 用综合项目串起全部能力。
12. 官方资料与本地教程
官方资料入口:
- LangGraph Overview
- LangGraph Persistence
- LangGraph Streaming
- LangGraph Interrupts
- LangGraph Durable Execution
- LangChain Multi-agent
- LangSmith Observability
最后记忆句
状态负责记,节点负责做,边负责走,条件边负责选,Reducer 负责合并,子图负责组合,检查点负责存活,interrupt 负责交权,stream 负责让过程可见。