2026 后端架构进入 AI 原生阶段:事件驱动 + 虚拟线程 + Agent 内嵌三驾马车怎么落地
云原生那一套正在被大模型"重新计费"。过去十年,后端架构的核心假设是:一次请求在几百毫秒内完成,线程占用可以忽略,超时和重试是有效的容错手段,接口成功就意味着结果已经产生。当业务链路里插入一次大模型调用之后,这些假设同时失效:首字延迟可能达到秒级到数十秒,完整生成持续更久,输出以流的方式逐段到达,中间结果本身就是产品体验的一部分,而失败重试还会带来真实的 token 成本。
2026 年中文技术社区对这类问题的集中回应,是把"事件驱动 + 虚拟线程 + Agent 内嵌"称为 AI 原生后端的三驾马车 1。同时,Spring AI 与 LangChain、NestJS 的生产选型对比,以及 Java 侧 Agentic RAG 项目 Ragent 所展示的 Java 17/Spring Boot 3.5.7 + Milvus 2.6 + RocketMQ 5.x 全链路,都指向同一个事实:AI 能力正在从"外部服务的 HTTP 调用"变成后端架构的内生组成部分 235。
本文不复述趋势口号,而是把三根支柱逐一拆开:它们各自解决长耗时、流式 LLM 调用的哪个具体问题,在 Java 与 Spring 上怎么写,什么时候不该用,以及把三者拼成一条 RAG 全链路时的版本、组件与工程取舍。全文以"企业内部知识库文档问答"这一贯穿示例展开。
一、先说版本基线:Java 17 与虚拟线程不能兼得
在进入正文前,必须先澄清一个会直接影响架构方案的版本事实。
虚拟线程由 JDK 21 的 JEP 444 正式定稿,Thread.ofVirtual()、Executors.newVirtualThreadPerTaskExecutor() 等 API 也从 JDK 21 起可用。这意味着"Java 17 + 虚拟线程"这一组合在语法层面并不成立:Java 17 上运行的 Spring Boot 3.5.x 无法开启虚拟线程支柱。Spring Boot 3.x 的 spring.threads.virtual.enabled 配置同样以运行时 JDK 支持虚拟线程为前提。
因此本文采用如下基线,并在后文各处标注差异:
| 项目 | 本文推荐基线 | 说明 |
|---|---|---|
| JDK | 21 LTS | 启用虚拟线程的最低可行版本 |
| Spring Boot | 3.5.x | 支持 Java 17+,虚拟线程可通过配置开启 |
| Spring AI | 1.0.x 起的稳定线,2.0 需单独核验 | 社区文章称 2.0 要求 Java 21+,属二手信息,见后文说明 |
| 向量库 | Milvus 2.5/2.6 | Ragent 公开技术栈使用 2.6 3 |
| 消息队列 | RocketMQ 5.x | 长任务编排与失败重放 |
如果既有系统被 Java 17 锁死,那么"虚拟线程"支柱要替换为"响应式/异步客户端(WebClient、Reactor)",本文第四章的结论不适用,需要用异步回调式代码重新组织。这不是细节差异,而是两套不同的并发模型,评审时应明确二选一。
二、云原生那套为什么在 LLM 场景开始失灵
2.1 一次文档问答请求的时间轴
一个典型的知识库问答请求会经历:参数校验 → 会话与权限检查 → 向量检索与重排 → Prompt 组装 → 大模型首 token → 流式生成 → 落库与审计。其中只有前两步是传统后端熟悉的"毫秒级",检索与重排是"百毫秒级",而大模型生成是"秒级到分钟级"。
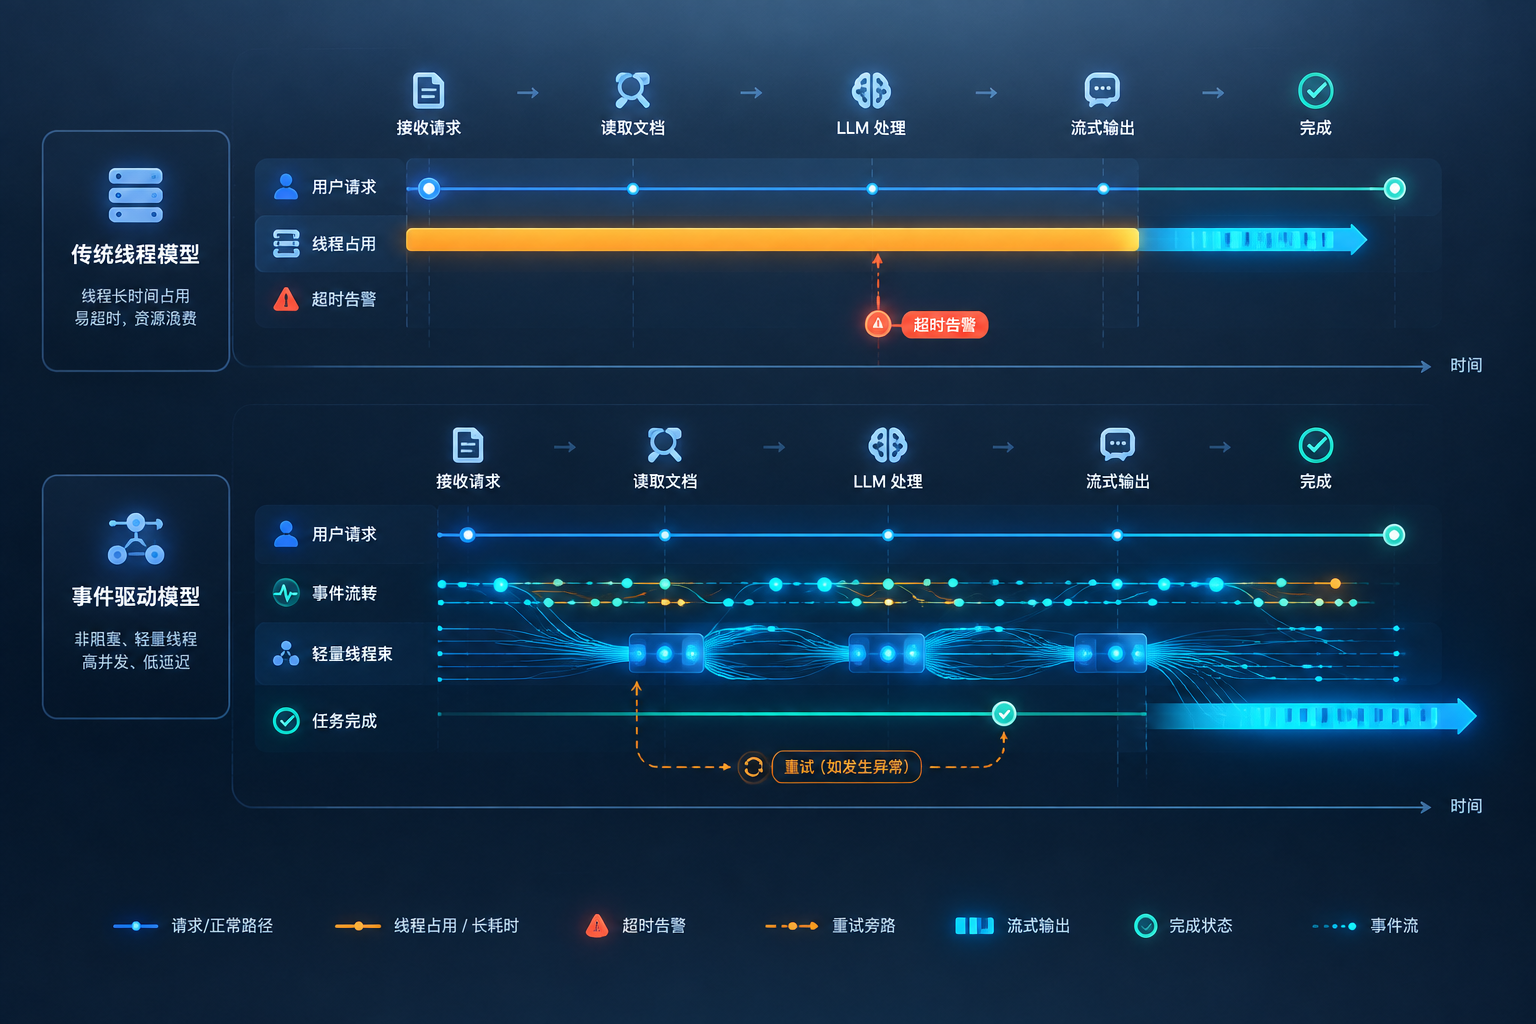
问题不在于"慢",而在于慢的形态变了:
- 同步阻塞把长耗时变成线程占用。一次 30 秒的生成,就要让一个平台线程被占满 30 秒。在 Tomcat 默认 200 线程的模型下,几百个并发提问就能把整个服务的请求能力吃光,与之无关的订单、用户接口一起排队。
- 超时与重试语义失效。网关 60 秒超时、Feign 默认超时、客户端重试,对 LLM 调用是灾难组合:重试意味着重复计费、重复生成,还可能在知识库侧产生重复写入。重试必须基于任务幂等键,而不是基于 HTTP 连接错误。
- "请求---响应"边界与流式输出冲突。产品要求首字尽快到达并持续渲染,而后端却把整段回答攒完才返回;客户端断线、用户中途取消、网络切换之后,任务状态无从恢复,中间结果全部丢失。
- 中间状态本身就是资产。检索用了哪些片段、Agent 调用了哪些工具、第几步失败,都决定了回答可不可信、能不能复现。同步 RPC 的"要么返回 200、要么抛异常"承载不了这种过程记录。
2.2 什么才算"AI 原生架构"
"接了大模型 API"不等于 AI 原生。建议用四条可验证判据来判断:
- 长任务可观测:任务有唯一 ID,状态可查询,关键阶段有 trace 与耗时埋点。
- 任务可恢复:进程重启、下游超时后,任务能从上次状态继续或安全重放,且重放幂等。
- 流式可断点续传:客户端断线后重新订阅能拿到已完成的片段与当前进度,而不是重头开始。
- 智能能力可组合:Agent 的工具、检索、记忆是进程内可复用的组件,而不是散落在各业务 Controller 里的裸 prompt 调用。
满足这四条,才是把大模型调用当成"一类新的长任务"来设计系统,这正是三驾马车要解决的问题 15。
三、三驾马车的分工:它们不在同一层,也不互相替代
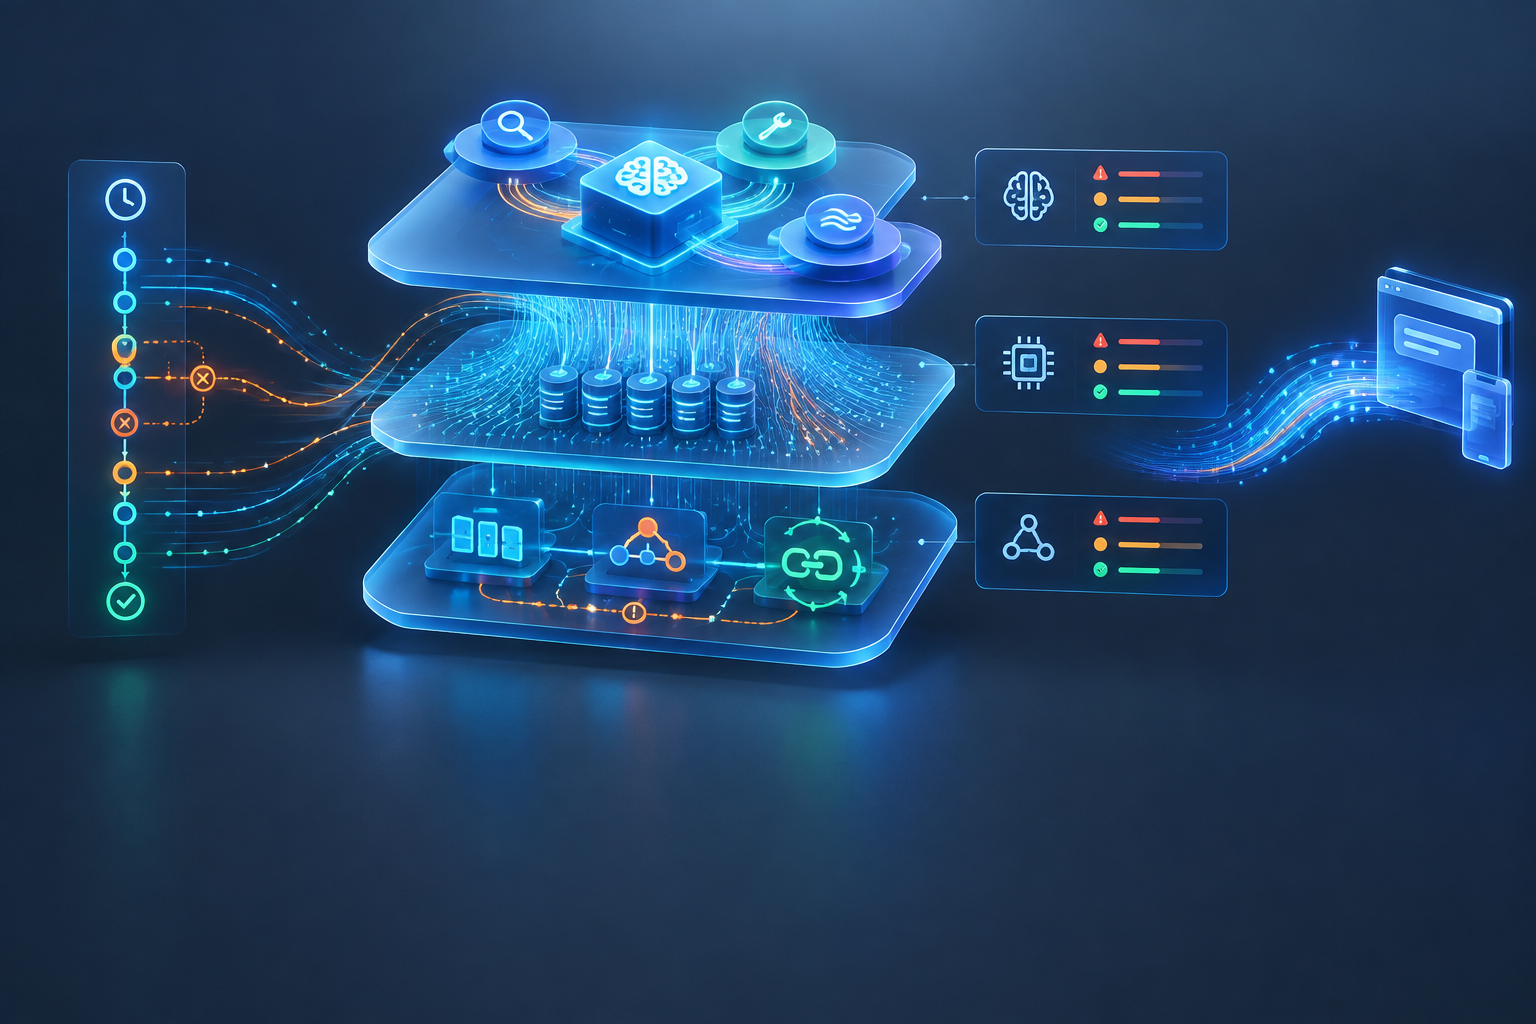
最容易出错的引入方式,是把三者当成三个并列"技术点"一拥而上。实际上它们各处一层,解决的问题正交:
| 支柱 | 所在层 | 解决的核心问题 | 不负责什么 |
|---|---|---|---|
| 事件驱动 | 通信与编排层 | 把长耗时从请求生命周期剥离,任务可重放、可审计 | 不降低单次调用延迟 |
| 虚拟线程 | 进程内并发层 | 让"每请求一线程"的写法在大量阻塞调用下仍然经济 | 不加速 CPU 密集任务,不做跨进程解耦 |
| Agent 内嵌 | 智能与能力层 | 让规划、工具调用、检索、纠错成为可复用的进程内组件 | 不负责任务持久化与传输可靠性 |
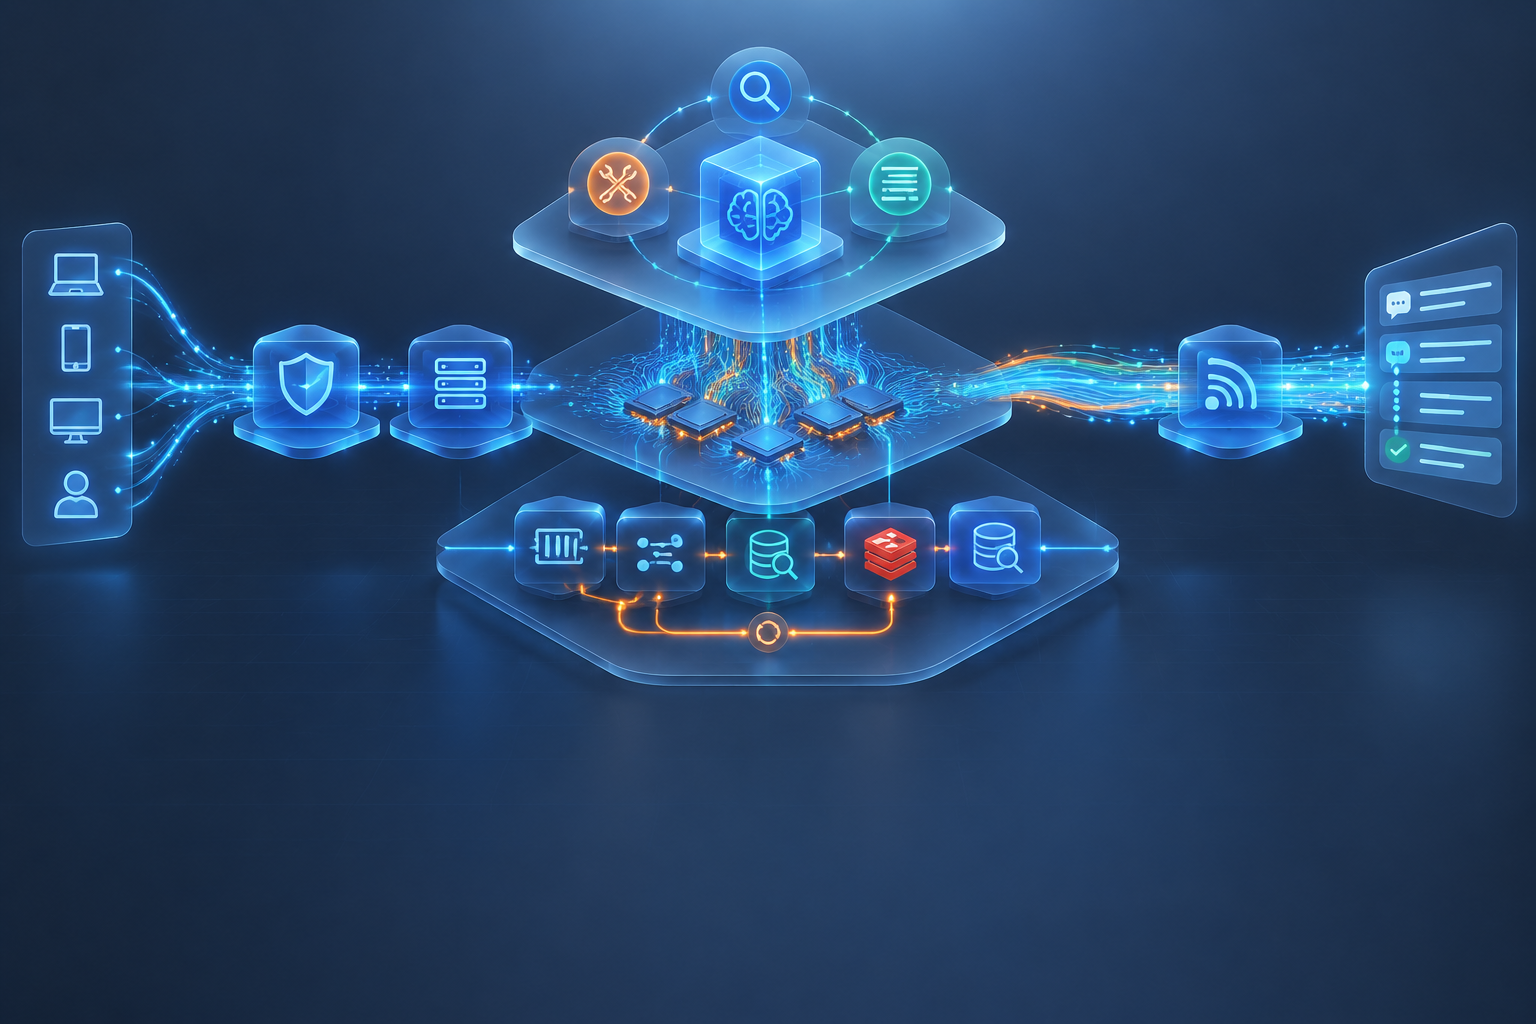
一次完整链路大致是:客户端提交问答任务 → 接口立即返回任务 ID 与订阅地址 → RocketMQ 承载任务事件与状态推进 → 消费端在虚拟线程上执行 Agent 循环 → Agent 内部调用 Milvus 检索、重排与工具 → LLM 流式生成 → 生成片段经 SSE 推送前端,同时异步落库。
其中值得注意的是分工边界:事件驱动决定"任务怎么流转",虚拟线程决定"进程内怎么并发执行",Agent 内嵌决定"智能逻辑长什么样"。三者缺一只是性能或效率问题,缺事件驱动则任务不可恢复,缺 Agent 抽象则智能逻辑无法治理,性质不同。
对简单场景要有克制:低频、低延迟、单轮、无中间状态的问答接口,直接同步调用即可,硬套三驾马车只会增加运维面。判别标准是"任务是否长于秒级、是否需要流式、是否有多步工具调用、是否需要失败恢复"四项中命中两项以上。
四、支柱一:事件驱动------把长耗时从请求生命周期里剥离
4.1 改造要点:提交与消费分离
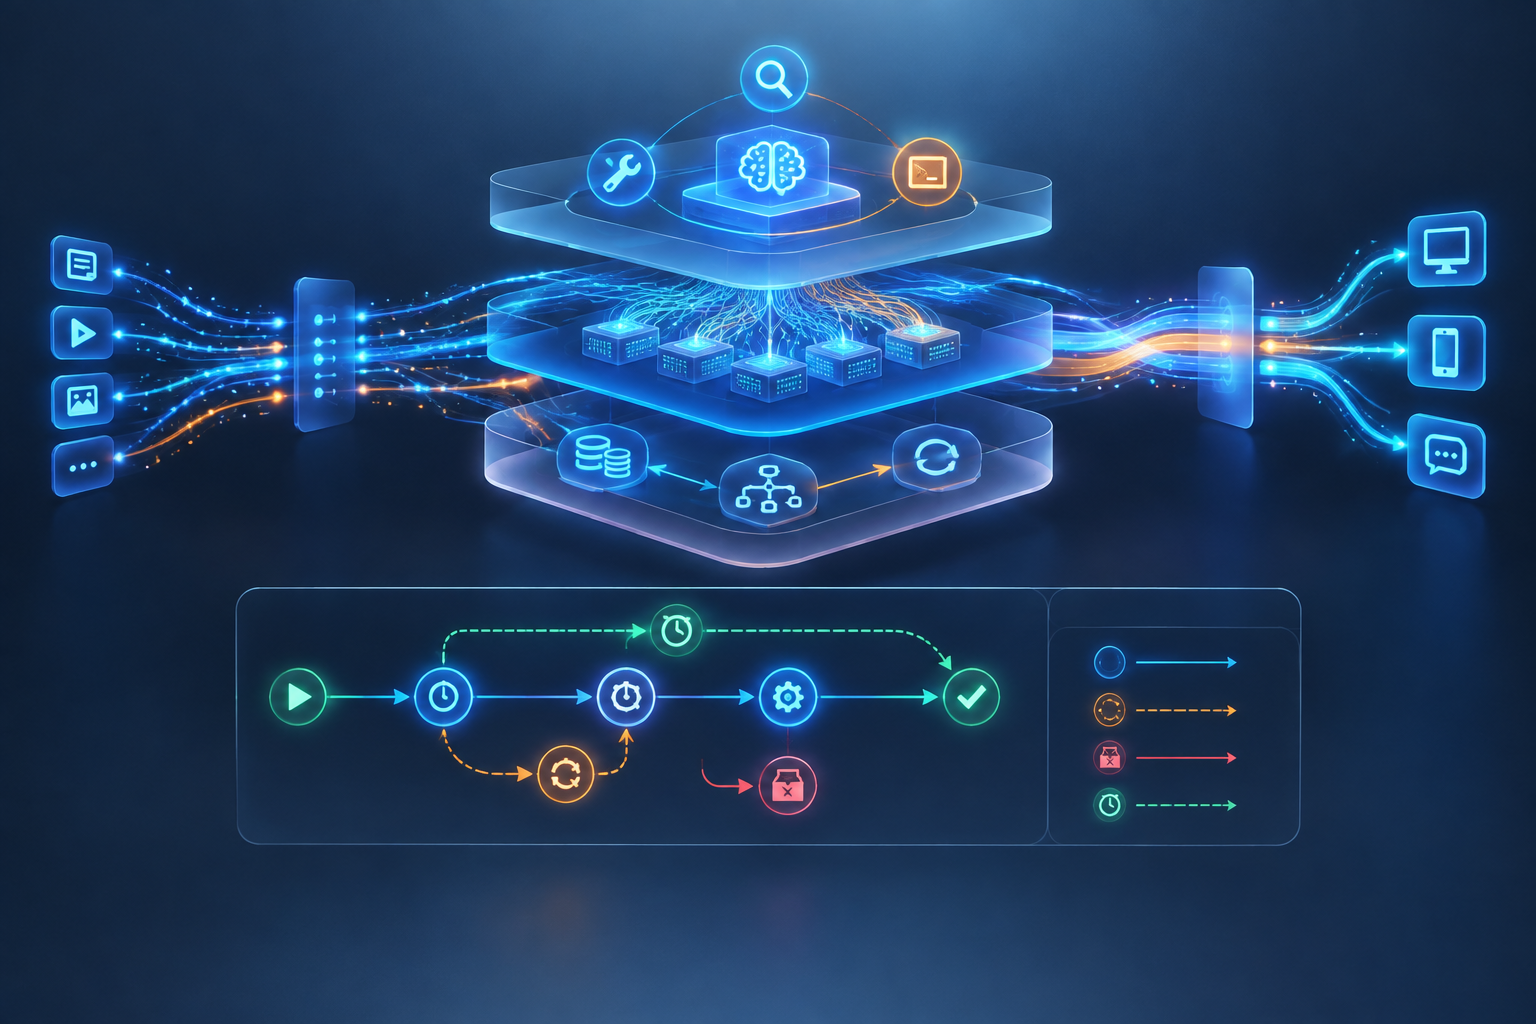
改造后的接口不再"算完再返回",而是三步走:写入任务记录(SUBMITTED)→ 发送任务事件 → 返回任务 ID 与流订阅地址。真正的检索与生成在消费者侧完成。
java
@RestController
@RequestMapping("/api/ask")
public class AskTaskController {

    private final AskTaskService askTaskService;

    public AskTaskController(AskTaskService askTaskService) {
        this.askTaskService = askTaskService;
    }

    // 提交问答任务:202 Accepted + 轮询/订阅地址
    @PostMapping("/tasks")
    public ResponseEntity<AskTaskView> submit(@RequestBody @Valid AskRequest request) {
        AskTask task = askTaskService.submit(request);   // 幂等键:request.getRequestId()
        String location = "/api/ask/tasks/" + task.getId();
        return ResponseEntity.accepted()
                .header("Location", location)
                .body(AskTaskView.of(task, location + "/stream"));   // /stream 为 SSE 订阅地址
    }

    // 任务状态查询,供前端轮询或断线后恢复
    @GetMapping("/tasks/{id}")
    public AskTaskView status(@PathVariable String id) {
        return AskTaskView.of(askTaskService.get(id), "/api/ask/tasks/" + id + "/stream");
    }
}
任务 ID 与幂等键要分开:任务 ID 由系统生成,幂等键由调用方生成(如 requestId),保证客户端超时重发不会产生两次计费生成。
4.2 事件建模:状态机优先于消息格式
不要先设计消息字段,先把状态机定下来:
SUBMITTED → RETRIEVING → GENERATING → COMPLETED
     │           │            │
     └───────────┴────────────┴──→ FAILED ──(重试超限)──→ DEAD_LETTER
每个事件只做一次状态推进,推进条件写进消费逻辑(例如只有 RETRIEVING 才能进入 GENERATING),避免乱序或重复消费把状态打乱。事件体建议包含:taskId、requestId(幂等键)、schemaVersion、traceId、payload、occurredAt。schemaVersion 很关键,向后兼容的消费者需要根据版本分支解析。
4.3 RocketMQ 在这条链路上的职责
RocketMQ 5.x 在 RAG 链路中适合承担四件事:文档入库流水线的解耦 (解析、分块、向量化可独立扩缩容)、长任务状态推进 、失败重放 、审计留痕 3。顺序消息用于同一 taskId 的状态事件保序;延时消息用于超时扫描(例如任务卡在 GENERATING 超过阈值则告警或重试);事务消息用于"任务记录落库 + 事件发送"的最终一致。
消费端骨架示意(具体注解与 starter 坐标以所用 rocketmq-spring 版本官方文档为准):
java
@Component
public class AskTaskConsumer {

    private final AskTaskService askTaskService;
    private final AgentOrchestrator orchestrator;

    public AskTaskConsumer(AskTaskService askTaskService, AgentOrchestrator orchestrator) {
        this.askTaskService = askTaskService;
        this.orchestrator = orchestrator;
    }

    @RocketMQMessageListener(
            topic = "ask-task-topic",
            consumerGroup = "ask-task-consumer",
            selectorExpression = "ask"
    )
    public void onMessage(AskTaskEvent event) {
        // 1. 幂等:以 requestId + 阶段 做唯一约束,重复投递直接 ACK
        if (!askTaskService.markConsumed(event.getRequestId(), event.getStage())) {
            return;
        }

        // 2. 状态机校验:非法跃迁丢弃并告警,避免乱序消息污染状态
        if (!askTaskService.canTransit(event.getTaskId(), event.getStage())) {
            return;
        }

        try {
            orchestrator.runStage(event.getTaskId(), event.getStage());
            askTaskService.transit(event.getTaskId(), event.getStage().next());
        } catch (Exception ex) {
            // 3. 业务异常:按重试次数退避;超限转死信队列并人工/自动处置
            askTaskService.recordFailure(event.getTaskId(), ex);
            throw ex;   // 让 MQ 触发重试,重试策略与死信配置在 broker 侧统一管理
        }
    }
}
4.4 一个必须守住的边界:token 不进消息队列
常见反模式是把 LLM 每个流式 token 都发一条消息。这会造成消息量爆炸、顺序与聚合复杂、消费端难以还原流语义,成本远大于收益。正确粒度是任务级与阶段级事件 :TaskSubmitted、RetrievalCompleted、GenerationStarted、TaskCompleted。token 流走 SSE/WebSocket 直连通道,最终结果作为一条 TaskCompleted 事件承载摘要与存储指针。
SSE 断线重连配合方式:前端持有 taskId,重连后先拉取已完成片段(存于 Redis 或结果表),再继续订阅增量。Redis 在此只做热态缓存与限流,持久结果仍以 MySQL 为准,这一"缓存加速、数据库保真"的分工与经典 Cache Aside Pattern 一致 10。
五、支柱二:虚拟线程------让"每请求一线程"重新变便宜
5.1 它解决的是线程经济性,不是延迟
虚拟线程把"线程"从操作系统资源变成 JVM 调度对象,使得数万级的阻塞任务可以复用少量平台线程。对 LLM 场景的意义在于:代码仍可以用最直白的同步写法(调用检索、调用模型、写库),却不再因为每次调用阻塞数十秒而耗尽线程池。
它不会 让模型生成更快,也不会解耦服务间依赖。CPU 密集的向量计算、重排模型推理仍然受核心数限制;跨服务的可靠性问题仍然要靠事件与重试语义解决。因此虚拟线程与事件驱动是互补关系:事件驱动负责跨进程的任务生命周期,虚拟线程负责进程内执行成千上万个等待中的任务。
5.2 开启方式
Spring Boot 3.2 及以上支持一键开启(需 JDK 21+):
yaml
spring:
  threads:
    virtual:
      enabled: true
开启后,Tomcat、任务执行器等默认走虚拟线程。自定义并发点可以显式创建:
java
@Configuration
public class ConcurrencyConfig {

    @Bean(destroyMethod = "close")
    public ExecutorService virtualTaskExecutor() {
        // 每个任务一个虚拟线程,适合大量阻塞型 I/O 任务
        return Executors.newVirtualThreadPerTaskExecutor();
    }
}
5.3 三个高频陷阱
陷阱一:synchronized 导致的线程钉住(pinning)。 在早期 JDK 21 实现中,synchronized 保护的代码块内发生阻塞会让载体线程被钉住,虚拟线程退化。JDK 24 的 JEP 491 大幅消除了这一问题,但只要团队还在 JDK 21 上,就应把长阻塞路径上的 synchronized 换成 ReentrantLock:
java
// 改造前:生成过程中持有锁,容易触发 pinning
public synchronized String generate(String taskId) {
    return chatClient.prompt().call().content();   // 长耗时阻塞
}

// 改造后:用 ReentrantLock,锁粒度只覆盖共享状态更新
private final ReentrantLock stateLock = new ReentrantLock();

public String generate(String taskId) {
    stateLock.lock();
    try {
        stateService.markGenerating(taskId);
    } finally {
        stateLock.unlock();
    }
    return chatClient.prompt().call().content();   // 不持锁执行长耗时调用
}
陷阱二:ThreadLocal 与上下文膨胀。 虚拟线程数量可能达到百万级,ThreadLocal 里的大对象(如整段文档、模型客户端缓存)会变成内存负担。审计信息优先用显式参数或 ScopedValue(状态随 JDK 版本演进,需按所用 JDK 核实)传递。
陷阱三:连接池上限成为新的串行点。 虚拟线程让线程不再是瓶颈后,HikariCP 连接数、HTTP 连接池、Milvus 客户端并发、模型侧并发配额会依次变成瓶颈。必须把连接池大小、模型侧限流阈值与虚拟线程并发一起做容量规划,否则只是把拥塞点从线程池挪到连接池。
5.4 如何自测收益
不引用任何未经复现的第三方性能数字,建议自建实验:固定业务代码与压测模型,分别在 spring.threads.virtual.enabled=false/true 下压测"并发 N 个 30 秒模拟生成任务 + M 个普通 CRUD 请求",观察三组指标------普通接口 P99 延迟、线程与内存占用、吞吐上限。重点验证的不是"快了多少",而是"长任务高并发时,无关接口是否还能保持稳定",这才是虚拟线程在 AI 后端的核心价值。
六、支柱三:Agent 内嵌------从调用模型 API 到进程内智能体
6.1 能力阶梯:Chat、RAG、Agentic RAG
- Chat:单轮问答,一问一答,无外部知识。
- RAG:先检索后生成,回答带出处,但流程固定为"检索一次、生成一次"。
- Agentic RAG:在检索与生成之间加入规划、工具调用、结果校验与二次检索,允许模型决定"再查一次""换个关键词""调用计算工具"。Ragent 公开介绍正是这一形态的 Java 实现案例 3。
差别不只在准确率,而在工程复杂度:Agentic RAG 引入了循环、工具、预算、超时、可观测性等一整套控制面问题。
6.2 "内嵌"的含义与组织方式
内嵌指 Agent 的规划、工具、记忆与业务服务同进程、同依赖注入容器、同事务边界管理。工程上的组织方式通常是:
- 工具注册:把业务能力(查订单、查知识库、算税费)注册为带描述与参数模式的工具函数,描述质量直接决定模型是否正确调用。
- 记忆与上下文:短期对话历史放会话存储,长期记忆进向量库并打上租户与权限标签。
- 循环控制:计划---执行---观察循环必须有硬上限,包括最大步数、最大 token 预算、总超时、允许调用的工具白名单。
- 结果与过程分离:最终回答与执行轨迹(调用了哪些工具、检索了哪些片段)分别存储,前者给用户,后者给审计与调优。
Spring AI 在其中提供统一的模型抽象、流式输出与工具调用能力;关于 MCP(Model Context Protocol)的接入形态与版本支持,社区文章将其列为 2026 年的热点协议 2,但该判断来自中文技术社区,缺乏更广泛交叉验证,具体 API 与支持范围务必以所用 Spring AI 版本的官方文档与 release notes 为准,本文不给出未经核实的类名与方法签名。
流式调用与工具注册的示意(API 形态随 Spring AI 版本演进,以官方文档为准):
java
@Service
public class KnowledgeAgent {

    private final ChatClient chatClient;

    public KnowledgeAgent(ChatClient.Builder builder) {
        this.chatClient = builder
                .defaultTools(new KnowledgeTools())      // 注册检索、重排、引用查询等工具
                .defaultSystem("回答必须基于检索片段,并给出引用编号。")
                .build();
    }

    public Flux<String> askStream(AgentContext ctx) {
        return chatClient.prompt()
                .user(ctx.getQuestion())
                .advisors(a -> a.param("chat_memory_conversation_id", ctx.getSessionId()))
                .stream()
                .content();
    }
}调用侧必须在循环外层再加一层兜底:timeout、预算熔断、工具白名单。模型输出不可控,任何"模型自己会停"的假设都会在生产上翻车。
6.3 内嵌 vs 独立 Agent 服务
| 维度 | Agent 内嵌 | 独立 Agent 服务 |
|---|---|---|
| 迭代速度 | 快,与业务同仓同发布 | 慢,跨服务契约与发布协调 |
| 故障隔离 | 差,Agent 崩溃影响同进程业务 | 好,独立扩缩容与隔离 |
| 事务与权限 | 易复用现有事务、鉴权体系 | 需要重新传递身份与上下文 |
| 技术栈复用 | 直接复用 Java 生态与团队技能 | 可选用 Python 生态 |
| 适用阶段 | 早期探索、能力与业务强耦合 | 能力成熟、多业务复用、需独立伸缩 |
经验判断:工具大多调用内部业务接口、团队是 Java 栈时,先内嵌;当 Agent 逻辑被三个以上业务复用、或推理负载需要独立弹性伸缩时,再外置为服务。外置后,内嵌版本的接口应保留为薄封装,避免业务层感知迁移。
七、整合实战:Java 21 + Spring Boot 3.5.x 上的 RAG 全链路
7.1 链路分解
- 文档解析:Apache Tika 提取文本与结构(Ragent 公开技术栈使用 Tika 3.2 3)。
- 分块:按标题层级与长度切分,保留来源、页码、章节元数据。
- Embedding:批量向量化,写入 Milvus,字段包含租户、知识库、文档版本。
- 检索:向量检索 + 标量过滤(权限、时间、文档类型),必要时混合检索。
- 重排:候选片段经重排模型排序后截断到上下文预算内。
- Prompt 组装:注入片段、引用编号、回答约束。
- 生成:流式输出,片段推送 SSE,完成后一次性落库与发布完成事件。
7.2 Milvus 的选型要点
Ragent 公开技术栈使用 Milvus 2.6 3。索引上,内存充足、召回要求高时多用 HNSW;写入量大、内存敏感时评估 IVF 系列或磁盘索引。向量库只承担检索,不要把它当主存储:业务事实、权限关系、任务状态仍在 MySQL,Milvus 里的记录必须能通过外部主键回溯到原始文档版本。检索与重排分离是关键设计,重排阶段的候选集可以放大到几十条,最终入 prompt 控制在个位数。
7.3 RocketMQ、Redis 的位置
RocketMQ 位于入库流水线与任务编排:文档上传后发 DocIngestEvent,解析、分块、向量化各为独立消费者,失败进死信队列,支持人工重放。Redis 承担三类职责:任务热状态与已生成片段缓存、模型调用与检索的限流、幂等标记(配合 Redisson 分布式锁)310。注意限流要在模型调用入口统一做,避免多实例各自为政导致总配额超限。
7.4 版本基线取舍
| 组件 | 稳妥选择 | 激进选择 | 建议 |
|---|---|---|---|
| JDK | 21 LTS | Java 26 等新版本 | 新特性可关注,但虚拟线程基线定在 21;升级前核验 JEP 状态与依赖兼容 |
| Spring Boot | 3.5.x | 4.0 线 | 3.5.x 生态成熟;4.0 需评估依赖与 Framework 7 兼容性 |
| Spring AI | 已 GA 的稳定线 | 2.0 | 以官方 release notes 确认版本号与最低 JDK/Boot 要求 |
| Spring Cloud Alibaba | 2025.0.x 配 Boot 3.5.x | 2025.1.0.0 配 Boot 4.0 | 两套版本矩阵不要混搭 8 |
需要明确标注的不确定性:中文社区文章提到 Java 26 于 2026 年 3 月发布、Spring AI 2.0 强制 Java 21 + Boot 4.0、Spring Cloud Alibaba 2025.1.0.0 对应 Boot 4.0 与 Nacos 3.1.1 等信息 4789,这些均来自二手技术博客,本文未做官方源核实。落地前请以 Oracle/OpenJDK 公告、spring.io 官方文档与对应项目的 release notes 为准。同理,二手文章中出现的"内存减少 37%"一类量化数据缺乏自测方法说明,本文不引用。
7.5 配置骨架
yaml
spring:
  threads:
    virtual:
      enabled: true        # 需 JDK 21+
  datasource:
    url: jdbc:mysql://mysql-host:3306/ragdb
    hikari:
      maximum-pool-size: 20   # 连接池上限必须与虚拟线程并发一起规划

# RocketMQ(starter 坐标与属性名以所用版本文档为准)
rocketmq:
  name-server: mq-host:9876
  producer:
    group: rag-producer-group

# 业务侧自定义配置示例
rag:
  milvus:
    uri: http://milvus-host:19530
    collection: kb_chunk_v1
  agent:
    max-steps: 6
    max-tokens: 8000
    overall-timeout: 60s
  stream:
    heartbeat: 15s          # SSE 心跳,防止中间层空闲断连
八、选型:Spring AI vs LangChain/LangGraph vs NestJS
2026 年的框架讨论集中在三类代表:面向 Java 生态的 Spring AI、面向 Python/多语言的 LangChain 与 LangGraph、面向 TypeScript 的 NestJS 方案 246。不建议做"谁更强"的排名,更实用的是按约束做决策:
| 考量维度 | Spring AI | LangChain / LangGraph | NestJS + JS 生态 |
|---|---|---|---|
| 主语言与团队 | Java,复用现有 Spring 团队 | Python,AI 算法侧强 | TypeScript,前后端同构 |
| 生产基建复用 | 直接复用 Spring Security、事务、监控 | 需自行补齐服务化能力 | 微服务与 WebSocket 支持较顺 |
| 流式与工具调用 | 有统一抽象,版本演进需核验 | 生态丰富,抽象层变动较快 | 可对接 LangGraph.js 等 |
| 部署形态 | 与业务服务同 JVM | 常作为独立推理/编排服务 | 独立 Node 服务 |
| 典型风险 | 新特性版本节奏快 | 抽象泄漏与升级成本 | 与 Java 业务域集成成本 |
决策路径可以压缩成三问:团队主栈是什么?智能逻辑与业务事务是否强耦合?是否需要独立弹性伸缩? Java 团队且工具以内部业务接口为主,选 Spring AI 内嵌;算法团队主导、实验迭代快,选 LangChain/LangGraph 独立服务;前端团队主导的实时交互型产品,NestJS + WebSocket 有开发效率优势。
MCP 是否现在投入:它的价值在于把"模型调用外部工具"标准化,减少为每个模型/Agent 框架重复写适配层;但其生态成熟度、生产案例与各框架实现完整度仍需自行评估,中文社区的热度判断 2 不足以作为投入依据。稳妥做法是:先在内部把工具定义与权限模型标准化,接口层预留 MCP 适配位,待所用框架的实现稳定后再切换。
九、落地路线与反模式清单
9.1 三阶段改造
| 阶段 | 动作 | 主要收益 | 主要风险 |
|---|---|---|---|
| 一:流式与超时治理 | SSE 输出、分层超时、取消传播、去掉客户端盲目重试 | 首字体验改善,线程占用下降 | 网关与前端需同步改造 |
| 二:任务异步化 | 任务表、状态机、RocketMQ 编排、幂等与死信 | 任务可恢复、可审计、可重放 | 引入最终一致,需处理乱序与重复 |
| 三:Agent 内嵌与观测 | 工具注册、预算控制、轨迹埋点、成本统计 | 能力复用、回答可解释 | 循环失控与成本失控风险 |
9.2 反模式清单
- token 级消息:流式片段走消息队列,消息量与复杂度失控。
- 虚拟线程 + 无界队列:线程不再稀缺后,无界缓冲会把压力转成内存泄漏。
- Agent 无预算:缺最大步数、token 预算、总超时、工具白名单。
- 重试无幂等:HTTP 层重试直接触发重复生成与重复计费。
- RAG 无引用溯源:回答无法回溯到文档版本,合规与排障都过不了关。
- 向量库当主存储:权限、状态、业务事实写进向量库,数据一致性无从保证。
- 超时配置不统一:网关、Feign/HTTP 客户端、模型 SDK 各自为政,出现"上游已放弃、下游仍在生成"。
- 把趋势当结论:例如"某协议是年度最热""某框架强制某 JDK"这类二手判断直接写进技术决策文档。
9.3 可观测性与成本
每个任务贯穿一条 trace:提交、检索、重排、首 token、生成结束、工具调用分别埋点;token 用量按业务线与租户统计,与预算阈值联动告警;失败任务保留原始输入与执行轨迹,支持按 taskId 重放。成本控制的抓手不是省 prompt 字数,而是:检索命中率(减少无效生成)、缓存高频问答、限制循环步数、对非实时任务使用低成本模型与离线批处理。
十、结语
AI 原生后端的本质不是"接入大模型",而是把长任务变成一等公民:事件驱动负责任务的流转、恢复与审计,虚拟线程让进程内等待不再昂贵,Agent 内嵌让规划、工具与检索成为可治理的工程组件。三者分处不同层次,单独引入都能改善局部,但只有组合起来,才能同时回答体验、可靠性与可解释性三个问题。
下一步的验证动作建议从最小闭环开始:选一个内部知识库场景,按"流式输出 + 任务化 + 一次工具调用"落地,跑通幂等、重放、断线恢复与预算控制,再决定是否引入更复杂的 Agent 循环。版本选择上,把基线定在 JDK 21 + Spring Boot 3.5.x,其他新版本在官方发布说明确认后再评估。
参考资料
1 云原生进化 AI 原生:2026 后端架构三驾马车完整实战手册|事件驱动 + 虚拟线程 + Agent 内嵌,CSDN,https://blog.csdn.net/weixin_56622231/article/details/164194282
2 2026 年 AI 后端开发终极指南:Spring AI 2.0 vs LangChain vs NestJS,生产级项目到底怎么选?CSDN,https://blog.csdn.net/weixin_44705473/article/details/163311682
3 Ragent AI:从零打造企业级 Agentic RAG 智能体,2026 年 Java 程序员必啃的硬核项目,CSDN,https://blog.csdn.net/chenchuang0128/article/details/163923949(文内列出的项目仓库为 https://github.com/nageoffer/ragent,文档为 https://nageoffer.com/ragent,本文未独立核验其内容)
4 Java AI 工程化:PyTorch On Java + SpringBoot 微服务部署(2025-2026 最新实战),CSDN,https://blog.csdn.net/HHX_01/article/details/159805388
5 2026 后端开发全解析:从核心技术到架构实战,一文吃透后端核心能力,CSDN,https://blog.csdn.net/2603_95386971/article/details/161179036
6 Backend developer roadmap for 2026,GitHub(atryx/backend-developer-roadmap-2026),https://github.com/atryx/backend-developer-roadmap-2026
7 2026 年 Java 后端热点科普:Java 26 新特性 + Java 21 落地实战,CSDN,https://blog.csdn.net/chen_si_shang_/article/details/160124027
8 2026 最新 Spring Cloud Alibaba 实战:用 Nacos + Sentinel 重构微服务(含完整代码),CSDN,https://blog.csdn.net/Add_kfxb/article/details/164113796
9 2026 版 Spring 全家桶:微服务、云原生与 AI 集成深度解析,CSDN,https://blog.csdn.net/weixin_31986143/article/details/165060193
10 一篇文章彻底搞懂 MySQL 和 Redis:原理、区别、项目用法全解析,掘金,https://juejin.cn/post/7614331029458681891
说明:上述来源多为中文技术社区文章与二手整理,本文在正文中已对版本号、发布日期、性能数据与协议热度等未经官方核实的信息作出标注;涉及 JDK、Spring、Spring AI、Milvus、RocketMQ 的 API 与配置项,请以对应官方文档和 release notes 为准。