摘要:容错是流处理系统的底线------挂了能不能恢复、恢复后会不会丢数据或重复数据。这篇把 Spark Streaming 的容错拆成三个层面讲:数据容错(WAL 和 offset 自管理)、计算容错(RDD 血缘重算)、元数据容错(checkpoint),再对照 Receiver 和 Direct 两种模式在四种故障场景下的恢复方式,说清楚为什么 Direct 模式的容错代价最低。
关键词:Spark Streaming, 容错, WAL, checkpoint, RDD 血缘, offset, exactly-once
一、容错分三个层面
Spark Streaming 的容错不能笼统说"它支持容错",要拆成三个层面,每个层面防的是不同东西的丢失:
- 数据容错:防的是"数据本身丢"------拉回来的数据没处理完就挂了,怎么找回。
- 计算容错:防的是"计算结果丢"------Executor 挂了,正在算的分区怎么重算。
- 元数据/状态容错:防的是"处理进度和状态丢"------Driver 挂了,流处理的进度、有状态算子的累计状态怎么恢复。
三个层面缺一个,容错就不完整。下面逐个说。
二、数据容错:WAL 和 offset 自管理
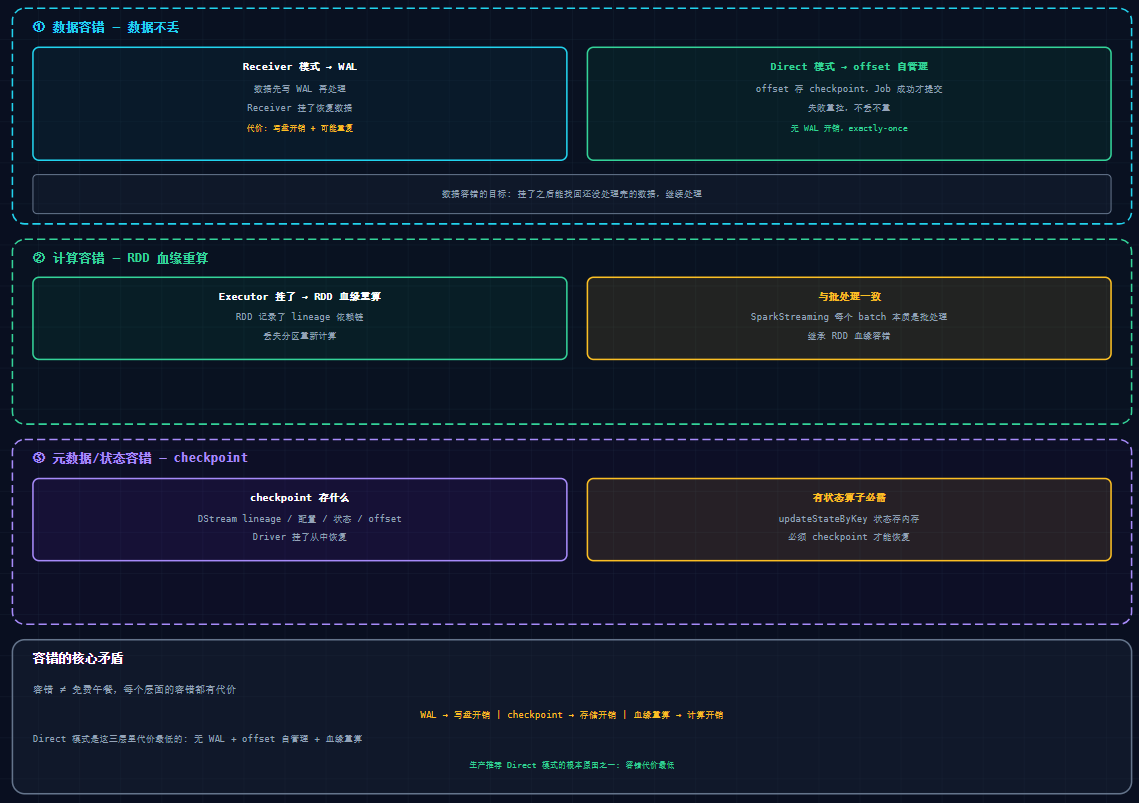
数据容错是两种模式分歧最大的地方。
Receiver 模式用 WAL(预写日志):Receiver 拉到的数据,先写进 WAL 落盘,再交给计算。Receiver 挂了,从 WAL 恢复还没处理的数据。
代价很明显:每拉一批数据就多一次写盘,吞吐打折扣;而且 WAL 恢复是 at-least-once------挂了之后已经处理完但没来得及确认的数据,恢复时可能重复处理。
Direct 模式用 offset 自管理:上一篇详细讲过,offset 存 checkpoint,Job 成功才提交。处理失败就不提交 offset,重算时从原位置重拉,不丢也不重。没有 WAL,也就没有写盘开销和重复消费问题。
三、计算容错:RDD 血缘重算
这一层 Spark Streaming 和普通 Spark 批处理完全一致------每个 batch 本质就是一个批处理作业,RDD 自带 lineage(血缘),记录了它从哪些父 RDD 怎么算出来的。
Executor 挂了,丢失的分区根据血缘重算即可,不需要额外配置。这是 Spark 最成熟的容错能力,直接继承过来。
四、元数据容错:checkpoint
这一层防的是 Driver 挂掉。checkpoint 把四类东西持久化到 HDFS:
- DStream 的 lineage(计算逻辑);
- 配置信息(SparkConf、batchInterval);
- 有状态算子的状态(updateStateByKey 的累计值);
- 未处理的 offset/block 元数据。
Driver 挂了,配合 YARN 的 --supervise 自动重启,再从 checkpoint 恢复。这块在 Driver HA 那篇讲透了,这里不展开。
关键点只有一个:有状态算子必须开 checkpoint。状态只存在 Driver 内存里,不开 checkpoint,Driver 一挂状态全丢,恢复也只能从零开始。
五、四种故障场景的恢复
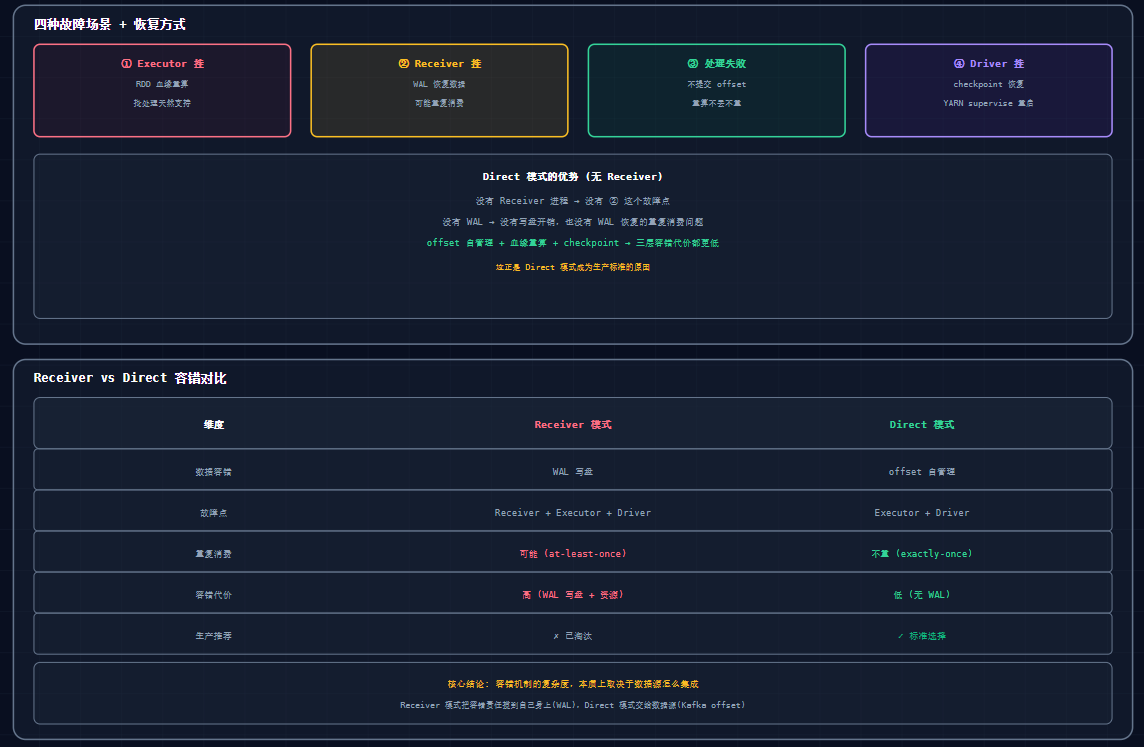
对照四种故障,看各自怎么恢复:
- Executor 挂:RDD 血缘重算,批处理天然支持。
- Receiver 挂(仅 Receiver 模式):从 WAL 恢复数据,可能重复消费。
- 处理失败:不提交 offset(Direct),重算不丢不重。
- Driver 挂:checkpoint + YARN supervise 恢复。
注意第 2 种是 Receiver 模式独有的故障点。Direct 模式没有 Receiver 进程,直接少了一整类故障,也少掉了 WAL 这套为它兜底的机制。
六、Receiver vs Direct 容错对比
| 维度 | Receiver 模式 | Direct 模式 |
|---|---|---|
| 数据容错 | WAL 写盘 | offset 自管理 |
| 故障点 | Receiver + Executor + Driver | Executor + Driver |
| 重复消费 | 可能(at-least-once) | 不重(exactly-once) |
| 容错代价 | 高(WAL 写盘 + 资源) | 低(无 WAL) |
结论一句话:Direct 模式的三层容错,代价都比 Receiver 模式低------没有 WAL 的写盘开销、少一个 Receiver 故障点、offset 自管理拿到 exactly-once。这正是 Direct 模式成为生产标准的核心原因,容错机制越简单,越不容易出错。
七、总结
- 容错分三层:数据容错(WAL/offset)、计算容错(RDD 血缘)、元数据容错(checkpoint),缺一不可。
- 数据容错是两种模式分歧最大的地方:Receiver 用 WAL(有写盘开销、可能重复),Direct 用 offset 自管理(无 WAL、exactly-once)。
- 计算容错继承 RDD 血缘,Executor 挂了重算即可,无需额外配置。
- 元数据容错靠 checkpoint,有状态算子必须开。
- Direct 模式容错代价最低,是它成为生产标准的根本原因之一。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践