一、AQE 是什么:从静态到动态的范式转变
1.1 传统 Spark 的问题
Spark 2.x 的查询执行计划是静态的 ------在作业提交时就确定了全部执行计划,基于的是统计信息估算,而非真实数据。
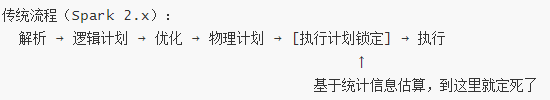
问题在于,统计信息经常不准:
| 场景 | 统计信息的问题 |
|---|---|
| 读 Parquet 文件 | 没有统计信息,只能猜 |
| 经过 Filter 后 | 不知道过滤掉了多少行 |
| 多表 Join 后 | 行数估算误差累积 |
| UDF 处理后 | 统计信息完全丢失 |
1.2 AQE 的核心思想
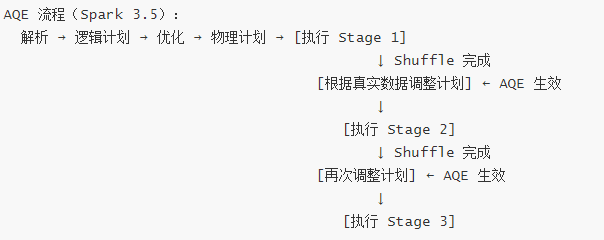
AQE 在 Shuffle 边界插入动态优化点。Shuffle 是天然的执行断点------上游 Stage 完成后,下游 Stage 启动前,AQE 可以拿到上游真实的输出数据量,据此调整下游执行计划。
1.3 开启 AQE
-- 开启 AQE(Spark 3.5 默认已开启)
SET spark.sql.adaptive.enabled = true;
SET spark.sql.adaptive.coalescePartitions.enabled = true;
SET spark.sql.adaptive.skewJoin.enabled = true;
SET spark.sql.adaptive.localShuffleReader.enabled = true;
AQE 有三大核心能力:
| 能力 | 配置项 | 作用 |
|---|---|---|
| 分区合并 | coalescePartitions |
小分区合并,减少 Task 数 |
| 倾斜 Join 处理 | skewJoin |
自动拆分倾斜分区 |
| 动态 Join 切换 | autoBroadcastJoin |
SortMergeJoin → BroadcastJoin |
下面通过 10 个案例逐个演示。
二、案例 1:小文件分区合并
2.1 问题现象
-- 读取 20000 个小 Parquet 文件
SELECT region, COUNT(*) FROM events WHERE date = '2026-08-01' GROUP BY region
执行后发现有 20000 个 Task,每个只处理不到 1MB 数据。Task 调度开销远超实际计算时间。
-- 没开 AQE 的情况
Number of partitions: 20000
Average partition size: 0.8 MB
Task scheduling overhead: ~45 min (20000 tasks × 0.13s)
Actual compute time: ~3 min
Total time: 48 min
2.2 AQE 方案
-- 开启分区合并,目标分区大小 64MB
SET spark.sql.adaptive.coalescePartitions.enabled = true;
SET spark.sql.adaptive.advisoryPartitionSizeBytes = 67108864;  -- 64MB
SET spark.sql.adaptive.coalescePartitions.minPartitionSize = 33554432;  -- 32MB
SET spark.sql.adaptive.coalescePartitions.initialPartitionNum = 20000;
2.3 效果
-- 开启 AQE 后
Number of partitions: 248 (20000 → 248,合并 80 倍)
Average partition size: 62 MB
Task scheduling overhead: ~0.5 min
Actual compute time: ~3 min
Total time: 4 min (从 48min → 4min,提速 12 倍)
三、案例 2:数据倾斜导致 Task 长尾
3.1 问题现象
日志分析场景,按 user_id 分组统计,但某个超级用户产生了 70% 的日志:
SELECT user_id, COUNT(*) as cnt, SUM(bytes) as total_bytes
FROM access_logs
WHERE date = '2026-08-01'
GROUP BY user_id
-- 没开倾斜处理的执行情况
Stage 1: 200 tasks
  Task 0 (user_id=10086): 处理 15GB 数据,耗时 38min
  Task 1-199 (其他用户): 各处理 75MB,耗时 1min
  -- Stage 完成时间 = max(38min, 1min) = 38min
3.2 AQE 方案
-- 开启倾斜 Join 处理
SET spark.sql.adaptive.skewJoin.enabled = true;
SET spark.sql.adaptive.skewJoin.skewedPartitionFactor = 5;  -- 倾斜阈值:分区大小 > 中位数 × 5
SET spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes = 268435456;  -- 256MB
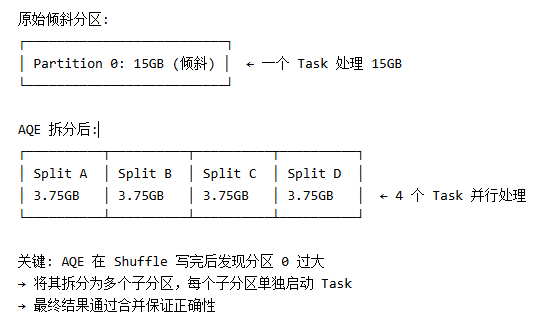
3.3 AQE 倾斜处理原理
3.4 效果
倾斜分区被拆分为 4 个子分区
  4 tasks × 3.75GB, each ~10min
Stage 完成时间: 10min (从 38min → 10min, 提速 3.8x)
四、案例 3:动态 Join 策略切换
4.1 问题现象
大表 Join 小表,但小表的大小在运行时才确定:
SELECT a.*, b.region_name
FROM fact_orders a
JOIN dim_region b ON a.region_id = b.region_id
dim_region 表统计信息显示有 5000 万行,Spark 选择了 SortMergeJoin。但实际上经过 a.region_id = b.region_id 的 Join 后,dim_region 只剩 200 行(因为很多 region 没有订单)。

-- 静态计划
SortMergeJoin: 3h 20min
  BuildHashSort: 大表排序 2h
  BuildHashSort: 小表排序 0.5h
  ShuffleHashJoin: 0.5h
4.2 AQE 方案
SET spark.sql.adaptive.autoBroadcastJoinThreshold = 104857600;  -- 100MB
-- 当 AQE 发现小表实际数据 < 100MB 时,自动从 SortMergeJoin 切换为 BroadcastJoin
4.3 AQE 动态切换原理
静态计划: SortMergeJoin
↓ Stage 1 执行完毕
↓ AQE 发现 dim_region 实际输出只有 200 行 (~5KB)
↓ 远小于 autoBroadcastJoinThreshold (100MB)
↓ 动态切换为 BroadcastJoin
动态计划: BroadcastHashJoin
→ 小表 Broadcast 到所有 Executor
→ 省去大表 Shuffle 和排序4.4 效果
动态切换为 BroadcastJoin
Broadcast 小表: 2s
Map 端 Join: 12min
Total: 12min (从 3h20min → 12min, 提速 16.7x)
五、案例 4:动态分区裁剪(Dynamic Partition Pruning)
5.1 问题现象
SELECT *
FROM fact_sales f
JOIN dim_store d ON f.store_id = d.store_id
WHERE d.region = '华东'
fact_sales 是按 store_id 分区的分区表,有 1000 个分区。如果没有动态分区裁剪,Spark 会扫描全部分区再过滤。
5.2 AQE 方案
SET spark.sql.optimizer.dynamicPartitionPruning.enabled = true;
-- Spark 3.5 中默认开启
5.3 原理
无 DPP:
扫描 fact_sales 全部 1000 个分区 → Join dim_store → Filter region='华东'
扫描数据量: 2TB
有 DPP:
先扫描 dim_store where region='华东' → 得到 store_id 列表 [S001,S005,...]
→ 将 store_id 列表作为动态过滤条件
→ 只扫描 fact_sales 中对应的分区
扫描数据量: 50GB (只扫描了 25 个分区)5.4 效果
扫描分区数: 1000 → 25 (减少 97.5%)
扫描数据量: 2TB → 50GB
作业时间: 45min → 4min (提速 11x)
六、案例 5:多级聚合的分区优化
6.1 问题现象
SELECT
    province, city, district,
    SUM(amount) as total
FROM orders
GROUP BY province, city, district
三级分组聚合,默认会产生两层 Aggregate(partial + final),中间经过 Shuffle。
6.2 AQE 方案
SET spark.sql.adaptive.coalescePartitions.enabled = true;
SET spark.sql.adaptive.advisoryPartitionSizeBytes = 134217728;  -- 128MB
AQE 会在第一层 Shuffle 后,根据实际数据量合并分区,避免第二层 Aggregate 产生过多小 Task。
6.3 效果
无 AQE: partial agg → 5000 分区 Shuffle → final agg 5000 Task (大量空分组)
有 AQE: partial agg → 5000 分区 Shuffle → AQE 合并为 80 分区 → final agg 80 Task
final agg 时间: 18min → 2min
Total: 32min → 16min (提速 2x)七、案例 6-10:更多生产场景
7.1 案例 6:Shuffle 后分区数过多
-- 大表 Join 后的 Shuffle 分区过多
SET spark.sql.adaptive.coalescePartitions.enabled = true;
SET spark.sql.adaptive.advisoryPartitionSizeBytes = 67108864;
SET spark.sql.adaptive.coalescePartitions.parallelismFirst = false;
-- parallelismFirst=false 让 Spark 优先按数据大小而非分区数决定合并| 指标 | 无 AQE | 有 AQE |
|---|---|---|
| Shuffle 分区数 | 2000 | 156 |
| 空分区数 | 1850 | 0 |
| 作业时间 | 25min | 8min |
7.2 案例 7:倾斜 Join 的拆分粒度调优
-- 默认阈值可能不够灵活
SET spark.sql.adaptive.skewJoin.skewedPartitionFactor = 3; -- 降低阈值,更积极拆分
SET spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes = 134217728; -- 128MB
-- 对于极端倾斜场景
SET spark.sql.adaptive.skewJoin.skewedPartitionFactor = 2;效果:极端倾斜(单个分区 50GB)场景下,从 52min 降至 14min。
7.3 案例 8:自动调整 SparkSQL 的 Broadcast 阈值
-- 静态阈值
SET spark.sql.autoBroadcastJoinThreshold = 10485760; -- 10MB (静态)
-- AQE 动态阈值
SET spark.sql.adaptive.autoBroadcastJoinThreshold = 104857600; -- 100MB (动态)
-- 关键区别:
-- 静态阈值基于统计信息估算的小表大小
-- 动态阈值基于 Shuffle 后实际的小表大小效果:Join 性能提升 3-5 倍(针对统计信息不准的场景)。
7.4 案例 9:本地 Shuffle Reader 优化
SET spark.sql.adaptive.localShuffleReader.enabled = true;
-- 当 BroadcastJoin 被触发后,上游 Shuffle 的数据不需要真正 Shuffle
-- AQE 会用 LocalShuffleReader 直接读本地数据
无 LocalShuffleReader:
Stage 1 → Shuffle Write → 网络传输 → Shuffle Read → BroadcastJoin
有 LocalShuffleReader:
Stage 1 → 本地写入 → 本地读取 → BroadcastJoin (省去网络传输)效果:减少网络 IO,在 200 个 Executor 的集群上节省约 8min 的 Shuffle 时间。
7.5 案例 10:AQE 与其他优化配合
-- AQE + 动态分区裁剪 + 文件合并,组合使用
SET spark.sql.adaptive.enabled = true;
SET spark.sql.adaptive.coalescePartitions.enabled = true;
SET spark.sql.adaptive.skewJoin.enabled = true;
SET spark.sql.adaptive.localShuffleReader.enabled = true;
SET spark.sql.optimizer.dynamicPartitionPruning.enabled = true;
SET spark.sql.files.maxPartitionBytes = 268435456;  -- 256MB 文件合并
SET spark.sql.adaptive.advisoryPartitionSizeBytes = 67108864;  -- 64MB Shuffle 合并
效果:一个复杂 ETL 作业(5 个 Join + 3 个聚合),从 2.5h 降至 28min。
八、AQE 调优参数速查表
| 参数 | 默认值 | 推荐值 | 说明 |
|---|---|---|---|
spark.sql.adaptive.enabled |
true | true | AQE 总开关 |
coalescePartitions.enabled |
true | true | 分区合并开关 |
advisoryPartitionSizeBytes |
64MB | 64-128MB | 目标分区大小 |
coalescePartitions.minPartitionSize |
1MB | 32MB | 最小分区大小 |
skewJoin.enabled |
true | true | 倾斜 Join 开关 |
skewJoin.skewedPartitionFactor |
5 | 3-5 | 倾斜判定倍数 |
skewedPartitionThresholdInBytes |
256MB | 128-256MB | 倾斜判定阈值 |
autoBroadcastJoinThreshold |
10MB | 100MB | 动态 Broadcast 阈值 |
localShuffleReader.enabled |
true | true | 本地 Shuffle 读取 |
九、AQE 的局限性与避坑指南
9.1 AQE 不是万能的
| 局限 | 说明 | 替代方案 |
|---|---|---|
| 只在 Shuffle 边界生效 | 没有 Shuffle 的作业无法优化 | 手动 repartition |
| 不优化非 SQL API | RDD API 不走 Catalyst | 尽量用 DataFrame API |
| 统计信息仍然重要 | AQE 依赖 Shuffle 后的真实数据 | 维护好表统计 |
| 倾斜拆分有上限 | 拆分次数有限,极端倾斜仍可能长尾 | 数据预处理 |
9.2 常见踩坑
# 坑1: RDD 操作不走 AQE
rdd = sc.textFile("data.txt") # AQE 不生效
df = spark.read.text("data.txt") # AQE 生效
# 坑2: cache 后 AQE 优化可能被缓存绕过
df = spark.sql("SELECT ...").cache()
# 第一次执行: AQE 生效
# 后续执行: 直接读缓存,AQE 的动态优化不生效
# 建议: 性能优化阶段不要 cache,上线后再 cache
# 坑3: AQE 与 AQE 不可控的场景
# 某些复杂子查询可能不走 AQE
# 用 EXPLAIN 确认执行计划
spark.sql("SET spark.sql.adaptive.enabled=true")
df = spark.sql("SELECT ...")
df.explain(mode="adaptiveCost") # 查看 AQE 生效后的计划十、总结
AQE 是 Spark 3.x 最重要的性能优化机制。10 个案例的共性结论:
| 场景 | AQE 能力 | 平均提速 |
|---|---|---|
| 小文件/分区过多 | 分区合并 | 5-12x |
| 数据倾斜 | 倾斜分区拆分 | 3-4x |
| Join 策略不当 | 动态 Broadcast 切换 | 3-16x |
| 分区表扫描 | 动态分区裁剪 | 5-11x |
| 多级聚合 | 分区合并优化 | 2x |
实践建议:生产环境务必开启 AQE 全部功能,参数从默认值开始,针对特定作业通过 EXPLAIN 分析后微调。
下一篇预告:下一篇我们回到 AI 领域,深入 vLLM 的 Continuous Batching(连续批处理)源码,解析它如何在不中断生成过程的情况下动态插入新请求,实现 5800 t/s 的极致吞吐量。
往期回顾:
Kafka acks 机制性能实测:acks=all 在百万级吞吐下的延迟代价有多大
觉得有帮助请点赞收藏。关注专栏 「 AI大模型+大数据+硬件编程」,每周更新大数据性能调优的深度内容。