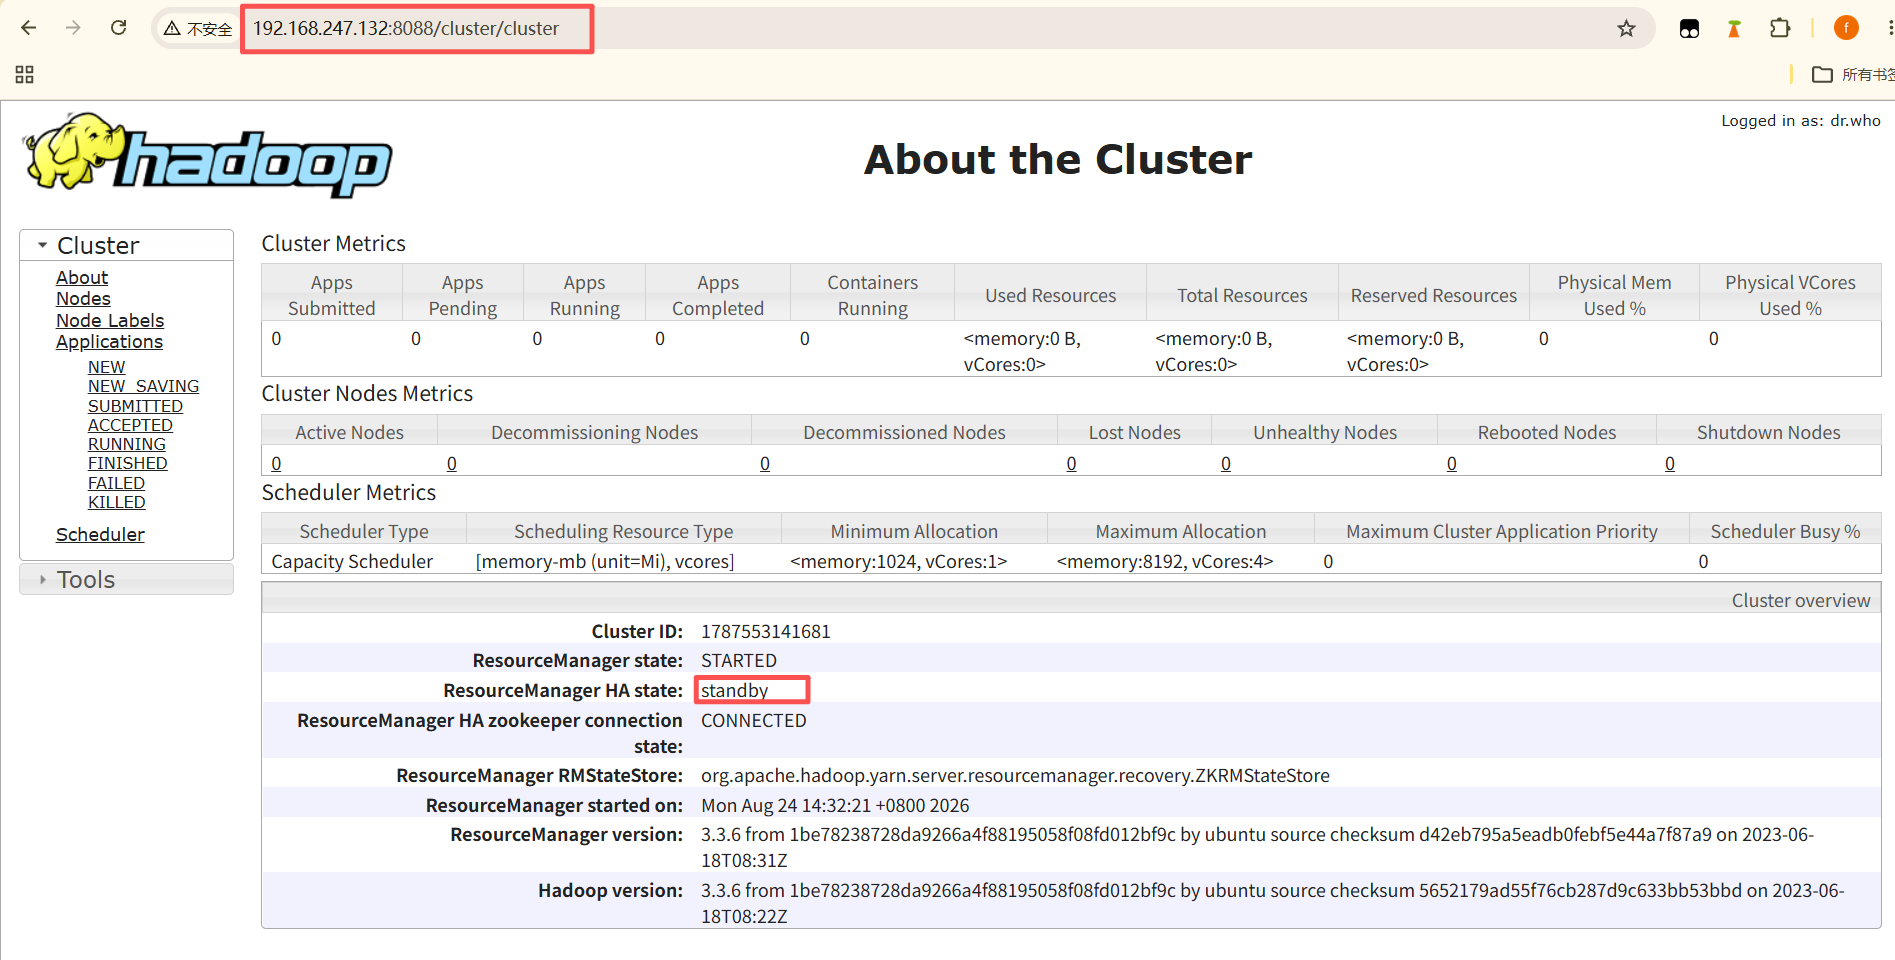
系统环境:Centos7 selinux and iptables is disabled
Hadoop 、jdk、zookeeper程序使用nfs共享同步配置文件
软件版本:hadoop-3.3.6.tar.gz
apache-zookeeper-3.8.6-bin.tar.gz
jdk-8u181-linux-x64.tar.gz
主机列表
|-----------------|-------|--------------------------------------------------|
| IP | 主机名 | 角色 |
| 192.168.247.132 | node1 | NameNode DFSZKFailoverController ResourceManager |
| 192.168.36.133 | node2 | JournalNode QuorumPeerMain DataNode NodeManager |
| 192.168.36.134 | node3 | JournalNode QuorumPeerMain DataNode NodeManager |
| 192.168.36.135 | node4 | JournalNode QuorumPeerMain DataNode NodeManager |
| 192.168.36.136 | node5 | NameNode DFSZKFailoverController ResourceManager |
node2~node5:
yum install -y nfs-utils
mount 192.168.247.132:/home/hadoop/ /home/hadoop/
zookeeper集群部署
安装zookeeper
修改目录所有权
root@node1 \~# chown -R hadoop:hadoop /home/hadoop/apache-zookeeper-3.8.6-bin
清理之前的数据
hadoop@node1 \~$ rm -fr /tmp/*
hadoop@node2 \~$ rm -fr /tmp/*
hadoop@node3 \~$ rm -fr /tmp/*
修改配置文件
hadoop@node2 \~$ cd /home/hadoop/apache-zookeeper-3.8.6-bin/conf
hadoop@node2 conf$ cp zoo_sample.cfg zoo.cfg
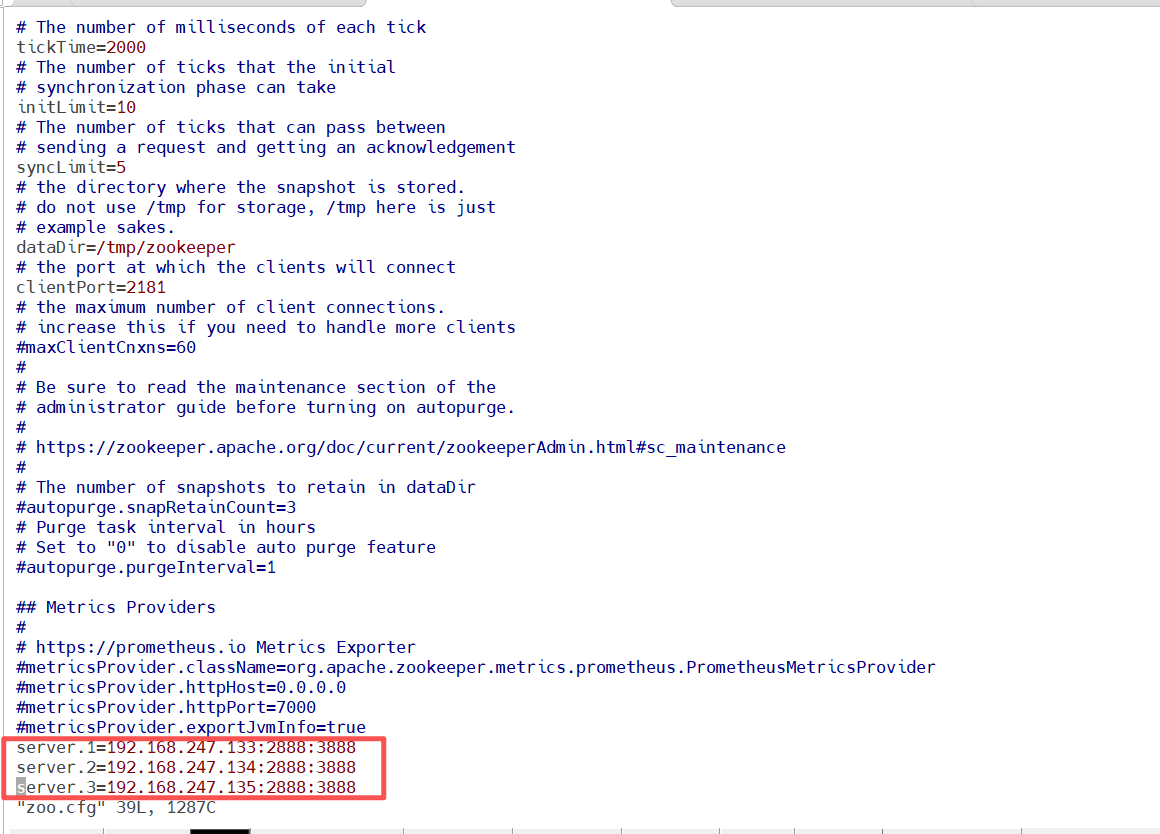
在/tmp/zookeeper目录中创建myid文件,写入一个唯一的数字
hadoop@node2 \~$ mkdir /tmp/zookeeper
hadoop@node2 \~$ echo 1 > /tmp/zookeeper/myid
hadoop@node3 \~$ echo 2 > /tmp/zookeeper/myid
hadoop@node4 \~$ echo 3 > /tmp/zookeeper/myid
在各节点启动服务
bin/zkServer.sh start
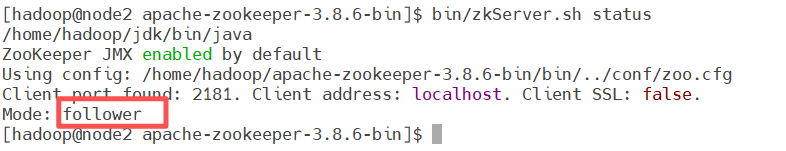
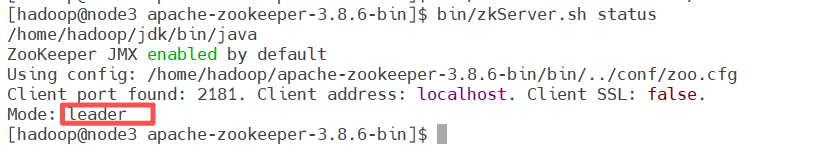
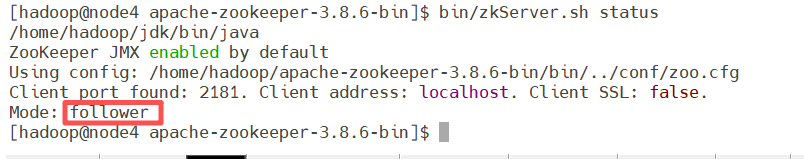
查看节点状态
bin/zkServer.sh status
Hadoop配置
编辑 core-site.xml
hadoop@node1 hadoop$ vim /home/hadoop/hadoop/etc/hadoop/core-site.xml
<configuration>
<property>
<name>fs.defaultFS</name>
<value>hdfs://masters</value>
</property>
<property>
<name>ha.zookeeper.quorum</name>
<value>192.168.247.133:2181,192.168.247.134:2181,192.168.247.135:2181</value>
</property>
</configuration>
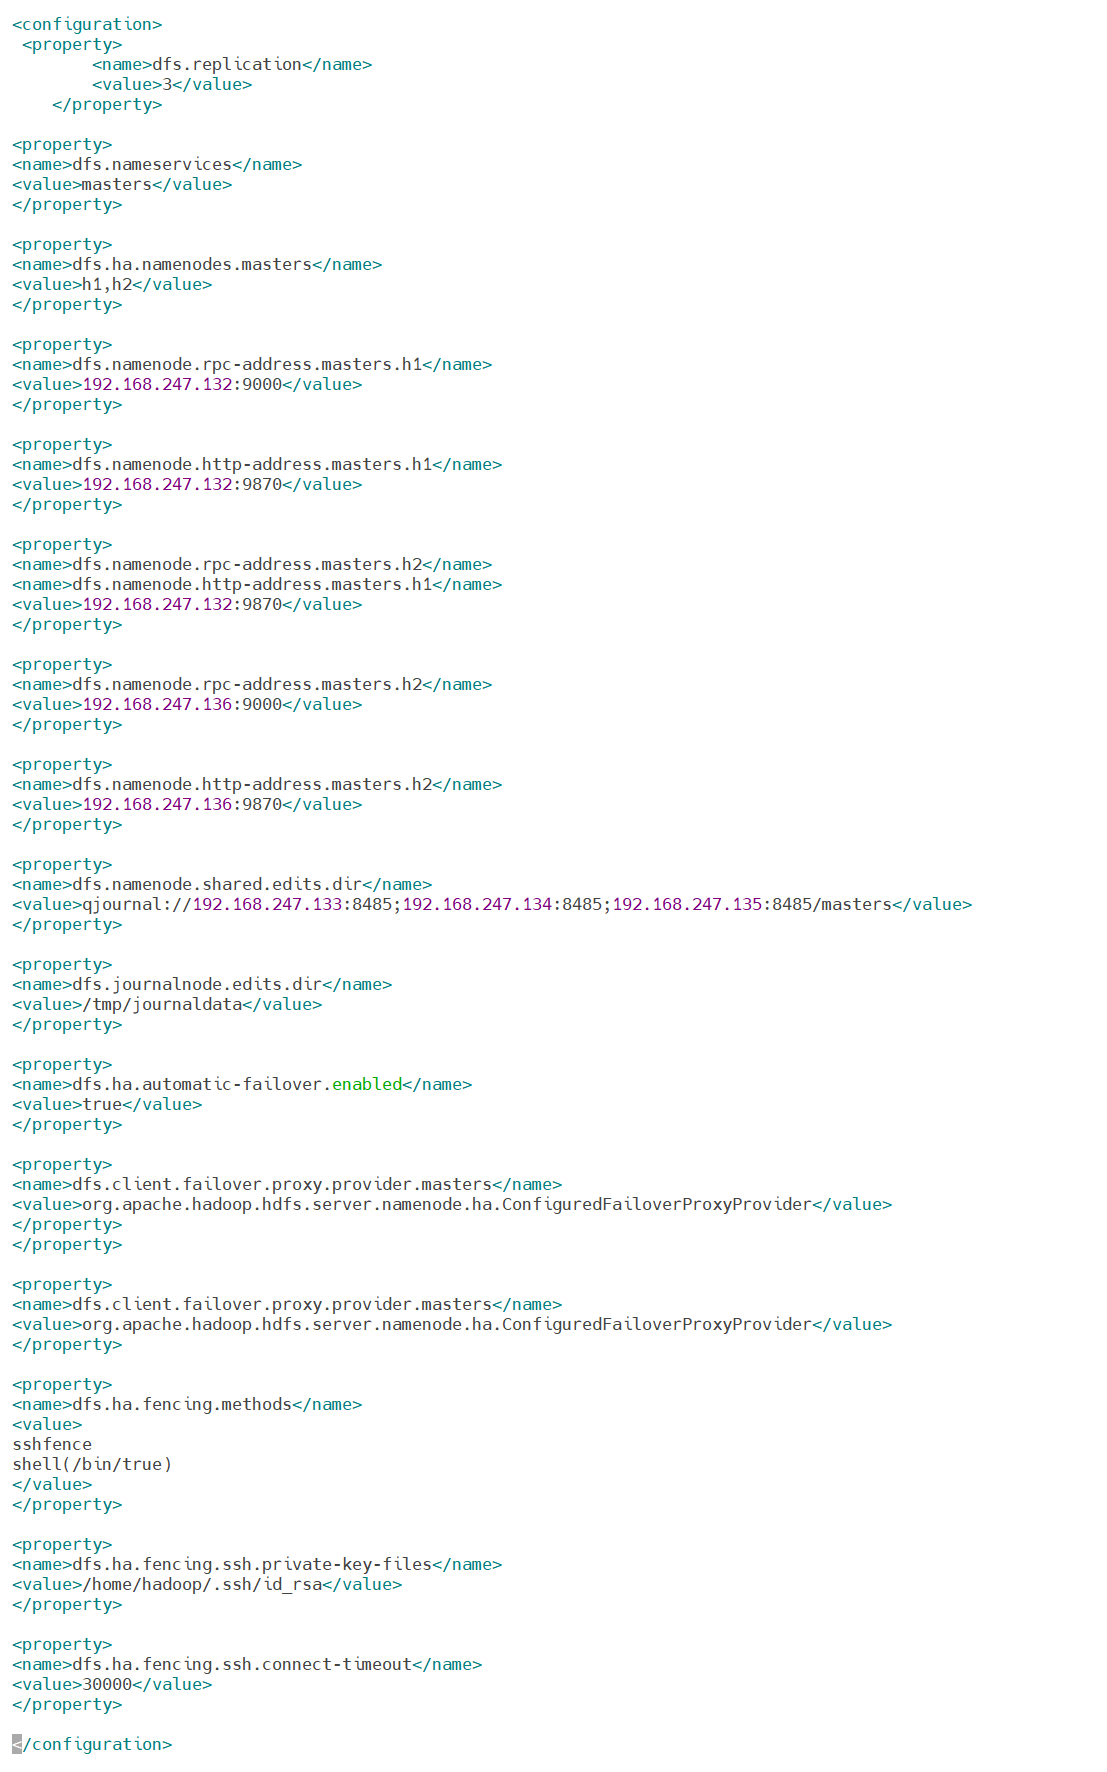
编辑 hdfs-site.xml
启动hdfs集群(按顺序启动)
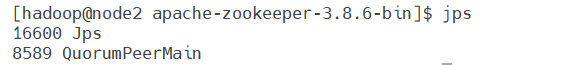
确认启动zookeeper集群(node2、node3、node4)
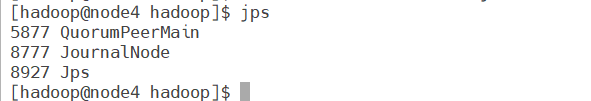
在三个DN上依次启动journalnode(第一次启动hdfs必须先启动journalnode)
hadoop@node4 \~ cd hadoop \[hadoop@node4 hadoop\] bin/hdfs --daemon start journalnode
格式化HDFS集群(node1上执行)
hadoop@node1 hadoop$ bin/hdfs namenode -format
Namenode数据默认存放在/tmp,需要把数据拷贝到h2
hadoop@node1 hadoop$ scp -r /tmp/hadoop-hadoop node5:/tmp
格式化zookeeper (只需在h1上执行即可)
hadoop@node1 hadoop$ bin/hdfs zkfc -formatZK
启动hdfs集群(只需在h1上执行即可)
hadoop@node1 hadoop$ sbin/start-dfs.sh
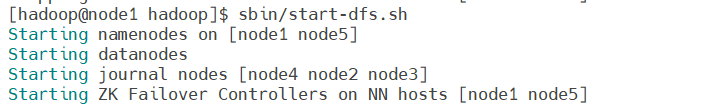
查看各节点状态
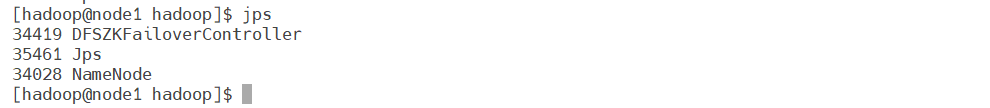
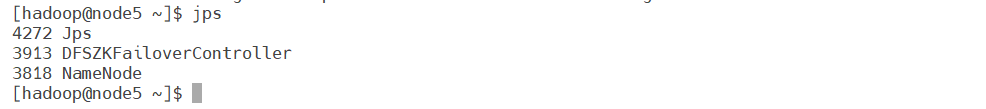
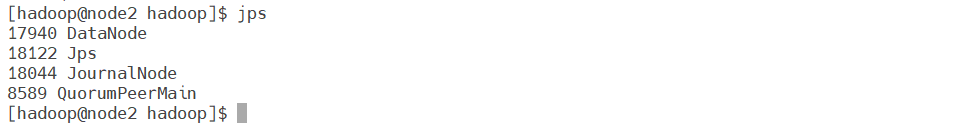
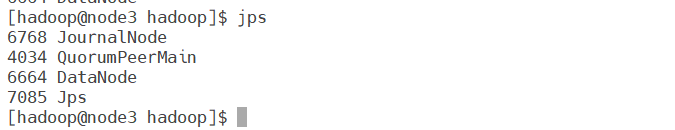
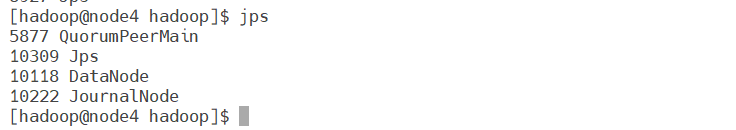
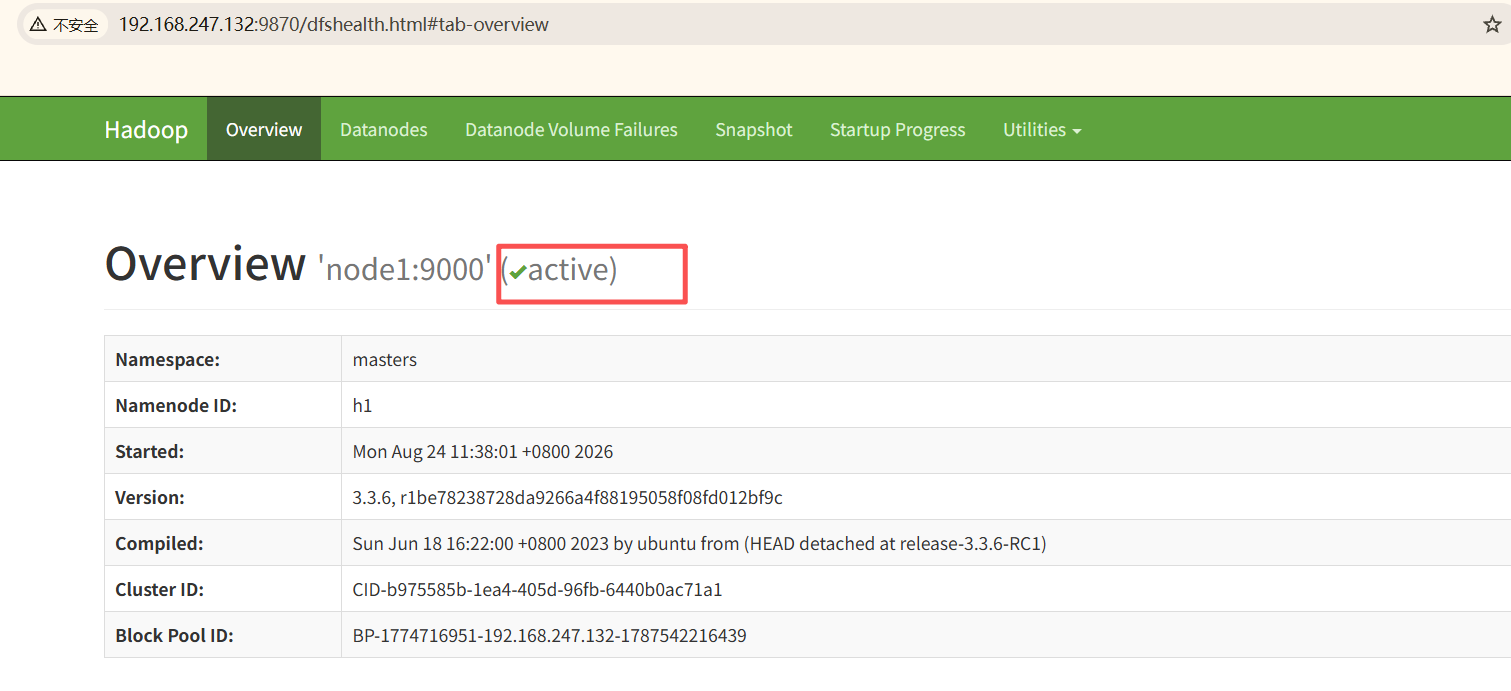
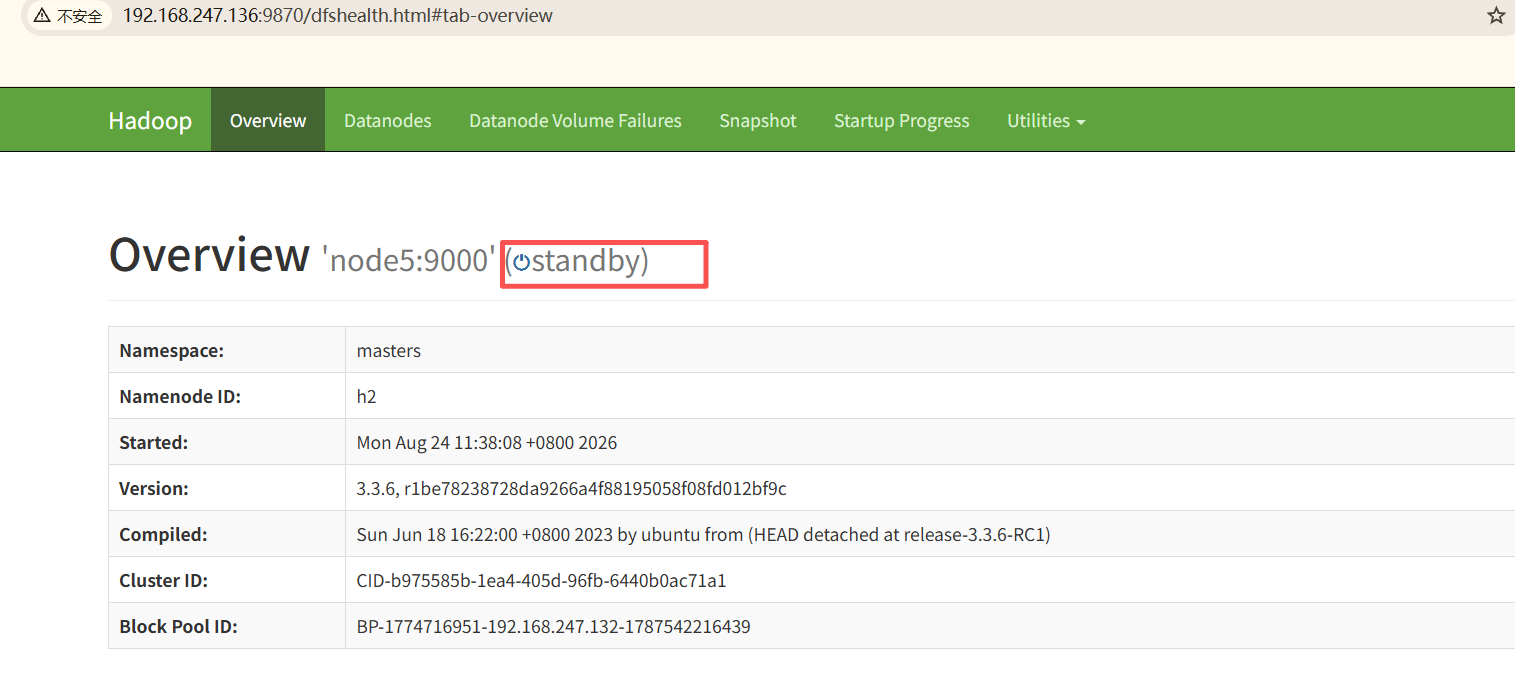
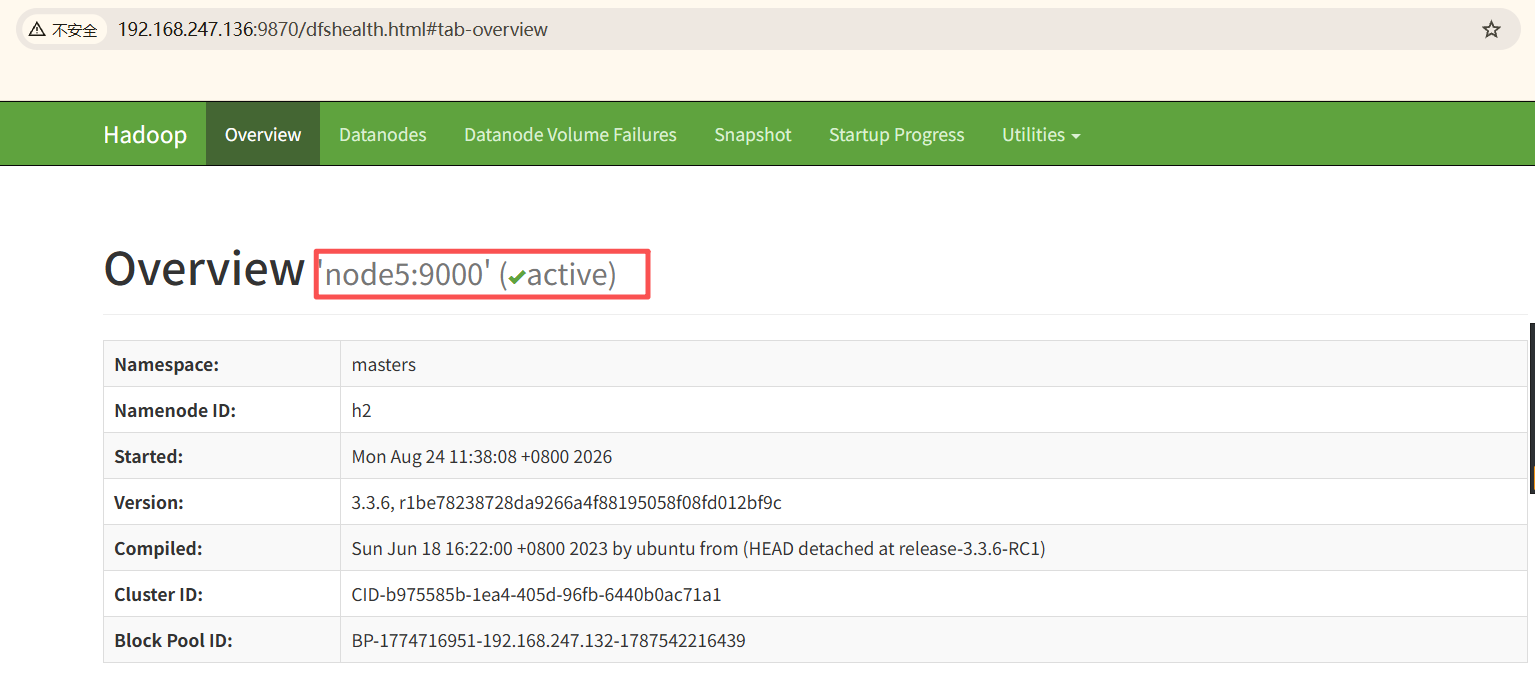
测试故障自动切换
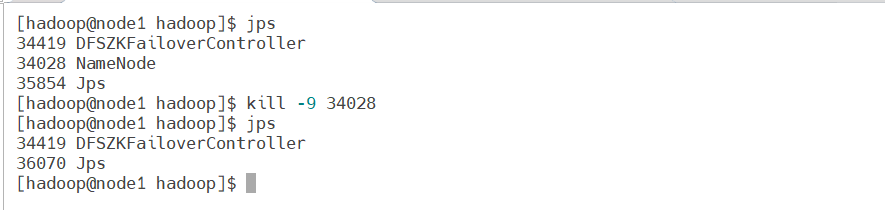
杀掉h1主机的namenode进程后依然可以访问,此时h2转为active状态接管namenode
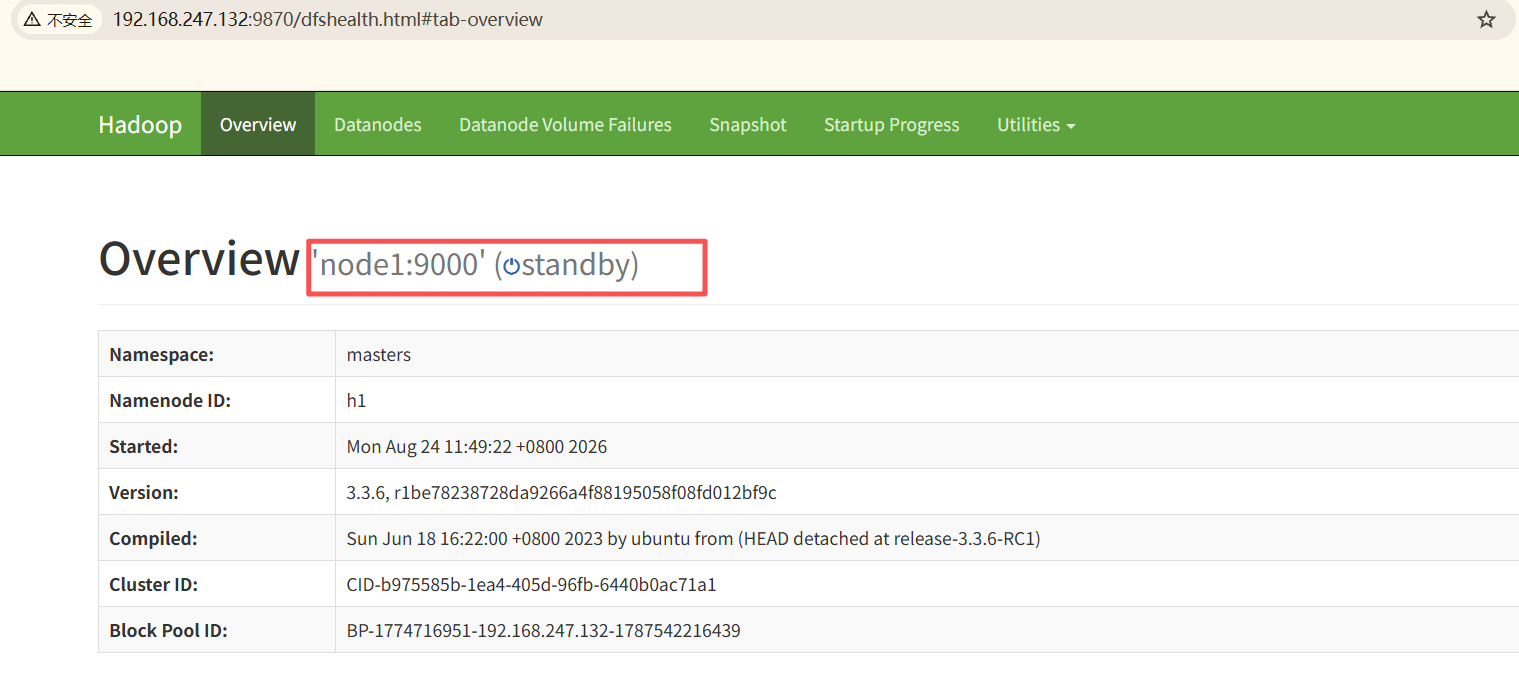
hadoop@node1 hadoop$ bin/hdfs --daemon start namenode
启动h1上的namenode,此时为standby状态
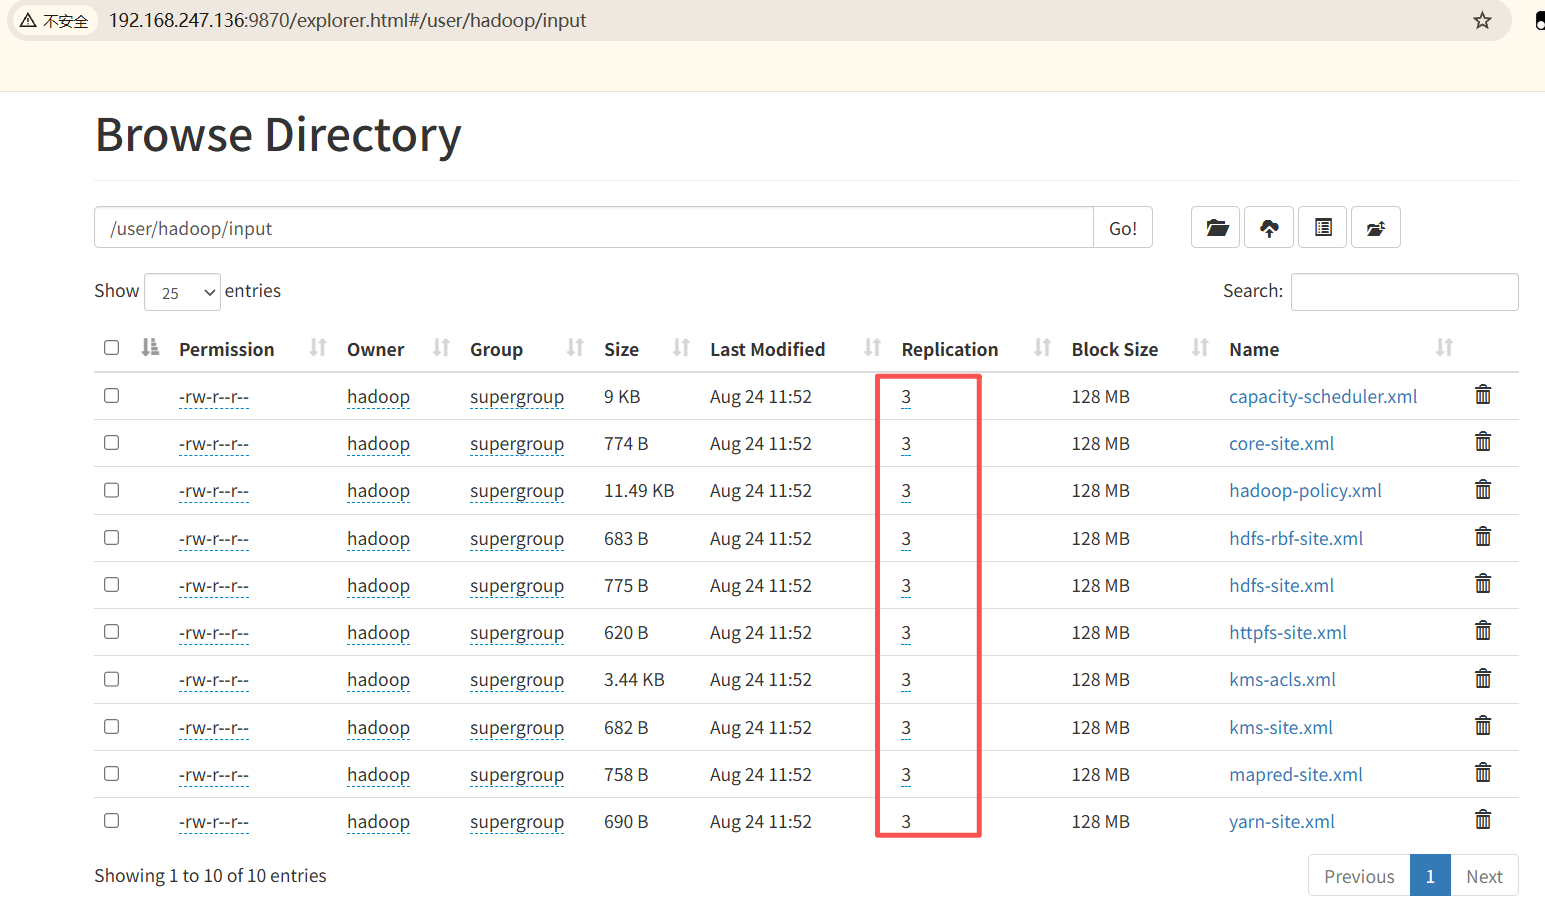
hadoop@node5 hadoop$ bin/hdfs dfs -mkdir /user
hadoop@node5 hadoop$ bin/hdfs dfs -mkdir /user/hadoop
hadoop@node5 hadoop$ bin/hdfs dfs -put input
yarn高可用 配置
编辑 mapred-site.xml
hadoop@node1 \~$ cd /home/hadoop/hadoop/etc/hadoop
hadoop@node1 hadoop$ vim mapred-site.xml
<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
<property>
<name>mapreduce.application.classpath</name>
<value>HADOOP_MAPRED_HOME/share/hadoop/mapreduce/\*:HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>
</property>
</configuration>
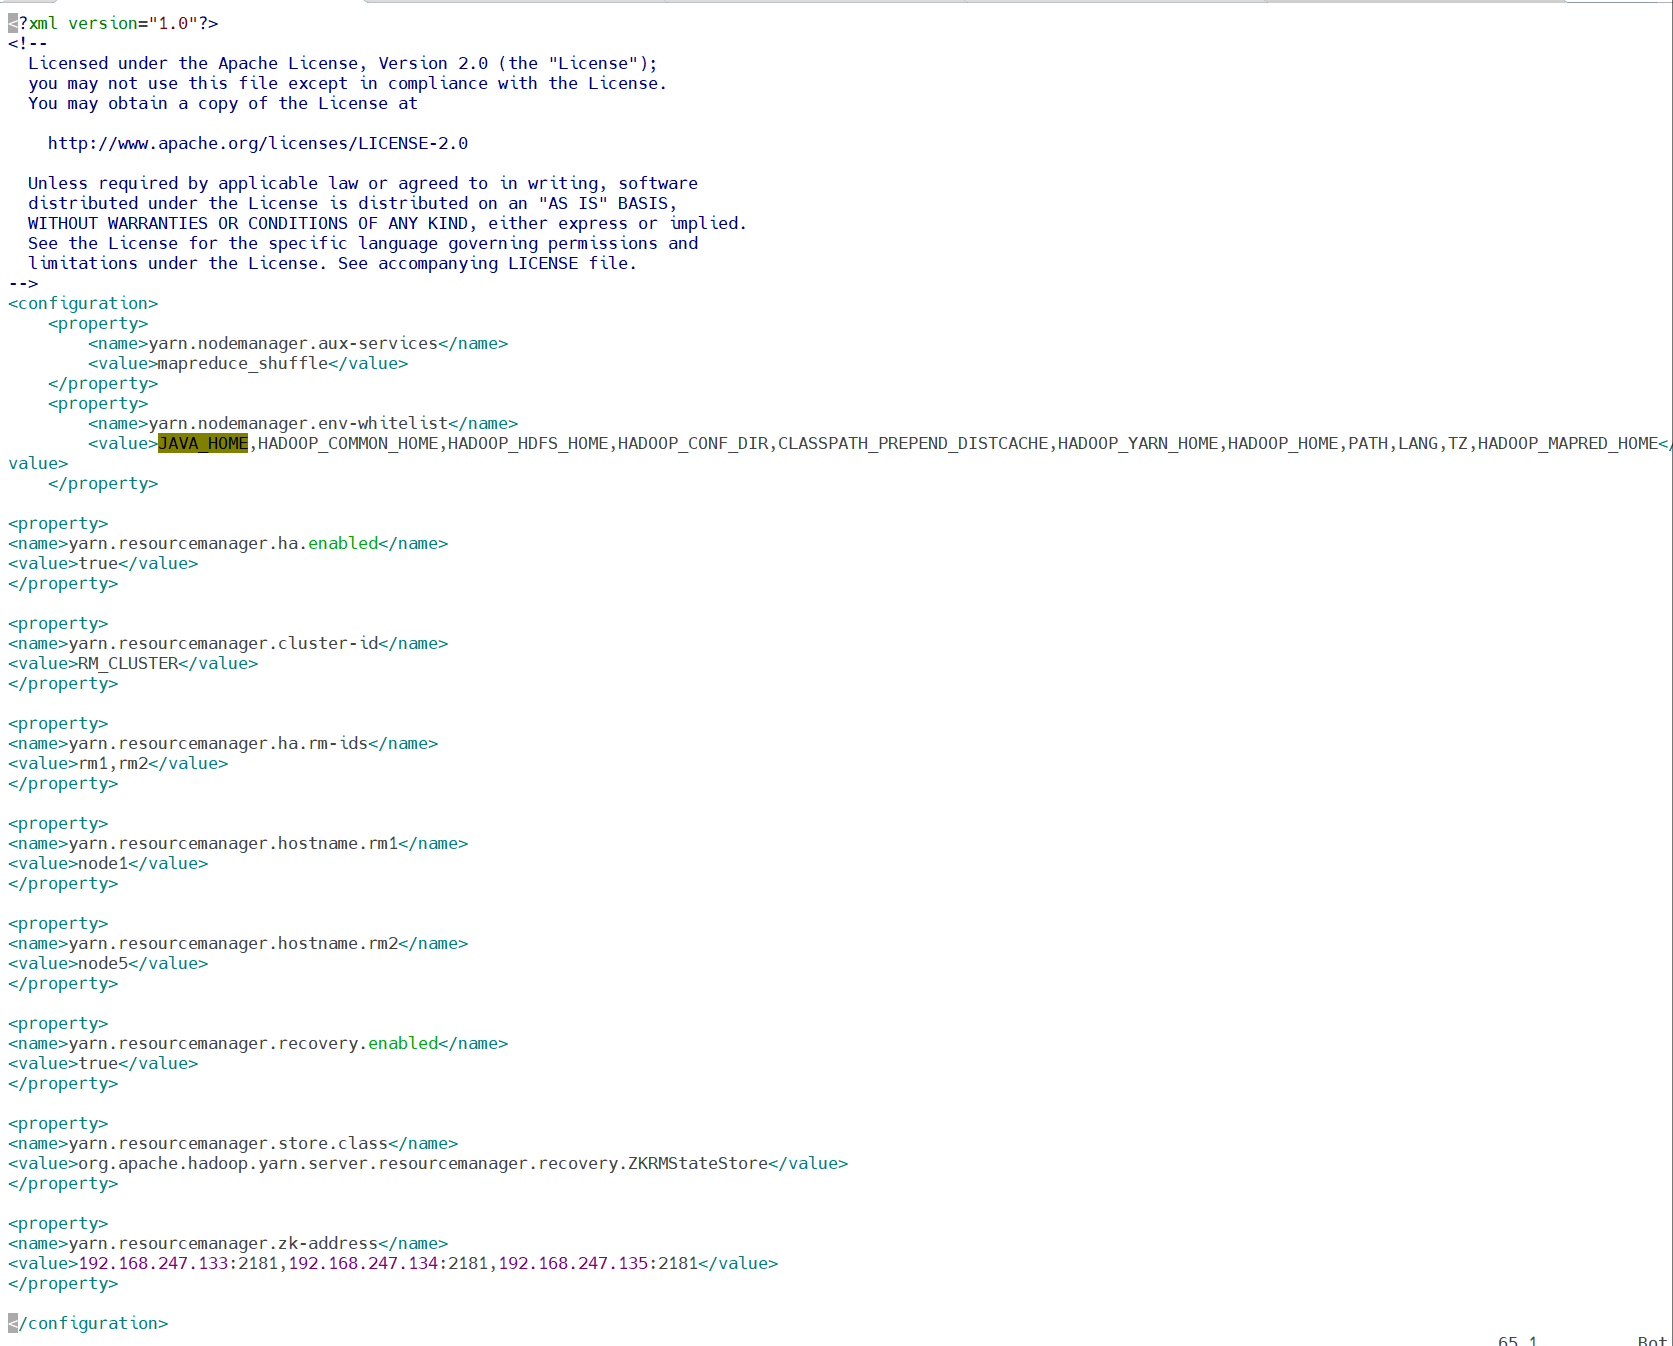
编辑 yarn-site.xml
启动yarn服务
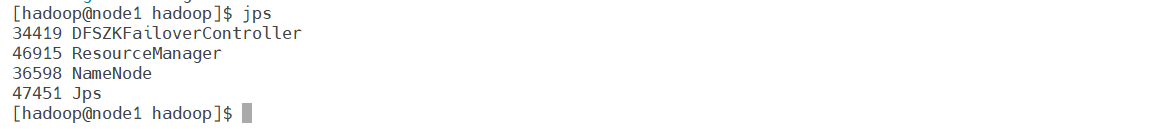
hadoop@node1 hadoop$ sbin/start-yarn.sh

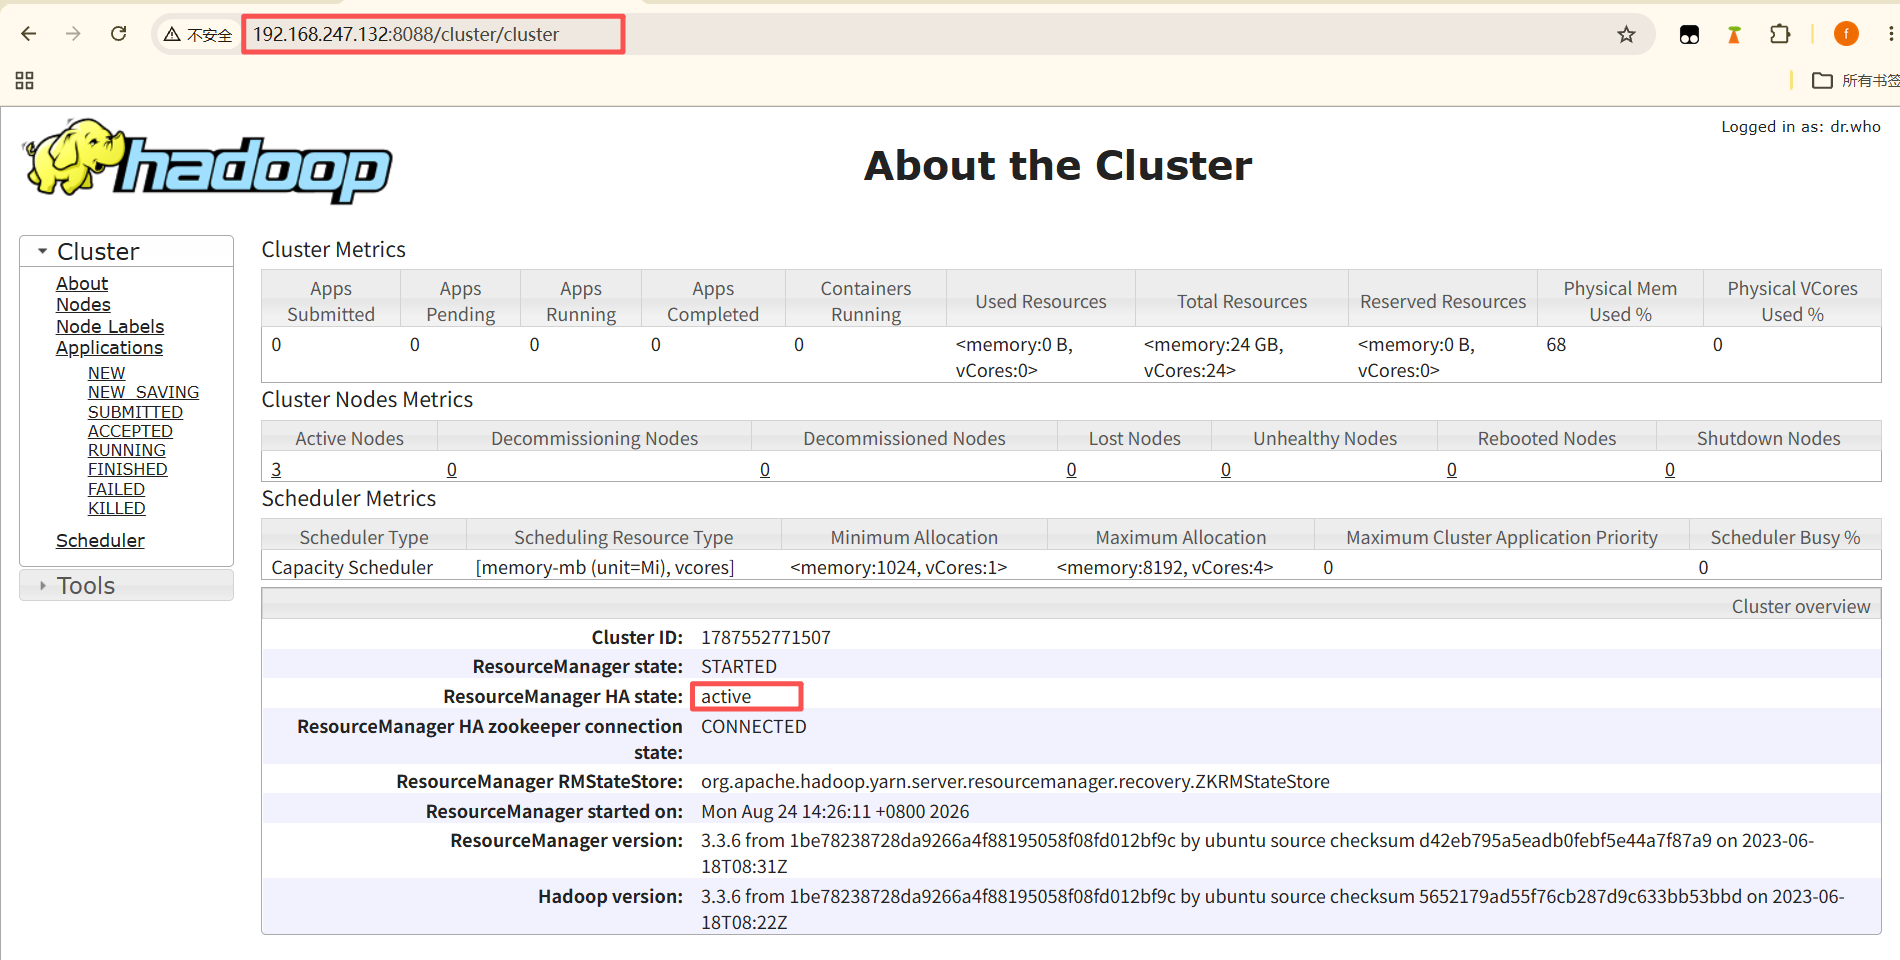
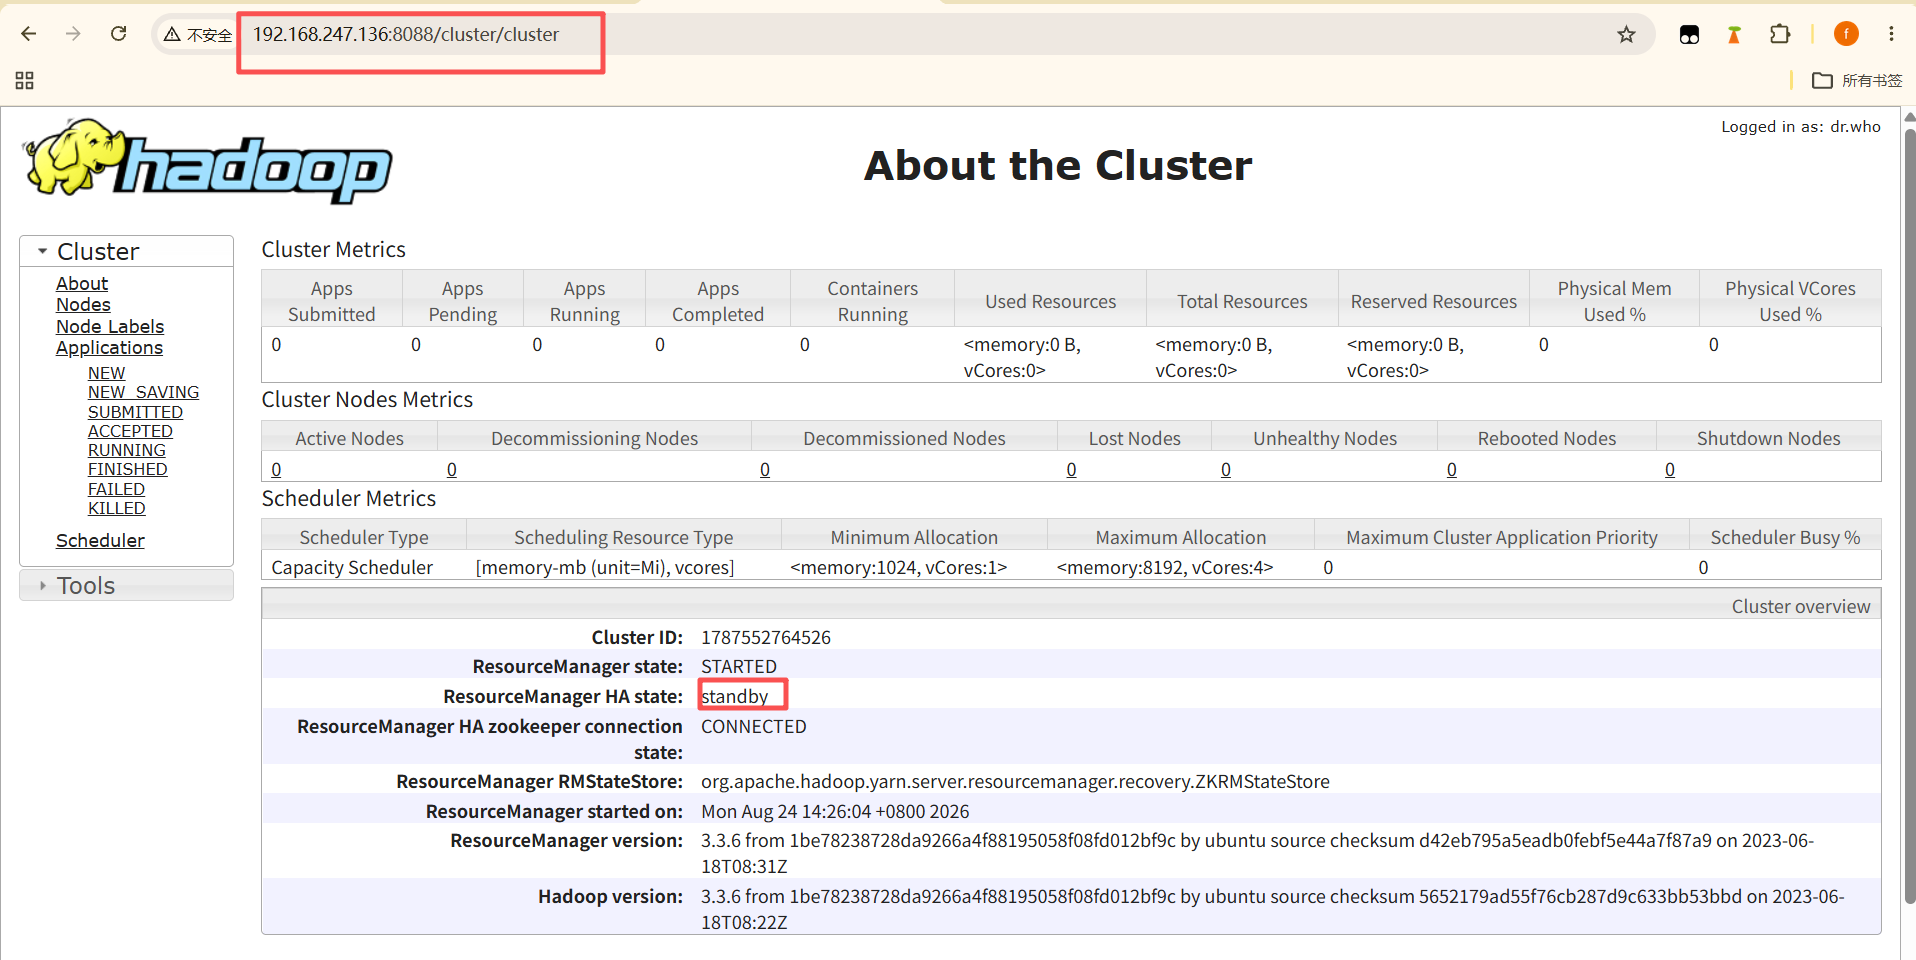
测试yarn故障切换
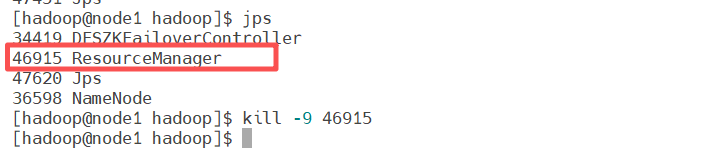
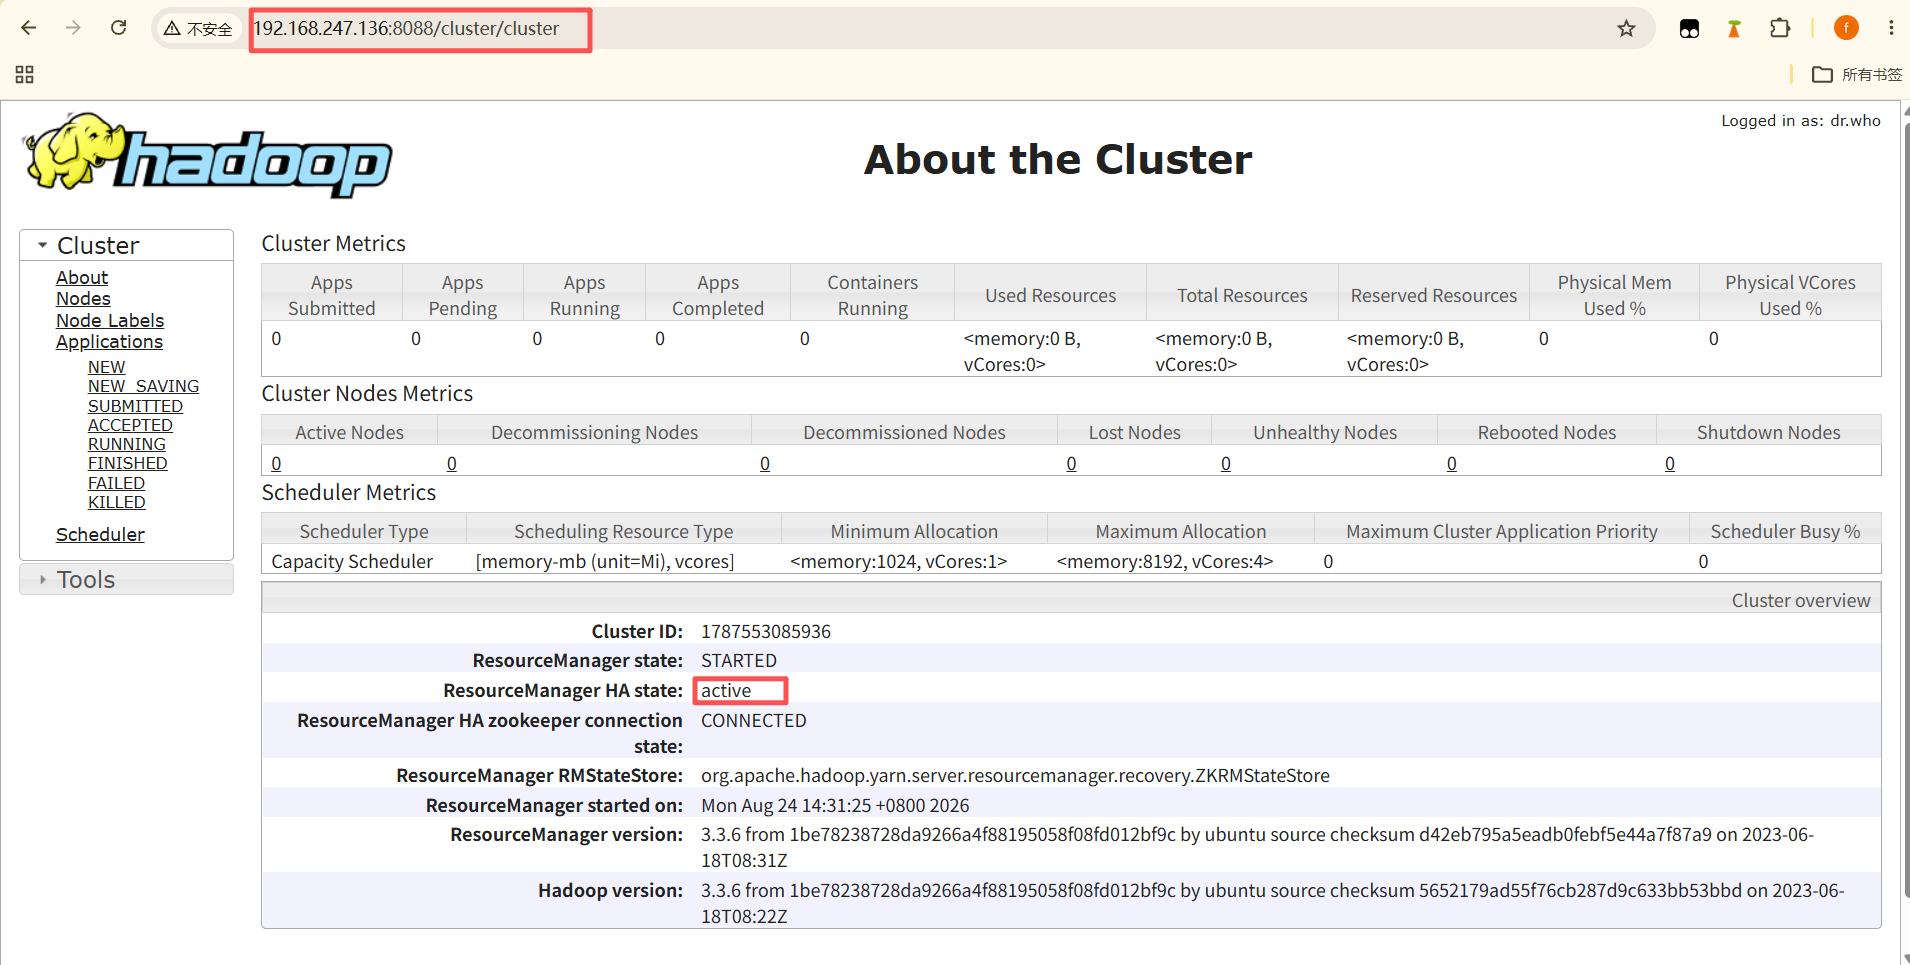
稍后手动恢复rm