你这里说的 OPD ,在当前 LLM 后训练 / Agent 语境里,通常指 On-Policy Distillation,在线策略蒸馏。
先给结论:
OPD 不是"比 RL 更先进、准备取代 RL"的方法。
它解决的是 RL 的一个核心短板:RL 的 reward 通常太稀疏,而 OPD 可以让强 Teacher 在 Student 自己实际走到的状态上,逐 token 告诉它"这里应该怎么做"。
因此截至 2026 年 8 月 ,更值得关注的趋势已经不是单纯的 OPD vs RL,而是:
On-policy rollout + Teacher dense supervision + RL outcome reward \boxed{\text{On-policy rollout}+\text{Teacher dense supervision}+\text{RL outcome reward}} On-policy rollout+Teacher dense supervision+RL outcome reward
即 OPD × RL 混合训练 ,尤其是在 long-horizon Agent / Tool Use / Agentic Search 上。
原始 On-Policy Distillation / GKD 工作已经证明了 student-generated trajectories 可以显著缓解传统 distillation 的 distribution mismatch;而 2026 年的研究正在集中解决 long-horizon agent、teacher-student mismatch、训练效率以及 OPD 与 RL 的融合。(arXiv)
一、先从你刚才理解的 GRPO 接上来
刚才我们讲 RL:
text
Question
   ↓
Student rollout
   ↓
Think
Search
Observe
Think
Search
Answer
   ↓
最终 Reward = 1
   ↓
GRPO
最大的问题是什么?
假设 Agent 生成了 1000 个 token:
text
Think A
↓
Search A
↓
Observe
↓
Think B
↓
Search B
↓
Observe
↓
Think C
↓
Answer
最后:
text
Reward = 0你只知道:
"这一整条轨迹不好。"
但你不知道:
text
Think A 是否正确?
Search A 是否正确?
Think B 是否开始出错?
Search B 的 query 哪个 token 不好?
这就是之前讲的:
Sparse Reward + Credit Assignment
二、OPD 的思路完全不同
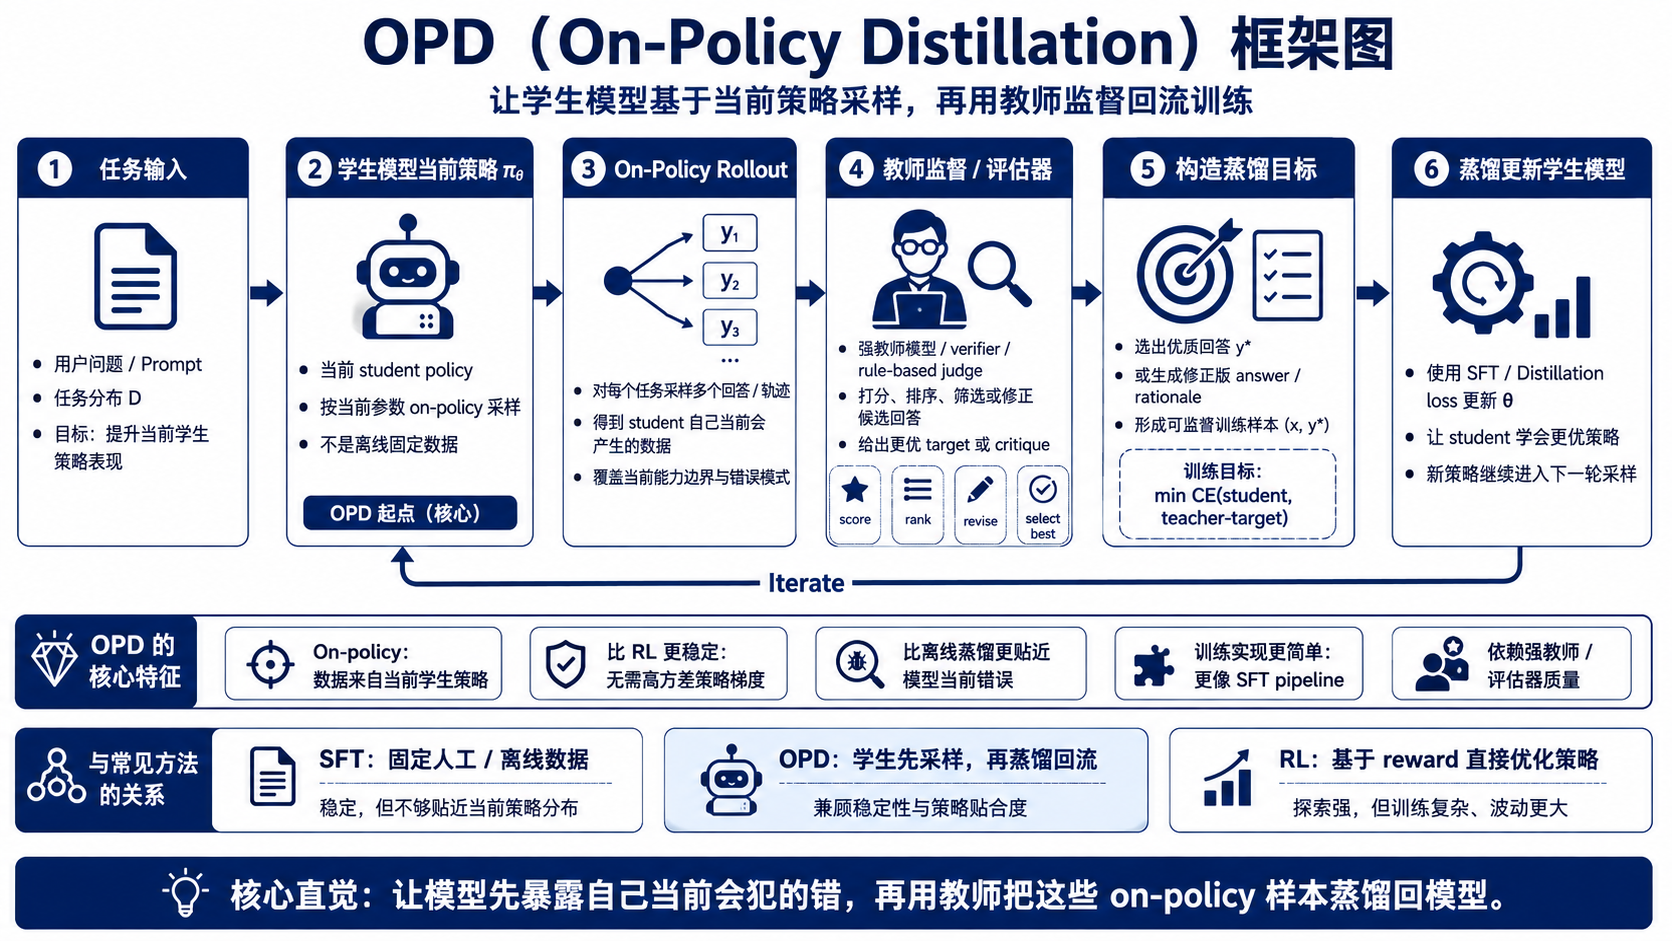
OPD 说:
既然我已经有一个很强的 Teacher,为什么非得等整个 trajectory 结束才告诉 Student 对不对?
可以让:
text
Student
自己走

↓

Teacher
一路看着它走

↓

每一步告诉它:
"如果是我,我下一 token 会怎么选。"
于是:
text
Student trajectory:

<s>
I need to first identify...
当前 Student:
π S ( ⋅ ∣ s t ) \pi_S(\cdot|s_t) πS(⋅∣st)
可能认为:
text
search      0.40
answer      0.25
inspect     0.10
other       ...
Teacher 看同一个 state:
π T ( ⋅ ∣ s t ) \pi_T(\cdot|s_t) πT(⋅∣st)
给出:
text
search      0.91
answer      0.02
inspect     0.03
...
于是:
Student 不需要等到任务结束,就已经得到一个非常强的学习信号:
text
这里应该更倾向 Search
而不是直接 Answer
三、最核心的区别就在这里
RL
Teacher / Verifier 说:
text
这一整道题:

7 / 10
OPD
Teacher 基本是在说:
text
token 1:这里应该选 A
token 2:这里 B 概率应该更高
token 3:这个 reasoning direction 不太对
token 4:这里应该 search
token 5:query 应该这样写
...
所以可以把两者粗略理解成:
R L = O u t c o m e S u p e r v i s i o n \boxed{ RL = Outcome Supervision } RL=OutcomeSupervision
而:
O P D = D e n s e P o l i c y S u p e r v i s i o n \boxed{ OPD = Dense Policy Supervision } OPD=DensePolicySupervision
这也是为什么最近很多工作把 OPD 称为一种很有吸引力的 post-training paradigm。(arXiv)
四、OPD 为什么叫 On-Policy?
这里非常容易和普通蒸馏混掉。
普通知识蒸馏
Teacher 先生成:
text
Question
    ↓
Teacher
    ↓
Trajectory A
然后 Student 学:
text
Trajectory A例如:
text
Teacher:

Think A
→ Search A
→ Think B
→ Answer
Student SFT:
text
模仿 Teacher trajectory问题:
Student 真正 inference 时可能根本不会走到 Teacher 的这些状态。
例如 Teacher:
text
Step 1 → A
Step 2 → B
Step 3 → C
Student 实际:
text
Step 1 → A
Step 2 → X
然后它到了:
text
AX这个状态。
但训练数据里:
text
从来没有 AX所以 Student:
"我现在不知道怎么办了。"
这就是:
Distribution Shift / Exposure Bias
五、On-Policy 的关键就是:让 Student 自己犯错
OPD:
text
Question
   ↓

Student rollout

   ↓

Student:
A
↓
X
↓
????
Teacher 不要求 Student 重走:
text
A → B → C而是 Teacher 来到 Student 的当前状态:
text
A → X然后问 Teacher:
"如果已经走到 AX,你下一步会怎么走?"
Teacher:
text
AX → YStudent 学:
text
AX → Y这就是 OPD 最漂亮的地方。
原始 GKD 工作将自回归生成形式化成 token-level MDP,并让 student 在自己生成的状态 上模仿 teacher 的 next-token distribution,从而缓解纯 teacher-forcing 带来的分布不匹配。(arXiv)
六、所以 OPD 和 SFT 最大区别也在这里
可以直接记:
| SFT / Off-policy Distillation | OPD | |
|---|---|---|
| Trajectory 谁生成 | Teacher / Dataset | Student |
| Student 学什么状态 | Teacher 遇到的状态 | Student 自己遇到的状态 |
| 犯错之后有监督吗 | 很少 | 有 |
| Distribution mismatch | 明显 | 较小 |
| 数据分布 | 固定 | 随 Policy 变化 |
这意味着:
text
SFT:
教优秀学生看标准答案

OPD:
跟着学生做题,
学生做错以后现场指导
这个类比其实相当准确。
七、OPD 的 loss 是什么?
最简单的版本就是让:
π S \pi_S πS
逼近:
π T \pi_T πT
例如:
$$
L_{OPD}
\sum_t
D_{KL}
\left(
\pi_T(\cdot|s_t)
|
\pi_S(\cdot|s_t)
\right)
$$
其中关键是:
s t ∼ π S s_t \sim \pi_S st∼πS
也就是:
这些 state 是 Student 自己 rollout 出来的。
这才叫 On-Policy。
不过实际 OPD 不局限于 Forward KL。GKD 系统研究了 Forward KL、Reverse KL 和 JSD;其中 reverse KL 等 mode-seeking objective 在不少实验中表现更好。(arXiv)
比如 reverse KL:
D K L ( π S ∥ π T ) D_{KL} ( \pi_S \| \pi_T ) DKL(πS∥πT)
倾向于让 Student:
重点学习 Teacher 高概率的优秀模式。
八、那 OPD 相较于 RL 到底有什么优势?
这个问题最重要。
优势 1:Reward 极其密集
RL:
text
1000 tokens

↓

Reward = 1
只有一个信号。
OPD:
text
token 1 → Teacher distribution
token 2 → Teacher distribution
token 3 → Teacher distribution
...
token 1000 → Teacher distribution
相当于:
1000 1000 1000
个监督信号。
所以:
O P D 的 C r e d i t A s s i g n m e n t 明显比纯 O u t c o m e R L 容易 \boxed{ OPD 的 Credit Assignment 明显比纯 Outcome RL 容易 } OPD的CreditAssignment明显比纯OutcomeRL容易
九、优势 2:不用等模型偶然探索到正确答案
之前讲 GRPO 最大的问题:
text
Group size = 8

Reward:
0
0
0
0
0
0
0
0
那:
text
Advantage ≈ 0基本学不到。
OPD 不一样。
即使 Student:
text
完全不会解Teacher 仍然可以在 Student 当前 state 上告诉它:
text
下一步你应该这样走所以学习信号不会完全消失。
这也是为什么 OPD 通常:
Sample Efficiency 更好、Early Training 更容易启动。
十、优势 3:不需要设计复杂 Reward
Agent RL 里你之前已经看到:
text
Answer Reward
Evidence Reward
Citation Reward
Search Cost Reward
Format Reward
...
然后还会出现:
text
Reward HackingOPD 可以简单很多:
text
Teacher:

这是我的 policy distribution

↓

Student:

跟它靠近
核心 supervision 直接来自 Teacher。
所以不必人为定义:
text
"一个 Search query 应该给多少 reward?"十一、优势 4:特别适合小模型 Agent 化
比如:
text
Teacher:

Qwen3-32B Agent
Student:
text
Qwen3-4B你希望 Student 学:
text
什么时候 Search
怎么调用工具
怎么 Plan
怎么修正错误
怎么停止
SFT只能给:
text
一些固定优秀 trajectoryOPD 可以:
text
4B Student 自己跑
        ↓
出现它真正容易犯的问题
        ↓
32B Teacher
在这些状态进行指导
因此对:
大 Agent → 小 Agent 能力迁移
很有吸引力。
2026 年 Guided-OPD 就用 Qwen3 大 Teacher 向更小 Student 蒸馏多轮 Agent 能力,并专门处理小 Student 多轮错误累积问题。(arXiv)
十二、把 RL 和 OPD 放一起看就非常清晰了
| RL / GRPO | OPD | |
|---|---|---|
| 谁告诉模型好不好 | Reward / Verifier | Teacher Model |
| 信号 | Scalar Reward | Token Distribution |
| 信号密度 | 稀疏 | 极密集 |
| Credit Assignment | 难 | 容易很多 |
| 是否需要 Teacher | 不一定 | 需要 |
| 是否需要 Reward | 是 | 不一定 |
| 探索能力 | 强 | 较弱 |
| 能否超过 Teacher | 理论上可以 | 容易受 Teacher ceiling 限制 |
| 学新策略 | 更有潜力 | 主要模仿 Teacher |
| Reward Hacking | 有 | 少很多,但有其他 pathology |
| Teacher Error | 不敏感 | 容易继承 |
| Long Horizon | sparse reward严重 | teacher cost严重 |
| 数据 | On-policy | On-policy |
注意最后:
两者都是 on-policy。
区别不在 on-policy。
区别主要是:
text
RL:

on-policy trajectory
+
reward
vs
text
OPD:

on-policy trajectory
+
teacher distribution
十三、但是这里我要纠正一个很容易产生的印象
你可能会想:
OPD 有 dense reward,那是不是全面优于 RL?
不是。
OPD 有几个非常明显的天花板。
十四、第一个:Teacher Ceiling
假设:
text
Teacher
只能做到 80%
你一直让 Student:
π S → π T \pi_S \rightarrow \pi_T πS→πT
那么:
Student 最终主要是在复制 Teacher。
Teacher 错了:
text
Student也被要求学它的错误MAD-OPD 2026 就把这个称作 single-teacher capability ceiling,并尝试通过多个 Teacher debate 后形成集体监督来缓解。(arXiv)
而 RL 不一样。
假如 Verifier 客观:
text
Teacher strategy → reward 0

Student自己探索的新策略 → reward 1
RL:
可以强化 Student 自己发现的新策略。
所以:
R L 的真正优势是探索 \boxed{ RL 的真正优势是探索 } RL的真正优势是探索
十五、第二个问题:Teacher--Student Gap
这个问题现在很热门。
假设:
text
Teacher = 671B
Student = 1.5B
Teacher:
text
复杂 reasoning
复杂 long-horizon plan
Student:
根本没有 capacity 表达这种 policy。
于是 Teacher 虽然很强:
text
Teacher distribution对 Student 却未必是有效学习目标。
2026 年系统研究发现 OPD 成功依赖至少两个重要条件:
- Student 与 Teacher 的 thinking pattern 要较兼容;
- Teacher 又必须提供 Student 当前训练分布中真正缺少的能力。
Teacher 太接近,没什么新东西;差得太远,又可能教不进去。(arXiv)
这其实很像一个:
Teacher--Student Sweet Spot
十六、尤其 Agent 场景更加严重
普通 math:
text
Student错一个token可能还能继续。
Agent:
text
Turn 1
Search错了

↓

Observation完全不同

↓

Turn 2 state不同

↓

Turn 3进一步漂移

↓

Turn 10
已经进入另一条世界线
即:
Compounding Error
因此 Vanilla OPD 对 long-horizon Agent 并没有想象中那么简单。
Guided-OPD 2026 的解决方式非常典型:
text
训练前期:

Teacher intervention多
Student不会走太偏

↓

训练中期:

逐渐减少 Teacher intervention

↓

训练后期:

纯 Student on-policy
类似 curriculum。(arXiv)
十七、第三个问题:OPD 其实很贵
想一下。
Student rollout:
text
2000 tokens每一个 Student state:
text
Teacher
都需要给 vocabulary distribution
假如:
text
vocab = 150K
Teacher = 32B / 72B
那成本很高。
RL:
text
Student rollout
+
最终 verifier
OPD:
text
Student rollout

+

Teacher Forward
Teacher Forward
Teacher Forward
...
所以 OPD 最大的工程瓶颈之一就是:
Teacher Inference Cost
Lightning OPD 2026 就是专门解决这个问题:尝试把 teacher logits 预计算下来,让 OPD 不再要求训练期间维持 live teacher server;论文报告在其设置中取得约 4× 训练加速。(arXiv)
十八、Agentic Search 下成本更夸张
比如:
text
Student

Think
Search
Observe 4K tokens

Think
Search
Observe 5K

Think
Search
Observe 6K
...
如果每一个 turn:
text
Teacher重新forward整个context成本会爆炸。
因此 2026 出现:
TurnOPD
它明确针对 long-horizon Agent 发现两个问题:
text
① 后面很多 turn
Teacher supervision价值越来越低

② token-level KL
过多集中在前面的 shallow turn
所以提出:
text
Adaptive Rollout Depth
+
Turn-normalized Loss
并在:
- ALFWorld
- WebShop
- Multi-Hop Search
上测试。(arXiv)
这个和 Agentic Search 非常相关。
十九、还有一个非常重要的新发现:OPD 不一定"增加能力上限"
这是 2026 年目前非常值得关注的研究。
以前大家容易认为:
text
Teacher更强

↓

OPD

↓

Student获得Teacher的新能力
但现在证据没这么简单。
2026 年 8 月一篇专门从 Test-Time Scaling 观察 OPD 的工作发现:
text
OPD后:

avg@K ↑
也就是平均采样更容易正确。
但是随着:
text
K越来越大pre-OPD model 在 pass@K 上甚至重新取得优势。
作者进一步用 pass@1024 分析发现,OPD 可能让某些本来可解的问题反而变得不可解。(arXiv)
二十、这和我们上一轮讲 RL 的 Distribution Sharpening 非常像
可以理解:
OPD 前
Student:
text
Strategy A  10%  ← correct
Strategy B  20%
Strategy C  20%
Strategy D  50%
Teacher 引导后:
text
Strategy A  60%
Strategy B  15%
Strategy C  10%
Strategy D  15%
于是:
text
pass@1
大涨
但原本 Student 有:
text
很多不同探索路径现在:
text
distribution更加集中所以大规模 sampling 后:
text
pass@128 / pass@1024不一定提高。
2026 年另一项分析也把 OPD 描述为一种 exploration catalyst ,强调它主要引导 Student 更频繁进入正确 reasoning path,而不是自动扩大 capability ceiling。(arXiv)
二十一、所以 OPD vs RL 的本质区别,可以用一句很关键的话概括
OPD
Teacher 告诉你往哪里走。
所以:
text
指导强
学习快
探索弱
RL
你自己探索,环境告诉你最后走得好不好。
所以:
text
指导弱
训练难
探索强
因此二者的优势实际上互补。
二十二、这就解释了为什么现在越来越热门的是 OPD + RL
可以写成:
text
                    Student
                       │
                       ↓
                 On-policy Rollout
                       │
          ┌────────────┴───────────┐
          ↓                        ↓
       Teacher                  Verifier
          ↓                        ↓
   Token-level Signal         Outcome Reward
          │                        │
          └────────────┬───────────┘
                       ↓
                   Update
对应:
L = L R L + λ L O P D L = L_{RL} + \lambda L_{OPD} L=LRL+λLOPD
其中:
L R L L_{RL} LRL
负责:
"最终任务是否完成?"
而:
L O P D L_{OPD} LOPD
负责:
"中间应该往什么方向优化?"
二十三、2026 最近一个非常典型的工作:Distilled RL
7 月的 Distilled Reinforcement Learning for LLM Post-training 就明确把:
text
RL和:
text
OPD列为两种主要 paradigm,并指出:
RL 问题
text
Outcome signal粗
Credit Assignment困难
OPD 问题
text
无条件匹配 Teacher logits

Teacher太相似 → 没新知识
Teacher差太大 → 教不进去
于是提出:
text
Distilled RL核心不是:
text
Teacher说什么都学而是:
把 Teacher guidance 放进 RL objective,由 RL 有选择地决定哪些 Teacher knowledge 值得强化。
论文报告其在 within-family 和 cross-family distillation 中都优于标准 RL 和 OPD。(arXiv)
这条路线我认为比"OPD 替代 RL"更值得关注。
二十四、现在 OPD / RL 真正热门的方向有哪些?
截至 2026 年 8 月,如果限定:
LLM / Reasoning / Agent / Agentic Search Post-training
我会把研究热度大致分成下面 6 条主线。
第一梯队:OPD × RL Hybrid
我认为这是目前最值得关注的。
核心问题:
D e n s e T e a c h e r G u i d a n c e + O u t c o m e − b a s e d E x p l o r a t i o n \boxed{ Dense Teacher Guidance + Outcome-based Exploration } DenseTeacherGuidance+Outcome−basedExploration
代表思路:
text
Distilled RL
SEED
SSOPD
SEED 更进一步把 Agent 完成后的 trajectory 转成 hindsight skills,再将 skill 对 action probability 的影响蒸馏回当前 policy,并和 outcome RL 联合训练。(arXiv)
而 SSOPD 利用同一个 GRPO group:
text
correct trajectory
vs
wrong trajectory
从它们之间构建 dense process supervision;其论文报告在多个 reasoning benchmark 上超过纯 GRPO。(arXiv)
为什么热门?
因为它正好补:
text
RL:会探索但信号稀疏

OPD:信号密集但被Teacher限制
二十五、第二梯队:Long-Horizon Agent OPD
这和 Agentic Search 最直接相关。
问题已经从:
text
怎么蒸馏一个回答变成:
text
怎么蒸馏:

Plan
→ Search
→ Read
→ Search
→ Verify
→ Tool
→ Answer

几十个 turn
当前主要解决:
text
Compounding Error
Turn Credit Assignment
Trajectory Length
Teacher Cost
Deep Turn Under-training
代表:
text
TurnOPD
Guided-OPD
OPAD / MAD-OPD(arXiv)
二十六、第三梯队:Efficient / Offline OPD
因为:
text
大Teacher实时forward太贵。
所以现在开始研究:
text
Teacher Logit Cache
Offline OPD
Selective Distillation
Sparse Update
Partial Token Supervision
代表:
text
Lightning OPD目标就是把:
text
Student rollout
+
Online Teacher Server
逐渐变成:
text
Student rollout
+
Cached / Selective Teacher Signal(arXiv)
这条方向工程价值很高。
二十七、第四梯队:Teacher--Student Mismatch
这个问题未来一定还会继续做。
研究:
text
什么 Teacher 最适合什么 Student?

Teacher越强越好吗?

跨模型家族:
DeepSeek → Qwen
Claude → Qwen
Llama → Qwen

能不能有效蒸馏?
目前答案已经比较明确:
不是 Teacher 越强越好。
关键是:
text
Teacher Capability
        +
Policy Compatibility
因此现在出现:
text
Teacher Selection
Multi-Teacher
Debate Teacher
Cross-family Distillation
Adaptive KL(arXiv)
二十八、第五梯队:Process-level / Turn-level Supervision
过去:
text
Sequence-level Reward现在:
text
Turn-level
Step-level
Token-level
开始组合。
尤其 Agent:
text
Turn 1:Plan
Turn 2:Search
Turn 3:Read
Turn 4:Search
Turn 5:Answer
问题变成:
到底哪个 turn 应该学 Teacher?
TurnOPD 就明确开始从 token-level budget 转向 turn-aware budgeting 。(arXiv)
这和之前 Agent RL 的:
text
Process Reward实际上正在逐渐汇合。
二十九、第六梯队:重新研究"RL / OPD 到底学到了什么"
这是偏基础研究,但非常热。
核心:
text
RL到底创造了新reasoning能力吗?

OPD真的transfer了Teacher knowledge吗?

还是只是:

改变现有trajectory概率?
评估也从:
text
pass@1进入:
text
pass@K
avg@K
large-K capability
policy entropy
trajectory diversity
2026 年最新 OPD 研究已经开始明确挑战:
"OPD = 从 Teacher 获得新能力"
这个传统叙事。(arXiv)
三十、如果专门放到 Agentic Search,我认为路线会长这样
你前面已经有:
text
Search-R1
DeepResearcher
WebDancer

↓

Outcome RL / GRPO
现在可以继续往下补:
text
                     Agentic Search Post-training

                              │
                 ┌────────────┴────────────┐
                 ↓                         ↓

              RL / GRPO                   OPD

                 │                         │
       Search Agent自己探索        Student自己跑Search
                 │                         │
          Final Reward              Teacher逐步指导
                 │                         │
          Search Policy             Dense Supervision

                 │                         │
                 └────────────┬────────────┘
                              ↓

                       Hybrid RL + OPD
                              │
                 ┌────────────┼─────────────┐
                 ↓            ↓             ↓

              Outcome      Teacher       Efficiency
              Reward       Guidance       Reward

                 ↓            ↓             ↓

            Answer正确    Search策略好   搜索不要过多

                       ↓

               Long-Horizon Search Agent

       Plan → Search → Observe → Verify → Search → Stop
三十一、如果你准备做 Agentic Search 研究,我的优先级判断
我不会推荐:
"做一个 OPD,然后和 GRPO 比 Accuracy。"
这个题已经偏简单。
我更推荐:
方向 A:RL + OPD for Search Policy
例如研究:
text
Outcome Reward
+
Teacher token guidance
Teacher 专门指导:
text
when-to-search
query generation
stop decision
但最终:
text
Correctness
Evidence
Efficiency
仍由 RL reward 控制。
如果不加 OPD:
Agent 在长 trajectory 中:
text
reward sparse
credit assignment困难
如果不用 RL:
Agent 容易:
text
被 Teacher policy ceiling 限制这两者组合非常合理。
三十二、备选方向:Turn-level OPD for Deep Research
这个可能更适合真正 Agentic Search。
不要:
text
每一个 token
都找 Teacher
而是:
text
Plan turn
Search query turn
Evidence judgment turn
Stop turn
只在关键决策点:
text
Teacher supervision比如:
L = w p L p l a n + w s L s e a r c h + w e L e v i d e n c e + w s t o p L s t o p + λ L R L L = w_pL_{plan} + w_sL_{search} + w_eL_{evidence} + w_{stop}L_{stop} + \lambda L_{RL} L=wpLplan+wsLsearch+weLevidence+wstopLstop+λLRL
这样相比 vanilla OPD:
text
Teacher cost ↓而且 supervision 更符合 Agent 的:
text
decision-level structure而不是平均撒在所有 token 上。
TurnOPD 的最新结果实际上已经在支持这种"long-horizon Agent 不应只按 token 均匀蒸馏 "的方向。(arXiv)
三十三、最后把 SFT、OPD、RL 三者一次讲透
这三个东西你以后可以这么区分:
text
                         Training Signal


SFT
│
├─ 谁产生trajectory?
│     Teacher / Dataset
│
├─ 学什么?
│     标准答案
│
└─ 本质
      模仿正确行为


OPD
│
├─ 谁产生trajectory?
│     Student
│
├─ 谁指导?
│     Teacher
│
└─ 本质
      在自己犯错的地方
      学Teacher怎么做


RL
│
├─ 谁产生trajectory?
│     Student
│
├─ 谁指导?
│     Reward / Environment
│
└─ 本质
      自己探索
      好结果得到强化
所以我会把现代 Agent 后训练理解成:
SFT负责"会做" \boxed{ \text{SFT负责"会做"} } SFT负责"会做"
OPD负责"有人带着改" \boxed{ \text{OPD负责"有人带着改"} } OPD负责"有人带着改"
RL负责"自己探索怎么做得更好" \boxed{ \text{RL负责"自己探索怎么做得更好"} } RL负责"自己探索怎么做得更好"
而 2026 年最值得看的方向不是三选一,而是如何把三者组合起来:
text
SFT Cold Start
      ↓
On-policy Agent Rollout
      ↓
Teacher Dense Guidance
      +
Environment Outcome Reward
      ↓
OPD + RL
      ↓
Long-Horizon Agent
尤其对 Agentic Search 来说,我会重点盯 Turn-level OPD / OPD+RL / Teacher-Student Mismatch / Efficient OPD / Long-Horizon Agent Distillation 这几条,而不是只继续追 GRPO 的 optimizer 变体。