文章目录
- [📌 TL;DR](#📌 TL;DR)
- 痛点一:双栏变单栏
- 痛点二:公式变乱码
- 痛点三:图表文字丢失
- [📊 三款方案速览对比](#📊 三款方案速览对比)
- [🔧 方案详解](#🔧 方案详解)
- 方案一:在线翻译工具
- [方案二:PDF 阅读器内置翻译](#方案二:PDF 阅读器内置翻译)
- [方案三:逐段对照翻译 + 截图 OCR](#方案三:逐段对照翻译 + 截图 OCR)
- [❓ 常见问题解答](#❓ 常见问题解答)
- [✅ 选择推荐](#✅ 选择推荐)
- [💬 写在最后](#💬 写在最后)
📌 TL;DR
PDF 翻译工具,没有最好,只有最合适。但如果你读的是理工科论文 (有公式、表格、双栏),方案三(逐段对照翻译 + 截图 OCR)是目前保真度最高的解法。核心优势是"原文不动,译文独立渲染"------排版 100% 保留,公式不用重新渲染,图表文字单独 OCR。每天有免费额度可以体验,如果你还没拿定主意,不妨先拿一篇公式密集的论文试试,感受一下"排版保真"和"翻译失真"哪个才是你真正不能接受的。工具是帮你省力的,选对场景再选工具,才不会用两次就吃灰。
先说一个扎心的事实:没有一个翻译工具能同时做到"翻译快 + 排版保真 + 完全免费"。但方案三通过"原文不动"的思路,绕过了排版失真的问题------这是目前理工科论文党最值得投入的方案。下面按痛点逐一拆解。
痛点一:双栏变单栏
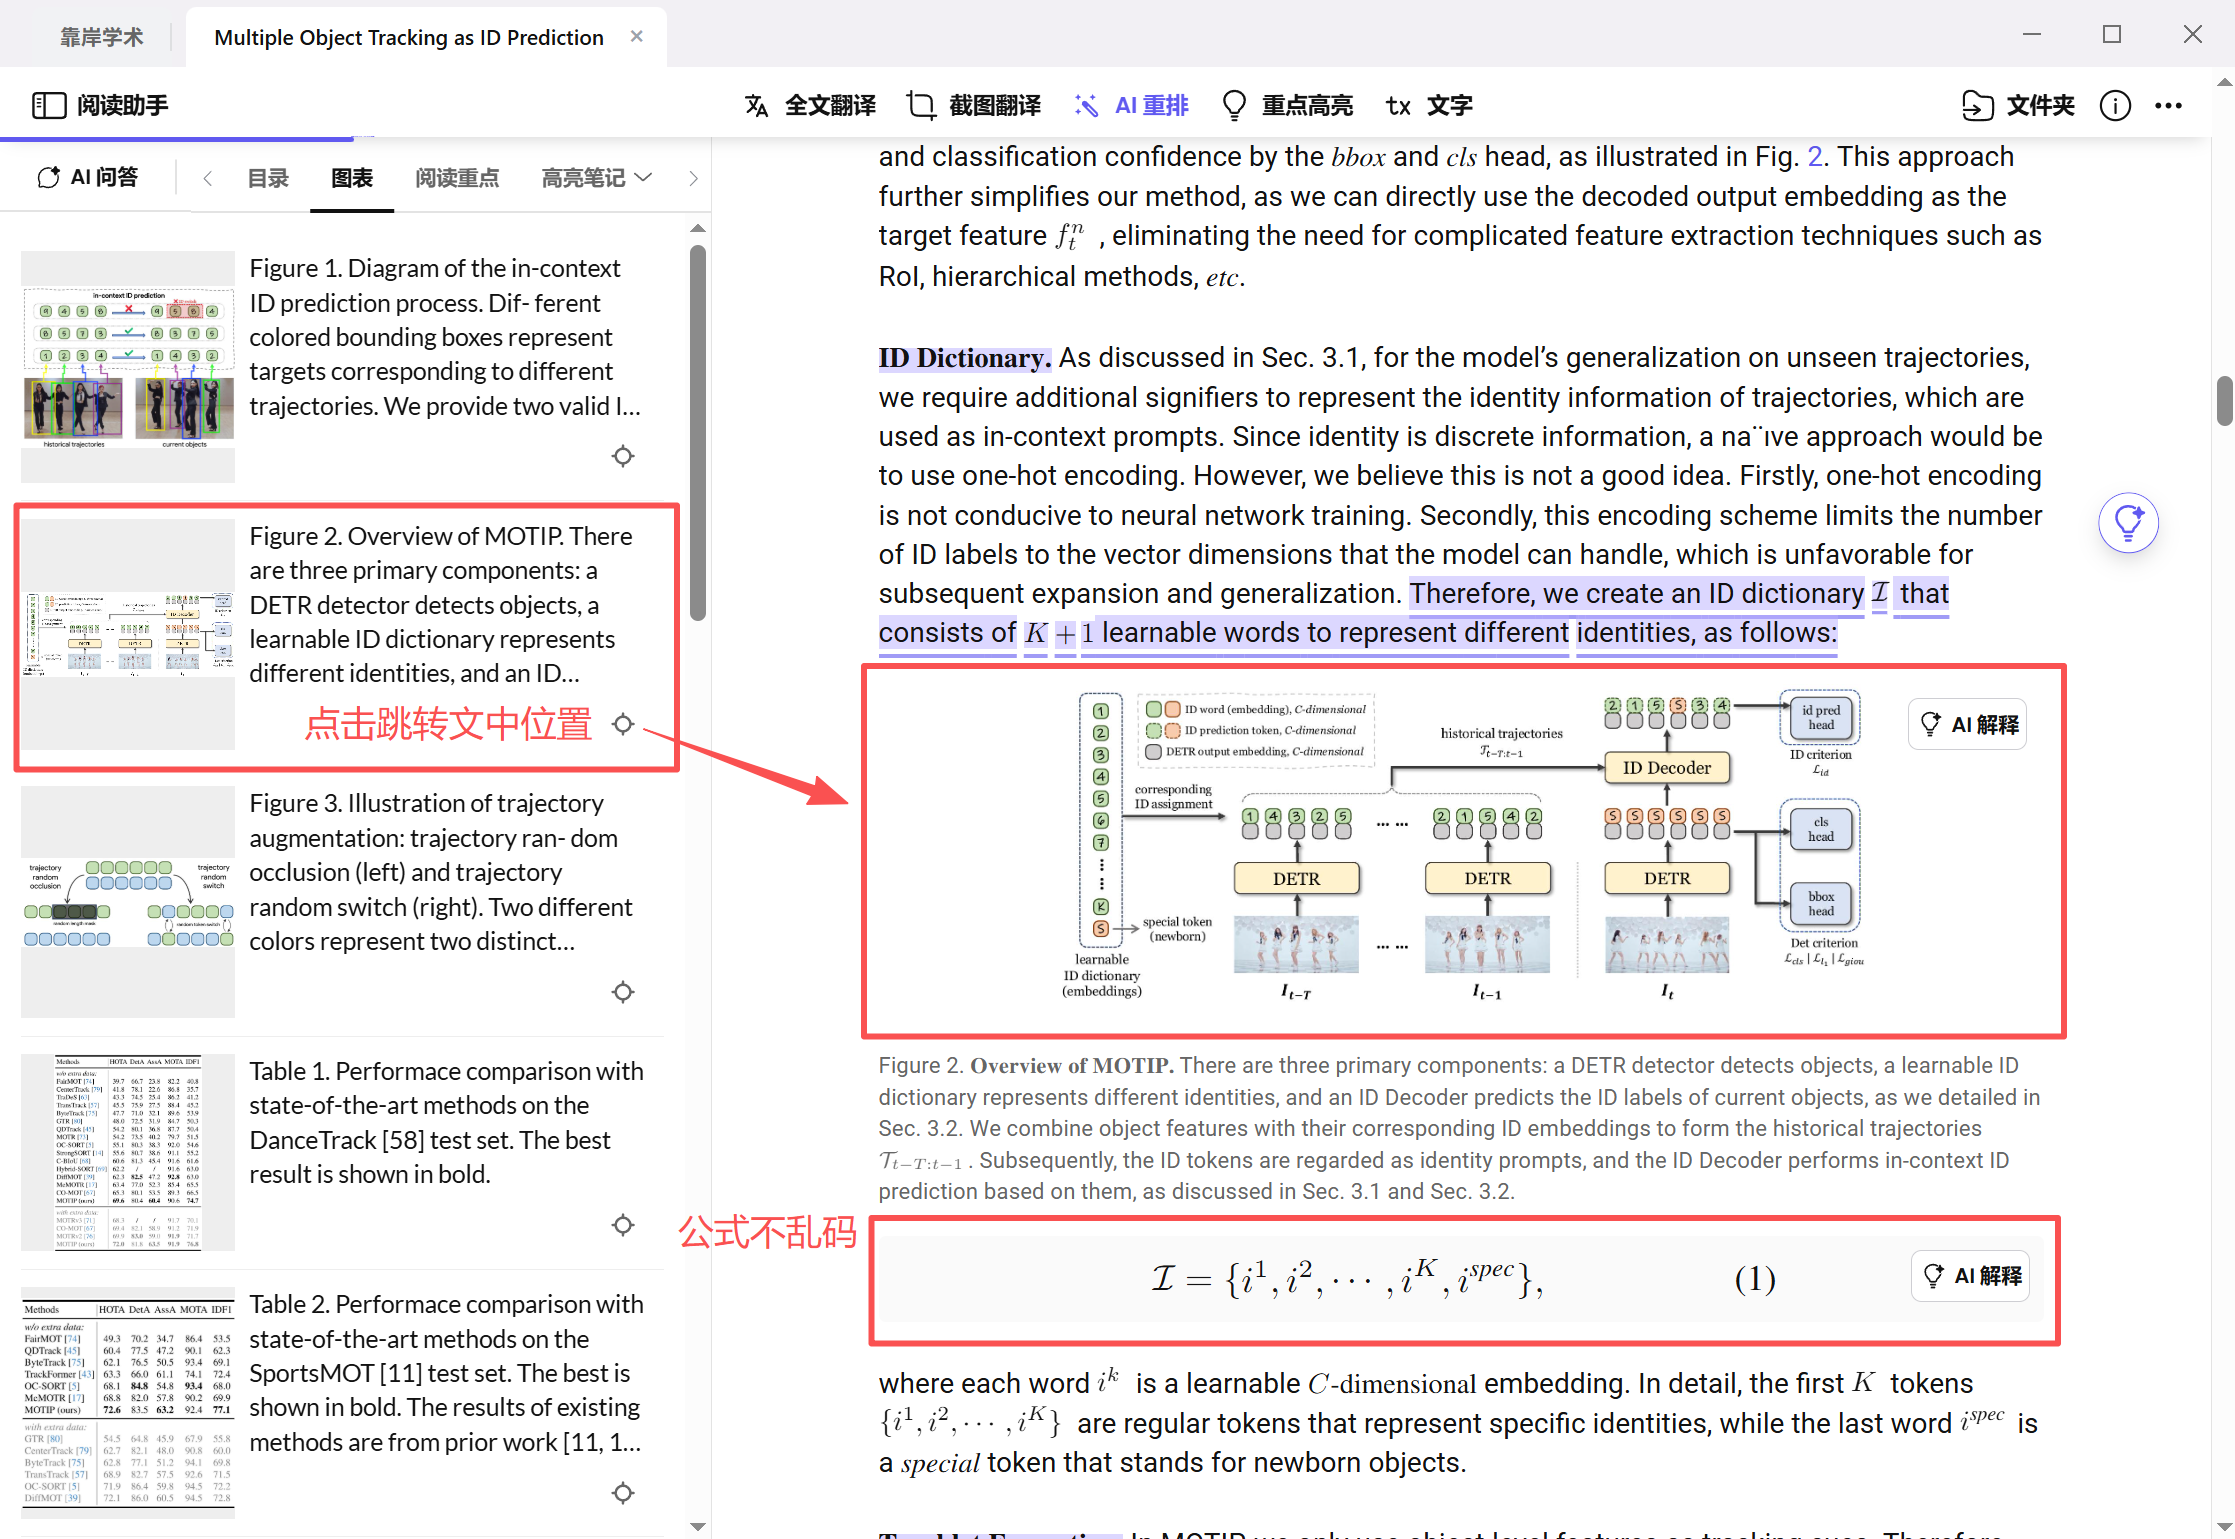
这是最常见的问题。PDF 论文(尤其是 IEEE/ACM 等会议论文)大多是双栏排版,但 Google 翻译、DeepL 等网页工具会把双栏强行拼成单栏。
后果:
- 段落顺序错乱(左栏第一段接右栏第一段,而不是左栏第二段)
- 跨栏表格被切断
- 引用标记和参考文献对不上
原因:网页翻译器把 PDF 当纯文本处理,按字符流顺序提取,直接丢掉分栏信息。
痛点二:公式变乱码
理工科论文重灾区。LaTeX 公式被拆成字符,翻译后无法重组。
典型翻车现场:
∫₀^∞ f(x)dx变成∫ 0 ∞ f ( x ) dx- 多行对齐的公式(比如矩阵、方程组)变成单行
- 上下标位置错乱
原因:公式不是"文字",是"渲染对象"。通用翻译器只提取 Unicode 字符,不保留 MathML/LaTeX 结构。
痛点三:图表文字丢失
图表里的坐标轴标签、图例说明、数据标注,通用翻译器直接跳过。
原因 :图片内的文字需要 OCR 识别,而网页翻译器不做这一步。少数工具会 OCR,但翻译结果悬浮在原图上,破坏原图布局。
📊 三款方案速览对比
| 对比维度 | 方案一:在线翻译 | 方案二:阅读器翻译 | 方案三:逐段对照 + OCR |
|---|---|---|---|
| 排版保真度 | ★★☆☆☆ 双栏会乱 | ★★★★☆ 原文不动 | ★★★★★ 原文不动 |
| 公式保真度 | ★★☆☆☆ 会乱码 | ★★★★☆ LaTeX 渲染 | ★★★★★ 原图保留 |
| 图表文字翻译 | ★☆☆☆☆ 不翻译 | ★★☆☆☆ 需手动 OCR | ★★★★★ 截图 OCR |
| 翻译速度 | ★★★★★ 快 | ★★★☆☆ 中 | ★★★★☆ 中上 |
| 对照阅读体验 | ★★☆☆☆ 需切换 | ★★★☆☆ 侧边栏对照 | ★★★★★ 并排对照 |
| 成本 | ★★★★★ 免费 | ★★★★☆ 免费 - 付费 | ★★★★☆ 每日免费额度 |
| 上手门槛 | ★★★★★ 网页即用 | ★★★★☆ 需安装 | ★★★★☆ 网页即用 |
| 中文体验 | ★★★★☆ 支持好 | ★★★★★ 中文工具 | ★★★★★ 中文界面 |
🔧 方案详解
方案一:在线翻译工具
- 代表工具:Google 翻译、DeepL、有道翻译
- 适用场景:纯文本论文(文科类)、快速浏览预印本、对排版要求不高的场景
- 优点 :
- 免费、无需安装,网页即用
- 翻译速度快,上传即出结果
- 翻译质量本身不错(DeepL 的语义理解确实强)
- 支持多种语言互译
- 局限 :
- 双栏论文会被强行拼成单栏
- 复杂公式会乱码
- 表格线丢失,数据行错位
- 图表内文字不翻译
- 无法对照原文核对
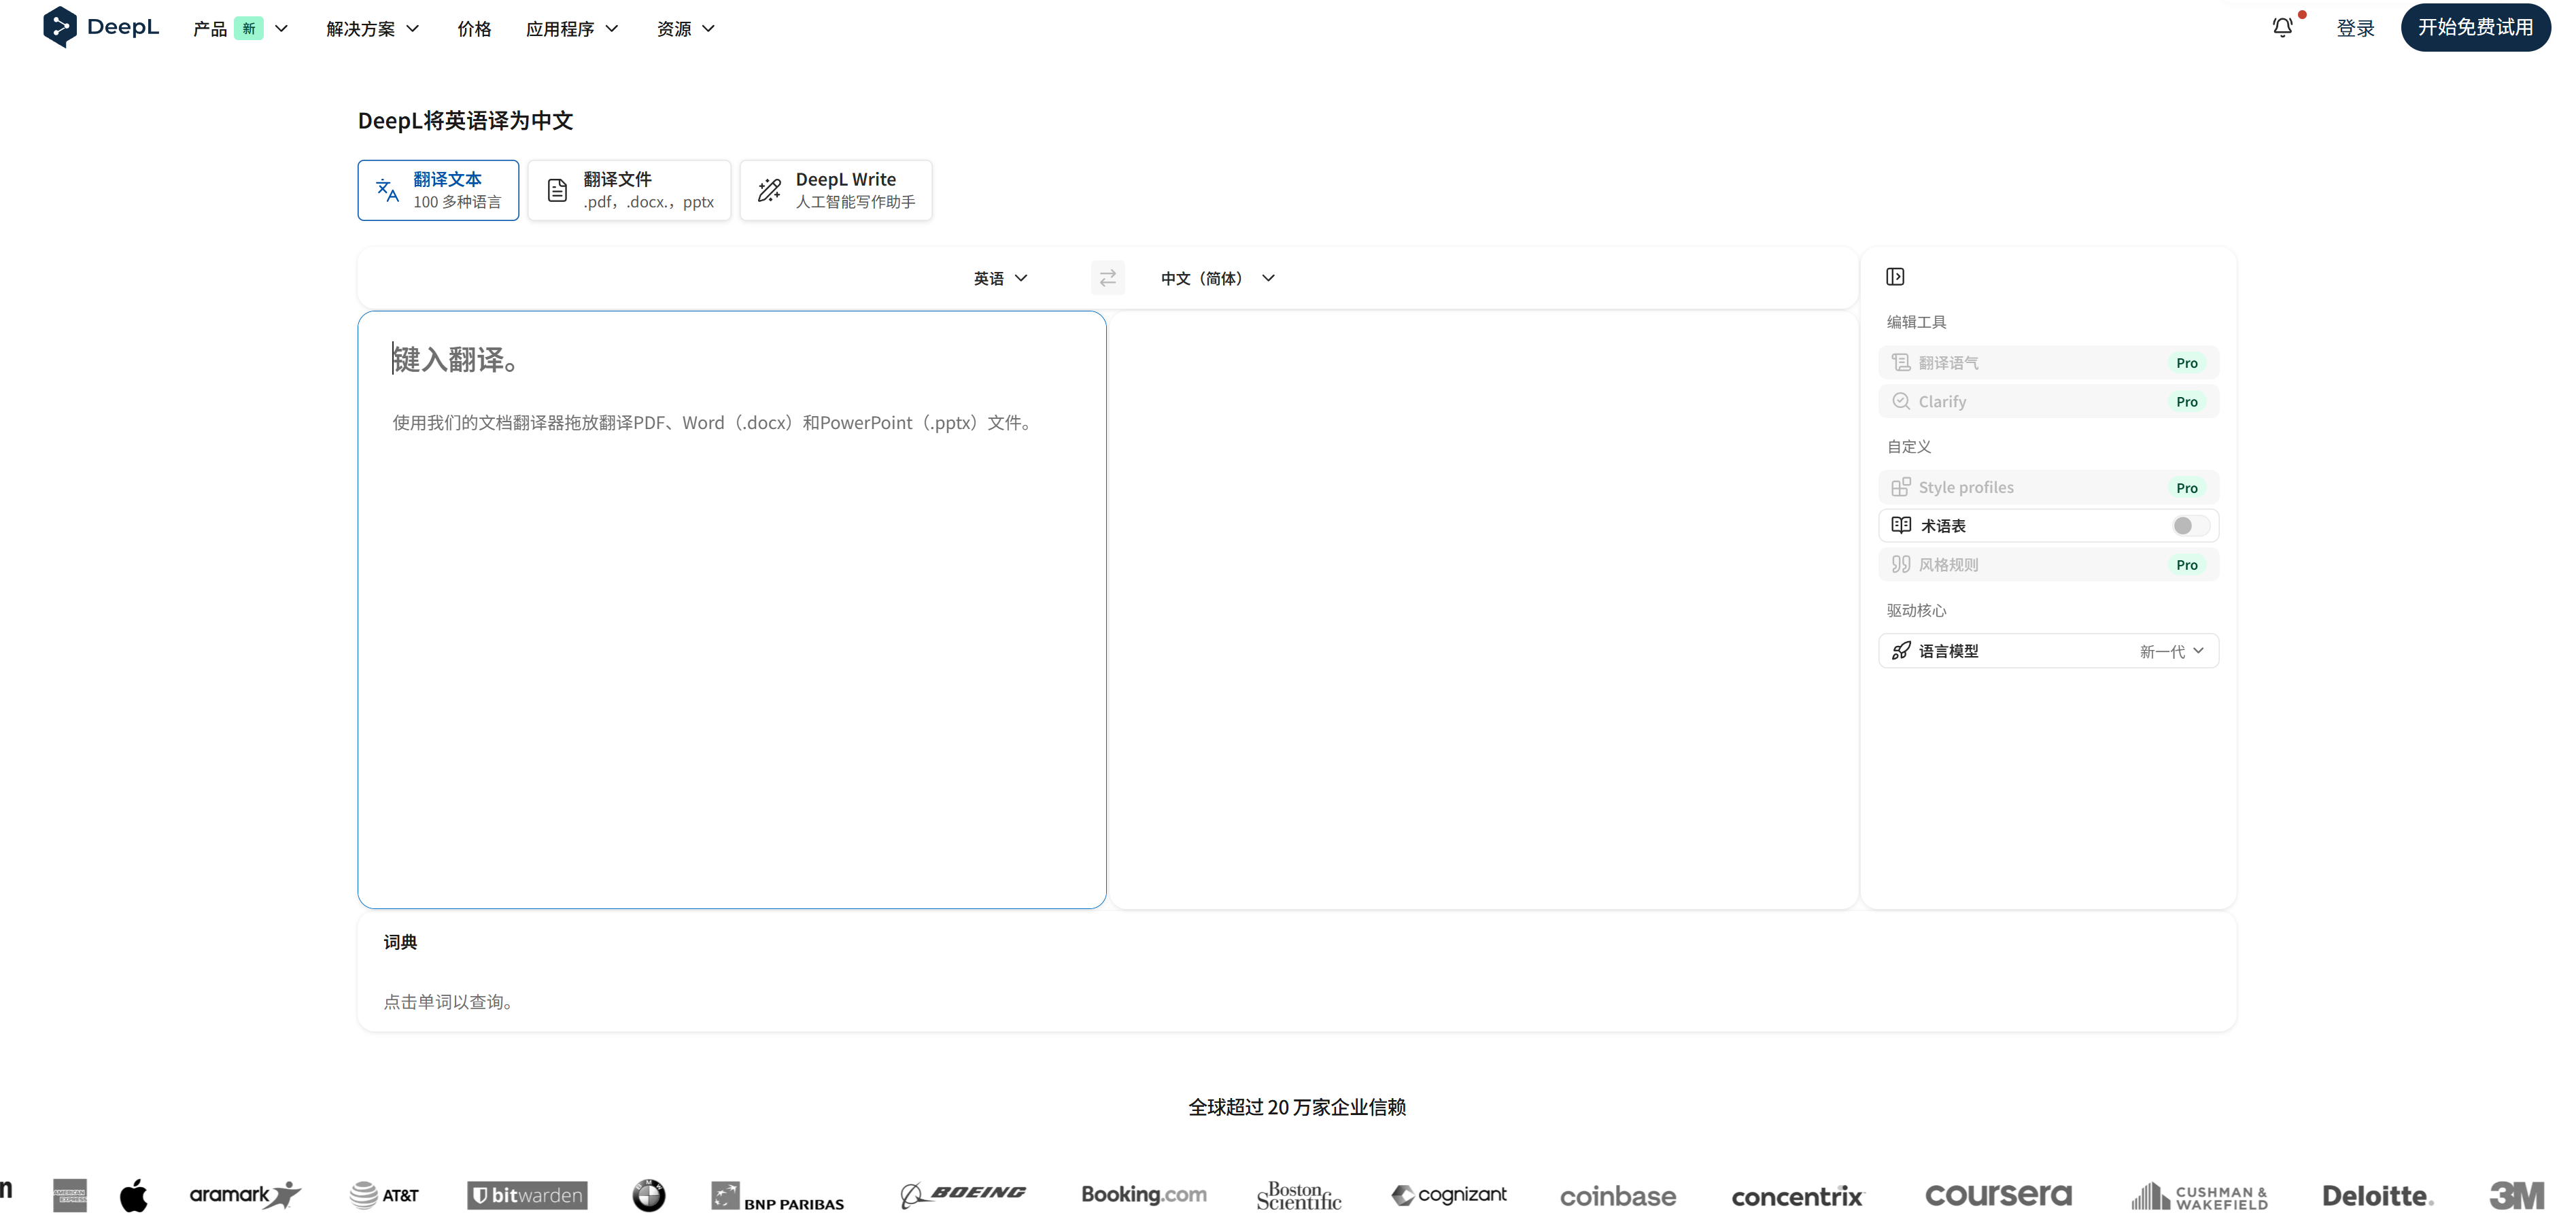
总结:适合文科生快速浏览,但理工科慎用。
方案二:PDF 阅读器内置翻译
- 代表工具:知云文献翻译、CAJ 阅读器、福昕翻译
- 适用场景:需要精读、对照原文核对公式数据的场景,尤其是中文文献
- 优点 :
- 原文排版 100% 保留(因为不修改原文件)
- 可以对照原文核对
- 支持公式区域的 LaTeX 渲染
- 部分工具支持表格内翻译
- 知云/CAJ 对中文文献支持好
- 局限 :
- 译文和原文分离,需要来回切换视线
- 无法导出对照版笔记
- 图表内文字仍需手动 OCR
- 长段落翻译需要手动分段
- 翻译质量依赖内置引擎(不如专业翻译器)
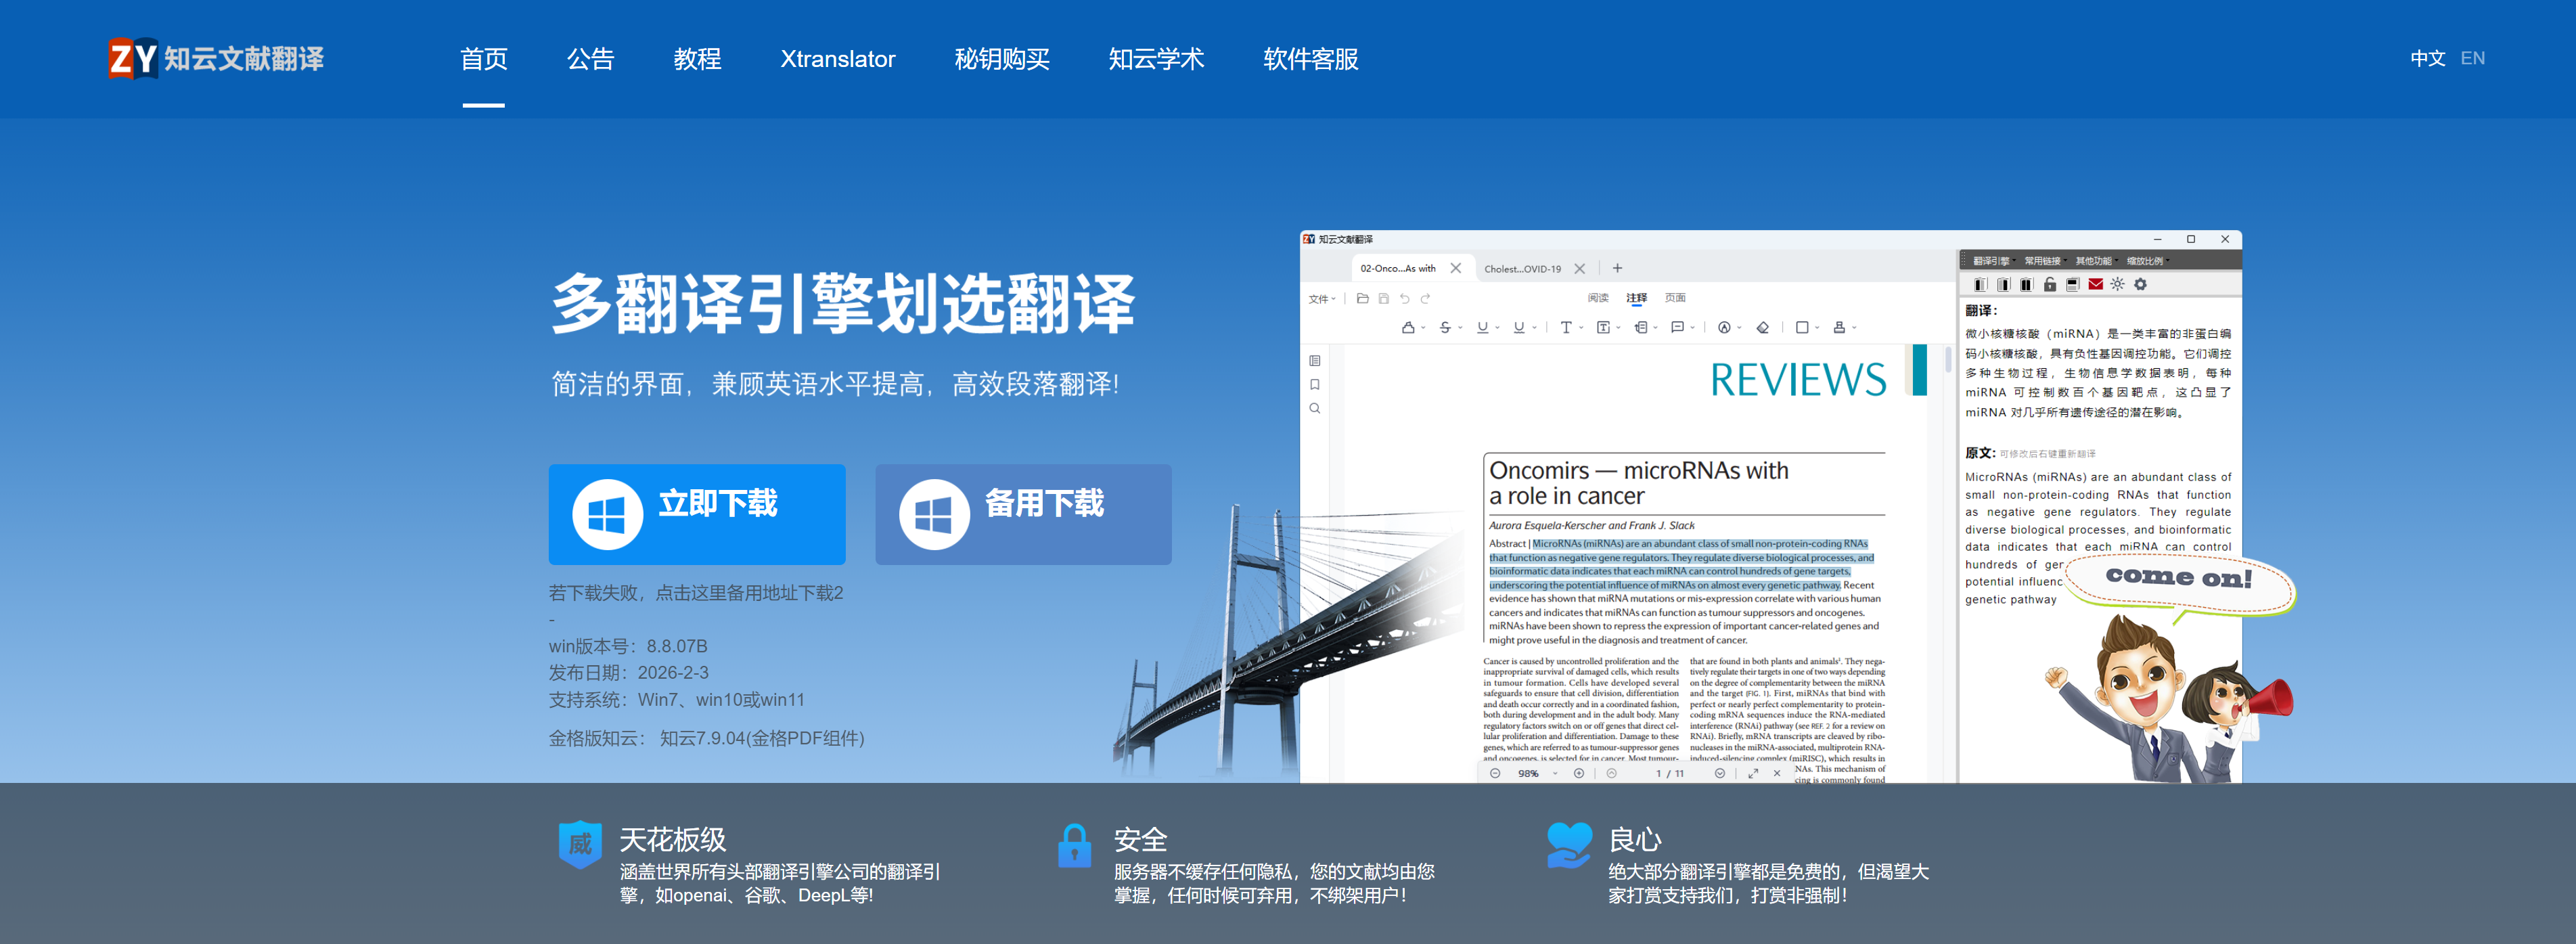
总结:保真度中等,适合预算有限的理工科学生,但效率一般。
方案三:逐段对照翻译 + 截图 OCR
- 代表工具:Scholaread(靠岸学术)
- 适用场景:理工科论文精读、需要反复对照原文核对数据的严谨场景、图表密集型论文
- 优点 :
- 原文排版零失真(因为原文根本没动)
- 译文可以按需显示/隐藏
- 公式、表格、双栏全部保留
- 图表内文字通过 OCR 单独翻译
- 支持导出对照版笔记(复习时不用重新打开 PDF)
- 中文界面,上手门槛低
- 对照阅读体验最好------原文译文并排,不用切换视线
- 局限 :
- 需要专用工具(通用翻译器不支持)
- 导出的是对照笔记,不是修改后的 PDF
- 部分高级功能需要付费
操作流程:
Step 1:逐段对照翻译
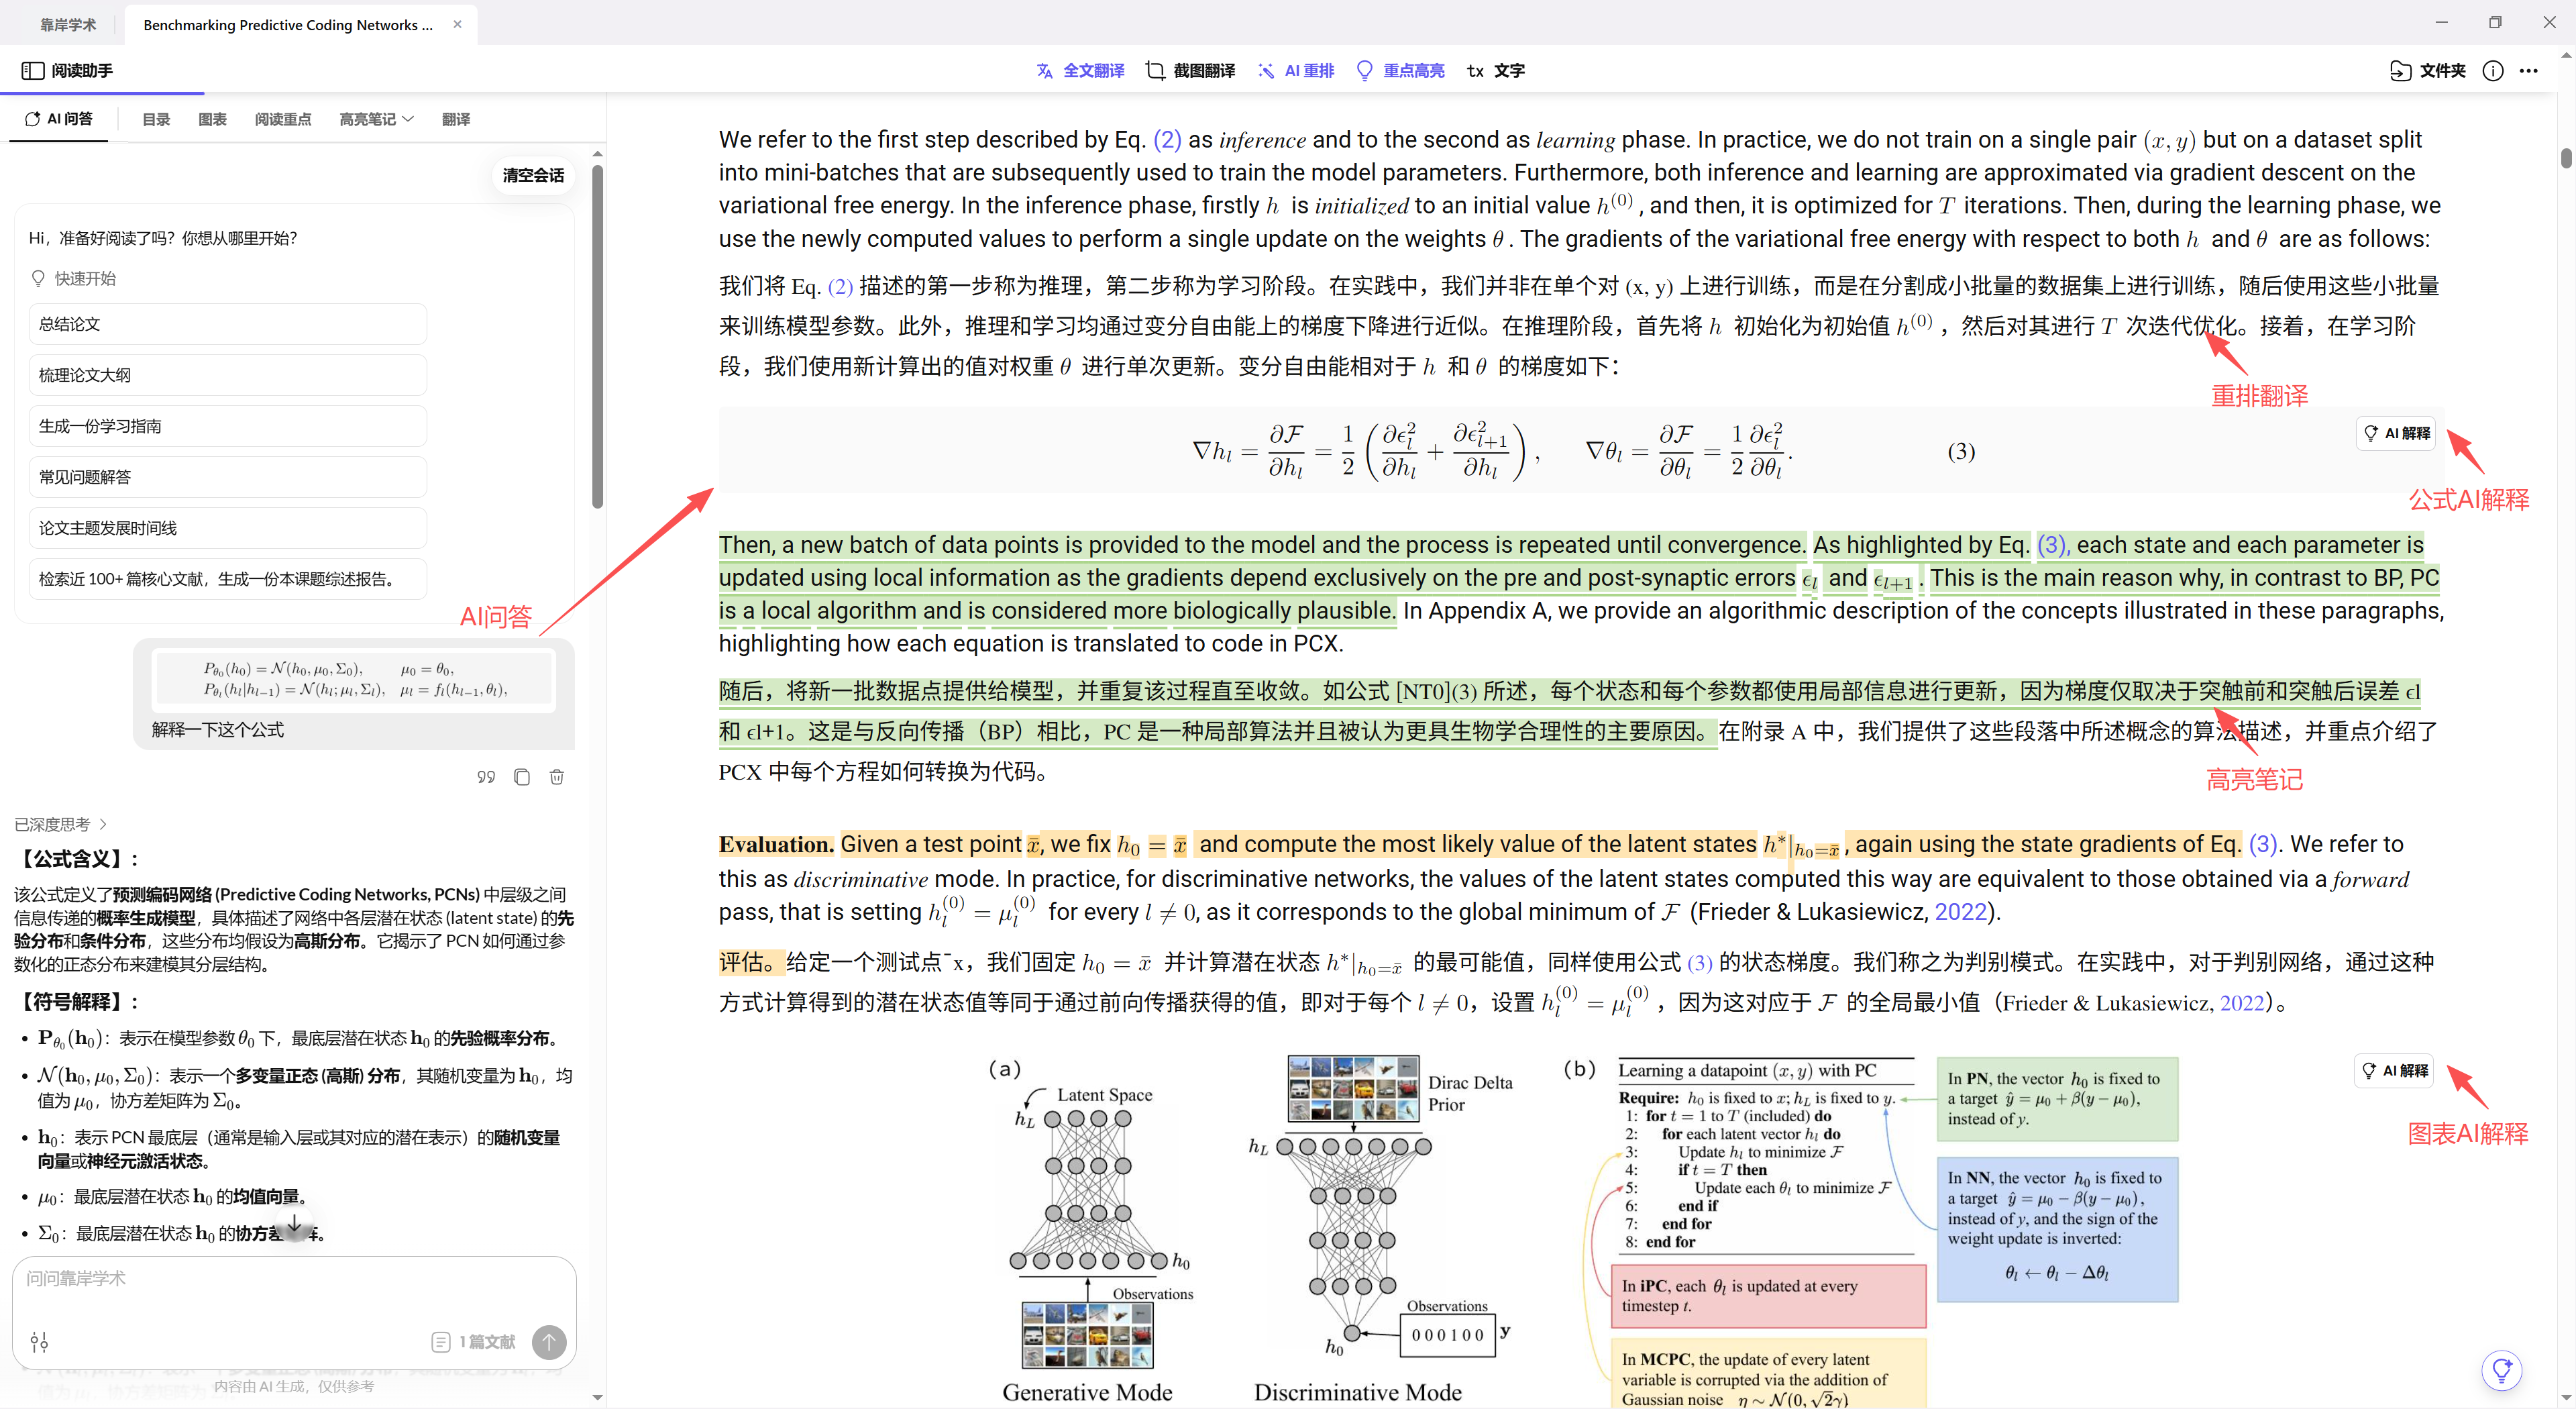
工具会把 PDF 按段落切分,原文和译文并排显示,但原文 PDF 本身不被修改,所以排版 100% 保留。公式、表格、双栏布局都维持原样。
Step 2:图表内文字翻译
遇到图表里的英文(比如坐标轴标签、图例说明),直接用截图 OCR 功能框选,翻译结果悬浮显示在图片上,不破坏原图。
个人使用感受 :
这个方案的核心优势是"对照"------原文和译文并排,公式不用重新渲染,直接看原图。我读机器学习论文时,遇到复杂的数学推导,可以直接对照原文核对,不用担心翻译失真。截图 OCR 功能处理图表里的文字也很方便,不用切换工具。对比方案二的侧边栏翻译,并排对照的效率明显更高------视线不用来回跳,阅读体验流畅很多。
总结:保真度最高,对照体验最好,适合理工科论文精读。每天有免费额度可以体验,建议先试再决定。
❓ 常见问题解答
Q1:这三个方案,我需要一次性都试试吗?
A:不需要。先想清楚自己最痛的是什么------读文科论文,方案一就够了;读理工科论文但预算有限,方案二(知云/CAJ)能满足基本需求;读公式/图表密集的论文且追求效率,方案三最值得投入 。每天有免费额度可以体验,先拿一篇正在读的论文试试,再决定要不要深入用。
Q2:方案三导出的是笔记,不是翻译后的 PDF,会不会不方便?
A:看你的使用场景。如果你需要把翻译后的 PDF 发给别人、或者打印出来,那方案三确实不适合(因为它不修改原文件)。但如果你是自己读、自己复习,导出的对照笔记反而更好用------原文和译文并排,复习时不用来回切换。我的习惯是:对照笔记用来复习,原 PDF 用来核对数据。
Q3:免费工具和付费工具差距到底有多大?
A:核心差距在"完整度"和"深度"。免费版往往限制使用次数、不支持批量翻译、OCR 次数有限。如果你只是偶尔翻译几篇论文,免费版足够;但如果文献量大、需要高频使用,付费工具的价值就体现出来了。方案三每天有免费额度,建议先用免费额度试水,再决定要不要订阅。
Q4:DeepL 翻译质量那么好,为什么排版保真度只有两颗星?
A:DeepL 的翻译质量 确实强(语义理解、语境把握),但排版保真不是它的强项。它把 PDF 当纯文本处理,双栏、公式、表格都会丢。如果你读的是纯文本论文(文科类),DeepL 是首选;但如果你读的是理工科论文,排版保真比翻译质量更重要------公式翻得再准,乱码了也没用。
Q5:方案三和方案二比,优势在哪里?
A:两个方案都能保留排版(因为都不修改原文件),但方案三的对照体验更好 ------方案二是"原文 + 侧边栏译文",视线需要来回切换;方案三是"原文译文并排",一眼就能对照。另外,方案三的截图 OCR 是内置的,方案二需要手动用其他工具 OCR。如果你每天读论文超过 2 小时,方案三的效率优势会很明显。
✅ 选择推荐
- 文科论文、纯文本:方案一(Google/DeepL/有道,免费快速)
- 理工科论文、预算有限:方案二(知云/CAJ,免费 - 付费,保真度中等)
- 公式/图表密集、追求效率 :方案三(逐段对照 + 截图 OCR,保真度最高,对照体验最好)
- 想先试水再决定 :方案二(知云免费)+ 方案三(每日免费额度,建议优先试)
- 三个场景都想覆盖 :方案三(一站式解决排版 + 翻译 + OCR,综合体验最优)
💬 写在最后
PDF 翻译工具,没有最好,只有最合适。
但如果你读的是理工科论文 (有公式、表格、双栏),方案三(逐段对照翻译 + 截图 OCR)是目前保真度最高的解法。双栏变单栏、公式变乱码、图表文字丢失------这三个痛点,方案三通过"原文不动"的思路全部绕过。
每天有免费额度可以体验 ,如果你还没拿定主意,不妨先拿一篇公式密集的论文试试,感受一下"排版保真"和"翻译失真"哪个才是你真正不能接受的。工具是帮你省力的,选对场景再选方案,才不会用两次就吃灰。
祝每一位在文献和翻译之间找到效率的研究生,都能借对工具,把时间花在真正值得精读的论文上。工具会越来越多,但知道自己要什么,比知道有什么更重要。