基于Flask+Vue的电影数据可视化与智能推荐系统
一、项目简介
本系统是一套以豆瓣电影数据为对象的数据采集、分析与推荐平台。后端采用 Flask、SQLAlchemy 与 MySQL,前端采用 Vue、Vuetify、ECharts 与 Vuex;系统将电影信息、评论、人物信息爬取,数据看板可视化,协同过滤推荐和中文评论情感分析整合到一个前后端分离项目中。
项目实际包含电影、用户、订单、文件、支付宝、百度等 API 模块,推荐算法包含 ItemCF.py 与 UserCF.py,深度学习目录包含 LSTM 模型定义、训练与预测脚本;Scrapy 项目包含电影评论、电影详情、电影条目和人物信息爬虫。
二、系统功能
1.1 用户端功能
账户与个人资料管理
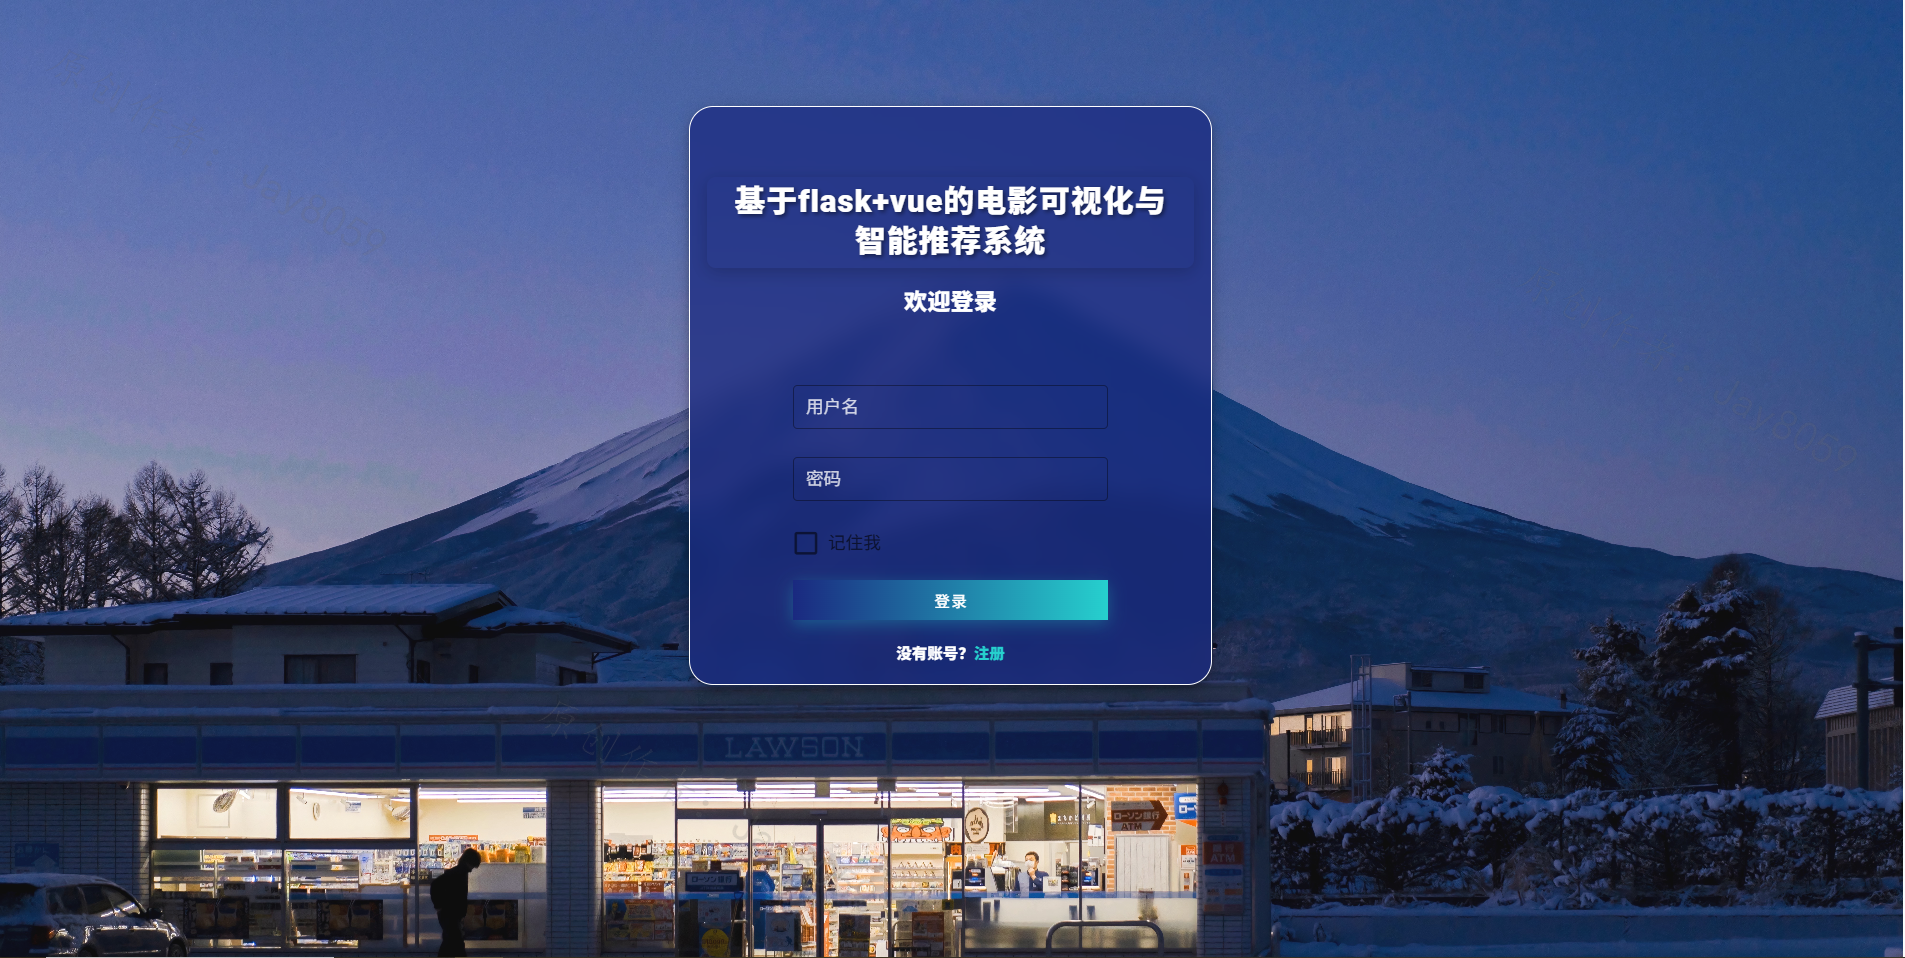
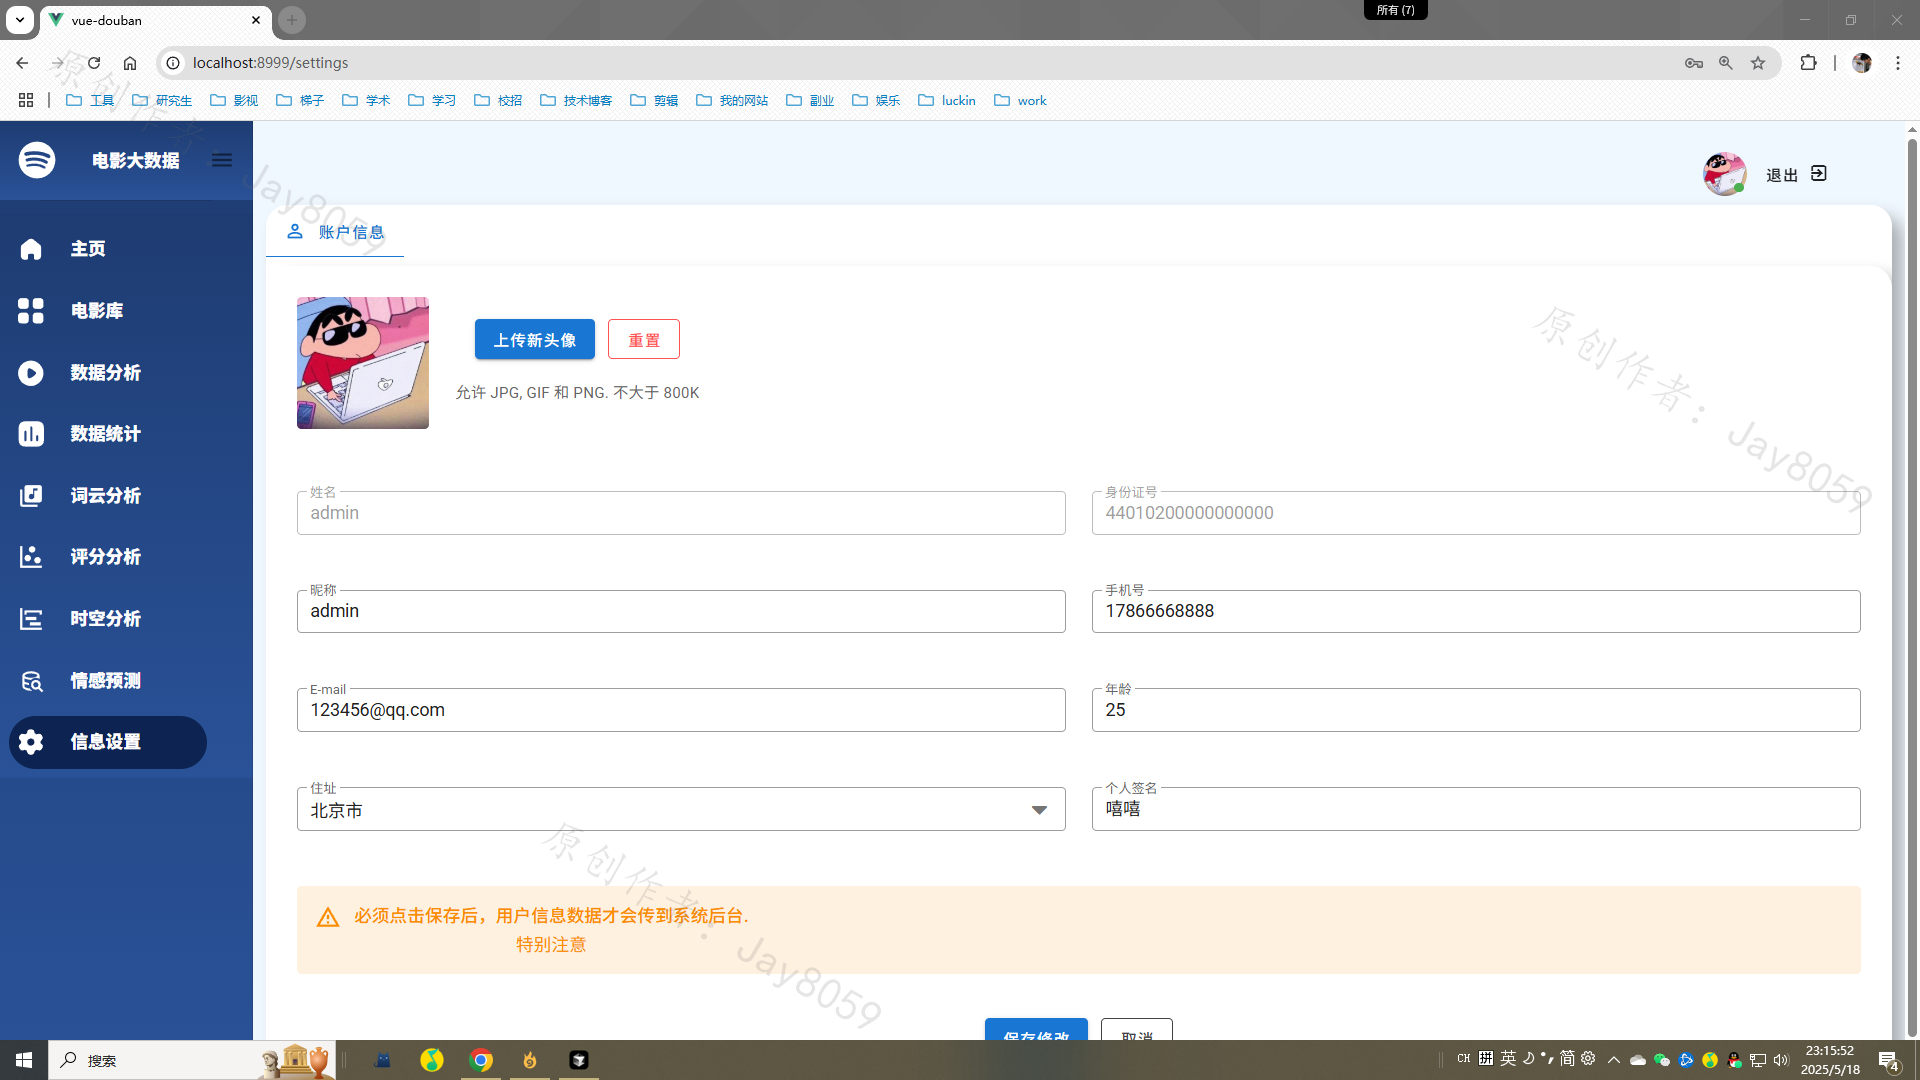
用户可注册、登录并在账户设置中维护账户资料、密码、安全信息和个人相关记录。userApi.py 为用户认证与资料业务提供接口支持。
电影资源浏览与检索
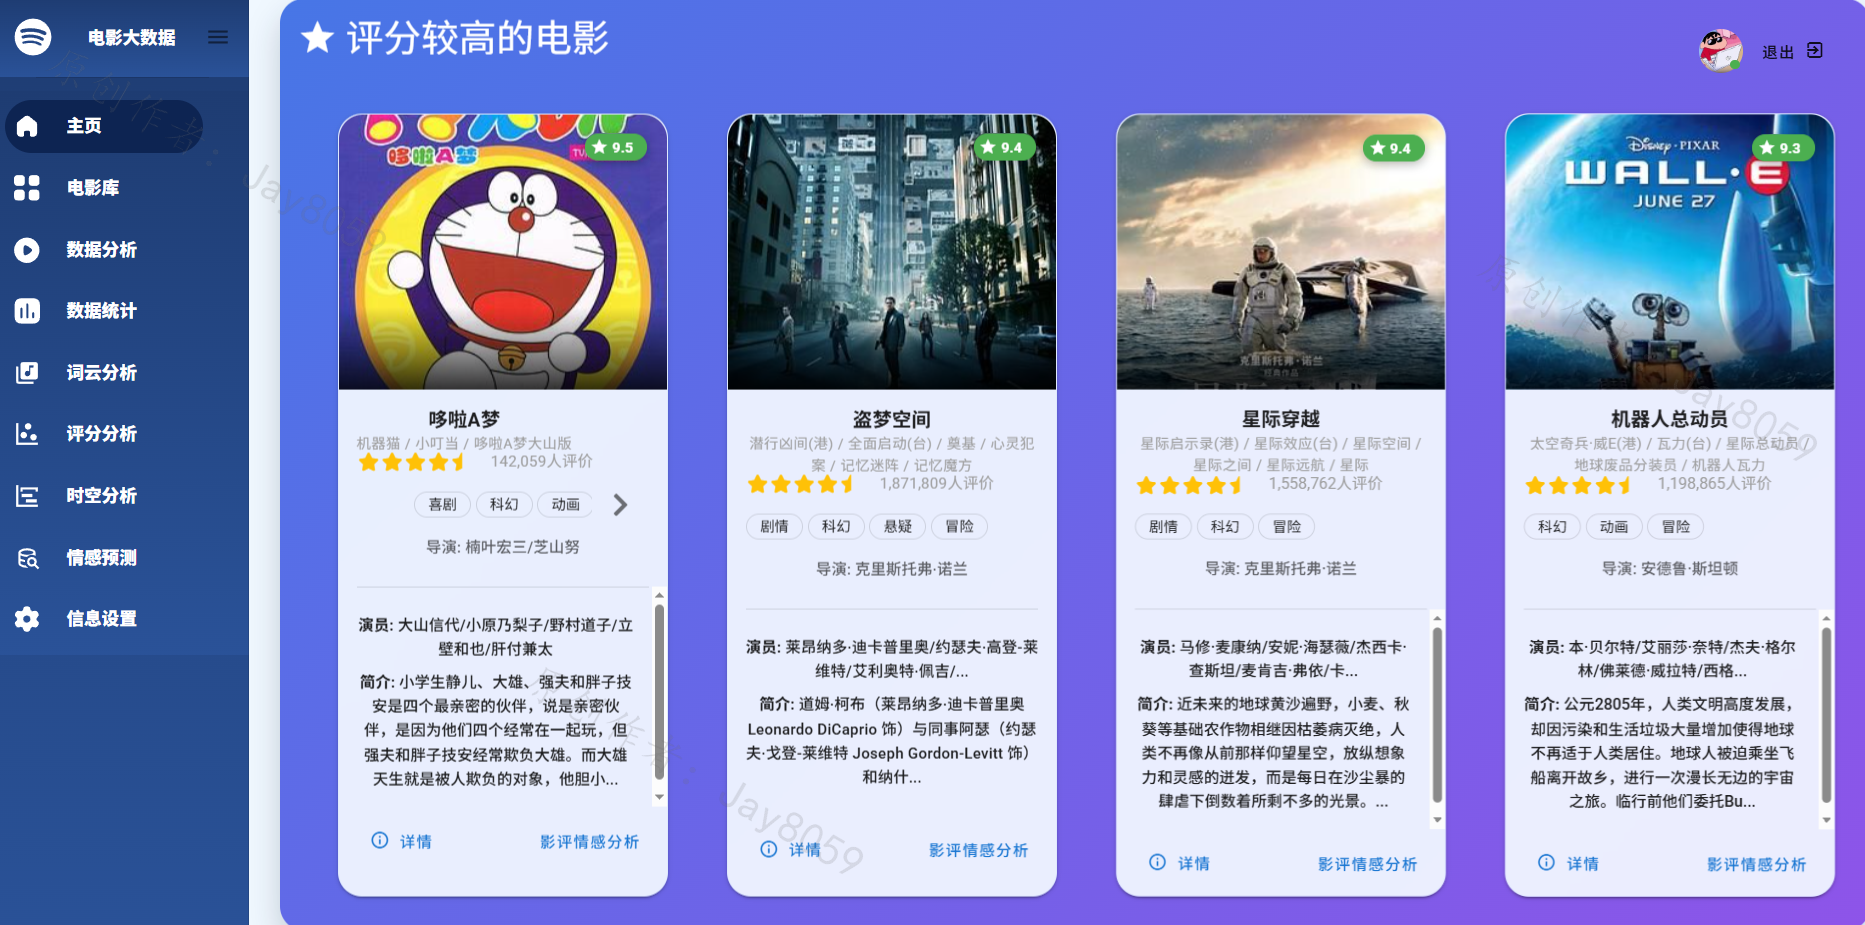
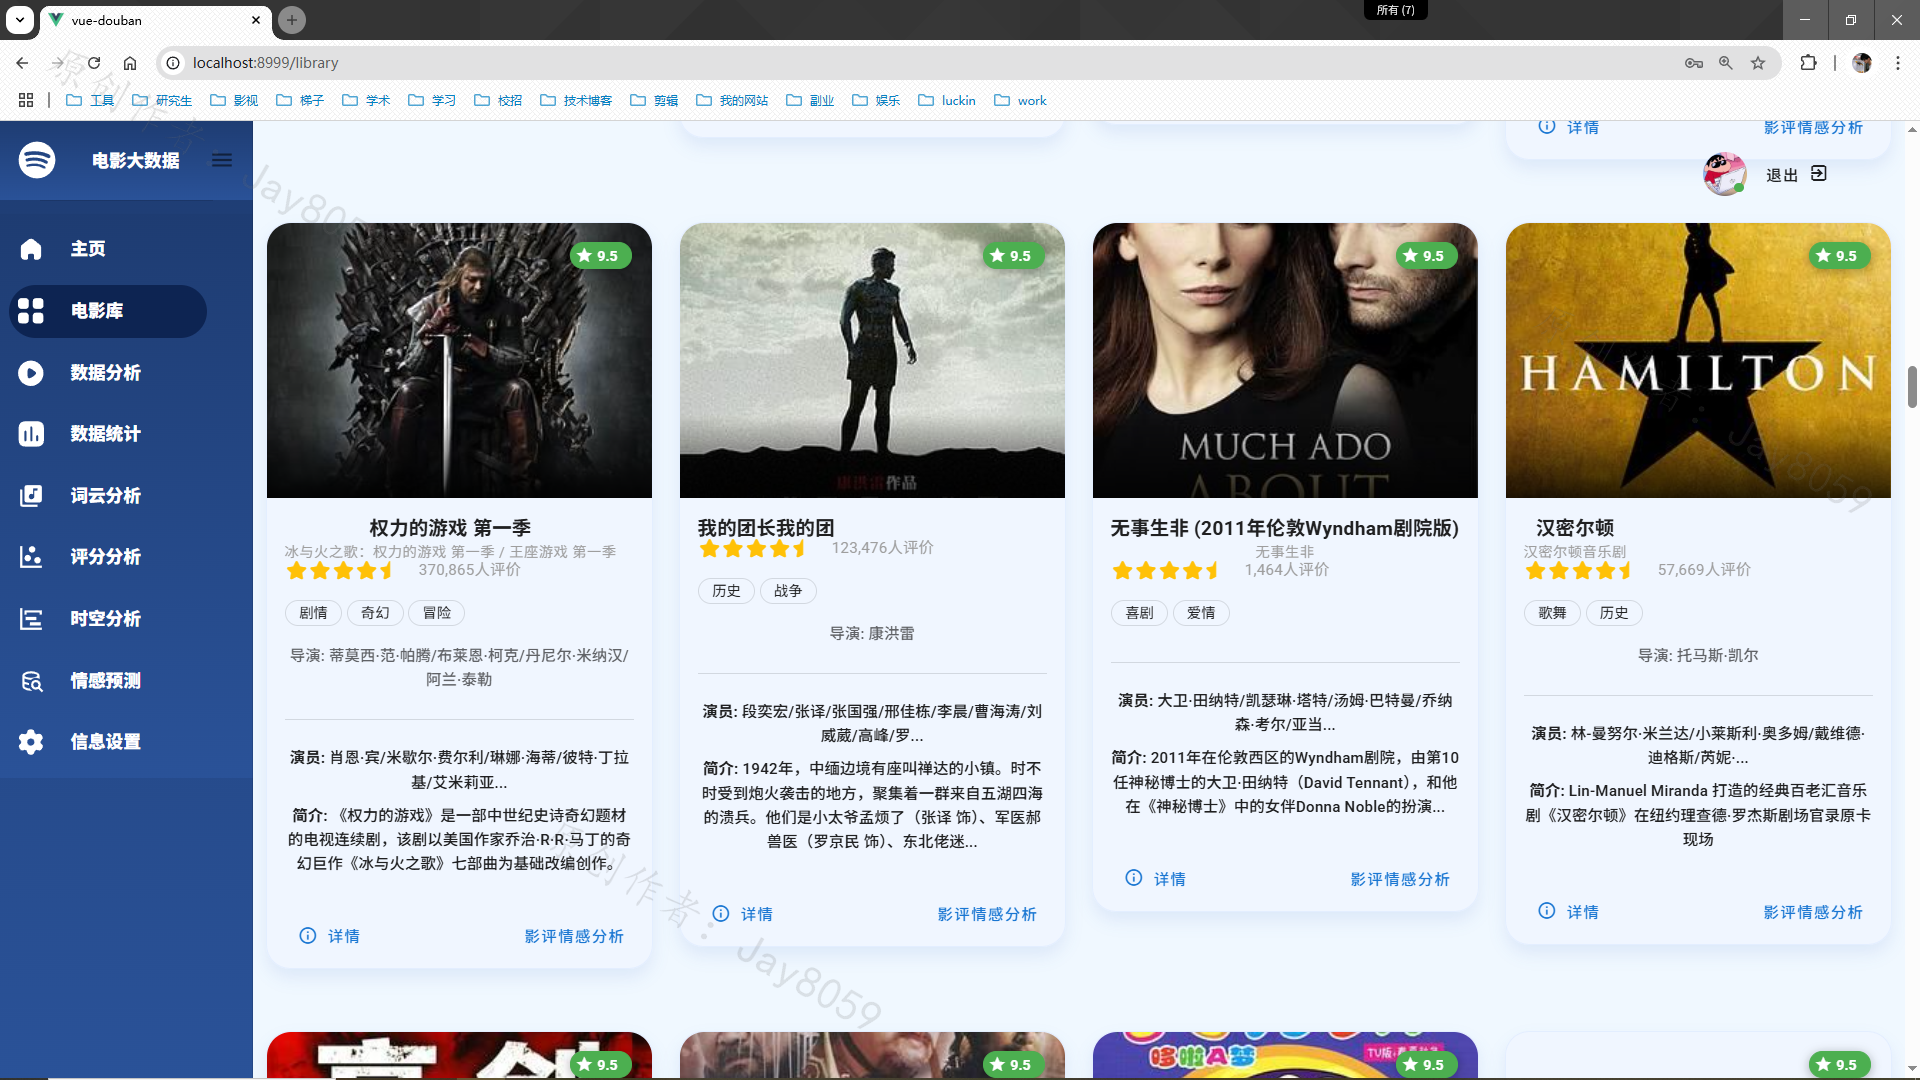
用户可在首页、电影库和电影详情等页面浏览电影基础信息、热门电影和影片相关数据。movieApi.py 为电影列表、详情、热门内容和推荐结果提供后端接口。
数据看板与可视化分析
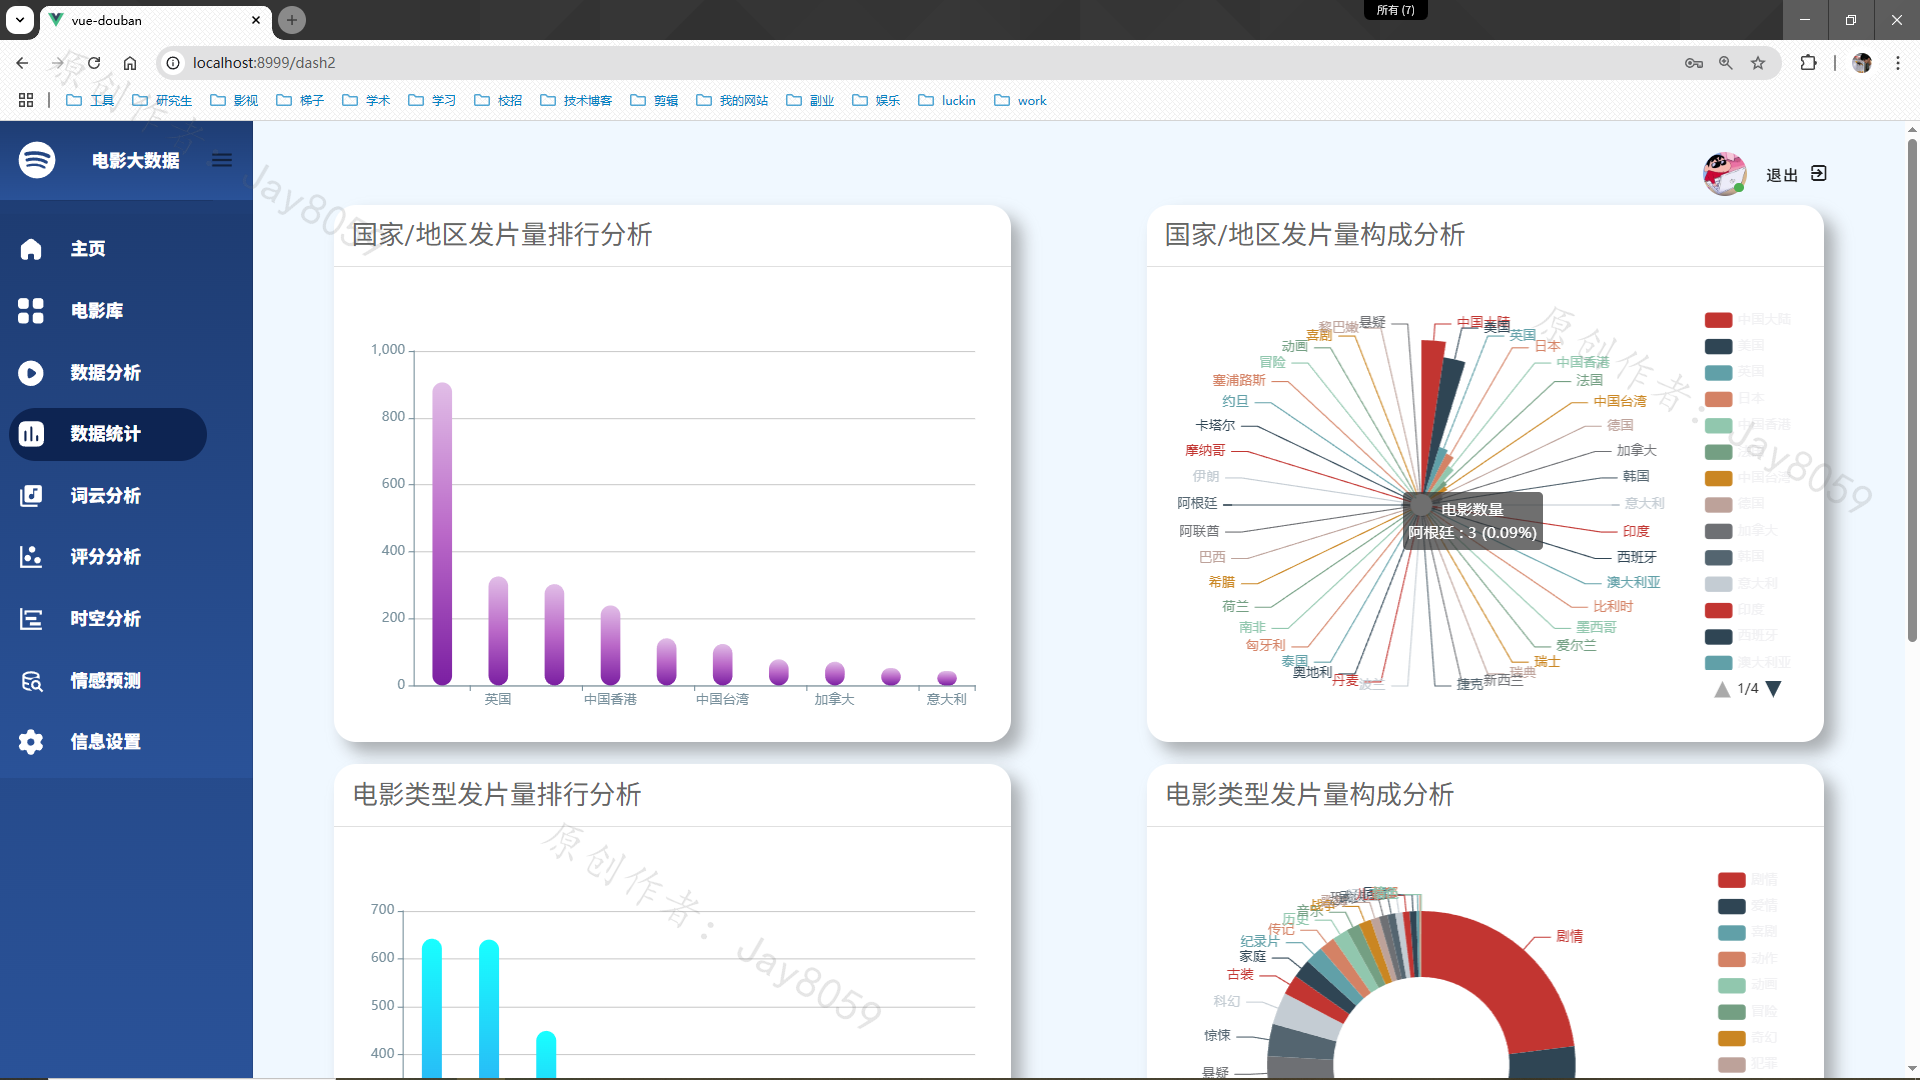
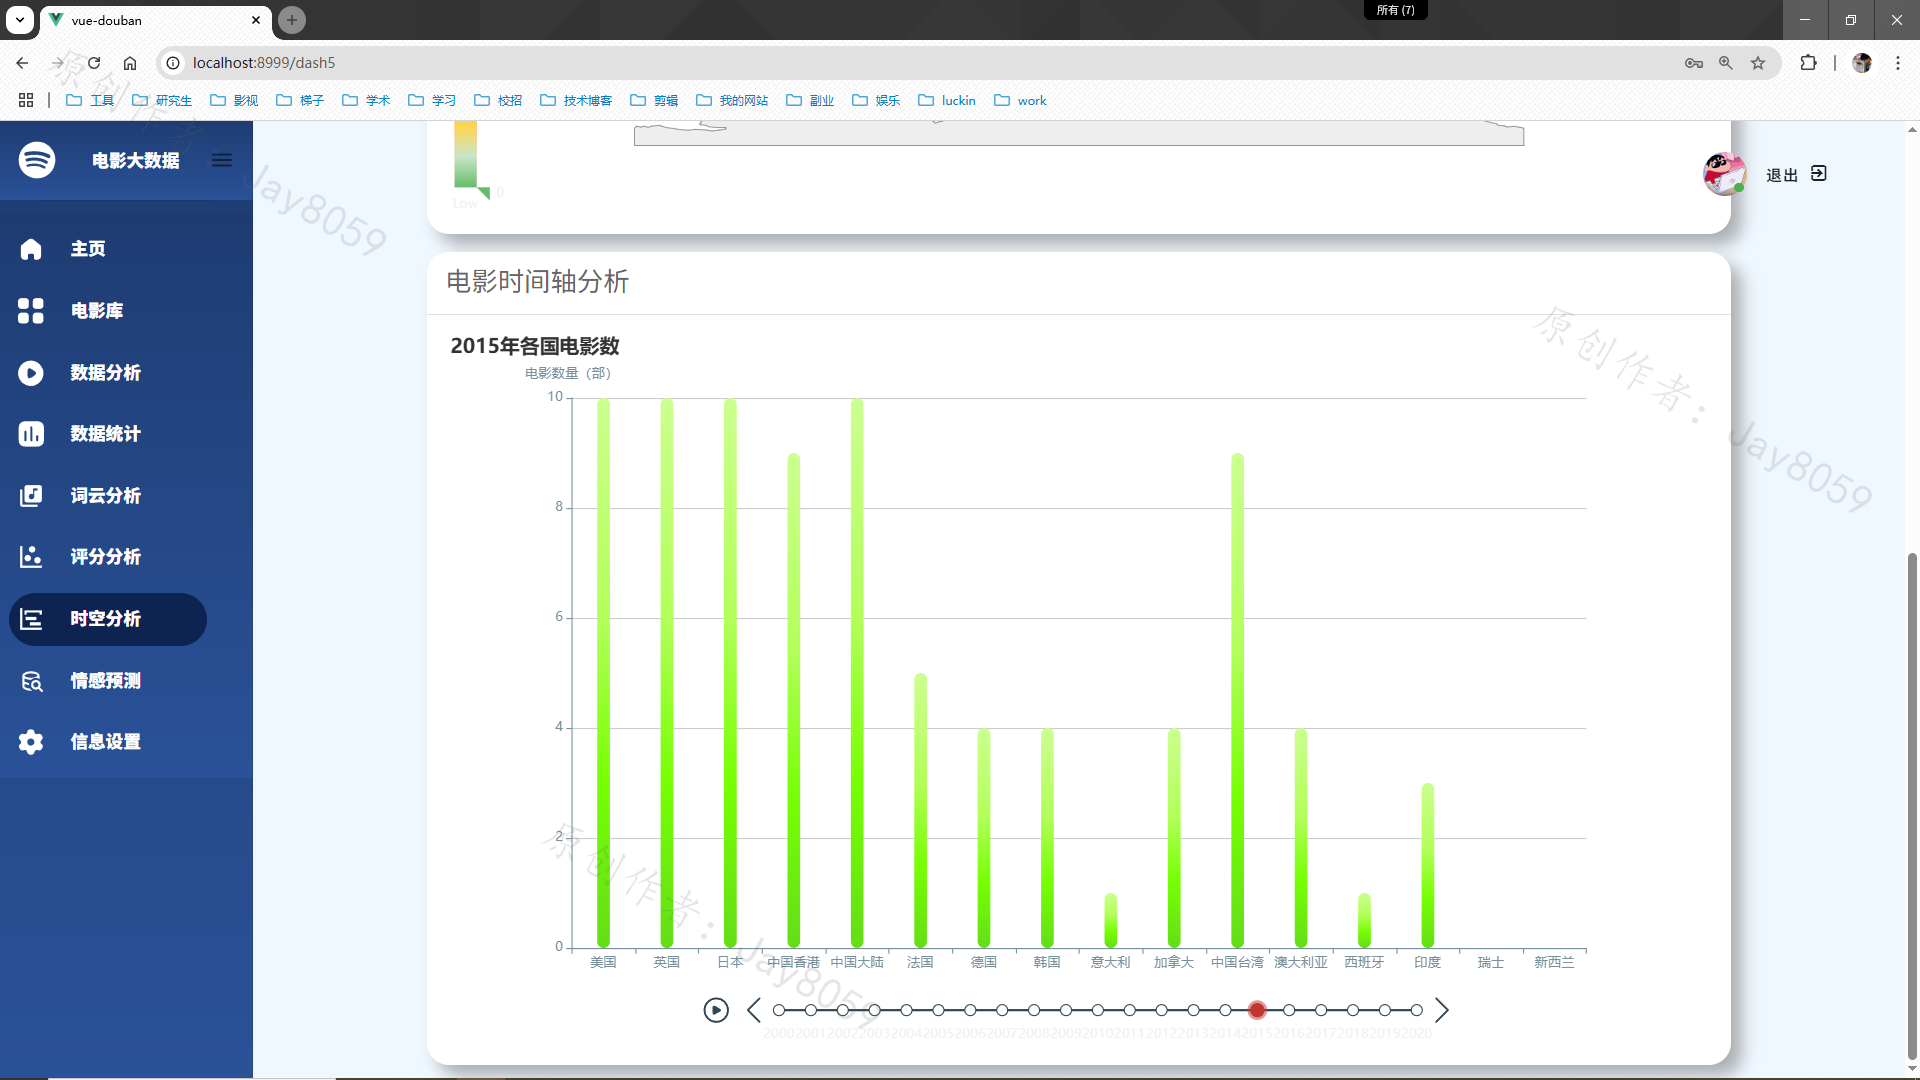
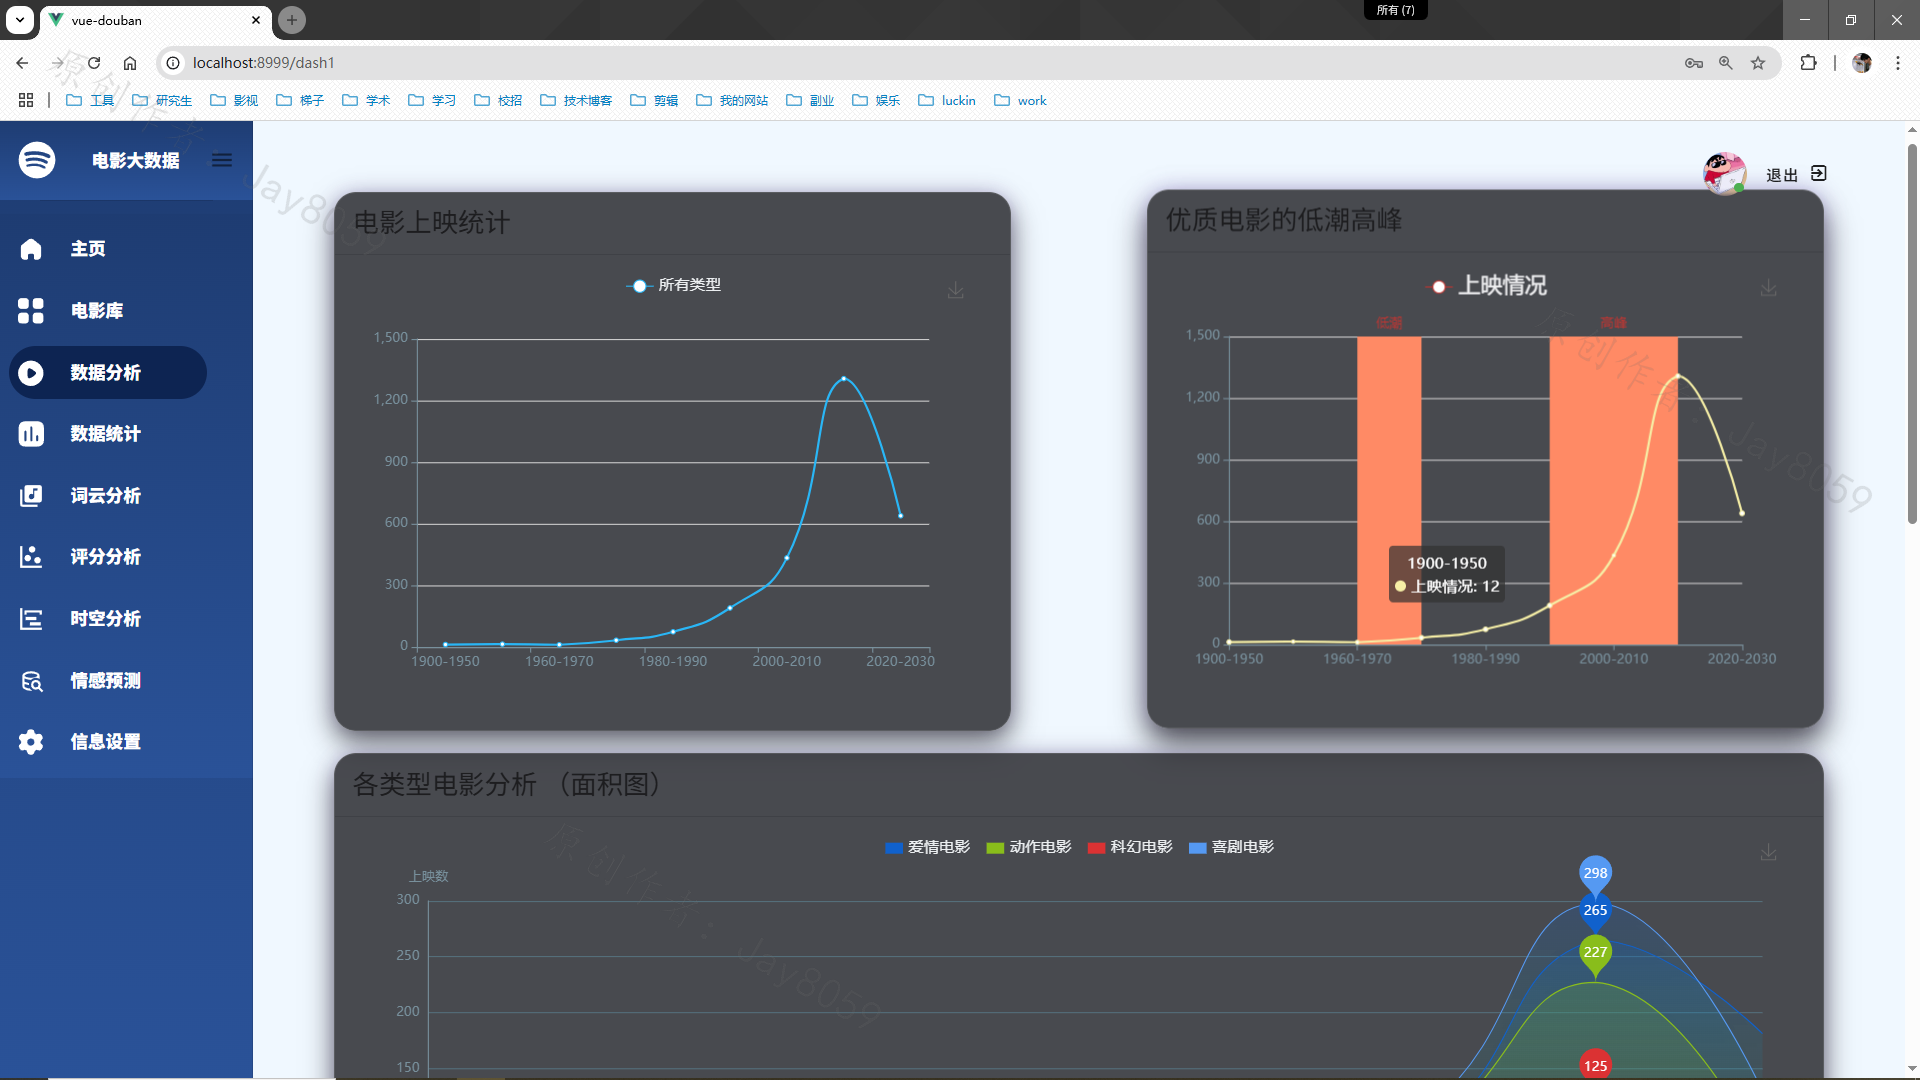
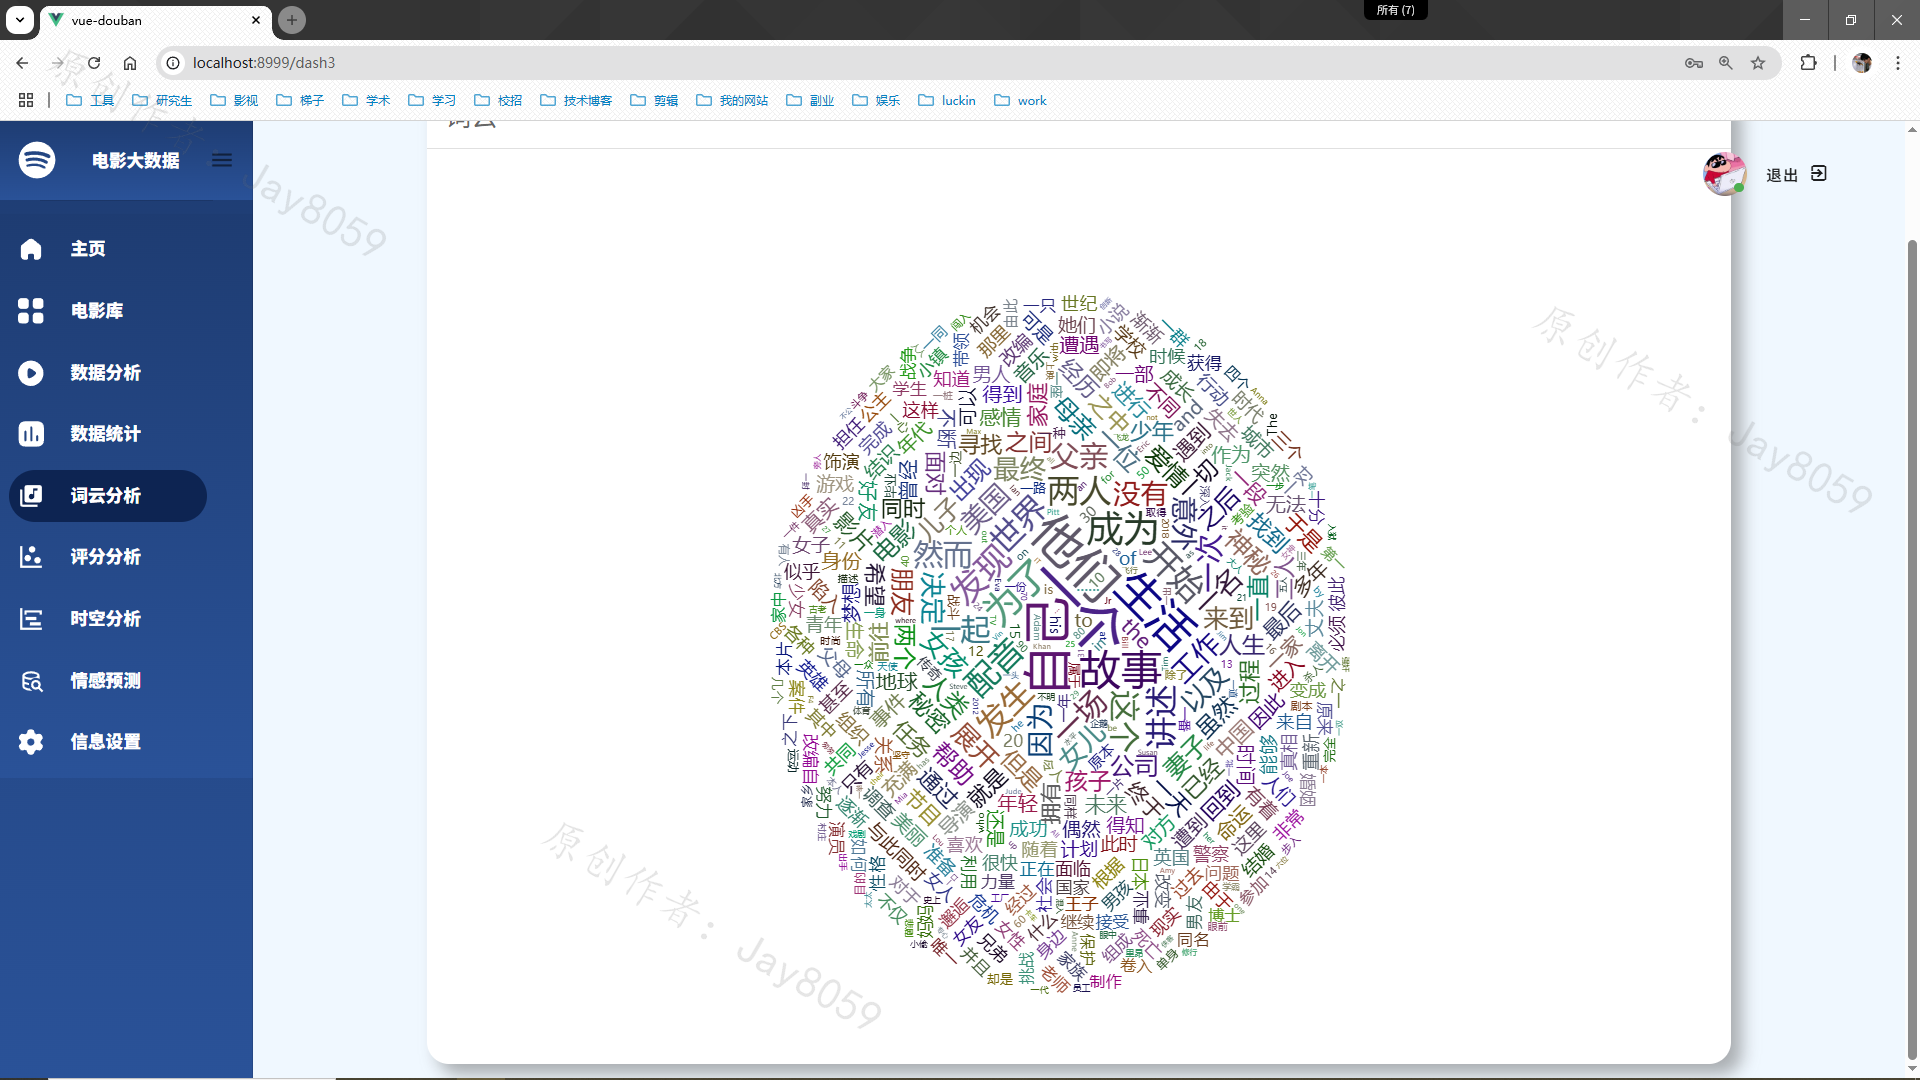
前端包含折线图、柱状图、饼图、词云、时间图、地图和综合 Dashboard 页面,用于展示电影评分、类型、时间分布、评论词频等多维数据。Charts 相关视图提供不同维度的图表呈现。
个性化电影推荐
系统提供 ItemCF 和 UserCF 两类协同过滤推荐。ItemCF 基于电影之间的相似度寻找用户可能感兴趣的影片,UserCF 基于相似用户的历史偏好生成推荐列表;推荐结果在前端电影页面中展示。
评论情感分析
用户可在机器学习页面输入中文评论文本。predict_lstm.py 调用训练后的 LSTM 模型完成情感倾向预测,前端 SentimentalAnalysis.vue 用于展示分析交互和结果。

1.2 数据处理与后台功能
豆瓣数据爬取
Scrapy 项目包含 movie_meta.py、movie_comment.py、movie_subject.py 和 person_meta.py 等爬虫,用于采集电影详情、评论、条目和人物相关数据。管道、代理和 Cookie 等辅助文件配合处理数据采集过程。
电影数据与订单业务
后端通过电影、订单、文件等 API 管理平台业务数据。订单和支付模块包括 orderApi.py、alipayApi.py,文件模块由 fileApi.py 提供支持。
模型训练与维护
deeplearning/train.py 用于 LSTM 情感分析模型训练,model.py 定义模型结构,vocab.json 保存词汇相关数据。推荐算法和深度学习模型可基于已采集或导入的数据持续更新。
三、技术栈
| 层级 | 技术 | 说明 |
|---|---|---|
| 后端 | Flask 2.0.2、SQLAlchemy、Flask-Marshmallow | API 与数据模型 |
| 数据库 | MySQL 8.0 | 电影、评论、用户和订单数据存储 |
| 前端 | Vue 2.6、Vuetify、Vuex、Vue Router、Axios | 页面、组件与状态管理 |
| 数据可视化 | ECharts 4.2.1 | 多类型电影数据图表 |
| 数据采集 | Scrapy | 豆瓣电影和评论数据爬取 |
| 推荐算法 | ItemCF、UserCF | 协同过滤电影推荐 |
| 情感分析 | PaddleNLP、PaddlePaddle、LSTM | 中文评论情感预测 |
四、项目结构
bash
Douban-Movie-Visualization/
├── Flask/
│   ├── api/
│   │   ├── movieApi.py               # 电影接口
│   │   ├── userApi.py                # 用户接口
│   │   ├── orderApi.py               # 订单接口
│   │   ├── fileApi.py                # 文件接口
│   │   └── alipayApi.py              # 支付相关接口
│   ├── algorithm/
│   │   ├── ItemCF.py                 # 基于物品的协同过滤
│   │   └── UserCF.py                 # 基于用户的协同过滤
│   ├── deeplearning/
│   │   ├── model.py                  # LSTM 模型定义
│   │   ├── train.py                  # 模型训练
│   │   └── predict_lstm.py           # 情感预测
│   └── requirements.txt
├── vue/src/views/
│   ├── Charts/                       # ECharts 图表页面
│   ├── MachineLearning/              # 机器学习与情感分析页面
│   ├── Home.vue、Library.vue          # 电影浏览页面
│   └── AccountSettings/              # 账户设置页面
├── scrapy/douban/spiders/            # 电影、评论和人物爬虫
└── 数据库/flask_douban_comment.sql   # 数据库脚本
五、环境要求
- Python 3.7+
- MySQL 8.0
- Node.js 14+
- pip、npm
六、数据库初始化
创建数据库 flask_douban_comment 并导入项目提供的 SQL 文件。随后按本机环境修改 Flask 的数据库连接配置。
bash
mysql -u root -p --default-character-set=utf8mb4 flask_douban_comment < 数据库/flask_douban_comment.sql七、后端启动
bash
cd Flask
pip install -r requirements.txt
python app.py
后端默认地址为 http://localhost:5000。
八、前端启动
bash
cd vue
npm install
npm run serve
九、默认账号
项目未提供可确认的默认账号,请以数据库初始化数据为准。
十、业务流程说明
9.1 数据采集与可视化流程
Scrapy 爬虫采集电影详情、评论和人物信息,并通过管道处理后写入数据库。前端图表页面调用电影相关接口读取统计数据,将评分、类型、时间、词频等分析结果以柱状图、折线图、饼图、词云等形式呈现。
9.2 推荐与情感分析流程
用户浏览电影或产生相关行为后,系统读取电影及用户行为数据,分别使用 ItemCF、UserCF 计算推荐候选结果并返回前端。用户输入评论文本时,LSTM 情感模型加载训练成果进行预测,并将情感分析结果展示在机器学习页面。
十一、交付内容
- Flask 后端、Vue 前端、Scrapy 爬虫及推荐和情感分析模块完整源码。
- 电影数据数据库脚本文件。
- 项目说明文档,包含功能说明、环境、初始化和启动步骤。
本项目为个人原创,结构清晰,功能完整,适合课程设计、毕业设计和项目演示使用。有定制化需求可以评论或私信作者。