第 10 章 提示链 Prompt Chaining
本章要解决的问题
一个复杂任务让模型一口气完成,总是顾此失彼------拆成有序子任务反而更准,怎么拆、怎么串?
章节大纲
- 10.1 模式原理:有序子任务流水线
- 10.2 前一步输出 → 后一步输入
- 10.3 适用场景与实现示例
- 10.4 主流框架对照:LangGraph / 自研实现
- 10.5 变体与演进
- 🛠 解决方案:链长控制与错误传播阻断策略
10.1 模式原理:有序子任务流水线
10.1.1 一句话定义
提示链(Prompt Chaining)是把一个复杂任务拆成多个有序子任务,每个子任务由一次独立的 LLM 调用完成,前一个子任务的输出作为后一个子任务的输入,像流水线一样逐级推进。
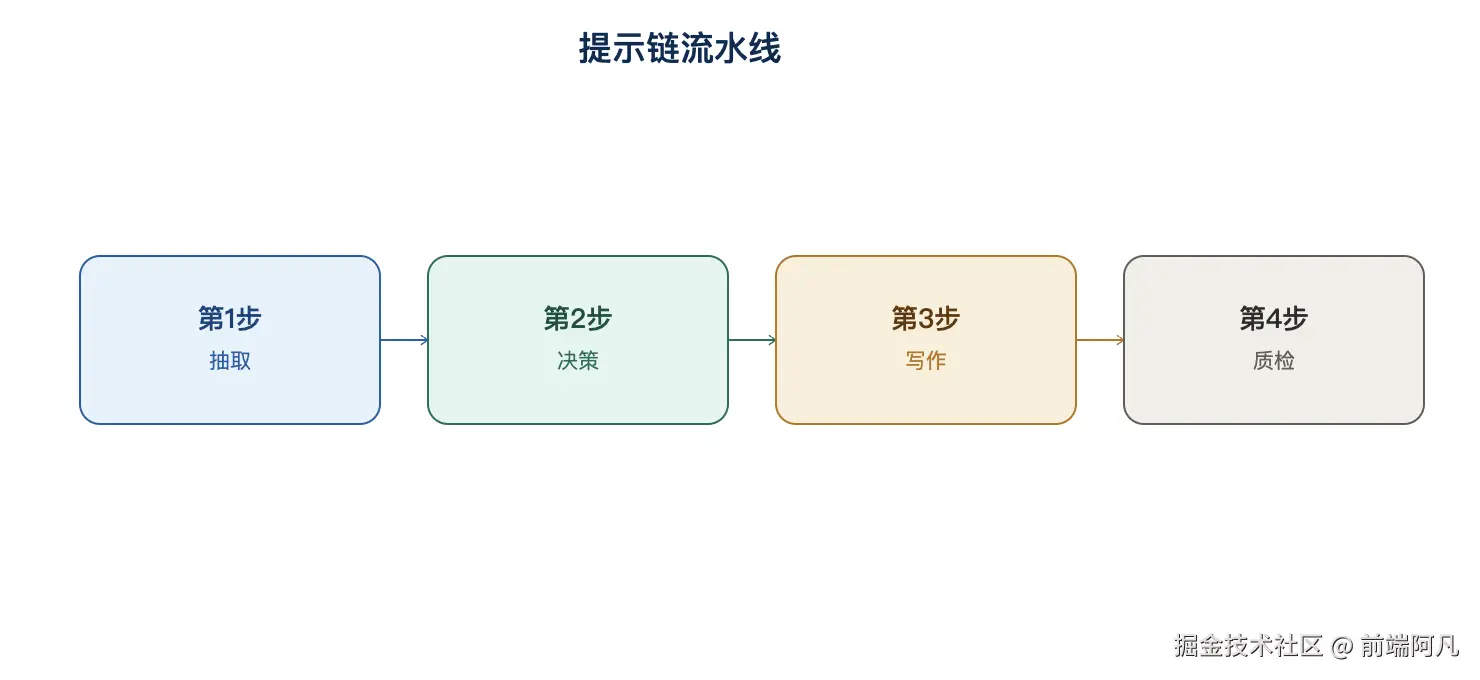
图 1:提示链流水线
它是 9 大设计模式中最基础、最容易被低估的一个。很多人觉得"拆开多调几次模型"只是实现细节,但提示链真正的价值在于:它把"一次赌博"变成"多次可控的质检关卡"。
10.1.2 为什么要拆:一次性提示词的三宗罪
先看反面案例。把"从客服工单中提取客户诉求并生成回复"写成一个大提示词:
text
你是一个客服助手。请阅读下面的客户工单,提取客户的核心诉求,
判断情绪是否激烈,然后生成一封专业的回复邮件,要求语气得体、
解决方案明确、字数在 200 字以内。工单如下:......
这个提示词有三个致命问题:
- 任务耦合 :提取、判断、写作三种能力混在一起。模型可能提取对了却写错了,或者情绪判断错导致回复语气完全跑偏------你无法定位是哪一步错了。
- 上下文污染:判断情绪时模型脑子里还装着"要写 200 字回复"的指令,输出会被隐形干扰。
- 无法复用:换个场景(比如把"工单"换成"差评"),整个提示词要重写。
提示链把上面那个大提示词拆成三步:
text
第 1 步(提取):从工单中提取 [客户诉求, 情绪标签, 关键时间点]
第 2 步(决策):基于提取结果,选择回复策略(安抚/补偿/转人工)
第 3 步(写作):基于前两步的结构化结果,生成回复邮件
每一步只做一件事、输出是严格的结构化数据(通常是 JSON),下一步只消费上一步的字段。错误被隔离在单步内,可定位、可重试、可替换。
10.1.3 与"一次调用"的本质区别
| 维度 | 单次大提示词 | 提示链 |
|---|---|---|
| 错误定位 | 黑盒,只能整体重试 | 白盒,能定位到具体步骤 |
| 中间产物 | 无,一步到底 | 每步有结构化输出,可审计 |
| 调试成本 | 高(改一句影响全局) | 低(单步独立优化) |
| 延迟 | 一次调用 | 多次串行,延迟叠加 |
| Token 成本 | 单次大上下文 | 多次小上下文,总量相近 |
| 适用任务 | 简单、单目标 | 复杂、多阶段、需质检 |
经验法则:如果一次调用能稳定达到 90% 以上的正确率,别拆;如果反复调提示词都上不去,且任务有明显阶段边界(先理解→再决策→再产出),就该拆链。
10.2 前一步输出 → 后一步输入
10.2.1 链的数据契约:结构化输出是链的骨架
提示链能不能跑通,取决于链上的数据契约。每步的输出必须是下步可消费的稳定格式。
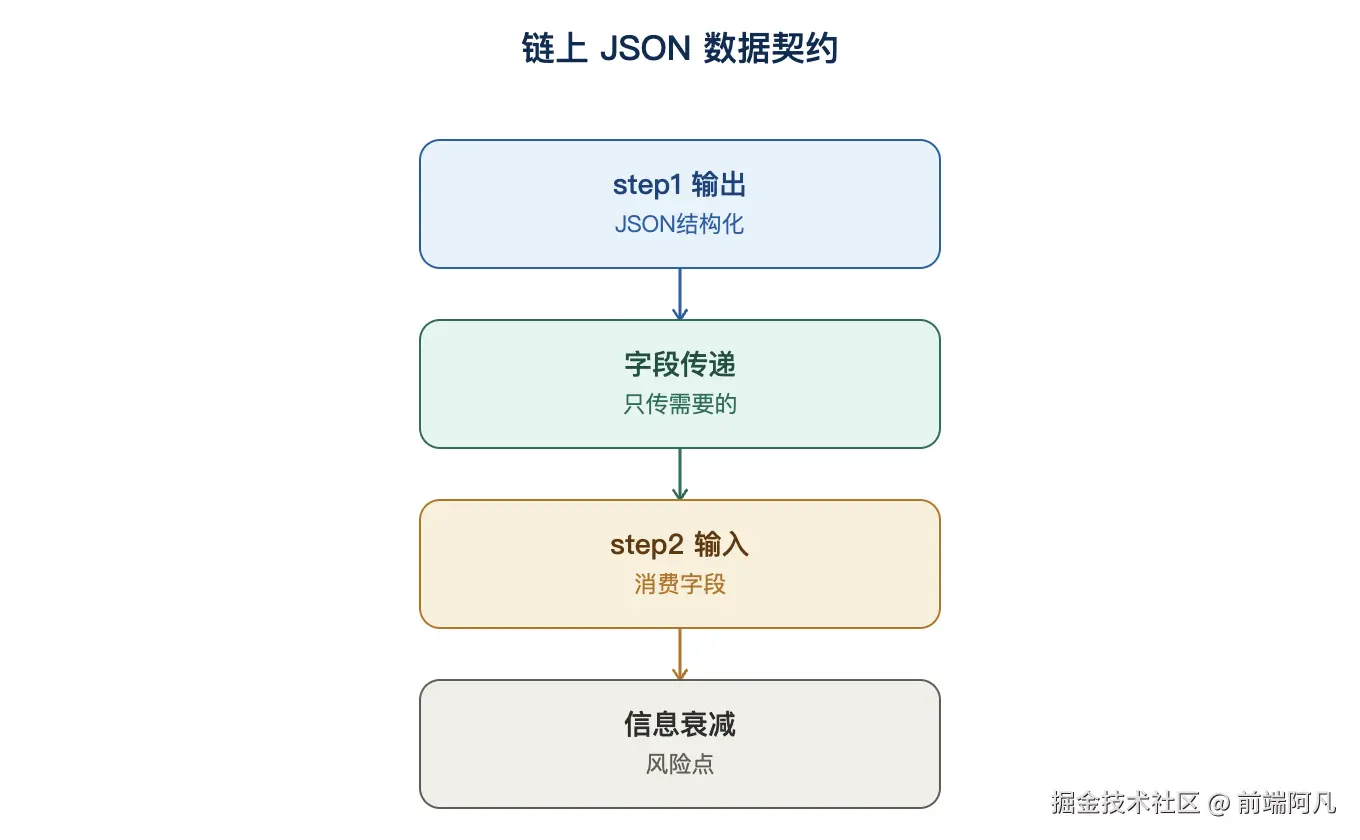
图 2:链上 JSON 数据契约
最推荐的做法:每一步都要求输出 JSON ,并用 response_format={"type": "json_object"} 或 json_schema 强约束(见第 4 章 4.3 节、第 24 章参数表)。例如第一步:
python
# 示例片段:演示两步链的数据契约,完整可运行示例见 10.3.2
extract_prompt = """你是工单信息抽取器。从下面的客户工单中抽取信息,
只输出 JSON,格式如下:
{
  "complaint": "客户的核心诉求",
  "emotion": "calm | frustrated | angry",
  "order_id": "订单号或 null",
  "time_sensitive": true/false
}

工单内容:
{content}
"""

resp = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": extract_prompt}],
    temperature=0.1,          # 抽取任务用低温度,见第 24 章表二
    response_format={"type": "json_object"},
)
try:
    step1 = json.loads(resp.choices[0].message.content)
except json.JSONDecodeError:
    step1 = {}  # 解析失败时降级为空对象,触发后续质检重试
第二步消费 step1 的字段,而不是原始工单:
python
decide_prompt = f"""你是客服策略决策器。基于以下抽取结果,选择回复策略。
只输出 JSON:{{"strategy": "apologize | compensate | escalate"}}

抽取结果:
{json.dumps(step1, ensure_ascii=False)}
"""

resp2 = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": decide_prompt}],
    temperature=0.2,
    response_format={"type": "json_object"},
)
try:
    step2 = json.loads(resp2.choices[0].message.content)
except json.JSONDecodeError:
    step2 = {}  # 解析失败时降级,后续策略按默认走
10.2.2 数据契约的三条设计规范
- 字段最小化:上一步只传下一步需要的字段,别把中间产物全部塞进去------那会让第二步的上下文重新变脏。
- 类型严格化 :布尔、枚举、数字要写清楚,
emotion: "calm | frustrated | angry"而不是emotion: 情绪。这能让第二步的提示词更简单、更稳。 - 可空字段显式声明 :
order_id: "订单号或 null"。不声明可空,模型会编一个假订单号------这是幻觉的重灾区。
10.2.3 链上的"信息衰减"问题
提示链最大的隐性风险是信息衰减:第一步抽取漏了一个关键字段,第二步再聪明也无能为力。
对策有三:
- 抽取得全:第一步输出字段宁多勿少(在成本允许内),把原始文本中的关键信息尽量结构化。
- 关键路径冗余 :对核心信息,可以在第一步要求"引用原文片段"(
evidence: "原文中的那句话"),第二步据此核对,而不是只给转述。 - 链尾质检:最后加一个校验步骤(见 10.3.3),发现缺字段就回退重跑第一步,而不是让错误流到下游。
10.3 适用场景与实现示例
10.3.1 典型适用场景
| 场景 | 链的分段 | 拆链收益 |
|---|---|---|
| 客服工单处理 | 抽取 → 策略决策 → 回复生成 | 情绪判断独立,回复质量可控 |
| 文档摘要 | 分段摘要 → 合并精炼 | 突破上下文窗口,长文档友好 |
| 报告生成 | 数据提取 → 分析 → 结构编排 → 润色 | 每步可人工介入 |
| SQL 生成 | 语义解析 → Schema 匹配 → SQL 生成 → 校验 | 校验步骤拦截错误 SQL |
| 翻译流水线 | 直译 → 文化适配 → 审校 | 审校独立于直译,质量可度量 |
| 多模态处理 | OCR → 文本清洗 → 理解 → 输出 | 清洗步骤提升下游准确率 |
10.3.2 完整示例:客户差评处理链
我们做一个完整的可运行示例:电商差评自动处理链,4 步流水线。
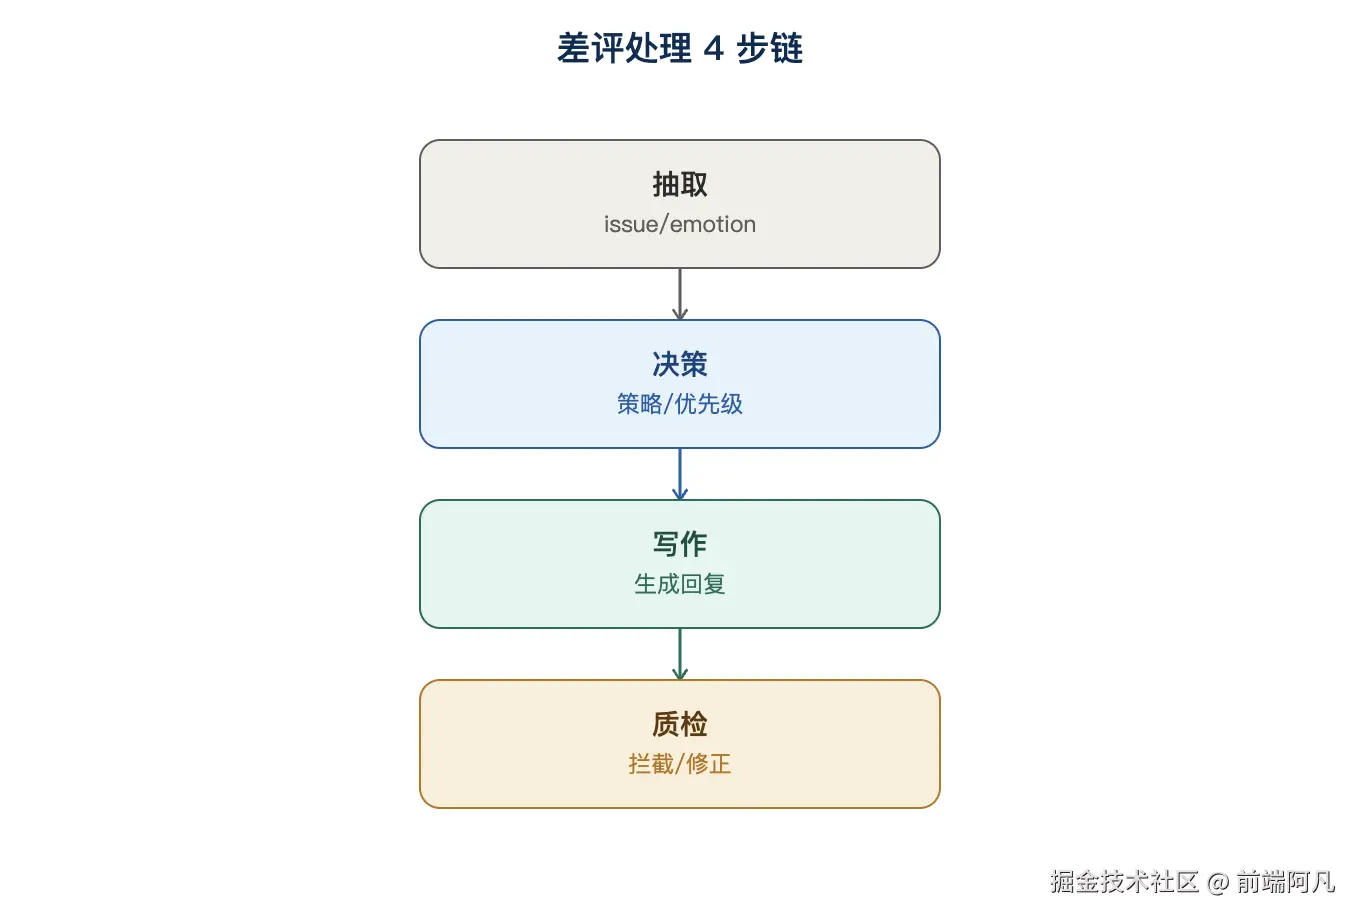
图 3:差评处理 4 步链
python
import json
from openai import OpenAI

client = OpenAI(base_url="https://api.deepseek.com", api_key="<你的Key>")

REVIEW = "东西到手就坏了,客服还爱答不理,再也不来了!差评!"

def call(prompt, temp=0.2):
    """调用模型并解析 JSON 输出。生产环境应加重试和降级逻辑。"""
    resp = client.chat.completions.create(
        model="deepseek-chat",
        messages=[{"role": "user", "content": prompt}],
        temperature=temp,
        response_format={"type": "json_object"},
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError as e:
        # 生产环境应重试或降级,此处简化为抛出
        raise ValueError(f"模型输出 JSON 解析失败: {e}")

# ── 第 1 步:意图与情绪抽取 ──
s1 = call(f"""你是电商差评分析器。抽取差评信息,只输出 JSON:
{{"issue": "具体问题", "emotion": "calm|frustrated|angry",
  "blame": "用户指责的对象", "evidence": "原文关键句"}}
差评内容:{REVIEW}""", temp=0.1)

# ── 第 2 步:处理策略决策 ──
s2 = call(f"""基于差评分析结果,选择处理策略。只输出 JSON:
{{"strategy": "refund|replacement|apology|coupon",
  "priority": "low|medium|high", "reason": "一句话理由"}}
分析结果:{json.dumps(s1, ensure_ascii=False)}""", temp=0.2)

# ── 第 3 步:回复草稿生成 ──
s3 = call(f"""基于策略生成给用户的回复,语气诚恳、不推卸责任、给出可执行方案。
只输出 JSON:{{"reply": "回复全文"}}
策略:{json.dumps(s2, ensure_ascii=False)}
差评原文:{REVIEW}""", temp=0.4)

# ── 第 4 步:质检(拦截幻觉与不当语气)──
s4 = call(f"""你是质检员。检查回复是否符合规范,只输出 JSON:
{{"pass": true/false, "issues": ["问题列表"],
  "corrected_reply": "若有问题则给出修改版,否则为 null"}}
规范:1) 不得否认用户感受 2) 必须给出可执行方案 3) 语气不得敷衍
回复内容:{s3['reply']}""", temp=0.1)

print("意图:", s1)
print("策略:", s2)
print("回复:", s3["reply"])
print("质检:", "通过" if s4["pass"] else f"未通过: {s4['issues']}")这段代码展示了提示链的全部要素:结构化契约(JSON)+ 温度分层(抽取低、写作中)+ 质检关卡(最后一步)。
10.3.3 链尾质检:让"不信任"成为架构的一部分
第四步质检是整个链的灵魂。它把 LLM 的"可能错"变成了"错了就拦住"。
质检步骤的常见实现方式:
- 自检:让同一个模型按规范检查自己的输出(成本低,但可能"自欺")。
- 规则校验:用正则/JSON Schema 校验字段格式(必做,零成本)。
- 异模型互检:用另一个模型(或同一模型低温度)独立检查(效果好,成本翻倍)。
建议组合:规则校验(必做)+ 自检(默认做)+ 异模型互检(仅高风险任务做)。质检不通过时,重跑对应步骤并附上质检意见:
python
if not s4["pass"] and s4["corrected_reply"]:
    # 用质检意见重写回复
    s3["reply"] = s4["corrected_reply"]
10.4 主流框架对照:LangGraph / 自研实现
10.4.1 自研实现(本章主线)
我们已经在上文用纯 Python 实现了链。自研的优势是零依赖、完全可控、每步可插桩打日志,最适合教学和排查问题。生产环境如果链不长(3~5 步)、分支不多,自研完全够用。
一个轻量可复用的链封装:
python
class PromptChain:
    def __init__(self, steps):
        self.steps = steps  # [(name, callable), ...]

    def run(self, initial_input):
        state = initial_input
        trace = []
        for name, step in self.steps:
            state = step(state)
            trace.append({"step": name, "output": state})
        return state, trace
配合日志,每步的输入输出都能被记录到追踪系统(见第 21 章可观测性),线上排错时可以精确看到是哪一步产出异常。
10.4.2 LangGraph 对照
LangGraph 是 LangChain 生态中面向图结构工作流的框架(见第 7 章选型讨论)。同样的链,在 LangGraph 中是"顺序执行的节点图":
python
from typing import TypedDict
from langgraph.graph import StateGraph, END

class ChainState(TypedDict):
    review: str
    extract: dict
    strategy: dict
    reply: str
    quality: dict

def step_extract(state): ...
def step_decide(state): ...
def step_write(state): ...
def step_check(state): ...

g = StateGraph(ChainState)
g.add_node("extract", step_extract)
g.add_node("decide", step_decide)
g.add_node("write", step_write)
g.add_node("check", step_check)
g.add_edge("extract", "decide")
g.add_edge("decide", "write")
g.add_edge("write", "check")
g.add_edge("check", END)
graph = g.compile()
result = graph.invoke({"review": REVIEW})
LangGraph 的核心价值在于状态管理 + 图结构 :当链开始出现条件分支、循环重试时(比如"质检不过→重写→再检"),它的优势会明显超过手写逻辑。建议:纯顺序链用自研(简单透明),出现分支/循环后用 LangGraph(省心可控)。
10.4.3 选择建议
| 因素 | 选自研 | 选 LangGraph |
|---|---|---|
| 链长度 | ≤5 步纯顺序 | 任意 |
| 分支/循环 | 无或很少 | 有 |
| 团队熟悉度 | 想掌控细节 | 已有 LangChain 生态 |
| 调试需求 | 需要自定义插桩 | 内置 trace |
10.5 变体与演进
10.5.1 条件链(Conditional Chaining)
不是所有输入都需要走完整条链。在链首加一个路由判断(见第 11 章路由模式):简单问题直接走短链,复杂问题走长链。这能省大量 token:
python
route = call(f"判断该任务复杂度,只输出 JSON:{{\"level\": \"simple|complex\"}}...")
if route["level"] == "simple":
    result = short_chain.run(input)
else:
    result = long_chain.run(input)
10.5.2 并行-聚合混合链(Fan-out / Fan-in)
链的某一步如果有多个独立子任务,可以先拆成并行分支、再聚合(详见第 12 章并行化)。例如"周报生成链":先并行提取(销售数据 / 客户反馈 / 研发进度),再聚合写周报。
10.5.3 循环链(Recursive Chaining)
质检不过就重跑,本质上是一个"带退出条件的循环"(见第 13 章反思模式)。循环链必须设置最大重试次数,防止死循环烧钱------这是企业上线前的硬性要求。
10.5.4 链与 Agent 的关系
严格来说,提示链通常是无回路的有序流水线 (实际工程中可通过质检重试形成受控循环,见 10.5.3),而 Agent 是有回路、能自主决策的循环 (见第 6 章 Agent 主循环)。设计上的一条经验:任务边界明确、步骤固定的场景用链;需要动态决策、环境交互、多轮工具调用的场景才上 Agent。链通常更便宜、更可控、更好评测;Agent 更灵活,但成本更高、质量更难保证。很多所谓的 Agent 产品,大部分流量其实走的是背后的短链。
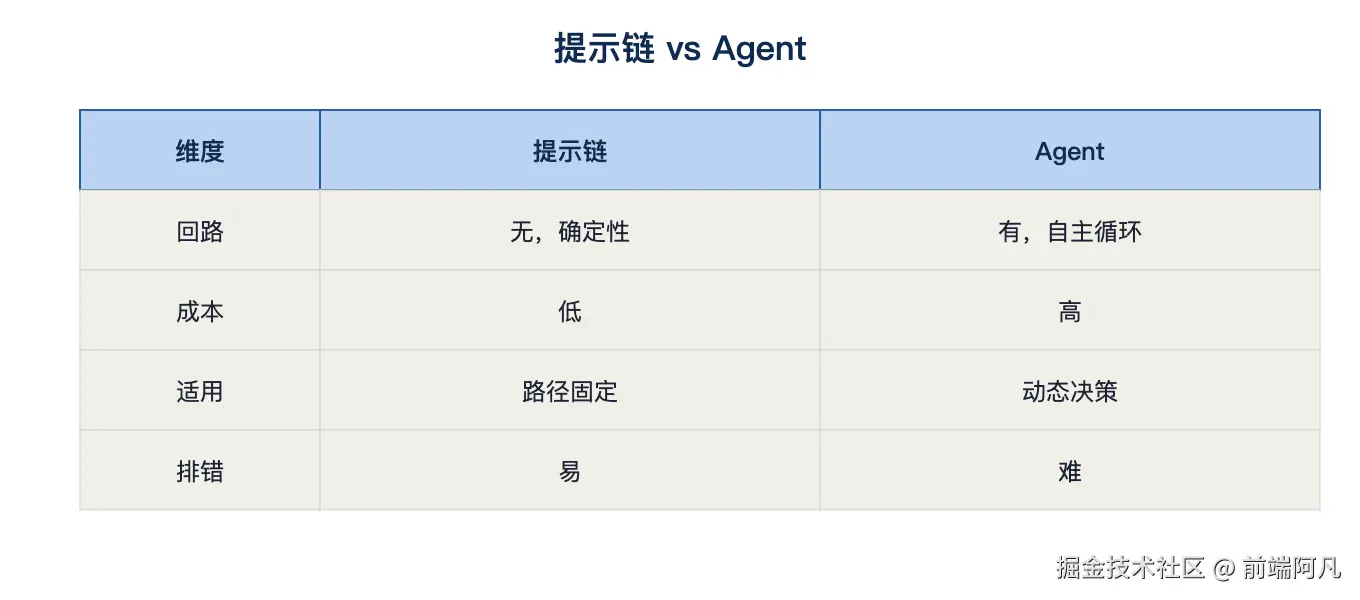
图 4:提示链 vs Agent
🛠 解决方案:链长控制与错误传播阻断策略
常见问题
- "拆了链反而更慢了":链是串行多次调用,延迟必然叠加。对策:能并行就并行(变体 10.5.2)、简单任务走短链(变体 10.5.1)、考虑用小模型跑低价值步骤。
- "第 2 步老是答非所问":90% 是上一步的 JSON 字段没传对或传脏了。先打印链上每一步的 state,检查数据契约(10.2 节)。
- "质检形同虚设" :质检提示词写得太宽松。把规范写成可判定的硬规则("回复必须包含'退款'或'补偿'字样"),别写"语气要诚恳"这种没法判定的软话。
- "链太长,错误滚雪球":超过 6 步的链,信息衰减和错误累积会让收益递减。先压缩步骤,或把链改成树状/分层的结构。
- "某一步特别容易失败" :把最不稳的步骤单独拆出来加重试 + 校验(循环链),失败重跑该步 2~3 次,而不是重跑整条链。
解决方案速查表
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 链结果整体变差 | 信息衰减 | 上一步字段宁多勿少 + 引用原文证据 |
| 单步反复失败 | 提示词模糊 / 数据契约脏 | 严格 JSON Schema + 单步重试 |
| 延迟超标 | 串行调用过多 | 短链路由 / 并行聚合 / 小模型 |
| 质检拦不住错 | 规范不可判定 | 硬规则 + 规则校验 + 异模型互检 |
| 成本超支 | 链无退出条件 | 循环链设最大重试 + 温度分层 |
实战提示
- 先画链再写码:动手前用一张图画出"每步的输入/输出字段",数据契约先定死,代码只是搬运工。
- 温度分层 :抽取/质检步骤用 0
0.2,生成/写作步骤用 0.30.5(对照第 24 章表二)。 - 链上留痕:每一步的输入输出都打 trace(第 21 章),线上出问题 5 分钟定位到步。
- 评测先行:用第 20 章的评测体系给每条链建基线,改任何一步都要回归,防止"修好第 2 步、弄坏第 4 步"。