摘要:上一篇讲了 foreachRDD 是"输出操作",这篇讲它的姊妹算子 transform------一个"转换操作",拿到 RDD 处理后返回新 RDD,让流继续往下算。它的真正价值在于:DStream 只有几十个算子,而 transform 让你能直接用 RDD 全套 API。这篇用黑名单过滤、实时流 join 维度表、用 RDD 独有算子三个场景,把 transform 的用法和坑讲清楚。
关键词:Spark Streaming, transform, 广播变量, 实时流 join 维度表, RDD API
一、transform 和 foreachRDD 是一对,先分清
两者都让你在 Driver 端直接拿到 RDD,但方向相反:
scala
// transform:转换操作,拿到 RDD → 返回新 RDD → 流继续往下算
val newDs = ds.transform(rdd => rdd.filter(...))

// foreachRDD:输出操作,拿到 RDD → 做输出 → 到此为止
ds.foreachRDD(rdd => rdd.foreachPartition(...))判断依据就一条:有没有返回值。transform 返回新 DStream,所以它是惰性的、可链式的;foreachRDD 不返回,是 Action 语义,会触发前面所有转换真正执行。
一个流里 transform 和 foreachRDD 通常是配合着用的:transform 负责加工,foreachRDD 负责落地。
二、transform 的定位:DStream 和 RDD 之间的桥
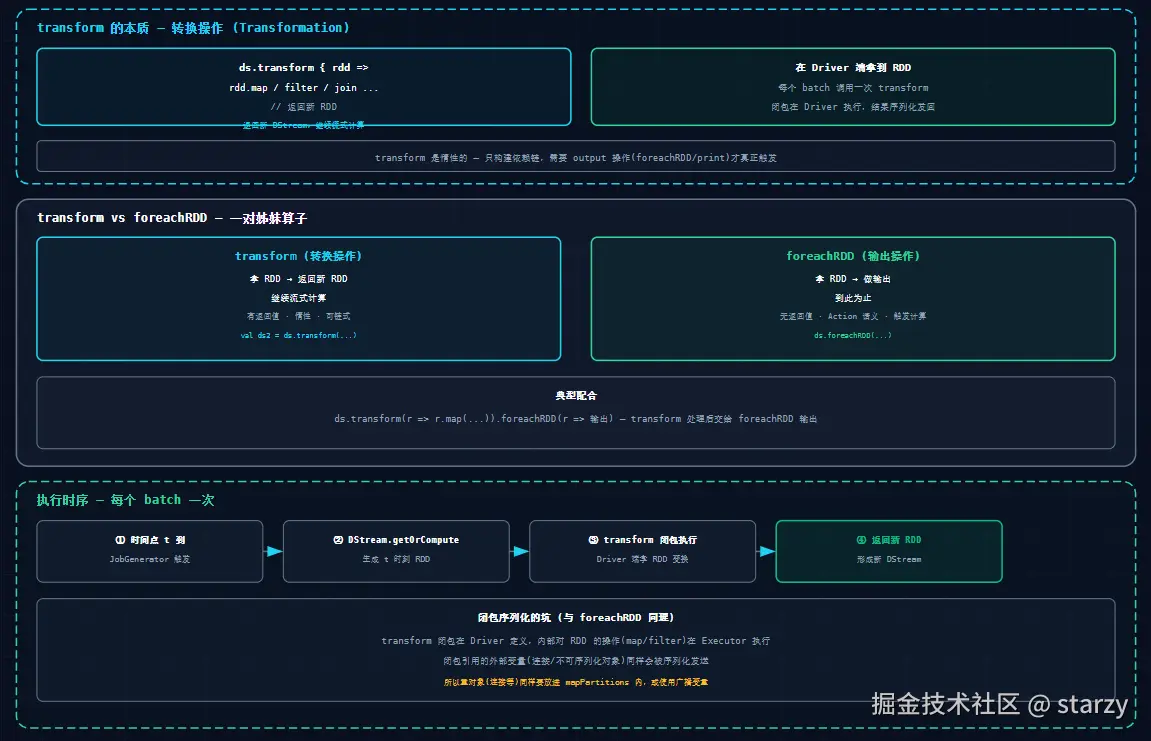
这是理解 transform 为什么存在的关键。DStream 的算子只有几十个,而 RDD 有上百个。很多 RDD 上的能力------mapPartitions、sortBy、distinct、sample、subtract、intersection------DStream 根本不提供。
transform 就是那道桥:它把 RDD 交到你手上,你可以在里面用任何 RDD 算子,再把结果包回 DStream。
scala
val sorted = ds.transform(rdd => rdd.sortBy(_.ts, ascending = false))这个 sortBy 是 DStream 没有的,不借 transform 根本写不出来。
三、场景一:黑名单过滤(transform + 广播变量)
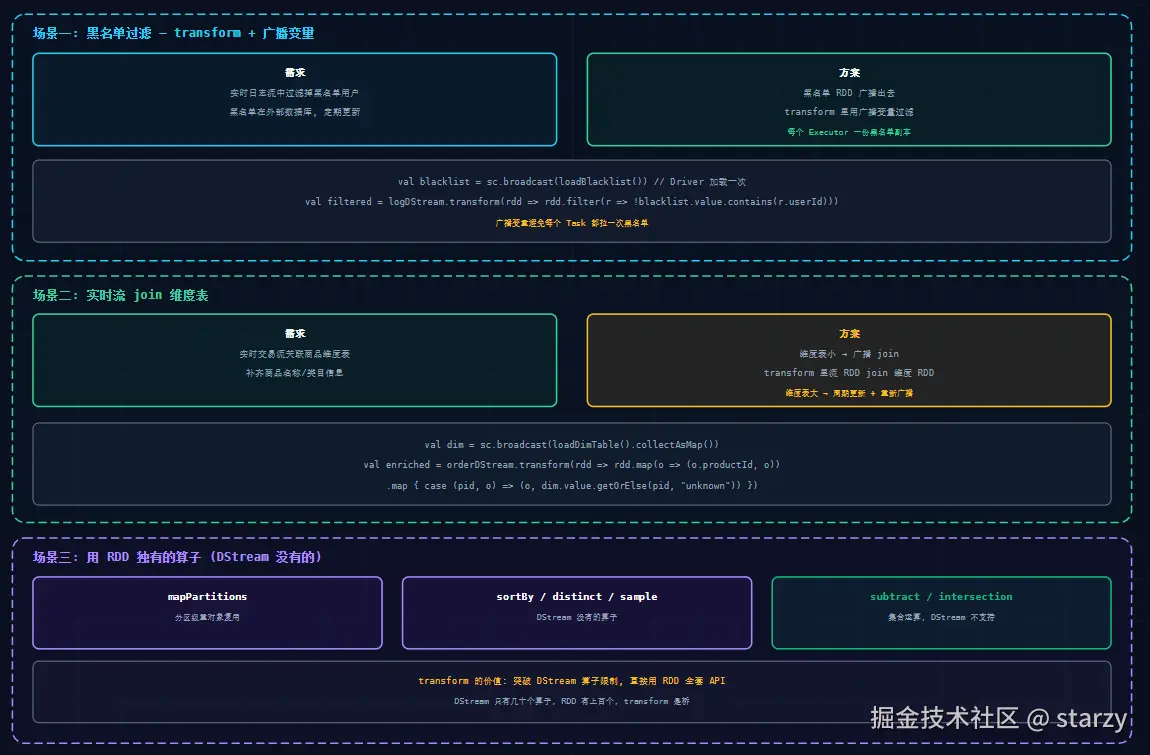
实时日志里要过滤掉一批黑名单用户,黑名单在外部库里、会定期更新。这是 transform 最典型的用法。
scala
// 黑名单加载一次,广播出去,每个 Executor 一份副本
val blacklist = ssc.sparkContext.broadcast(loadBlacklist())

val filtered = logDStream.transform { rdd =>
  rdd.filter(record => !blacklist.value.contains(record.userId))
}
为什么要广播变量 :如果不广播,直接在 filter 闭包里引用 blacklist,这个集合会被序列化后随闭包发给每个 Task------每个 Task 都带一份完整黑名单,网络和内存开销翻倍。广播变量让每个 Executor 只持有一份,所有 Task 共享。
为什么要用 transform :黑名单是 RDD 层面的集合运算,DStream 的 filter 只能传函数,没法方便地引用一个外部集合做 contains 判断。放进 transform 里,你就拿到了 RDD,可以自由地用广播变量做过滤。
四、场景二:实时流 join 维度表
交易流里只有商品 ID,要关联商品维度表补上名称和类目。维度表通常不大,适合广播 join。
scala
// 维度表加载成 Map,广播出去
val dim = ssc.sparkContext.broadcast(
  loadDimTable().collectAsMap()
)

val enriched = orderDStream.transform { rdd =>
  rdd.map { order =>
    val name = dim.value.getOrElse(order.productId, "unknown")
    (order, name)
  }
}
这里的关键点:
- 小表广播 join :维度表几百 MB 以内,用
collectAsMap拉到 Driver、广播到各 Executor,join 时纯内存查 Map,不用 shuffle。 - 维度表会变怎么办 :用
transform每次都从 Driver 侧重新读维度表,或者维护一个定时刷新的广播变量(Spark 1.6+ 的spark.streaming.unpersist配合定时任务)。维度表很大的时候,广播就不合适了,得换外部 KV 存储(HBase/Redis)做关联。
五、场景三:用 RDD 独有的算子
有些需求 DStream 直接写不了,借 transform 就能写。举两个:
scala
// distinct 去重(DStream 没有)
val deduped = ds.transform(_.distinct())

// mapPartitions:分区级复用重对象(连接等)
val processed = ds.transform { rdd =>
  rdd.mapPartitions { iter =>
    // 每分区初始化一次,比如建连接、加载模型
    val helper = new ExpensiveHelper()
    iter.map(helper.process)
  }
}
mapPartitions 这个场景和上一篇 foreachRDD 里讲的连接管理是同一个道理------重量级对象放分区级初始化,而不是每条记录 new 一个。
六、闭包序列化的坑(和 foreachRDD 一样)
transform 的闭包在 Driver 端定义、内部对 RDD 的操作在 Executor 端执行,闭包引用的外部变量同样会被序列化发送。所以:
- 连接、文件句柄这类不可序列化的对象,不能直接写在 transform 闭包里引用,要放进
mapPartitions里。 - 大对象用广播变量,别让每个 Task 都序列化一份。
这两条和 foreachRDD 完全一致,写 transform 时同样要盯紧。
七、总结
- transform 是转换操作,返回新 RDD 让流继续算;foreachRDD 是输出操作,到此为止。判断依据是"有无返回值"。
- transform 是 DStream 到 RDD 的桥,让你能用 RDD 全套 API,突破 DStream 算子限制。
- 三大场景:黑名单过滤(广播变量)、实时流 join 维度表(小表广播)、RDD 独有算子(mapPartitions/distinct/sortBy)。
- 闭包序列化的坑和 foreachRDD 一样:重对象放分区级初始化,大对象用广播变量。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践