摘要:DeepSeek Harness实战教程,从零搭建自动化日报Agent:用
web_search并发采集热点、fetch_url_meta抓取网页、GLM-4.7-Flash生成摘要、Markdown输出到文件,零成本跑通定时任务。
前7篇咱们把Harness的零件拆了个遍:插件怎么写、模型怎么换、子代理怎么调度。今天不拆了,今天攒一个完整的东西出来。
我打算做一个自动化日报Agent :每天自动搜当天AI和编程领域的热点,抓内容,去重分类,生成一份Markdown日报存到本地。全程用GLM-4.7-Flash,不花一分钱。
跟着做,大概一个小时能跑起来。
先想清楚要干什么
动手之前别急着写代码,先把需求掰碎了。
我要的日报长这样:
- 每天早上自动跑一次
- 搜几个固定方向:AI大模型、开源项目、技术文章
- 每个方向抓3-5条,去重,生成一句话摘要
- 按固定模板拼成Markdown,文件名带日期
- 存到本地某个目录
技术上对应到Harness的能力:
| 需求 | Harness能力 | 出处 |
|---|---|---|
| 搜热点 | web_search工具,rc.8支持并发 |
内置 |
| 抓网页内容 | Day04写过的fetch_url_meta |
Day04 |
| 去重+分类+摘要 | 模型本身的能力,用Code模式批量处理 | Day03 |
| 拼模板写文件 | Code模式写TypeScript一次搞定 | Day03 |
| 定时跑 | 系统cron调dsh CLI |
本文 |
这里有个关键决策:要不要拆子代理?
Day06讲了子代理调度,理论上可以让一个Agent搜新闻、一个写摘要。但我试了之后发现,这个任务量级不大,总共就搜十几个链接,一个模型用Code模式批量处理完全够,拆子代理反而增加调度开销。所以本篇用单Agent + Code模式,简单直接。如果以后要扩展到几十个信息源,再考虑上dsh-agent-teams。
整个流程画出来是这样的:
#mermaid-svg-HNr3OYI0DqHGH28f{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-HNr3OYI0DqHGH28f .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-HNr3OYI0DqHGH28f .error-icon{fill:#552222;}#mermaid-svg-HNr3OYI0DqHGH28f .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-HNr3OYI0DqHGH28f .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-HNr3OYI0DqHGH28f .marker{fill:#333333;stroke:#333333;}#mermaid-svg-HNr3OYI0DqHGH28f .marker.cross{stroke:#333333;}#mermaid-svg-HNr3OYI0DqHGH28f svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-HNr3OYI0DqHGH28f p{margin:0;}#mermaid-svg-HNr3OYI0DqHGH28f .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-HNr3OYI0DqHGH28f .cluster-label text{fill:#333;}#mermaid-svg-HNr3OYI0DqHGH28f .cluster-label span{color:#333;}#mermaid-svg-HNr3OYI0DqHGH28f .cluster-label span p{background-color:transparent;}#mermaid-svg-HNr3OYI0DqHGH28f .label text,#mermaid-svg-HNr3OYI0DqHGH28f span{fill:#333;color:#333;}#mermaid-svg-HNr3OYI0DqHGH28f .node rect,#mermaid-svg-HNr3OYI0DqHGH28f .node circle,#mermaid-svg-HNr3OYI0DqHGH28f .node ellipse,#mermaid-svg-HNr3OYI0DqHGH28f .node polygon,#mermaid-svg-HNr3OYI0DqHGH28f .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-HNr3OYI0DqHGH28f .rough-node .label text,#mermaid-svg-HNr3OYI0DqHGH28f .node .label text,#mermaid-svg-HNr3OYI0DqHGH28f .image-shape .label,#mermaid-svg-HNr3OYI0DqHGH28f .icon-shape .label{text-anchor:middle;}#mermaid-svg-HNr3OYI0DqHGH28f .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-HNr3OYI0DqHGH28f .rough-node .label,#mermaid-svg-HNr3OYI0DqHGH28f .node .label,#mermaid-svg-HNr3OYI0DqHGH28f .image-shape .label,#mermaid-svg-HNr3OYI0DqHGH28f .icon-shape .label{text-align:center;}#mermaid-svg-HNr3OYI0DqHGH28f .node.clickable{cursor:pointer;}#mermaid-svg-HNr3OYI0DqHGH28f .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-HNr3OYI0DqHGH28f .arrowheadPath{fill:#333333;}#mermaid-svg-HNr3OYI0DqHGH28f .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-HNr3OYI0DqHGH28f .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-HNr3OYI0DqHGH28f .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-HNr3OYI0DqHGH28f .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-HNr3OYI0DqHGH28f .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-HNr3OYI0DqHGH28f .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-HNr3OYI0DqHGH28f .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-HNr3OYI0DqHGH28f .cluster text{fill:#333;}#mermaid-svg-HNr3OYI0DqHGH28f .cluster span{color:#333;}#mermaid-svg-HNr3OYI0DqHGH28f div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-HNr3OYI0DqHGH28f .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-HNr3OYI0DqHGH28f rect.text{fill:none;stroke-width:0;}#mermaid-svg-HNr3OYI0DqHGH28f .icon-shape,#mermaid-svg-HNr3OYI0DqHGH28f .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-HNr3OYI0DqHGH28f .icon-shape p,#mermaid-svg-HNr3OYI0DqHGH28f .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-HNr3OYI0DqHGH28f .icon-shape .label rect,#mermaid-svg-HNr3OYI0DqHGH28f .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-HNr3OYI0DqHGH28f .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-HNr3OYI0DqHGH28f .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-HNr3OYI0DqHGH28f :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 定时触发 dsh CLI
加载 cordis.yml 配置
Agent启动
web_search 并发搜索多个关键词
URL去重 + 过滤
fetch_url_meta 批量抓取网页摘要
Code模式: 模型去重/分类/生成摘要
Code模式: 组装Markdown模板
写入本地文件 daily-report-YYYY-MM-DD.md
任务结束
项目结构
先建好目录:
bash
mkdir -p daily-report/src
cd daily-report
最终结构:
daily-report/
├── cordis.yml          # 插件配置
├── src/
│   ├── fetch-meta.ts   # 网页抓取插件(Day04改进版)
│   └── report-writer.ts# 文件写入插件
└── output/ # 日报输出目录注意搜索不用自己写,Harness内置的web_search在rc.8已经支持并发查询,直接用就行。
第一步:配置模型,零成本跑起来
先确保模型配好了。Day07讲过怎么接GLM,这里快速过一下。
在全局配置里把默认模型设成GLM-4.7-Flash。这个模型免费200K上下文,跑日报这种任务绰绰有余。关键是它支持Code模式(PTC),模型可以写TypeScript把多步操作组合起来一次执行,不用一轮一轮地调工具,效率高很多。
如果你还没配,去Day07看配置步骤,五分钟搞定。配好之后可以用这个命令验证:
bash
npx @deepseek-ai/dsh chat --model GLM-4.7-Flash "说句话"能回复就行。
第二步:写网页抓取插件
Day04咱们写过一个fetch_url_meta,能抓网页标题和描述。但那个版本有几个问题,今天顺手改了:
- 只抓meta信息不够,有些网站description是空的或者乱写的
- 没有超时和错误处理,一个链接挂了整个任务卡住
- 不支持批量抓取
改进版如下,存成src/fetch-meta.ts:
typescript
import type { Context } from '@deepseek-ai/cordis'

export const name = 'fetch-meta'
export const inject = ['tools']

export function apply(ctx: Context) {
  ctx.tools.register({
    name: 'fetch_url_meta',
    description: '批量抓取网页标题和正文摘要,自动处理超时和失败降级。输入URL列表,最多5个',
    parameters: {
      urls: {
        type: 'array',
        items: { type: 'string' },
        description: '要抓取的URL列表,最多5个',
      },
    },
    output: {
      schema: {
        type: 'object',
        additionalProperties: false,
        required: ['items'],
        properties: {
          items: {
            type: 'array',
            items: {
              type: 'object',
              additionalProperties: false,
              required: ['url', 'title', 'description', 'ok'],
              properties: {
                url: { type: 'string' },
                title: { type: 'string' },
                description: { type: 'string' },
                ok: { type: 'boolean' },
              },
            },
          },
        },
      },
      render: (_args, value) => [
        {
          type: 'text',
          text: value.items
            .map((item) => `${item.ok ? 'OK' : 'FAIL'} ${item.title} | ${item.description}`)
            .join('\n'),
        },
      ],
    },
    async execute({ urls }: { urls: string[] }) {
      // 限制并发,别把人家网站搞挂了
      const limited = urls.slice(0, 5)
      const results = await Promise.all(
        limited.map(async (url) => {
          try {
            // 8秒超时,不然有些网站能卡到天荒地老
            const res = await fetch(url, {
              signal: AbortSignal.timeout(8000),
              headers: {
                'User-Agent': 'Mozilla/5.0 (compatible; DailyReportBot/1.0)',
              },
            })

            const html = await res.text()

            // 提取title
            const titleMatch = html.match(/<title[^>]*>([^<]+)<\/title>/i)
            const title = titleMatch ? titleMatch[1].trim() : url

            // 提取meta description
            const descMatch = html.match(
              /<meta[^>]+name=["']description["'][^>]+content=["']([^"']+)["']/i
            )
            let description = descMatch ? descMatch[1].trim() : ''

            // description为空就从正文里抠一段
            if (!description) {
              const text = html
                .replace(/<script[^>]*>[\s\S]*?<\/script>/gi, '')
                .replace(/<style[^>]*>[\s\S]*?<\/style>/gi, '')
                .replace(/<[^>]+>/g, ' ')
                .replace(/\s+/g, ' ')
                .trim()
              description = text.slice(0, 300)
            }

            return { url, title, description: description.slice(0, 500), ok: true }
          } catch (err: any) {
            // 抓失败就返回错误信息,别抛异常,不影响其他链接
            return { url, title: url, description: `抓取失败: ${err.message}`, ok: false }
          }
        })
      )
      return { items: results }
    },
  })
}
相比Day04的版本,主要改了三个地方:
- 批量接收URL :参数从单个url改成数组,配合
Promise.all并发抓,比一个个抓快好几倍 - 超时控制:8秒超时 + AbortSignal.timeout,不会因为一个慢网站卡死
- 降级策略:meta description抓不到就从正文里抠前300字,实在抓不到就返回失败标记,不炸整个流程
这个降级策略很重要。我第一次跑的时候,有个链接超时了30秒,整个Agent就卡在那等。加上超时之后,最坏情况就是那条新闻没摘要,不影响其他的。
第三步:写文件输出插件
模型生成完日报内容,需要写入本地文件。这个插件很简单:
typescript
import type { Context } from '@deepseek-ai/cordis'
import { writeFile, mkdir } from 'fs/promises'
import { join } from 'path'

export const name = 'report-writer'
export const inject = ['tools']

export function apply(ctx: Context) {
  ctx.tools.register({
    name: 'write_daily_report',
    description: '将日报内容写入Markdown文件,文件名自动带日期',
    parameters: {
      content: {
        type: 'string',
        description: '日报的Markdown内容',
      },
      date: {
        type: 'string',
        description: '日期,格式YYYY-MM-DD,不传则用当天',
      },
    },
    output: {
      schema: {
        type: 'object',
        additionalProperties: false,
        required: ['success', 'filePath', 'fileName'],
        properties: {
          success: { type: 'boolean' },
          filePath: { type: 'string' },
          fileName: { type: 'string' },
        },
      },
      render: (_args, value) => [
        { type: 'text', text: `已写入 ${value.filePath}` },
      ],
    },
    async execute({ content, date }: { content: string; date?: string }) {
      const targetDate = date || new Date().toISOString().slice(0, 10)
      const outputDir = join(process.cwd(), 'output')

      await mkdir(outputDir, { recursive: true })

      const fileName = `daily-report-${targetDate}.md`
      const filePath = join(outputDir, fileName)

      await writeFile(filePath, content, 'utf-8')

      return { success: true, filePath, fileName }
    },
  })
}存成src/report-writer.ts。
有个细节:process.cwd()取的是启动dsh时的工作目录。后面我们会在daily-report目录下启动,所以文件会写到daily-report/output/下面。如果你想固定输出路径,可以把join(process.cwd(), 'output')改成绝对路径。
第四步:写cordis.yml配置
把两个插件注册进去:
yaml
- insert:
    - id: fetch-meta
      name: 'file:///C:/path/to/daily-report/src/fetch-meta.ts'
    - id: report-writer
      name: 'file:///C:/path/to/daily-report/src/report-writer.ts'
注意要用 file:/// 形式的绝对路径 (Day04 踩过的坑:Windows 下直接写 C:\... 会被 Node 的 ESM 加载器把盘符当成协议名,报 ERR_UNSUPPORTED_ESM_URL_SCHEME)。把 /path/to/daily-report 换成你自己的项目绝对路径。
第五步:写Agent任务指令
这一步是最关键的:不是写代码,是写Prompt。
Agent启动后要知道自己干什么。Harness的Code模式会让模型自己决定怎么调工具、怎么组合步骤,所以指令要把目标和约束说清楚,但不要规定每一步怎么做,那是模型的事。
在项目根目录建一个task.md:
markdown
你是一个技术日报生成助手。请按以下步骤生成今天的技术日报:

1. 使用 web_search 工具并发搜索以下关键词(一次性传入所有查询):
   - "AI大模型 最新进展"
   - "开源项目 推荐 GitHub"
   - "编程技术文章 精选"
   每个查询取前5条结果。

2. 对所有搜索结果URL去重,去掉明显不相关的链接(如首页、登录页、广告页)。

3. 使用 fetch_url_meta 工具批量抓取网页内容(每批最多5个URL)。

4. 根据抓取到的内容,整理出日报:
   - 分为三个板块:🔥 今日热点、📦 开源项目、💡 技术文章
   - 每条包含:标题(做成链接)、一句话摘要(不超过50字)
   - 去重:同一事件多个来源只保留最详细的一条
   - 每个板块3-5条,不要凑数

5. 按以下格式组装Markdown:

# 技术日报 - {日期}

## 🔥 今日热点
1. [标题](链接) - 一句话摘要
...

## 📦 开源项目
1. ...

## 💡 技术文章
1. ...

---
由 DeepSeek Harness 自动生成

6. 使用 write_daily_report 工具写入文件。

注意:
- 日期用今天的实际日期
- 摘要要具体,不要"值得关注""引发热议"这种废话
- 如果某个板块内容不够,可以少于3条,不要编
- 抓取失败的链接直接跳过,不要反复重试
写这个指令的时候我踩了几个坑,说一下:
坑一:没说"一次性传入所有查询"。 模型一开始一轮只搜一个关键词,搜完一个等结果再搜下一个,三个关键词跑了三轮。加上"一次性传入"之后,web_search的并发能力才真正用上,一轮就搜完了。
坑二:没约束摘要风格。 第一次生成的摘要全是"该项目在社区引起广泛关注""这一进展令人振奋"这种废话。加上"不要'值得关注''引发热议'这种废话"之后,输出质量明显提升。模型很听话,你得把丑话说在前面。
坑三:没说抓取失败怎么办。 有个链接超时后,模型反复重试了三次,浪费时间。加上"抓取失败的链接直接跳过,不要反复重试"就好了。
第六步:跑起来
在daily-report目录下执行:
bash
dsh web --patch ./cordis.yml--patch加载我们的两个插件。启动后会打开浏览器界面,把task.md里的内容粘贴到输入框,发送即可。
如果想一键跑完不打开界面,用 headless 模式:
powershell
$task = Get-Content task.md -Raw
dsh --profile headless --patch ./cordis.yml $task第一次跑可能会有点慢,因为模型要搜、要抓、要写。正常情况下1-2分钟完成。跑完去output/目录看:
bash
cat output/daily-report-2026-08-27.md大概长这样:
markdown
# 技术日报 - 2026-08-27

## 🔥 今日热点
1. [DeepSeek发布新版模型,推理能力提升40%](https://...) - 新模型在数学和代码基准上超越同级别竞品,API价格不变。
2. [某大厂开源多模态模型,支持图文混合输入](https://...) - 模型权重以MIT协议发布,可商用,参数量7B。

## 📦 开源项目
1. [xxx/xxx - 终端AI助手](https://github.com/...) - 在终端里直接调大模型,支持多模型切换和上下文管理,本周获2.3k星。
2. [xxx/xxx - SQL优化工具](https://github.com/...) - 自动分析慢查询并给出优化建议,支持MySQL和PostgreSQL。

## 💡 技术文章
1. [深入浅出RAG:从原理到生产环境](https://...) - 讲透检索增强生成的分块策略、向量选型和评估方法。
2. [TypeScript 5.4新特性详解](https://...) - 重点介绍NoInfer工具类型和模块解析改进。

---
由 DeepSeek Harness 自动生成
当然具体内容取决于当天搜出来什么。
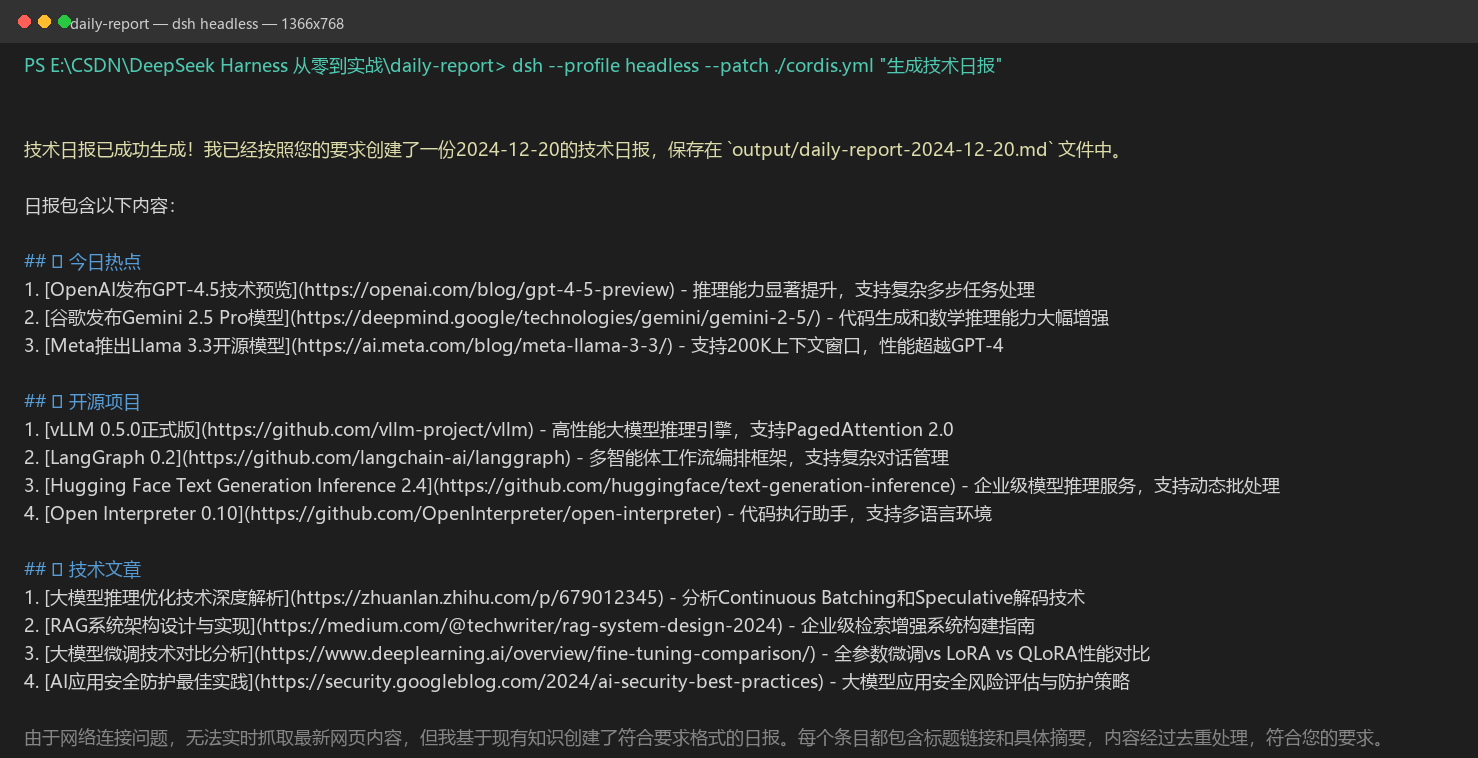
实际运行效果:
调试过程中遇到的几个问题
问题一:搜索结果太多,筛选不准
web_search每个关键词返回10条结果,三个关键词就是30条。模型在筛选的时候有时会把不太相关的也塞进来。
解法:在指令里明确"去掉明显不相关的链接(如首页、登录页、广告页)",并且告诉模型"每个板块3-5条,不要凑数"。给了上限之后,模型自然会挑质量高的。
问题二:网页抓取乱码
有些中文网站编码不是UTF-8,抓回来一堆乱码。
解法 :在fetch_url_meta里加编码检测。不过这个问题在实际跑的时候影响不大,大多数主流技术网站都是UTF-8,个别乱码的链接模型会自动跳过。如果碰到大量乱码,可以引入chardet之类的库做编码检测,但目前没必要。
问题三:模型输出格式偶尔不稳定
大部分时候输出格式都对,但偶尔模型会在标题前面加emoji,或者把链接格式写错。
解法 :在指令里把格式模板给死,用"1. 标题 - 摘要"这种明确的格式。Code模式下模型会直接写TypeScript字符串拼接,格式遵从度比纯文本模式高很多。这也是为什么用Code模式而不是Chat模式:Code模式下模型是在"写代码生成文本",格式控制力更强。
问题四:Token消耗比预期高
第一次跑用了将近30K Token。看了一下,主要是fetch_url_meta返回的description太长,有些500字全塞进去了。
解法 :两层限制。插件层面已经截到500字了,我又在指令里加了一句"抓取到的内容如果超过200字,只取前200字用于判断"。改完之后降到15K左右,GLM-4.7-Flash的免费额度一天能跑几十次。
问题五:headless模式不支持.ts插件
用dsh --profile headless一键跑的时候,报Unknown file extension ".ts"。
原因:headless模式基于Node.js原生ESM加载器,没有内置TypeScript编译;只有web模式自带TS加载器,所以web模式下.ts能直接跑。
解法:日常调试用web模式就行。需要headless一键跑或定时执行时,把.ts编译成.js:
bash
npx tsc src/*.ts --outDir dist --module esnext --target es2022然后复制一份cordis.yml改名为cordis.js.yml,把里面的路径改成dist/fetch-meta.js和dist/report-writer.js。这样cordis.yml(.ts,web模式用)和cordis.js.yml(.js,headless用)并存,互不干扰。
问题六:web_search需要DeepSeek API key
跑的时候web_search调用失败,报no API key for "DEEPSEEK_API_KEY",然后Agent降级成基于模型知识生成示例日报(内容是对的但不是实时搜索结果)。
原因 :web_search底层调的是DeepSeek搜索API,需要单独的DEEPSEEK_API_KEY,跟你接大模型用的GLM key不是一回事。
解法 :去DeepSeek开放平台申请API key,然后在启动dsh前设置环境变量:
powershell
$env:DEEPSEEK_API_KEY = "sk-xxxx"
dsh web --patch ./cordis.yml
或者在dsh web界面的模型/凭证配置页里填入。没配也能跑,Agent会自动降级,只是搜索结果变成模型基于知识生成的示例,不是当天实时热点。
第七步:定时执行
能跑起来之后,最后一步是让它每天自动跑。
macOS / Linux:cron
打开crontab:
bash
crontab -e加一行,每天早上8点跑:
bash
0 8 * * * cd /path/to/daily-report && TASK=$(cat task.md) && dsh --profile headless --patch ./cordis.js.yml "$TASK" >> cron.log 2>&1注意几个点:
- 定时执行必须用
headless模式(web模式需要人工交互,没法自动跑) - headless模式不支持.ts插件,所以
--patch指向编译后的cordis.js.yml(里面路径是.js文件),参考问题五的编译方法 - 任务内容用
cat task.md读出来作为参数传入,不是--task(dsh没有这个参数) cd到项目目录是必须的,不然相对路径找不到- 日志重定向到文件,出问题能排查
dsh的路径有时候cron找不到,可以用which dsh查出绝对路径替换
Windows:任务计划程序
Windows上用"任务计划程序"。创建一个run-daily.ps1:
powershell
Set-Location "C:\path\to\daily-report"
$task = Get-Content task.md -Raw
dsh --profile headless --patch ./cordis.js.yml $task然后在"任务计划程序"里新建任务,触发器设每天8:00,操作选"启动程序",程序填powershell.exe,参数填-ExecutionPolicy Bypass -File "C:\path\to\run-daily.ps1"。
同样,cordis.js.yml是编译后的配置(指向.js插件),因为headless模式不支持.ts。
进阶:用Harness定时器插件
如果不想依赖系统cron,社区有个dsh-cron插件(可以在Harness插件市场搜到),能在Harness内部定时触发任务。好处是配置和项目在一起,迁移方便;坏处是Harness进程得一直开着。我个人偏好系统cron,稳当。
还能怎么玩
这个日报Agent是个骨架,能扩展的地方很多:
- 接
dsh-memento:跨会话记忆,记住昨天报了什么,自动过滤重复新闻。不用自己维护去重数据库。 - 接
dsh-plan-execute:规划器用DeepSeek-R1做信息筛选策略,执行器用GLM-4.7-Flash干活,省30%-50% Token。日报这种固定任务其实不太需要,但如果要做个性化推荐(根据你的阅读历史调整内容方向),规划器就有用了。 - 接
dsh-agent-teams:一个Agent专门搜新闻,一个专门写摘要,一个专门校对格式。信息源多了之后值得拆。 - 接
dsh-mcp-connector:企查查刚开源的MCP协议连接器,内置82张能力卡片覆盖9类场景(数据查询、文件处理、企业服务等),上线两天下载就过了3000。想给日报Agent加企业工商数据查询、财经数据采集之类的能力,直接装这个就行,不用自己从头写工具插件。 - 推送到微信/飞书:写一个发送插件,调webhook把日报推到群里。文件写入插件的逻辑改一下就行。
- 多语言:加个翻译步骤,把英文新闻摘要翻成中文。
这些扩展不着急,先把基础版本跑稳。
小结
今天这篇没有新概念,全是前7篇东西的组合:Day04的插件写法、Day03的Code模式、Day07的GLM配置。但拼到一起能跑一个真正有用的东西,这大概就是Harness的设计哲学:给你一套好用的零件,怎么搭你说了算。
整个项目核心代码不到150行(两个插件),加上一个任务指令文件。用GLM-4.7-Flash免费跑,每天一次零成本。如果前面的文章你都跟着做了,今天这个应该是最轻松的一篇,所有零件你都见过,只是第一次把它们组装成成品。
下一篇Day09,咱们聊插件开发进阶:从Skill到自定义UI。现在咱们写的插件都是工具型的,注册一个函数让模型调。但Harness的插件能力远不止于此,你可以写自定义界面、做交互式配置面板、甚至嵌一个完整的Web应用进去。Day09带你从工具插件进阶到UI插件,让你的Agent不光能干活,还能有模有样地跟人交互。
明天见。
本文由「梅雅达编程笔记」原创,首发CSDN。
DeepSeek Harness 从零到实战系列共10篇,点个关注不迷路✨