网页采集如何稳定输出结构化数据,真正困难的通常不是完成一次 API 调用,而是让结果可以校验、失败可以定位、后续能够回到原始证据。本文围绕"如何把网页字段抽取、链接发现和页面快照组合成可验证的采集流水线"给出一套可以直接落到任务状态和数据契约上的实现方式。
问题与结果
将结构化结果、链接清单和页面快照分别留存,避免单次 AI 抽取结果直接进入业务库。
最终交付不是一段不可追溯的模型回答,而是一组带来源、版本、状态和失败记录的数据。这样既方便接入后续系统,也能在接口、页面或模型输出变化时定位问题。
适用场景
- 商品与价格页面监测
- 公开资料结构化采集
- 页面变更与证据快照
实现前先确定边界
- 先定义字段契约,再调用网页转 JSON
- 候选 JSON 必须经过本地 Schema 校验
- 快照用于复核,不替代业务字段真实性校验
可验证工作流
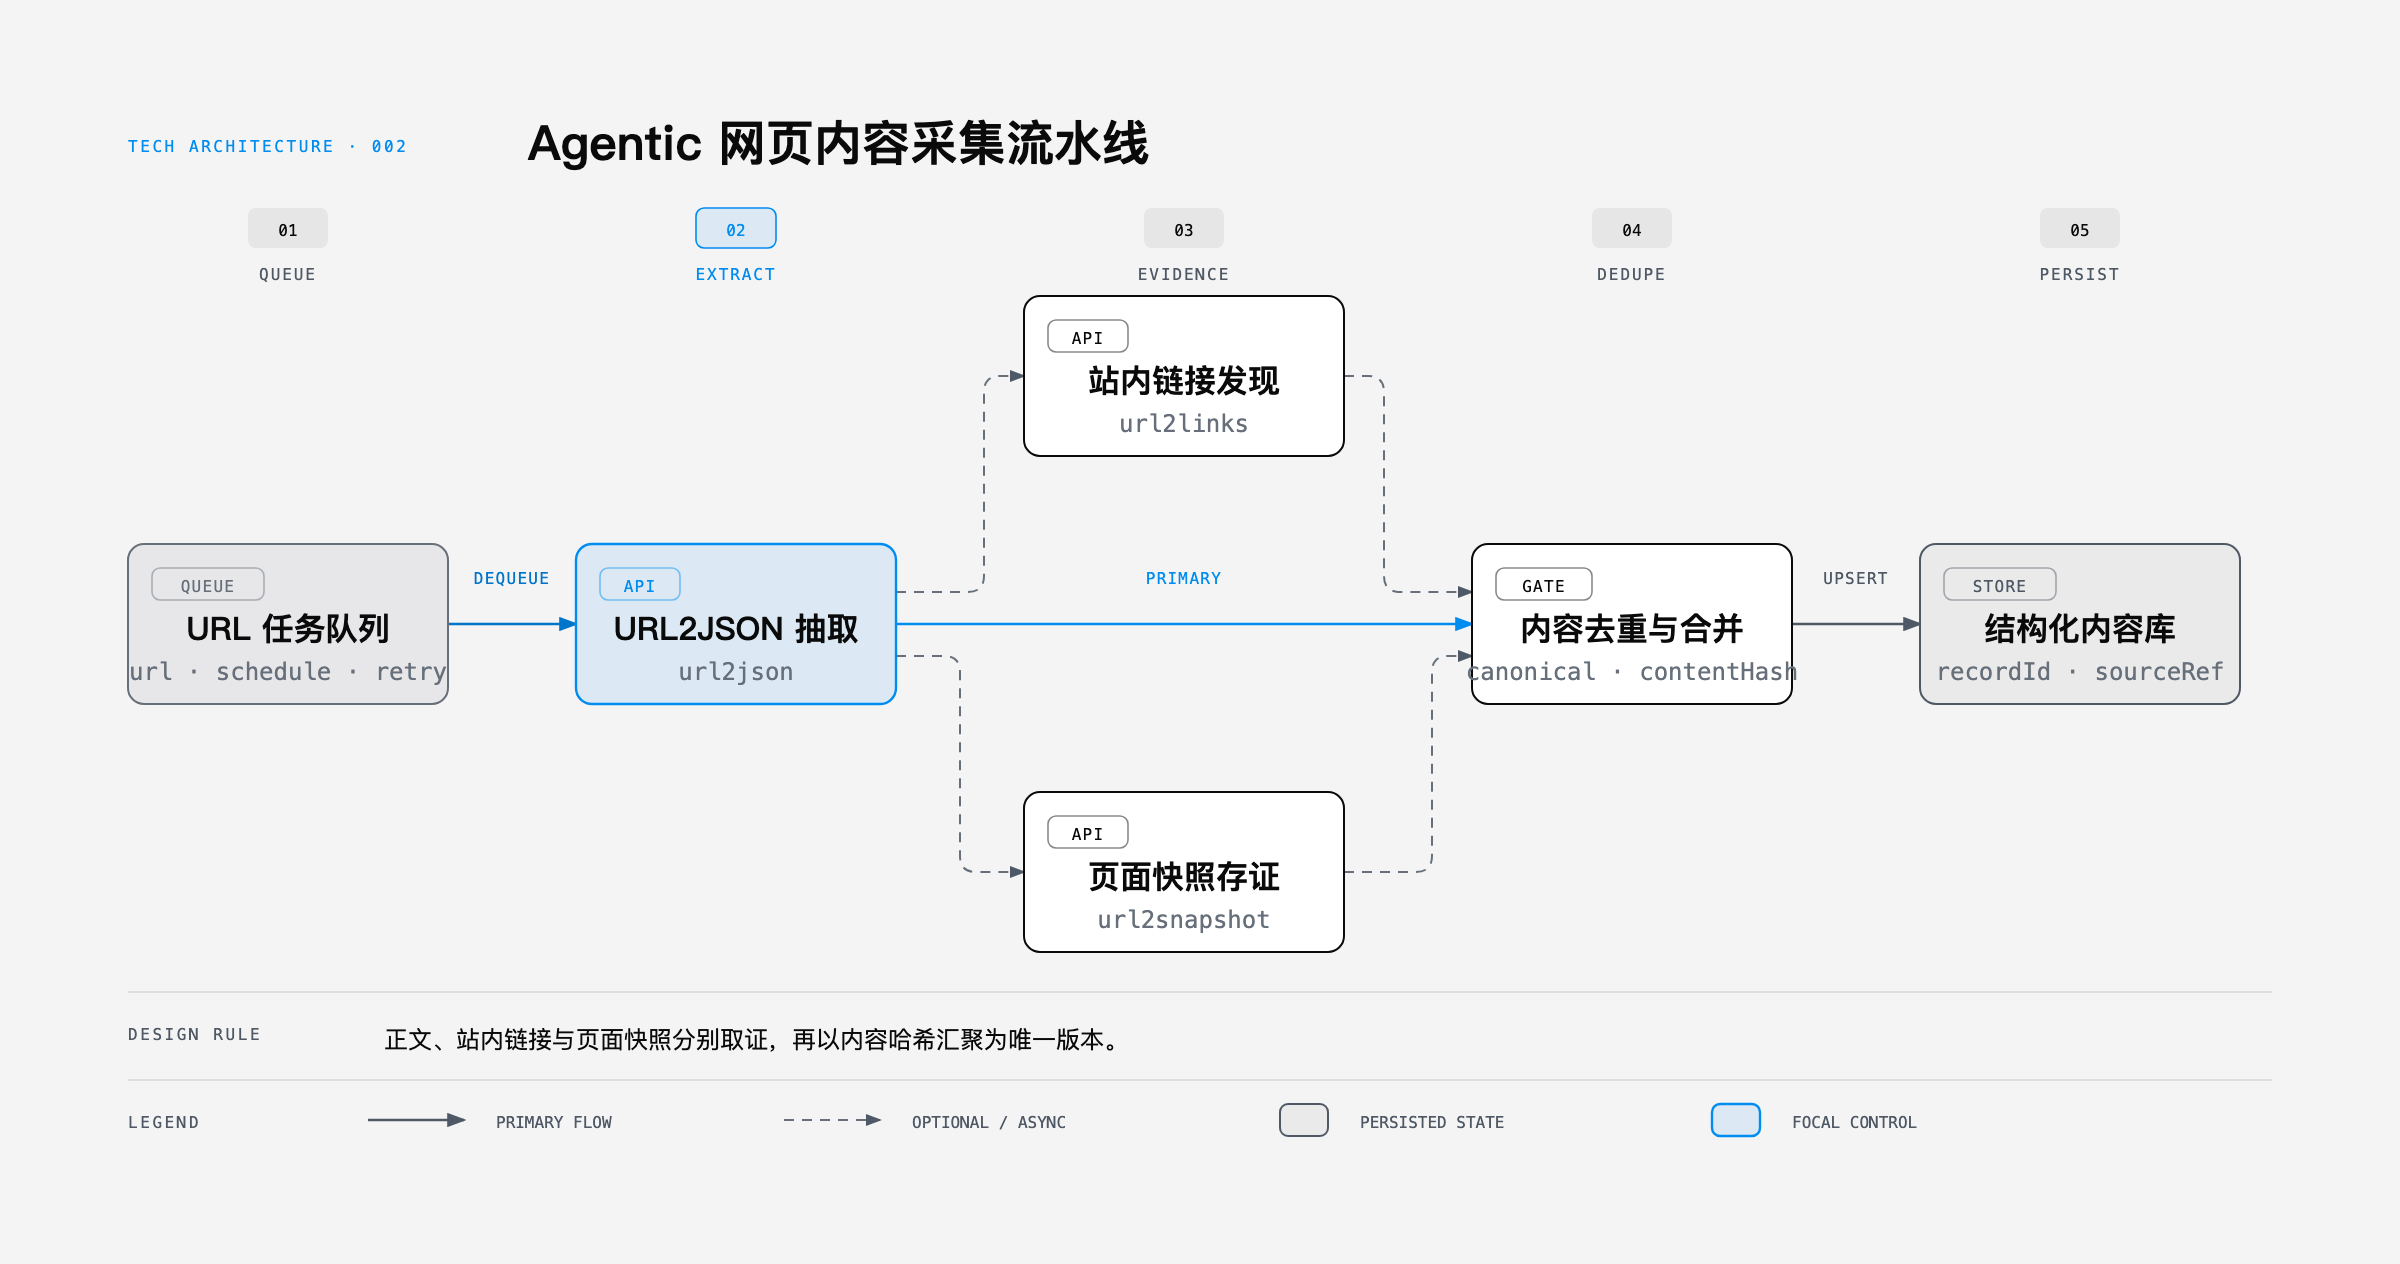
API 编排与职责
| 能力 | 接口 | 请求方式 | 适合场景 |
|---|---|---|---|
| 语义化抽取字段 | 语义化获取站点 JSON 结构内容 | POST | 从页面提取标题、价格、作者、摘要等指定字段 |
| 提取页面链接 | 网页 URL 链接提取 | GET | 构建后续采集队列或发现关联页面 |
| 保留页面状态 | 网站截图与 HTML 快照 | POST | 保存页面截图和 HTML 快照,便于复核 |
最小可运行实现
bash
curl -X POST "https://api.gugudata.com/websitetools/url2json?appkey=YOUR_APPKEY&url=https%3A%2F%2Fexample.com%2Fproduct%2F10001&prompt=%E6%8F%90%E5%8F%96%E5%95%86%E5%93%81%E6%A0%87%E9%A2%98%E3%80%81%E4%BB%B7%E6%A0%BC%E3%80%81%E5%93%81%E7%89%8C%E3%80%81%E4%B8%BB%E8%A6%81%E5%8F%82%E6%95%B0%E5%92%8C%E9%A1%B5%E9%9D%A2%E6%91%98%E8%A6%81%EF%BC%8C%E8%BF%94%E5%9B%9E%20JSON%E3%80%82"
bash
curl -G "https://api.gugudata.com/websitetools/url2links" \
  --data-urlencode "appkey=YOUR_APPKEY" \
  --data-urlencode "url=https://example.com/product/10001"
bash
curl -X POST "https://api.gugudata.com/websitetools/url2snapshot?appkey=YOUR_APPKEY&url=https%3A%2F%2Fexample.com%2Fproduct%2F10001&responseFormat=url&fullPage=true&width=1920&height=1080"Agent 如何决策
Agent 不需要每次都调用所有接口。一个实用策略是:
| 页面类型 | 建议动作 |
|---|---|
| 文章页 | URL 转 JSON,提取标题、作者、发布时间和摘要 |
| 列表页 | 先提取链接,再把详情页加入队列 |
| 商品页 | URL 转 JSON,同时保留截图作为价格证据 |
| 低可信页面 | 只记录链接和截图,不自动入库 |
返回处理
URL 转 JSON 的 Data 结构会随 prompt 变化,因此自己的程序要先定义目标字段,再校验返回结果。链接提取结果建议去重后入队,并记录来源页面。截图或快照结果要和结构化字段绑定,方便之后人工复核。
工程化注意事项
- prompt 要短而明确,说明目标字段,不要把业务规则全部塞进抽取指令。
- 采集队列需要限速和失败重试,避免因为外部页面波动导致任务堆积。
- 对重复 URL 做规范化,例如去掉无意义的追踪参数。
- 对结构化结果设置字段级校验,缺少关键字段时进入人工审核。
数据契约与留痕
建议至少保存以下字段;真实项目可以继续拆分,但不要删除来源、版本和状态信息。
| 字段 | 作用 |
|---|---|
source_url |
来源或目标 URL,保留最终跳转前后的差异 |
prompt_version |
规则、输入或产物版本,变更时保留旧版本 |
candidate_json |
业务数据字段,保存时记录来源、口径和缺失状态 |
schema_version |
规则、输入或产物版本,变更时保留旧版本 |
links |
业务数据字段,保存时记录来源、口径和缺失状态 |
snapshot_ref |
业务数据字段,保存时记录来源、口径和缺失状态 |
所有派生结果都应带生成时间和输入版本。发生重试时新增尝试记录,不要覆盖最后一次失败,以免排查时只剩"最终成功"而看不到中间问题。
验收清单
- 字段缺失会进入隔离队列
- Prompt 和 Schema 均可追溯
- 原页面变化后仍可定位采集证据
能力边界
页面动态渲染、访问控制和字段语义会影响结果;接口响应成功不能替代业务校验。
示例中的 YOUR_APPKEY 仅为占位符。真实密钥只能放在服务端环境变量或密钥管理系统中,不应进入前端、文章、日志或版本库。