✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
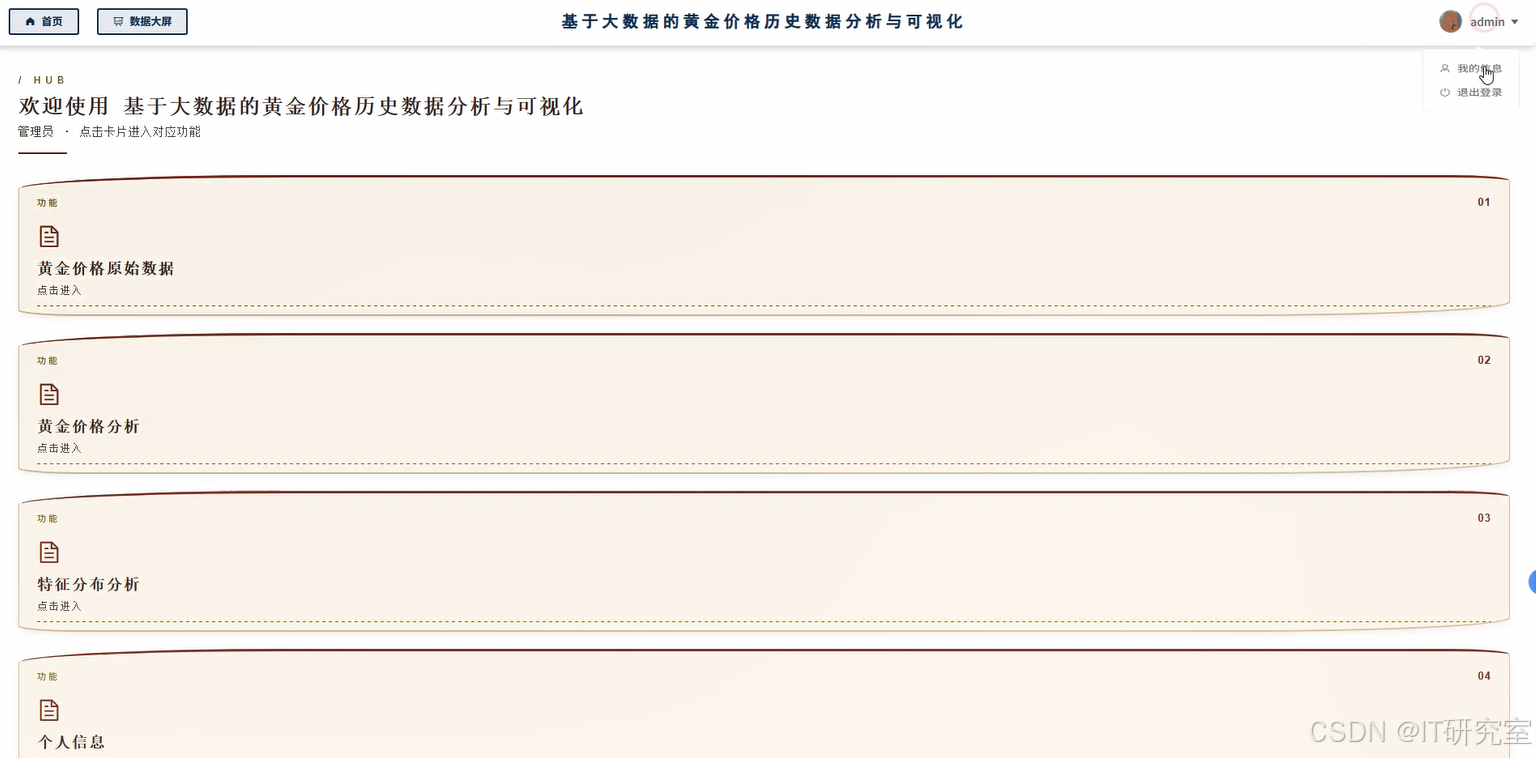
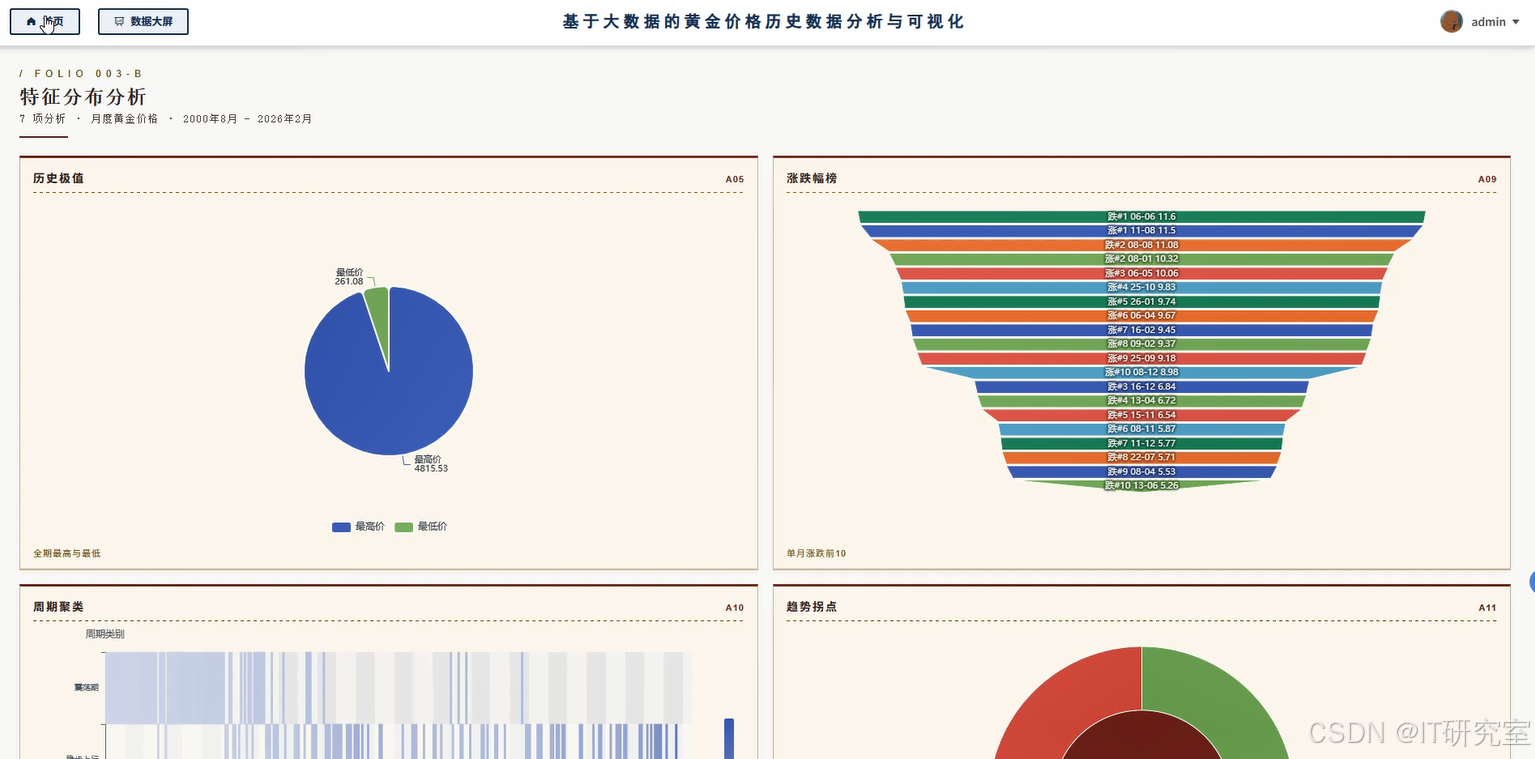
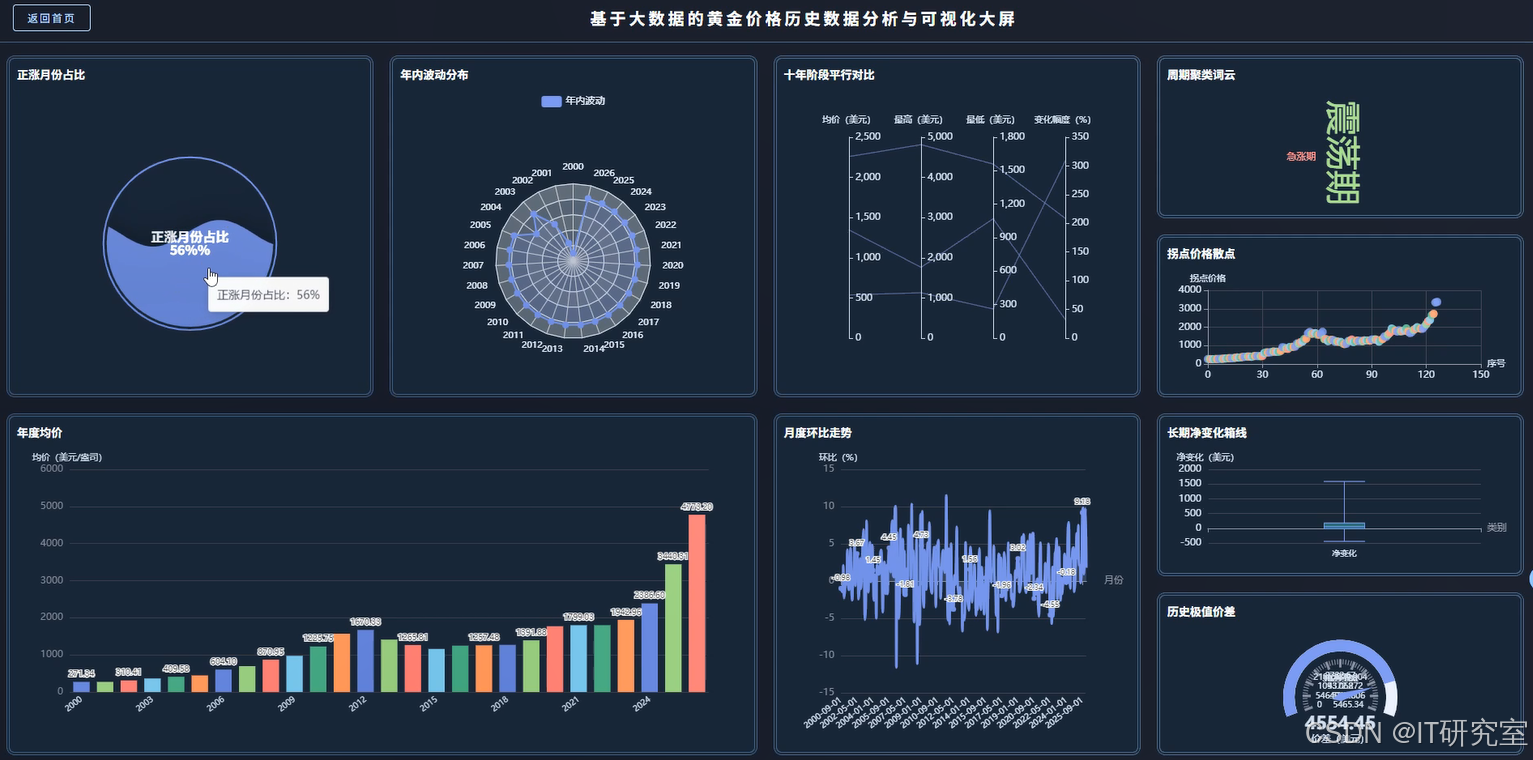
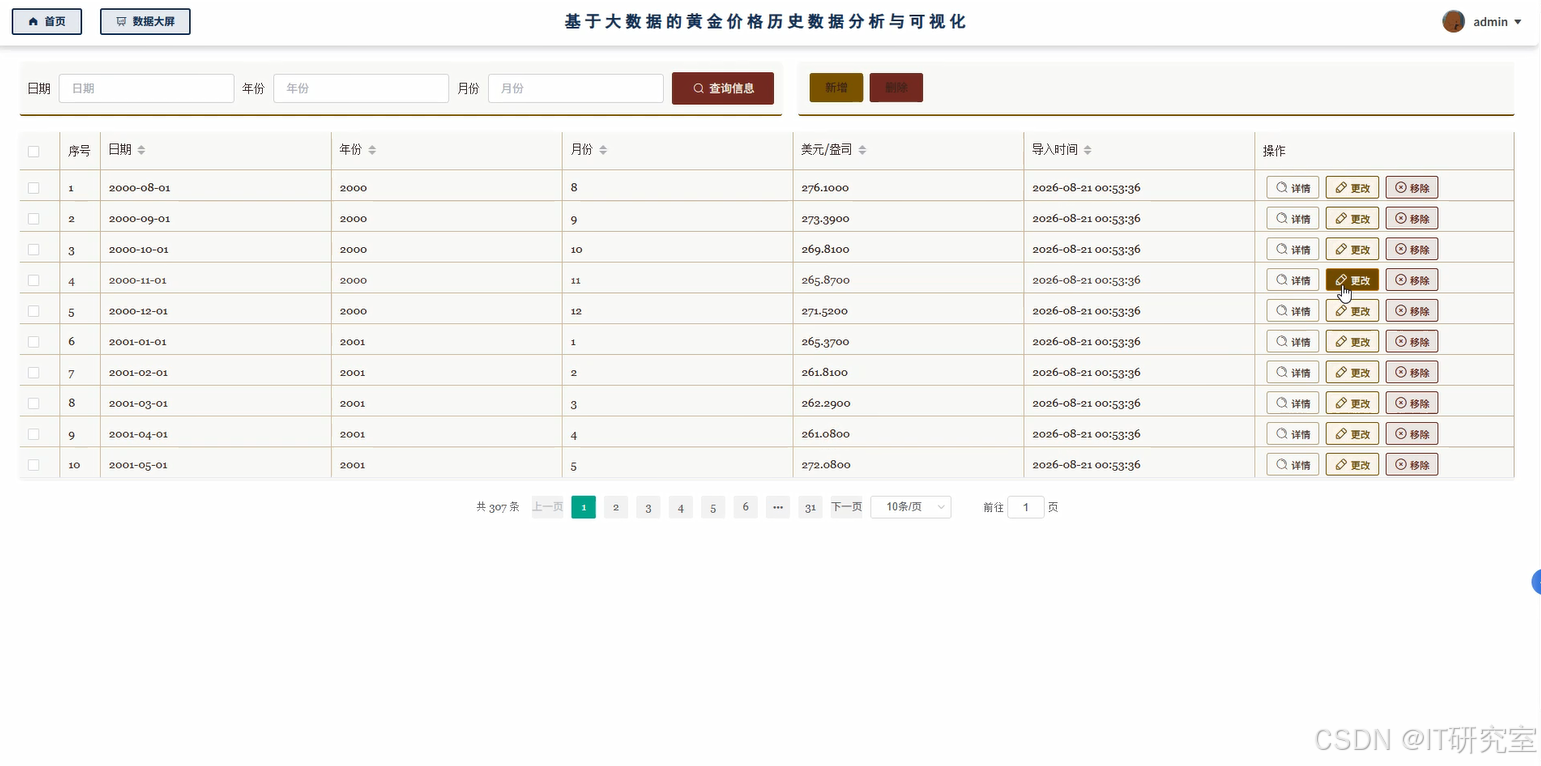
本系统《基于大数据的黄金价格历史数据分析与可视化》是一个面向计算机专业本科毕业设计的大数据应用项目,核心目标是对黄金价格历史数据进行高效的清洗、存储、分析与可视化展示。系统采用Hadoop分布式文件系统(HDFS)作为底层数据存储层,承载近五年的黄金价格历史数据集,利用Spark计算引擎和Spark SQL模块对海量数据进行快速聚合、统计与特征提取,Pandas与NumPy则辅助完成数据的二次加工与异常值处理。后端服务提供Python(Django)和Java(Spring Boot)双版本支持,前端采用Vue框架结合ElementUI组件库构建用户交互界面,Echarts负责渲染各类分析图表,jQuery与原生JavaScript辅助完成异步数据请求与DOM操作。系统功能模块涵盖黄金价格原始数据的表格化展示与条件检索、黄金价格的时间序列趋势分析与统计指标计算、价格特征分布的可视化呈现,以及用户个人信息维护。整个项目从数据采集、分层存储、分布式计算到前端展示形成完整闭环,旨在帮助学生深入理解大数据处理全流程,为毕业设计提供一份可运行、可演示、可扩展的实践成果。
选题背景
黄金作为一种具备商品属性和金融属性的特殊资产,其价格走势长期受到全球经济形势、货币政策、地缘政治风险以及市场供需关系等多重因素的综合影响。近二十年间,国际黄金价格经历了数轮明显的周期波动,积累了海量的历史交易数据。面对如此庞大规模的时间序列数据,传统的关系型数据库和单机分析工具在数据清洗、批量聚合和趋势挖掘方面逐渐暴露出性能瓶颈,处理效率难以满足日益增长的数据分析需求。与此同时,大数据技术生态日趋成熟,Hadoop的分布式文件系统和Spark的内存计算引擎为大规模历史数据的存储与快速分析提供了成熟的技术路径。将大数据处理方法引入黄金价格分析领域,能够更高效地从繁杂的历史记录中提取有价值的统计规律和价格分布特征。因此,设计并实现一个基于Hadoop和Spark的黄金价格历史数据分析与可视化系统,既契合当前大数据技术应用的发展趋势,也为本科阶段的毕设选题提供了一个兼具技术深度与实际数据支撑的实践方向。
选题意义
本课题的实践意义主要体现在三个层面。对学生个人而言,通过完整经历从数据采集、分布式存储、Spark SQL计算到前端可视化的全过程,能够将大数据课程中学到的HDFS、Spark等理论知识落地为可运行的软件系统,加深对分布式计算框架工作原理的理解,提升工程实践能力。对毕设教学环节而言,本课题提供了一个数据量真实、分析流程完整、技术路线清晰的项目范本,有助于指导教师更高效地帮助学生理解大数据项目的开发规范与实施节奏。从更实际的视角出发,黄金价格数据具有较强的可解释性,分析结果易于通过图表直观呈现,答辩展示时导师能够快速理解项目价值与工作量,降低了因选题方向模糊而导致延毕的风险。整体来看,本课题不求在算法层面做多么深入的创新,而是踏踏实实地将大数据处理技术应用于一个具体且有意义的数据分析场景中,做到技术选型合理、功能完整可用、展示效果直观。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
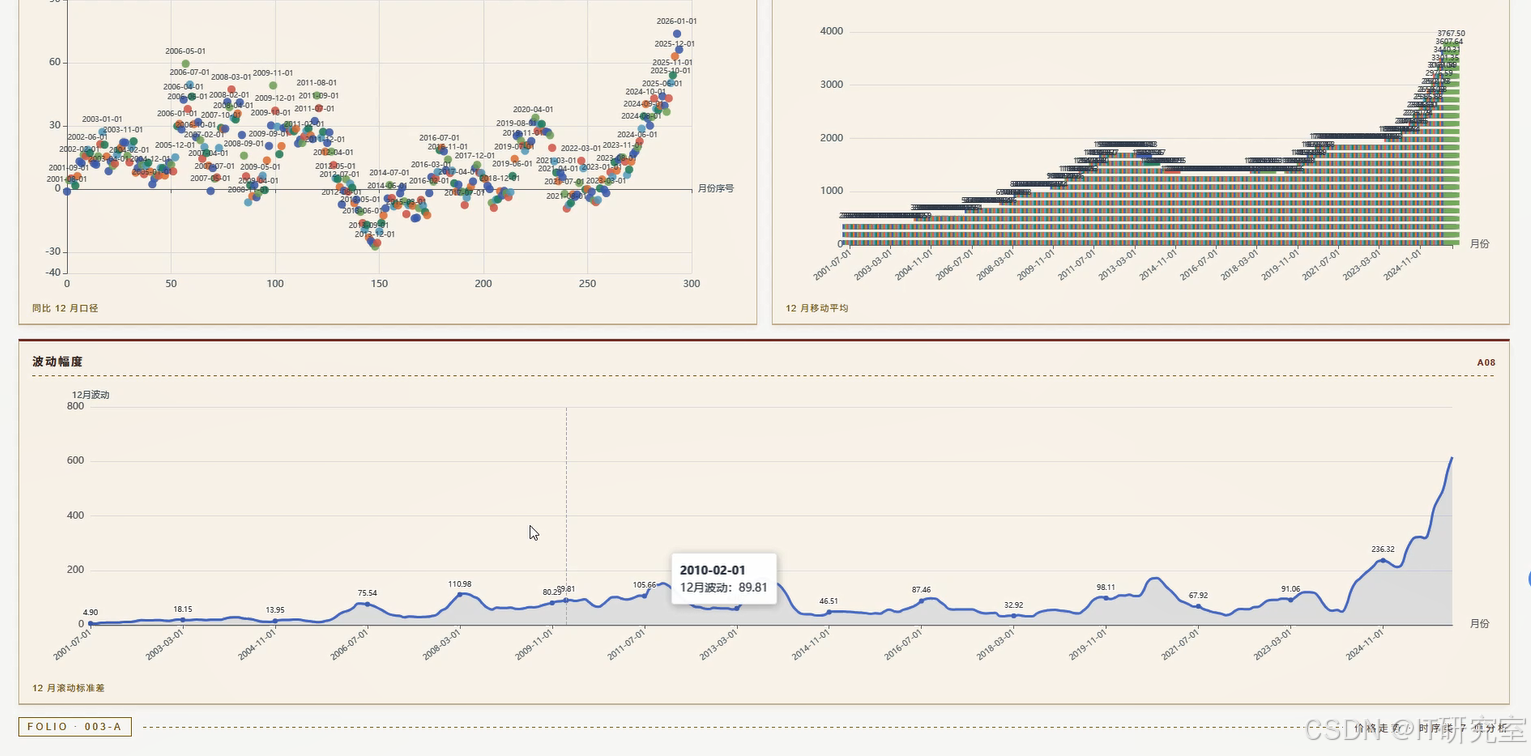
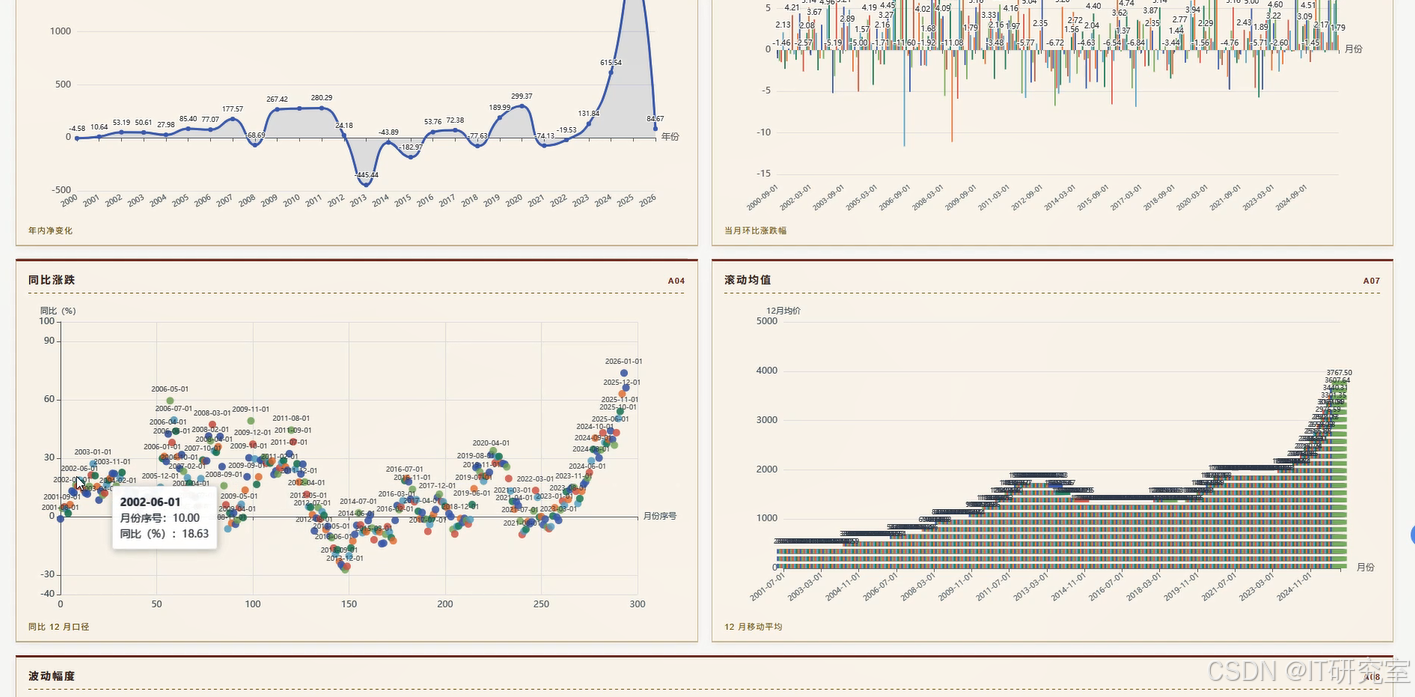
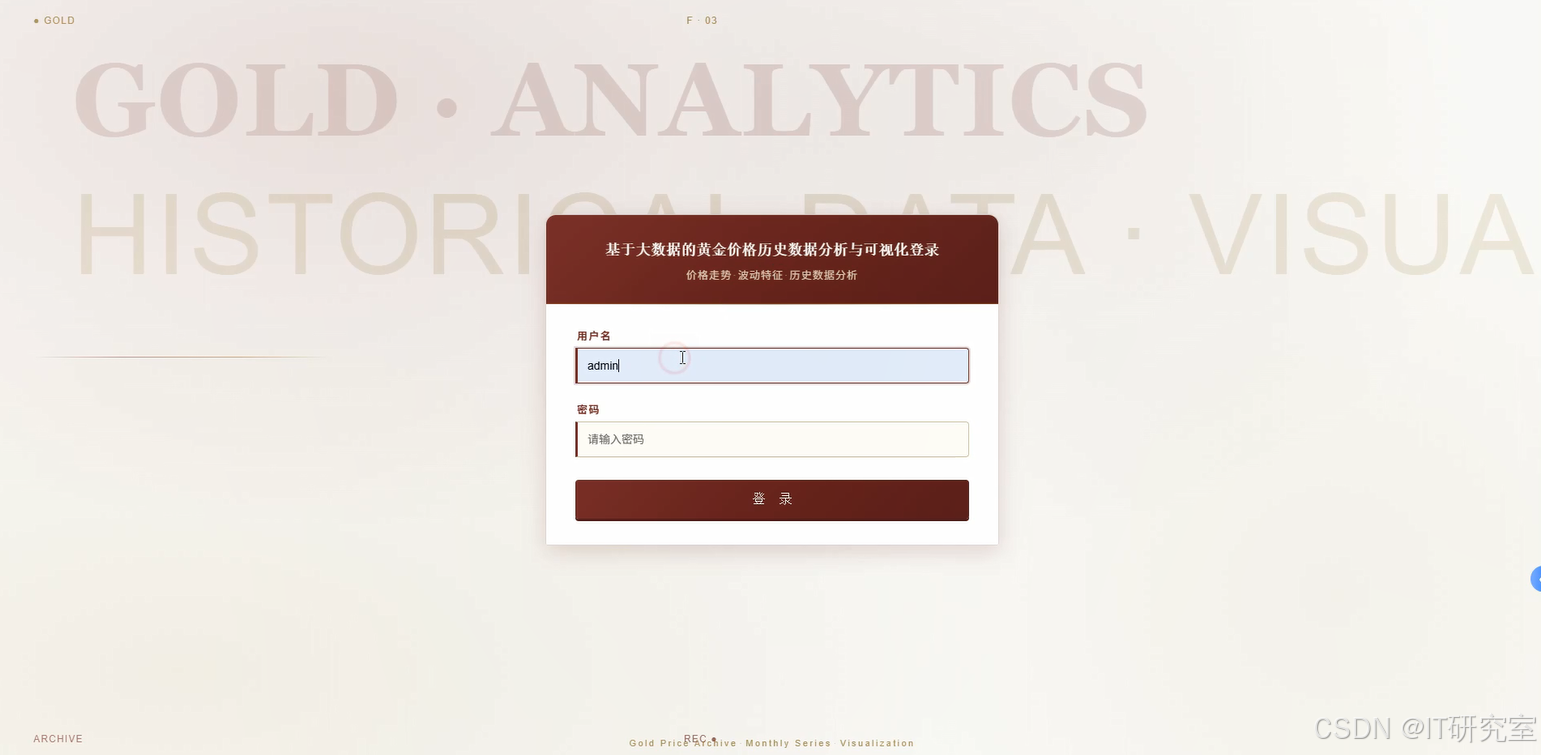
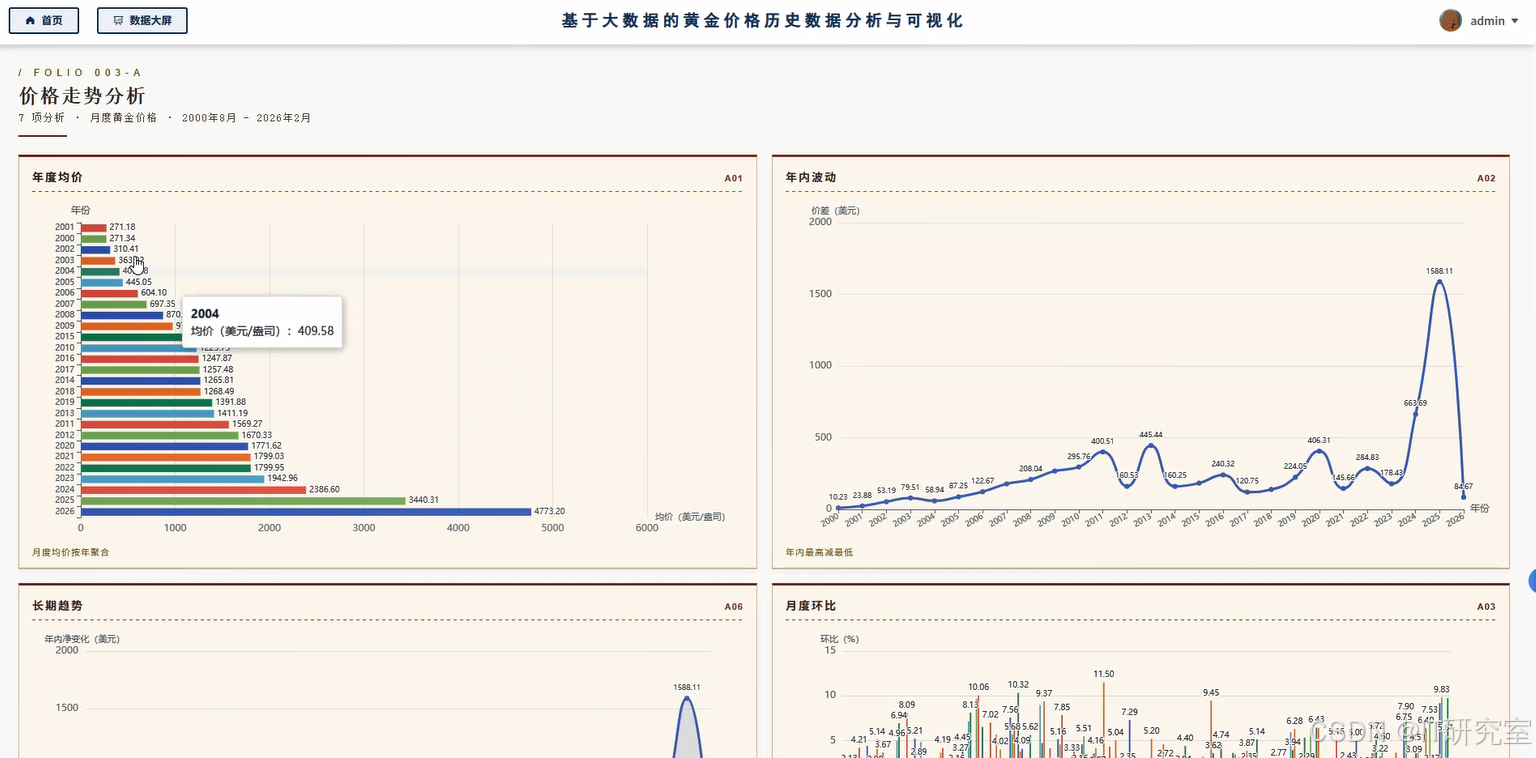
- 基于大数据的黄金价格历史数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, avg, stddev, max, min, count, year, month, sum, when, isnan, isnull
from pyspark.sql.types import DoubleType, StringType, StructType, StructField
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("GoldPriceAnalysis").config("spark.sql.adaptive.enabled", "true").getOrCreate()

# 核心功能一:黄金价格原始数据加载与表格展示(支持条件检索)
def load_gold_data_with_filters(start_date=None, end_date=None, price_min=None, price_max=None):
    hdfs_path = "hdfs://localhost:9000/gold_data/historical_prices.csv"
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df = df.withColumn("Date", col("Date").cast("date")).withColumn("Close", col("Close").cast(DoubleType()))
    if start_date:
        df = df.filter(col("Date") >= start_date)
    if end_date:
        df = filter(col("Date") <= end_date)
    if price_min:
        df = df.filter(col("Close") >= price_min)
    if price_max:
        df = df.filter(col("Close") <= price_max)
    df = df.withColumn("Year", year(col("Date"))).withColumn("Month", month(col("Date")))
    pandas_df = df.limit(1000).toPandas()
    total_count = df.count()
    return {"data": pandas_df.to_dict(orient="records"), "total": total_count}

# 核心功能二:黄金价格时间序列趋势分析与统计指标计算
def calculate_price_statistics_and_trend():
    hdfs_path = "hdfs://localhost:9000/gold_data/historical_prices.csv"
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df = df.withColumn("Close", col("Close").cast(DoubleType())).withColumn("Volume", col("Volume").cast(DoubleType()))
    stats = df.select(avg("Close").alias("avg_price"), stddev("Close").alias("std_price"), max("Close").alias("max_price"), min("Close").alias("min_price"), count("Close").alias("total_days")).collect()[0]
    df_year = df.withColumn("Year", year(col("Date"))).groupBy("Year").agg(avg("Close").alias("yearly_avg"), max("Close").alias("yearly_max"), min("Close").alias("yearly_min"), count("Close").alias("days_count")).orderBy("Year")
    df_month = df.withColumn("Month", month(col("Date"))).groupBy("Month").agg(avg("Close").alias("monthly_avg")).orderBy("Month")
    df_volatility = df.withColumn("Price_Change", col("Close") - col("Open")).select(avg("Price_Change").alias("avg_daily_change"), stddev("Price_Change").alias("volatility")).collect()[0]
    yearly_pandas = df_year.toPandas()
    monthly_pandas = df_month.toPandas()
    return {"avg_price": round(stats[0], 2), "std_price": round(stats[1], 2), "max_price": round(stats[2], 2), "min_price": round(stats[3], 2), "total_days": stats[4], "yearly_trend": yearly_pandas.to_dict(orient="records"), "monthly_avg": monthly_pandas.to_dict(orient="records"), "avg_daily_change": round(df_volatility[0], 4), "volatility": round(df_volatility[1], 4)}

# 核心功能三:黄金价格特征分布分析(价格区间分布与涨跌分布)
def analyze_price_distribution_and_fluctuation():
    hdfs_path = "hdfs://localhost:9000/gold_data/historical_prices.csv"
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df = df.withColumn("Close", col("Close").cast(DoubleType())).withColumn("Open", col("Open").cast(DoubleType()))
    df = df.withColumn("Price_Range", when(col("Close") < 300, "0-300").when((col("Close") >= 300) & (col("Close") < 600), "300-600").when((col("Close") >= 600) & (col("Close") < 900), "600-900").when((col("Close") >= 900) & (col("Close") < 1200), "900-1200").when((col("Close") >= 1200) & (col("Close") < 1500), "1200-1500").when((col("Close") >= 1500) & (col("Close") < 1800), "1500-1800").when(col("Close") >= 1800, "1800+").otherwise("unknown"))
    range_counts = df.groupBy("Price_Range").agg(count("Close").alias("frequency")).orderBy("Price_Range")
    df = df.withColumn("Daily_Change", col("Close") - col("Open")).withColumn("Change_Type", when(col("Daily_Change") > 0, "上涨").when(col("Daily_Change") < 0, "下跌").otherwise("持平"))
    change_counts = df.groupBy("Change_Type").agg(count("Close").alias("count"), avg("Daily_Change").alias("avg_change")).collect()
    top_volatility = df.withColumn("Change_Rate", abs((col("Close") - col("Open")) / col("Open") * 100)).orderBy(col("Change_Rate").desc()).select("Date", "Close", "Open", "Change_Rate").limit(10)
    range_pandas = range_counts.toPandas()
    change_dict = {row["Change_Type"]: {"count": row["count"], "avg_change": round(row["avg_change"], 4)} for row in change_counts}
    return {"price_distribution": range_pandas.to_dict(orient="records"), "change_statistics": change_dict, "top_volatility_days": top_volatility.toPandas().to_dict(orient="records")}
五、系统视频
基于大数据的黄金价格历史数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的黄金价格历史数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇