同一份机组数据进平台后,往往会被提出几种完全不同的要求:运维看板要立即拿到当前值,工程师要回看故障前后的明细,报表要按小时汇总多个设备,数仓还要扫描更长时间范围的数据。只测连续写入和单点查询,很难回答这些需求能不能同时满足。
从大数据平台角度做选型,时序库不只是一个写入端点。它要承接在线查询,也要和历史分析、保留策略、消息接入及运维流程配合。更实用的做法,是先列出真实查询,再检查数据从哪里进、在哪里留、由谁计算。以下用 Apache IoTDB 2.0.x 的树模型 SQL 和 Spark 连接器整理一条可复现的评估路径;代码是 PoC 样例,不包含未经测量的性能结论。
先把时序库放进数据链路
拿风电场举例,业务侧通常有三个数据入口。第一类是在线服务查询:看板取某台设备的最新状态,告警服务检查最近几分钟的温度和功率。第二类是 Spark 直接读取 IoTDB 中的在线数据,适合有明确时间范围的分析任务。第三类是 Spark 读取已有的 TsFile 文件,文件可以位于本地文件系统或 HDFS,适合对归档数据做批处理。IoTDB 用户手册分别提供了 Spark-IoTDB 连接器、TsFile-Spark 连接器和 Hive-TsFile 连接器的用法。
这几条路径的输入对象不同:Spark-IoTDB 连接器从数据库读数据,TsFile-Spark 连接器从已有的 TsFile 文件或目录读数据。若方案要求把在线数据持续沉淀到 HDFS,还要把"文件由哪一段任务生成、失败后如何补齐、保留多久"写进架构和验收项,不能只在图上画一个箭头。
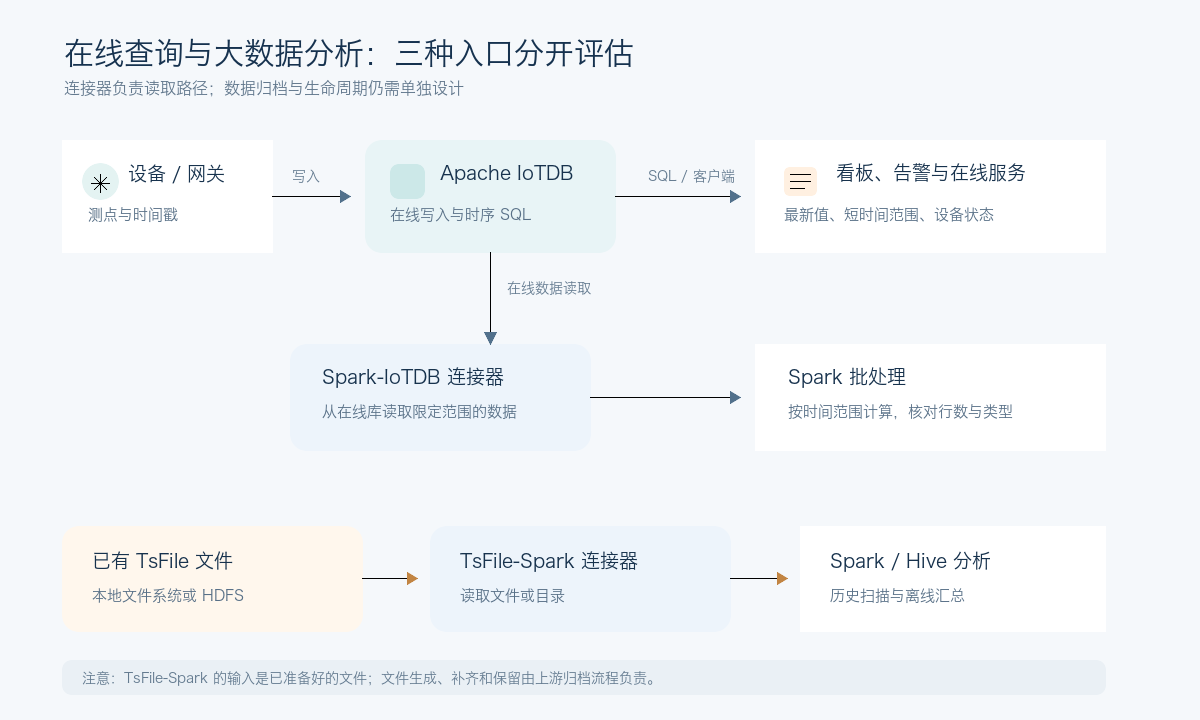
架构评审时,在线服务与离线作业最好分开列资源和责任边界。实时看板的时间窗口通常短,离线任务可能扫描多天或跨设备聚合;即使它们都能返回 DataFrame,也不代表可以不加限制地并发执行。对 PoC 来说,记录每类任务的时间范围、并发数、返回行数和资源占用,比只保留一张总 QPS 表更容易解释结果。
先写查询清单,再决定怎么建模
业务描述里的"看趋势""查故障""算利用率"需要变成能运行的 SQL。至少把最近值、时间范围明细、时间窗口聚合和多设备查询分开。每一类都要标明设备数量、测点数量、时间跨度、并发数,以及查询结果是否需要按设备区分。
IoTDB 2.0.x 的用户手册说明了树模型与表模型两种建模方式。树模型可以把组织、场站、设备和测点放进路径;表模型适合团队习惯按关系表组织数据时评估。两种模式应结合现有数据目录、写入程序和 SQL 习惯做 PoC。以下示例只使用树模型,建模语义可查阅官方建模方案说明。
先启动树模型会话,再建立两个同层级设备。示例的时间戳按毫秒精度书写;实际评估前需核对目标集群的时间精度和时区设置。
sql
-- 创建数据库
CREATE DATABASE root.energy;

-- 建立对齐时间序列:同一设备在相同时间点上报多个测点
CREATE ALIGNED TIMESERIES root.energy.wind.farm01.turbine01 (
  temperature FLOAT,
  power FLOAT,
  status BOOLEAN
);

CREATE ALIGNED TIMESERIES root.energy.wind.farm01.turbine02 (
  temperature FLOAT,
  power FLOAT,
  status BOOLEAN
);

SHOW TIMESERIES root.energy.**;
初始化数据也要覆盖后续查询。下面放入两台机组、各四个时间点,后面的多设备聚合就会实际扫到两个设备,而不是只验证 SQL 能否解析。
sql
INSERT INTO root.energy.wind.farm01.turbine01
  (timestamp, temperature, power, status)
VALUES
  (1790812800000, 24.1, 480.0, true),
  (1790813100000, 24.5, 476.8, true),
  (1790813400000, 24.8, 0.0, false),
  (1790813700000, 24.4, 0.0, false);

INSERT INTO root.energy.wind.farm01.turbine02
  (timestamp, temperature, power, status)
VALUES
  (1790812800000, 23.8, 465.2, true),
  (1790813100000, 24.0, 461.7, true),
  (1790813400000, 24.2, 458.1, true),
  (1790813700000, 24.6, 452.9, true);
这组数据只是便于阅读和复现查询的微型样本,不适合拿来评价写入吞吐、压缩率或并发能力。正式 PoC 应换成脱敏后的业务数据,并保留真实的缺测、补写、设备数量和测点类型分布。
四种 SQL 对应四类使用压力
看板常先问"最后一次状态是什么"。IoTDB 的快速 SQL 指南给出了 LAST 查询示例。选型清单里可以保留一条单设备最新值查询,再增加多测点或多设备版本,观察客户端如何处理返回结果。
sql
SELECT LAST status
FROM root.energy.wind.farm01.turbine01;
故障回溯更关心指定时间段里的明细。PoC 应把时间条件固定下来,避免每轮使用不同的数据范围;还应记录返回行数和客户端拉取完整结果所需的时间。
sql
SELECT temperature, power, status
FROM root.energy.wind.farm01.turbine01
WHERE time >= 1790812800000 AND time < 1790816400000;
报表通常要把高频点聚合成较粗的时间粒度。IoTDB SQL 手册中的 GROUP BY 时间窗口用法,可以覆盖这类评估。窗口大小要按业务报表设定,不要只挑对候选系统有利的一种粒度。
sql
SELECT AVG(power), MAX_VALUE(temperature)
FROM root.energy.wind.farm01.turbine01
GROUP BY ([1790812800000, 1790816400000), 10m);
需要把多个设备放在同一个结果里时,可以用路径通配符匹配同一场站下的设备,再按设备对齐结果。这里的 turbine01 和 turbine02 都在样例数据中,因此查询能覆盖两个设备。
sql
SELECT AVG(power)
FROM root.energy.wind.farm01.*
GROUP BY ([1790812800000, 1790816400000), 10m)
ALIGN BY DEVICE;
四条 SQL 对应的负载并不相同:LAST 偏向快速返回当前状态;时间过滤需要读出一个设备的一段历史;窗口聚合会计算区间结果;ALIGN BY DEVICE 则把同类设备放进一次查询。把这些语句连同输入范围放在 PoC 仓库里,后续版本升级或更换连接器时也能重复执行。SQL 方言、路径模式和函数细节以目标版本的快速 SQL 指南及SQL 手册为准。
写入压测也要统一计数口径。上面的单条 INSERT 请求一次写入了多个时间点,每个时间点又包含多个测点。记录"每秒写入量"时,应同时写明统计的是请求数、时间点行数,还是测点值数量,并固定批次大小。否则一个系统按请求计数,另一个系统按测点计数,表格里的数字就不在同一口径上。测试集还应保留真实的补写和乱序比例;只有整齐递增的时间戳,无法代表所有采集程序的行为。
可以用区间计数核对指定测点有没有读到数据,但它只给出非空值数量,不保证每个预期时间戳都存在。采样周期固定时,再从客户端导出时间戳核对缺口,才能检查连续性。
sql
SELECT COUNT(power)
FROM root.energy.wind.farm01.turbine01
WHERE time >= 1790812800000 AND time < 1790816400000;
PoC 结束后若要重置这组样例数据,可在隔离数据库中按时间范围删除;这条语句不应直接用于生产数据清理。
sql
DELETE FROM root.energy.wind.farm01.turbine01
WHERE time >= 1790812800000 AND time < 1790816400000;
保留策略要和归档方案分开验收
保留多少天通常由在线查询和业务合规共同决定。树模型中可以对路径配置 TTL,以下示例把 root.energy 下的数据保留期设为 30 天:
sql
-- 仅在隔离的 PoC 数据库中演示
SET TTL TO root.energy.** 2592000000;
SHOW TTL ON root.energy.**;
TTL 的单位是毫秒,判断数据是否过期依据的是数据点时间,不是写入时间。达到 TTL 的数据不可查询,但物理删除可能延迟到压缩阶段;缩短或取消 TTL 也可能改变之前数据的可见性。相关规则见数据保留时间文档。所以验收时至少记录三项:查询何时不再返回过期点、磁盘占用何时下降、TTL 修改后历史数据的可见性如何变化。生产路径上不要直接粘贴 PoC 的 TTL 语句。
冷数据保留期可能长于在线数据库的服务周期。若归档方案使用 TsFile,应单独检查文件生成、目录组织、元数据、校验和恢复流程。Spark 的 TsFile 连接器可以从本地文件系统或 HDFS 读取 TsFile;这个能力解决的是计算引擎怎样读取文件,不能替代上游归档任务的设计。
用 Spark 验证下游接口
如果离线任务要直接查询在线库,可以依据官方连接器文档把 IoTDB SQL 读成 Spark DataFrame。示例给查询加了起止时间,并通过 lowerBound、upperBound 和 numPartition 控制读取范围和分区参数。账号从环境变量读取,生产口令不应写进 Notebook 或脚本。
scala
import org.apache.iotdb.spark.db._

val start = "1790812800000"
val end   = "1790816400000"

val df = spark.read
  .format("org.apache.iotdb.spark.db")
  .option("user", sys.env("IOTDB_USER"))
  .option("password", sys.env("IOTDB_PASSWORD"))
  .option("url", "jdbc:iotdb://127.0.0.1:6667/")
  .option("sql", s"select temperature, power from root.energy.wind.farm01.** where time >= $start and time < $end")
  .option("lowerBound", start)
  .option("upperBound", end)
  .option("numPartition", "4")
  .load()

df.printSchema()
df.show(20, truncate = false)
Spark 作业读取数据库时,连接器版本要与 IoTDB、Spark、Scala 版本对应。评估时别把全库扫描当成第一条验证语句;先限定设备路径和时间范围,再逐步增加跨度与并发。比较结果时,除了耗时,还要对照两边返回的行数、时间戳和数据类型。
如果分析对象已经是 HDFS 上的 TsFile,入口则是 TsFile-Spark 连接器:
scala
import org.apache.iotdb.spark.tsfile._

val archived = spark.read.tsfile(
  "hdfs://nameservice1/warehouse/energy/tsfile/2026/10"
)

archived.printSchema()
archived.show(20, truncate = false)
这两种读取方式适合不同阶段的数据。在线库连接器适合按范围读取当前服务数据;TsFile 连接器适合处理已准备好的文件。PoC 要确认它们各自的输入路径、Schema、时间精度和错误恢复方式,不要把"Spark 能读"直接等同于整套归档链路已经完成。
下游读取还要检查资源争用。先在没有 Spark 作业时记录一组在线查询的基线,再启动一条有代表性的 Spark 任务,同时重复同一批在线 SQL。两个阶段要使用同样的数据范围和并发参数,并记录 CPU、内存、磁盘读写以及查询延迟变化。如果离线作业会在失败后重试或补算,也应把重试时的资源占用纳入验证。这样能判断"连得上"之后,在线服务和离线计算是否还能按各自 SLA 工作。
PoC 结果表里该留下什么
只贴一条吞吐数字,团队很难用它推演上线后的查询和存储。每次测试都应注明 IoTDB、连接器、Spark、JDK 的版本,硬件和磁盘类型,数据量、设备数、测点数、时间范围及并发配置。跑分时固定数据集和 SQL;如果一轮用了冷缓存、另一轮用了热缓存,应在记录中分开。
| 验证面 | PoC 输入 | 需要保存的结果 |
|---|---|---|
| 写入 | 峰值写入、突发写入、历史补写 | 成功率、积压变化、恢复到稳态所需时间 |
| 在线查询 | 最新值、时间范围、窗口聚合、多设备查询 | P50/P95/P99、返回行数、并发下的错误数 |
| 存储 | 实际测点类型、采样周期、保留规则 | 磁盘增长、压缩后占用、TTL 可见性与清理延迟 |
| 大数据接口 | Spark-IoTDB 与 TsFile 文件读取 | Schema、时间精度、结果核对、作业资源占用 |
| 运维恢复 | 重启、短时断连、连接器重试 | 失败表现、数据缺口、恢复后结果是否一致 |
表里的通过阈值应来自业务 SLA、容量预算和运维窗口,不存在适用于所有项目的统一 QPS 或压缩比。集群方案还要在目标部署形态下验证节点恢复、扩容和客户端重连,不能用单机 PoC 的结果代替集群验收。
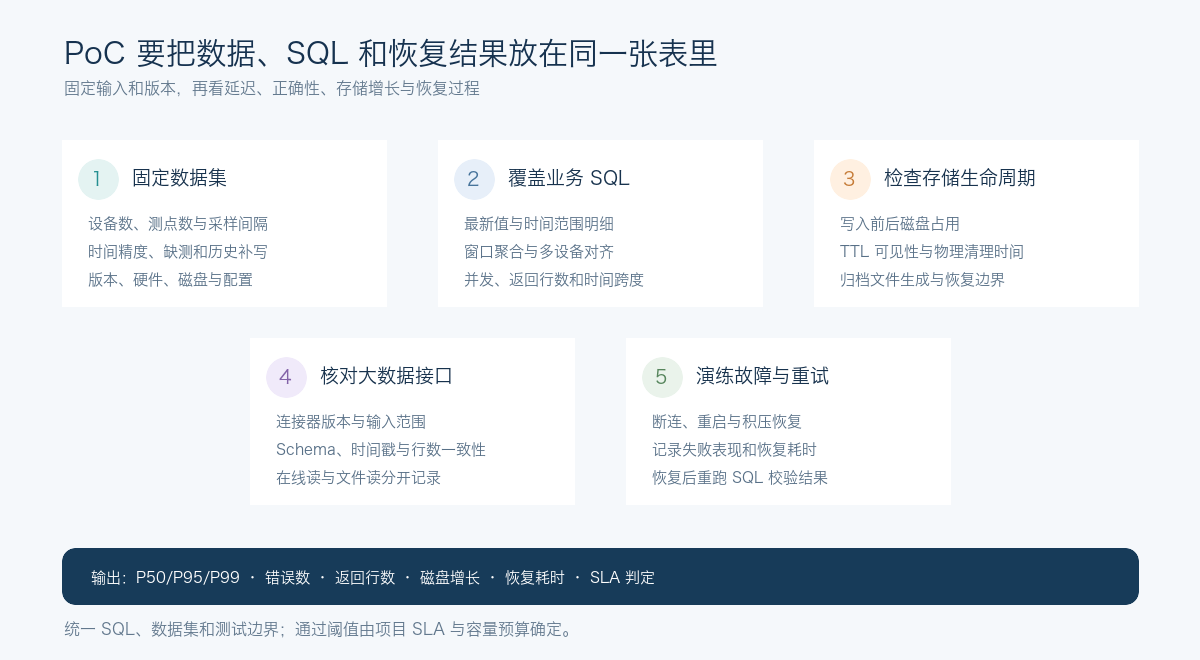
这张清单不是评分模板,缺少的阈值应由项目团队补上。比如业务明确要求故障后五分钟内恢复,就把"恢复完成"的判定条件写成可查询的数据一致性检查,而不是只记录服务进程重新启动。离线作业如果不能影响在线告警,也要把并发时的在线查询延迟放进同一轮验证。
选型结论最终应落在可复现的 SQL、数据集、保留规则和连接器版本上。Apache IoTDB 的开源版本可从下载链接(Apache IoTDB 下载页)获取;企业版官网 Timecho提供企业版信息入口。涉及 SLA、部署支持和商业服务范围时,按具体版本与业务要求核对官方材料,再把确认过的条件补进 PoC 验收表。