回顾:过拟合是怎么来的?
模型容量太大,把训练数据的误差也学习下来了。
比如拟合房价:
欠拟合:一条直线,连训练数据都对不上(容量太小)
刚好:二次曲线,贴合大部分真实规律
过拟合:七次多项式,训练点全穿过,但曲线疯狂抖动(容量太大)
同样效果,过拟合体现在两个指标差很远:
训练准确率 → 99%(背下答案)
测试准确率 → 60%(考试就露馅)
验证准确率远低于训练准确率,就是过拟合的铁证。
治它的思路有两条路:
| 方法 | 思路 | 代表方法 |
|---|---|---|
| 增大数据量 | 让模型见更多样本,不敢乱记 | 数据增强、收集更多数据 |
| 限制模型/参数 | 让模型"不敢太嚣张" | 权重衰减、Dropout |
今天就讲第二条路里的两大主角。
第一部分:权重衰减(Weight Decay)
1.1 为什么权重越小越好?
为什么限制权重大小能防过拟合?
- 一个简单的模型,像一个"答卷工整、要点清晰"的学生,他能把规律总结得简洁,不靠死记硬背。
- 一个过拟合 的模型,像一个"把每一个错别字、每一条口误都背下来"的学生,他要记的东西特别多,每个特征的系数都被他调得又大又碎,去精确贴合那些噪音。
要让学生学的不要那么多,办法就是:在损失函数里加一条"惩罚"------你的权重越大,我罚得越狠。
这样模型为了降低总损失,就会倾向把权重压小,从而学得"简单"一些。
1.2 数学定义
普通损失函数(比如均方误差):
L(w,b)=1n∑i=1n12(yi−(w⊤xi+b))2 L(\mathbf{w}, b) = \frac{1}{n}\sum_{i=1}^{n} \frac{1}{2}\left( y_i - \left(\mathbf{w}^\top \mathbf{x}_i + b\right)\right)^2 L(w,b)=n1i=1∑n21(yi−(w⊤xi+b))2
加正则化后,在损失上加一个"权重的平方和":
Lreg=L(w,b)+λ2∥w∥2⏟新增惩罚项 L_{\text{reg}} = L(\mathbf{w}, b) + \underbrace{\frac{\lambda}{2}\|\mathbf{w}\|^2}_{\text{新增惩罚项}} Lreg=L(w,b)+新增惩罚项 2λ∥w∥2
其中:
- ∥w∥2\|\mathbf{w}\|^2∥w∥2 = ∑jwj2\sum_j w_j^2∑jwj2,所有权重的平方和
- λ\lambdaλ(lambda)是超参数,控制惩罚
- 12\frac{1}{2}21 是为了求导时把 2 消掉
为什么罚"权重"不罚"偏置 b"?
因为偏置 b 不参与对特征的敏感性调节,它只是一个平移量。惩罚它没有任何意义,所以正则化项只惩罚权重 w。
1.3 求导看真相:梯度下降时权重被"拉小"
对正则化项求梯度,你就明白为什么叫"权重衰减"了:
∂∂wj(λ2∥w∥2)=λwj \frac{\partial}{\partial w_j} \left(\frac{\lambda}{2}\|\mathbf{w}\|^2\right) = \lambda w_j ∂wj∂(2λ∥w∥2)=λwj
把这条加进普通的梯度下降更新公式里(不考虑 batch 平均系数):
wj←wj−η∂L∂wj−ηλwj w_j \leftarrow w_j - \eta \frac{\partial L}{\partial w_j} - \eta \lambda w_j wj←wj−η∂wj∂L−ηλwj
把最后两项合并:
wj←(1−ηλ)⏟<1wj−η∂L∂wj w_j \leftarrow \underbrace{(1 - \eta\lambda)}_{<1} w_j - \eta \frac{\partial L}{\partial w_j} wj←<1 (1−ηλ)wj−η∂wj∂L
因为 ηλ\eta\lambdaηλ 大于 0,所以 (1−ηλ)<1(1-\eta\lambda) < 1(1−ηλ)<1,权重被往小了压。
这就是"衰减"二字的由来------像弹簧自动回缩一样,每轮更新都把 w 拉回去一点。
1.4 手写权重衰减
从零实现的关键就是在更新梯度时额外减去 λw\lambda wλw。
python
import torch

def l2_penalty(w):
    """计算 L2 正则化项:所有权重的平方和"""
    return torch.sum(w.pow(2)) / 2   # 乘 1/2 纯粹为了求导好看

def sgd_with_weight_decay(params, lr, batch_size, lmbd):
    """带权重衰减的随机梯度下降"""
    with torch.no_grad():
        for param in params:
            # 关键:梯度里额外加上 lambda * w
            param -= lr * (param.grad + lmbd * param) / batch_size
            param.grad.zero_()

# 假设已经有 net、trainer 等
for X, y in train_iter:
    # 计算损失
    l = loss(net(X), y) + lmbd * l2_penalty(net.weight)  # 损失里加正则项
    l.sum().backward()
    sgd_with_weight_decay([net.weight, net.bias], lr, batch_size, lmbd)
1.5 PyTorch 一行搞定
实际工程中,不会手写正则化。我们使用**weight_decay** 参数:
python
trainer = torch.optim.SGD(net.parameters(), lr=0.03, weight_decay=0.01)weight_decay=0.01 就相当于 λ=0.01\lambda = 0.01λ=0.01。一行,搞定。
⚠️ 注意:
weight_decay默认会对所有 进优化器的参数做 L2 惩罚(包括偏置,虽然理论上偏置不用罚)。想要更精细控制可以用param_groups,但对大多数场景,默认就够用。
1.6 完整实验代码
用一个真正简单的函数 y=0.05+∑i=1p0.01xi+ϵy = 0.05 + \sum_{i=1}^{p} 0.01x_i + \epsilony=0.05+∑i=1p0.01xi+ϵ 生成数据,但给模型的特征维度 p 设得很大(比如 200),样本却很少(比如 20 个)。
特征多 + 样本少 = 经典过拟合。
python
import torch
import torch.nn as nn
from torch.utils import data

# ---------- 1. 过拟合场景:特征 200 维,训练样本仅 20 个 ----------
n_train, n_test, num_inputs = 20, 100, 200
true_w, true_b = torch.ones((num_inputs, 1)) * 0.01, 0.05

def synthetic(w, b, n):
    X = torch.normal(0, 1, (n, num_inputs))
    return X, X @ w + b

features, labels       = synthetic(true_w, true_b, n_train)
test_features, test_labels = synthetic(true_w, true_b, n_test)
train_iter = data.DataLoader(data.TensorDataset(features, labels), batch_size=5, shuffle=True)

loss = nn.MSELoss(reduction='none')

def train(lmbd):
    net = nn.Linear(num_inputs, 1)
    # 关键就在 weight_decay 参数:等价于在损失里加 lambda/2 * ||w||^2
    trainer = torch.optim.SGD(net.parameters(), lr=0.003, weight_decay=lmbd)
    for epoch in range(100):
        for X, y in train_iter:
            l = loss(net(X), y.reshape(-1, 1)).sum()
            trainer.zero_grad()
            l.backward()
            trainer.step()
    return net

def test_err(net):
    with torch.no_grad():
        return ((net(test_features).reshape(-1) - test_labels.reshape(-1))**2).mean().item()

def evaluate(net, data_feat, data_labels):
    with torch.no_grad():
        return ((net(data_feat).reshape(-1) - data_labels.reshape(-1))**2).mean().item()

net_plain = train(lmbd=0)        # 关权重衰减
net_wd    = train(lmbd=100)     # 开权重衰减

train_err_plain = evaluate(net_plain, features, labels)
train_err_wd    = evaluate(net_wd, features, labels)

print('关闭 weight_decay 训练误差:', train_err_plain, '测试误差:', test_err(net_plain))
print('开启 weight_decay 训练误差:', train_err_wd, '测试误差:', test_err(net_wd))
模型就是一个线性模型 nn.Linear(num_inputs, 1)。训练后看训练误差 vs 测试误差。
不加 weight_decay 时 → 训练误差极小,但测试误差很大(过拟合)。
加 weight_decay=0.01 时 → 训练误差略微上升,但测试误差明显下降 (泛化变好)。

第二部分:Dropout
2.1 Dropout的思路
前面权重衰减是"限制权重大小"。Dropout 的角度完全不同------随机让一些神经元在训练时"罢工"。
- 一个团队做方案,如果每次全靠某一个人(一个神经元),出问题时团队就崩了。如果做一个项目,就好比大学生组队做期末项目人数有六人,但真正出力的只有那么两三个人,其他的人都摆烂,没有充分利用到那些学生。
- Dropout 的做法是:每次训练随机"请假"掉一部分人,逼团队里的每个人都得学会独当一面。
这样模型就不会"过度依赖某一个(或某几个)特征/神经元",从而减少对训练数据特定模式的记忆,泛化更强。
Dropout = 随机丢弃部分神经元,逼剩下的学习更鲁棒的特征。
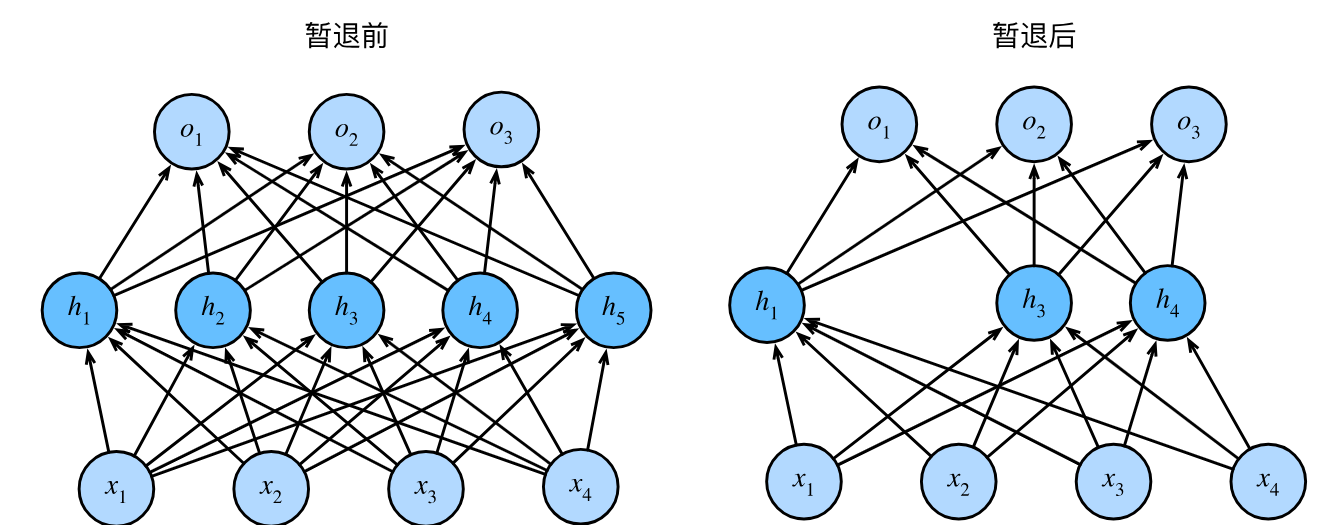
2.2 数学定义:随机丢弃
设隐藏层某个神经元的输出为 hhh,激活函数为 σ\sigmaσ:
h′=σ(x) h' = \sigma(x) h′=σ(x)
引入一个 伯努利随机变量 d∼Bernoulli(1−p)d \sim \text{Bernoulli}(1-p)d∼Bernoulli(1−p):
- 以概率 1−p1-p1−p:d=1d = 1d=1,神经元全部保留
- 以概率 ppp:d=0d = 0d=0,神经元全部丢弃(输出置 0)
h′={h1−pif d=10otherwise h' = \begin{cases} \dfrac{h}{1-p} & \text{if } d = 1\\ 0 & \text{otherwise} \end{cases} h′=⎩ ⎨ ⎧1−ph0if d=1otherwise
重点在训练时除以 (1−p)(1-p)(1−p),这保证了期望不变:
Eh′=(1−p)⋅h1−p+p⋅0=h Eh' = (1-p)\cdot\frac{h}{1-p} + p\cdot0 = h Eh′=(1−p)⋅1−ph+p⋅0=h
期望不变,意味着"整体输出水平"在训练时没有被扭曲。
2.3 训练 vs 预测(一定要分清!)
这是新手最容易踩坑的地方:
| 阶段 | 是否开 Dropout | 原因 |
|---|---|---|
| 训练 | 开 | 随机丢弃,防止过拟合 |
| 预测/推理 | 关 | 需要用到全部神经元做出最稳定判断 |
PyTorch 里:
net.train()→ Dropout 生效net.eval()→ Dropout 关闭(退化为恒等)
2.4 从零手写 Dropout
python
import torch

def dropout_layer(X, dropout):
    """dropout=1 表示全部丢弃;dropout=0 表示不丢弃"""
    assert 0 <= dropout <= 1
    if dropout == 1:
        return torch.zeros_like(X)
    if dropout == 0:
        return X
    mask = (torch.rand(X.shape) > dropout).float()   # 随机生成 0/1 mask
    return mask * X / (1.0 - dropout)                # 丢弃并缩放
2.5 简洁实现:nn.Dropout
python
from torch import nn

dropout1, dropout2 = 0.2, 0.5   # 两层各自的丢弃率

net = nn.Sequential(
    nn.Flatten(),
    nn.Linear(784, 256), nn.ReLU(),
    nn.Dropout(dropout1),       # 第一层后 Dropout 0.2
    nn.Linear(256, 256), nn.ReLU(),
    nn.Dropout(dropout2),       # 第二层后 Dropout 0.5
    nn.Linear(256, 10)
)经验:Dropout 一般放在激活函数(ReLU)之后。越靠近输出的层,特征越抽象,可以给更高丢弃率(如上面前层 0.2、后层 0.5)。
2.6 完整实验:Dropout 效果
在 Fashion-MNIST 上用 MLP + Dropout,看训练/测试准确率差距:
python
import torch
import torchvision
from torch import nn
from torch.utils.data import DataLoader

# 数据
batch_size = 256
transform = torchvision.transforms.ToTensor()
train_ds = torchvision.datasets.FashionMNIST(root='./data', train=True, download=True, transform=transform)
test_ds  = torchvision.datasets.FashionMNIST(root='./data', train=False, download=True, transform=transform)
train_iter = DataLoader(train_ds, batch_size, shuffle=True)
test_iter  = DataLoader(test_ds, batch_size)

net = nn.Sequential(
    nn.Flatten(),
    nn.Linear(784, 256), nn.ReLU(), nn.Dropout(0.2),
    nn.Linear(256, 256), nn.ReLU(), nn.Dropout(0.5),
    nn.Linear(256, 10)
)

loss = nn.CrossEntropyLoss()
trainer = torch.optim.SGD(net.parameters(), lr=0.1)

num_epochs = 10
for epoch in range(num_epochs):
    net.train()                      # 训练模式:开 Dropout
    train_loss, correct, total = 0., 0, 0
    for X, y in train_iter:
        trainer.zero_grad()
        l = loss(net(X), y)
        l.backward()
        trainer.step()
        correct += (net(X).argmax(1) == y).sum().item()
        total += y.numel()
    net.eval()                       # 评估模式:关 Dropout
    test_correct = test_total = 0
    with torch.no_grad():
        for X, y in test_iter:
            test_correct += (net(X).argmax(1) == y).sum().item()
            test_total += y.numel()
    print(f'epoch {epoch+1}, train acc {correct/total:.4f}, test acc {test_correct/test_total:.4f}')
3 权重衰减 vs Dropout:怎么选?
| 维度 | 权重衰减 (L2) | Dropout |
|---|---|---|
| 核心思想 | 惩罚大权重,压小参数 | 随机丢弃神经元 |
| 作用对象 | 权重向量 w | 隐藏层神经元输出 |
| 数学操作 | 损失函数加 λ∣w∣2\lambda|\mathbf{w}|^2λ∣w∣2 | 输出乘伯努利 mask |
| 超参数 | λ(惩罚力度) | p(丢弃率) |
| 是否影响训练速度 | 几乎无 | 略增(随机操作) |
| 是否改变网络结构 | 否 | 训练时"感觉上"缩小网络 |
| 适用范围 | 几乎所有模型 | 全连接层最有效(卷积用 BN 更多) |