基于多尺度复数卷积融合网络(MCCFN)的自动调制识别实现与复现
本文环境: Python 3.9 + PyTorch 2.0 + CUDA 11.8 + NVIDIA RTX 3090
1. 背景与问题
自动调制识别(Automatic Modulation Recognition, AMR)是认知无线电与电子侦察中的底层关键任务。空天地一体化网络(SAGIN)场景下,信号经历多径、多普勒与干扰,低信噪比区间的识别率急剧下降。传统人工特征(高阶累积量、循环谱)泛化能力有限,而现有深度学习方法普遍将 I/Q 信号作为两个独立实数通道 处理,忽略了幅度与相位的联合分布信息。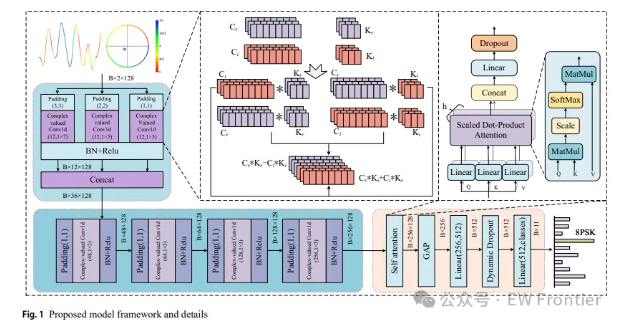
文献 1 提出的 MCCFN(Multi-scale Complex-valued Convolutional Fusion Network) 用复数卷积保留 I/Q 联合相位信息,配合多尺度特征提取与自注意力融合,在 RML2016.10A / 10b / RML22 上取得 SOTA 效果。本文基于公开代码梳理其结构、训练策略与复现要点。
2. 数据集说明
| 数据集 | 类别数 | 每帧采样点数 | SNR 范围 | 备注 |
|---|---|---|---|---|
| RML2016.10A | 11 | 128 | −20 ~ 30 dB | QAM16、QAM64、8PSK、WBFM、BPSK、CPFSK、AM-DSB、GFSK、PAM4、QPSK、AM-SSB |
| RML2016.10b | 10 | 128 | 0 ~ 30 dB | 同 10A 去除 AM-SSB,SNR 起点更高 |
| RML22 | 22 | 128 | −20 ~ 30 dB | 扩展调制样式,难度最大 |
训练配置(以 2016.10A 为例):epochs=100, batch_size=64, lr=0.001, patience=10, gamma=0.5。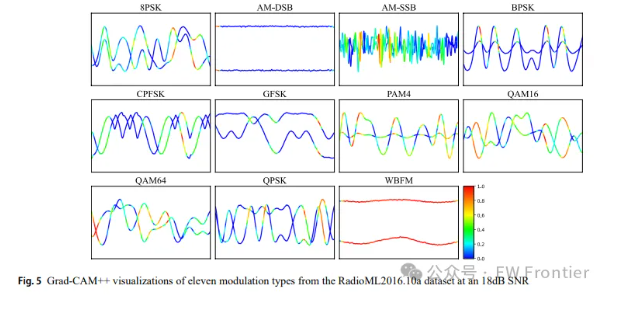
3. 复数卷积原理
将采样信号建模为复数
z = x + j y z = x + jy z=x+jy
复数卷积核 w = a + j b w = a + jb w=a+jb,卷积结果遵循复数乘法:
z ∗ w = ( x a − y b ) + j ( x b + y a ) z \ast w = (xa - yb) + j\,(xb + ya) z∗w=(xa−yb)+j(xb+ya)
即实部输出 = 实-实卷积 − 虚-虚卷积,虚部输出 = 实-虚卷积 + 虚-实卷积。实部与虚部通过卷积核参数交叉耦合 ,从而保留 I/Q 联合相位特征。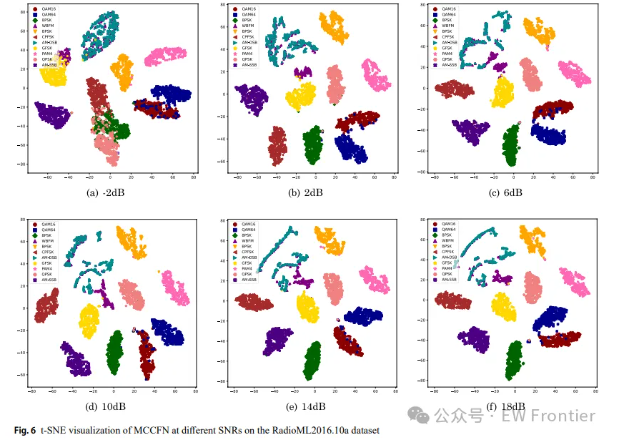
核心实现(完整版):
python
import torch
import torch.nn as nn

class ComplexConv1d(nn.Module):
    """复数一维卷积:实部/虚部交叉运算,保留 I/Q 联合相位信息

    参数:
        in_channels:  输入通道数,要求为 2 的倍数(实+虚)
        out_channels: 输出通道数,要求为 2 的倍数
    """
    def __init__(self, in_channels, out_channels, kernel_size=1,
                 stride=1, padding=0, dilation=1, groups=1,
                 bias=False, complex_axis=1):
        super().__init__()
        assert in_channels % 2 == 0 and out_channels % 2 == 0, \
            "复数卷积通道数必须为偶数(实/虚各半)"
        self.real_conv = nn.Conv1d(
            in_channels // 2, out_channels // 2,
            kernel_size, stride, padding, dilation, groups, bias=bias)
        self.imag_conv = nn.Conv1d(
            in_channels // 2, out_channels // 2,
            kernel_size, stride, padding, dilation, groups, bias=bias)

    def forward(self, inputs):
        # 输入 [B, C, L],沿通道维拆成实部/虚部
        real, imag = torch.chunk(inputs, 2, dim=1)
        real2real = self.real_conv(real)  # 实部 → 实部
        imag2imag = self.imag_conv(imag)  # 虚部 → 虚部
        real2imag = self.imag_conv(real)  # 实部 → 虚部(共享虚部卷积核)
        imag2real = self.real_conv(imag)  # 虚部 → 实部(共享实部卷积核)
        # 复数乘法:实部 = 实*实 − 虚*虚;虚部 = 实*虚 + 虚*实
        real_out = real2real - imag2imag
        imag_out = real2imag + imag2real
        return torch.cat([real_out, imag_out], dim=1)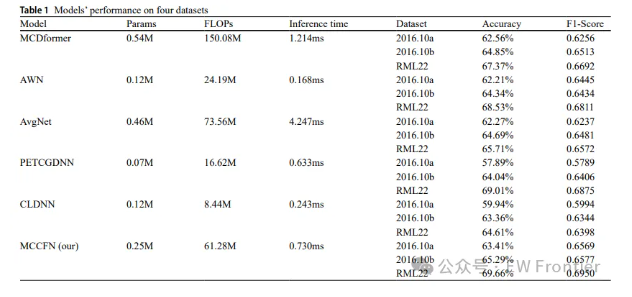
4. 网络结构
整体数据流:
text
IQ (2, 128)
  └─ MultiScaleModule ──► 复数卷积 kernel=3/5/7 并行,各 1/3 通道,拼接
  └─ Conv Stem ──► 复数卷积块 ×4:36 → 48 → 64 → 128 → 256
  └─ 自注意力特征融合(Multi-Head Attention, 2 头, hidden=512)
  └─ GAP ──► Linear(256,512) + Dropout + PReLU + Linear(512, num_classes)
多尺度模块(MultiScaleModule):
python
class MultiScaleModule(nn.Module):
    """多尺度复数卷积:3/5/7 三种卷积核并行,覆盖不同符号周期特征"""
    def __init__(self, out_channel):
        super().__init__()
        self.conv_3 = nn.Sequential(
            nn.ZeroPad2d((1, 1, 0, 0)),
            ComplexConv1d(2, out_channel // 3, kernel_size=3),
            nn.LeakyReLU(inplace=True),
            nn.BatchNorm2d(out_channel // 3))
        self.conv_5 = nn.Sequential(
            nn.ZeroPad2d((2, 2, 0, 0)),
            ComplexConv1d(2, out_channel // 3, kernel_size=5),
            nn.LeakyReLU(inplace=True),
            nn.BatchNorm2d(out_channel // 3))
        self.conv_7 = nn.Sequential(
            nn.ZeroPad2d((3, 3, 0, 0)),
            ComplexConv1d(2, out_channel // 3, kernel_size=7),
            nn.LeakyReLU(inplace=True),
            nn.BatchNorm2d(out_channel // 3))

    def forward(self, x):
        # 三种尺度的特征沿通道维拼接
        return torch.cat([self.conv_3(x), self.conv_5(x), self.conv_7(x)], dim=1)
自注意力特征融合(FeaFusionModule):
python
class FeaFusionModule(nn.Module):
    """自注意力特征融合:按输入信号动态加权多尺度特征"""
    def __init__(self, num_attention_heads, input_size, hidden_size):
        super().__init__()
        self.attention = nn.MultiheadAttention(
            embed_dim=hidden_size, num_heads=num_attention_heads, dropout=0.5)
        self.key_layer = nn.Linear(input_size, hidden_size)
        self.query_layer = nn.Linear(input_size, hidden_size)
        self.value_layer = nn.Linear(input_size, hidden_size)

    def forward(self, x):
        # x: [B, L, C];MultiheadAttention 期望 [L, B, C] 或 [B, L, C](batch_first)
        key = self.key_layer(x).permute(1, 0, 2)
        query = self.query_layer(x).permute(1, 0, 2)
        value = self.value_layer(x).permute(1, 0, 2)
        attn_output, _ = self.attention(query, key, value)
        return attn_output.permute(1, 0, 2)
5. 训练策略:动态 Dropout 与动态学习率
针对短样本(128 点)信号极易过早过拟合的问题,作者设计了两种动态机制。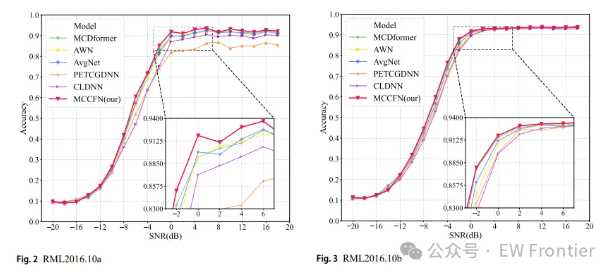
动态 Dropout: 学习率下降时(进入精细拟合阶段),将 Dropout 率从初始 0.3 逐步上调至上限 0.6:
python
def update_dropout(self):
    """学习率下降 → 加大 Dropout 正则,防止后期过拟合"""
    if self.current_lr < self.previous_lr:
        self.new_dropout_rate = min(
            self.cfg.max_dropout_rate,                    # 上限 0.6
            max(self.new_dropout_rate + 0.1,              # 步长 0.1
                self.cfg.initial_dropout_rate))           # 下限 0.3
        self.set_dropout_rate(self.new_dropout_rate)
动态学习率: 监测训练/验证准确率差异,超过阈值(acc_threshold=0.01)即降低学习率(gamma=0.5),配合早停(patience=10):
python
if acc_train - acc_val > self.cfg.acc_threshold:
    self.scheduler.step()  # 学习率 × 0.5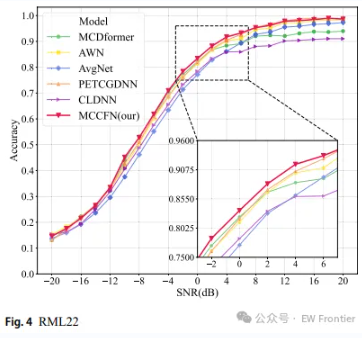
6. 实验结果与对比
| 数据集 | MCCFN | 对比基线(SOTA) | 提升 |
|---|---|---|---|
| RML2016.10A | 63.415% | ~62% 量级 | +1~2 个点 |
| RML2016.10b | 65.29% | 约 64% 量级 | +1 个点以上 |
| RML22 | 69.66% | 约 68% 量级 | +1~2 个点 |
消融实验(RML2016.10A):
| 变体 | 改动 | 结论 |
|---|---|---|
| MCCFN_1 | 单尺度卷积 | 多尺度有效,准确率下降 |
| MCCFN_2 | 实数卷积替换复数卷积 | 复数卷积有效,准确率明显回落 |
| MCCFN_3 | 去掉自注意力融合 | 动态融合有效,准确率下降 |
7. 复现避坑清单
- 通道数必须为偶数 :复数卷积要求
in_channels/out_channels能被 2 整除,否则torch.chunk(2)报错; - ZeroPad2d 的 padding 是 4 元组 :
(left, right, top, bottom),一维信号用(pad, pad, 0, 0)补左右两侧; - Dropout 上限别开太大:0.6 以上在低 SNR 段容易欠拟合,准确率反而下降;
- BN 放在激活之后 :
LeakyReLU → BatchNorm2d顺序经过实验验证,反序训练不稳定; - 按 SNR 分段评估:低 SNR 段准确率方差大,只看总体准确率会掩盖模型在 −10~0 dB 区间的能力;
- 短样本必配动态正则:128 点信号信息密度低,静态 Dropout 不足以抑制过拟合。
8. 参考文献
1 An Li, Yue Li, Qiang Zhang, Ping Chen. "A Multi-scale Complex-valued Convolutional Fusion Network for Automatic Modulation Recognition." Mobile Networks and Applications , 2026. DOI: 10.1007/s11036-026-02513-9
2 O'Shea T J, Corgan J, Clancy T C. "Convolutional radio modulation recognition networks." EANN 2016.(RML2016 数据集出处)
本文为原理与核心代码拆解,完整可运行工程、数据集与调参脚本见原文链接 EWFrontier。