DEAP数据集下载:https://gitee.com/CodeStoreHub/deap-fat
Transformer算法下载:https://gitee.com/CodeStoreHub/deap-fat
本算法将傅里叶启发的周期性表示与可学习的通道邻接关系结合,在 Transformer 中同时建模样本相关性与共享结构,并通过 DEAP 的效价、唤醒度分类实验检验模型的识别与泛化能力。
01 / OVERVIEW研究目标与方法定位
脑电情绪识别需要在噪声、非平稳性和个体差异的共同影响下,从多通道信号中提取有效信息。单纯依赖固定脑区连边可能无法适应样本变化,而完全由输入决定的注意力又缺少稳定的通道结构约束。我们提出傅里叶邻接 Transformer(Fourier Adjacency Transformer,FAT),将两类信息整合到同一注意力计算中。
周期性表示
我们使用傅里叶解析线性层(FAL)生成余弦、正弦与线性分支,使周期成分和非周期成分在特征维度上显式分离,再分别进入注意力头。
结构先验
我们学习周期和非周期两组邻接矩阵,通过输入相关的门控控制其贡献,将跨样本共享的通道关系与当前样本的 Q--K 相关性相加。
本报告重点回答三个问题:该结构如何工作;DEAP 数据如何变成模型输入;在明确划分和统计口径后,完整实验与原论文基线有何差异。
02 / METHODFAT:从差分熵到情绪预测
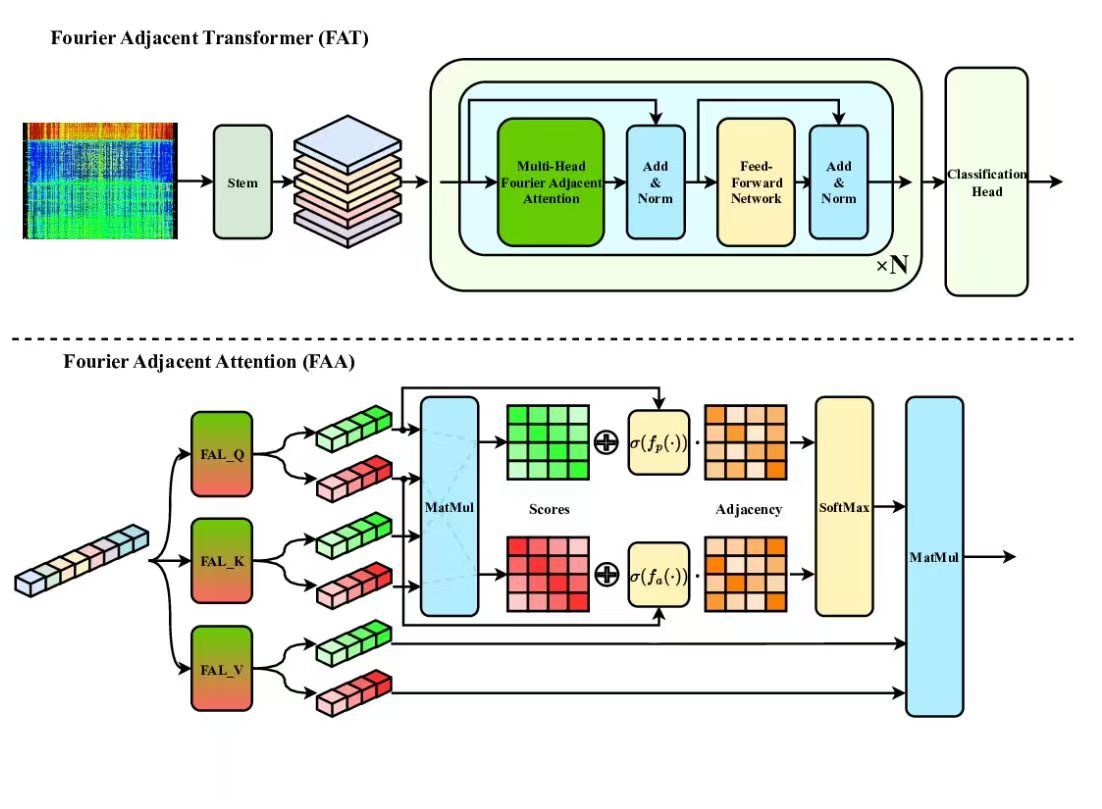
图 1|FAT 与 FAA 的模型框架。原论文 Figure 2;采用官方仓库 model.jpg 同版图,未重绘或更改结构。上半部分为完整网络,下半部分展开周期与非周期注意力分支。
2.1 输入表示与特征嵌入
我们不直接将 128 Hz 的原始波形输入 Transformer,而是对每个 EEG 窗口构建通道 × 频带的差分熵(Differential Entropy,DE)特征。在 DEAP 中,单个窗口为 32 × 5;训练张量为 B × 1 × 32 × 5,其中 B 为 batch size。序列 token 对应 EEG 通道,而非连续时间点。
嵌入模块先加入可学习的位置参数,再以两个 1×1 卷积实现逐通道的 5→20→40 维映射,各层配合 BatchNorm 与 ReLU。这样,每个通道被映射为一个 40 维 token。随后拼接可学习的 CLS token,并加入正弦位置编码,得到 B × 33 × 40 的序列。
X ∈ ℝB×C×F → ReLU(BN(f₂(ReLU(BN(f₁(X)))))) ∈ ℝB×C×E
DEAP:C = 32,F = 5,E = 40;实现接口额外包含一个长度为 1 的维度。
2.2 FAL:显式分离周期与非周期成分
我们用 FAL 替代普通线性 Q/K/V 投影。与 FAN 在非周期分支使用非线性激活不同,FAL 将该分支的激活设置为恒等映射,保留线性变换;周期分支通过可学习投影后的正弦和余弦构造特征。
Φ(x) = cos(Wpx) ‖ sin(Wpx) ‖ (Wax + ba)
‖ 表示拼接;p 表示周期分支,a 表示非周期分支。
当输出维度 E=40、代码中的 p_ratio=0.25 时,余弦和正弦分支各 10 维,线性分支为 20 维。因此,周期分支合计占输出的一半。8 个注意力头每头 5 维:前 4 个头处理周期特征,后 4 个头处理非周期特征。
这里的"傅里叶"是对正弦/余弦基函数表示的借鉴,不是对时间序列执行 FFT。模型学习的是 DE 特征空间中的周期性映射,不能直接将每个注意力头解释为某个物理脑电振荡频率。
2.3 FAA:把邻接关系加入注意力
我们分别通过 FAL 得到 Q、K、V,并对周期与非周期分支独立计算注意力。QKᵀ 描述输入样本中各通道之间的相关性;两组可学习邻接矩阵 Ap、Aa 表达训练中积累的共享关系。门控 g=σ(f(Q)) 让模型根据当前输入决定邻接项的权重。
Q = ΦQ(X),K = ΦK(X),V = ΦV(X)
Attentionr = softmax(QrKrT / √dk + σ(fr(Qr)) ⊙ Ar),r ∈ {p, a}
O = AttentionpVp ‖ AttentionaVa
以上为论文的概念公式;⊙ 表示带广播的逐元素门控加权。
在公开实现中,两组邻接矩阵为 33 × 33,包括 CLS token;先经 ReLU,再使用 D−1/2AD−1/2 归一化。邻接参数跨 6 层共享,而每层有自己的门控线性层。每组门控由该通道的 20 维查询生成一个标量,再广播到对应的 4 个头及各个 key 位置。
**共享结构不等于解剖连接。**该实现没有输入电极的物理距离或预先定义的脑区连接。邻接矩阵由任务损失学习,输入相关的变化主要来自 QKᵀ 与门控;它不应被直接当作经过神经科学验证的功能连接图。
2.4 Transformer 编码与分类头
我们堆叠 6 个编码模块,每个模块由预归一化注意力、残差连接及前馈网络组成。前馈网络将维度从 40 扩展到 160,经过 GELU 和 Dropout 后映射回 40。编码结束后,使用 CLS token 的表征,经 LayerNorm 和 40→2 的线性层输出二分类 logits。Valence 和 Arousal 各训练一套独立模型,不共享最终分类器。
DE 特征32 × 5
Stem32 × 40
CLS + 位置编码33 × 40
FAA 编码器 × 633 × 40
分类头2 logits
| 模型项 | 本次设置 | 含义 |
|---|---|---|
| 嵌入维度 / heads / depth | 40 / 8 / 6 | 每个 head 为 5 维 |
| FAL 周期分支 | 10 维 cos + 10 维 sin | 余下 20 维为恒等激活的线性分支 |
| 共享邻接矩阵 | 2 × 33 × 33 | 周期/非周期各一组,含 CLS 节点 |
| 可训练参数 | 114,812 | 32 通道、2 类的当前公开模型 |
| 位置编码 Dropout / 编码器 Dropout | 0.1 / 0.2 | 本次使用公开 FAT 类的默认配置 |
2.5 训练目标与数据增强
我们使用交叉熵和 Adam 优化器,学习率 0.001、weight decay 0.0001、batch size 32,固定训练 200 epochs,不使用测试集决定提前停止。每个训练样本的各频带独立乘以 U(0.9,1.1) 系数;Mixup 使用 α=0.2 的 Beta 分布对同一 batch 中的样本进行线性混合。
λ ∼ Beta(0.2, 0.2),x̃ = λxi + (1−λ)xj
ℒ = λ CE(f(x̃), yi) + (1−λ) CE(f(x̃), yj)
我们保留频率 2、幅度 0.05 的正弦增强公式。但是在 5 个等间隔频带取样点上,sin(2 × linspace(0, 2π, 5)) 几乎全为零,实际扰动可以忽略。这不是本次额外修正后的增强。
03 / DATASETDEAP 数据集与学习任务
DEAP 是面向情感计算的多模态数据集,由 Koelstra 等人构建。32 位参与者分别观看 40 段时长约一分钟的音乐视频,同时采集 EEG 与外周生理信号,并对情绪体验进行主观评分;其中 22 位参与者还记录了正面面部视频。数据集的原始论文介绍了刺激材料筛选、实验流程与多模态情绪分析任务。本实验只使用 EEG,不使用外周信号或面部视频。
| 项目 | 数据集 / 本次使用情况 |
|---|---|
| 参与者与 trials | 32 人 × 每人 40 trials = 1,280 trials |
| 输入文件 | 官方预处理 MATLAB 格式 s01.mat--s32.mat;只读使用标准文件,忽略重复的 *_1.mat |
| 文件中 data 的形状 | 40 × 40 × 8,064(trial × 通道 × 采样点),已逐文件校验 |
| 文件中 labels 的形状 | 40 × 4;列顺序为 Valence、Arousal、Dominance、Liking |
| 通道选择 | 40 个保留通道中使用前 32 个 EEG 通道;其余 8 个通道不进入本模型 |
| 采样率与长度 | 原始采集 512 Hz;所用预处理版本为 128 Hz。每 trial 63 秒 = 8,064 点,包含 3 秒基线 + 60 秒刺激段 |
| 原始 EEG 与预处理版本 | 预处理版本已做降采样、眼电伪迹处理、4--45 Hz 滤波及参考处理;本次从预处理版本继续提取 DE 特征 |
| 本次有效 EEG 总时长 | 1,280 × 60 秒 = 21 小时 20 分钟;窗口重叠不会增加独立记录时长 |
前 3 秒
384 点 · 丢弃
后 60 秒刺激 EEG
7,680 点 · 提取 59 个窗口
3.1 情感维度与二分类定义
Valence(效价) 描述情绪体验的愉悦程度,从不愉悦到愉悦;**Arousal(唤醒度)**描述激活强度,从平静到兴奋。高唤醒不必然代表积极情绪,低唤醒也不等同于消极情绪,因此我们分别建立两个二分类任务。Dominance 表达主观控制感,Liking 表达喜好程度,二者保留在原始标签中但不用于此次训练。
y = 1,若 rating > 5;否则 y = 0
低类:rating ≤ 5;高类:rating > 5。评分等于 5 的 trial 不丢弃。
所用标签的四个情感维度采用 1--9 评分。评分阈值与边界归类在 FAT 原文中未给出完整 DEAP 细节,因此这里是明确记录的实现假设。每个 trial 的标签复制到其 59 个窗口;我们没有把窗口解释为具有独立瞬时情绪标注的样本。
| 目标 | 高类 trials | 低类 trials | 高类比例 | 恰好等于 5 |
|---|---|---|---|---|
| Valence | 708 | 572 | 55.3125% | 16 trials,归低类 |
| Arousal | 737 | 543 | 57.5781% | 17 trials,归低类 |
上述类别计数来自本地 32 份 MATLAB 文件的实际 labels,而非引用其他实验的样本统计。不同被试类别比例不同,评估中额外保存由训练集多数类确定的测试基线。
04 / PROTOCOL特征提取与评估协议
4.1 从波形到差分熵
我们移除每个 trial 的前 384 个基线采样点,仅保留前 32 个 EEG 通道。以 256 点(2 秒)窗口、128 点(1 秒)步长滑动,从每个 60 秒 trial 提取 59 个重叠窗口。这里是直接丢弃基线段,并未再做基线 DE 相减。
Nwindow = ⌊(7,680 − 256) / 128⌋ + 1 = 59
Ntotal = 32 × 40 × 59 = 75,520
每个窗口、每个通道分别用四阶 Butterworth 带通滤波器和双向 filtfilt 处理,再以无偏样本方差估计高斯近似下的差分熵:
DE = ½ ln(2πeσ²),σ² = var(signal, ddof=1)
使用自然对数;高斯假设是特征构造的近似,不表示 EEG 必然服从高斯分布。
| 代码频带名称 | 频率范围 | 实现说明 |
|---|---|---|
| theta | 4--7 Hz | 沿用公开 DEAP 预处理 |
| alpha | 8--10 Hz | 与下一频带存在重叠 |
| slow_alpha | 8--13 Hz | 名称来自代码;未重新命名或替换 |
| beta | 14--29 Hz | 沿用公开 DEAP 预处理 |
| gamma | 30--45 Hz | 沿用公开 DEAP 预处理 |
这不是常见的 δ、θ、α、β、γ 五个互异频带;本次保留上游的两组 alpha 区间。随后对每个 trial 内每个通道/频带的 59 点 DE 序列做 LDS 平滑。随机游走模型取状态转移和观测系数为 1,过程噪声协方差 0.01,观测噪声协方差 1,初始均值取首点、初始协方差为 1。
向量化实现与官方逐通道滤波、方差计算及 pykalman 平滑的数值等价性已通过检查。每人保存 40 × 59 × 32 × 5 的特征;训练前仅用当前训练折计算各通道/频带的均值和标准差,再变换测试折。
4.2 三种划分,回答三类问题
| 协议 | 划分单位与训练方式 | 每折训练 / 测试窗口 | 解释范围 |
|---|---|---|---|
| window10 | 每位被试内按标签随机分层 10 折;汇总所有被试共同训练 | 67,968 / 7,552 | 已见被试、同一 trial 的窗口可以跨集合 |
| trial10 | 每位被试内按 trial 分层 10 折;一个 trial 的窗口整体分配 | 67,968 / 7,552 | 已见被试的独立 trial 识别 |
| LOSO | 31 位被试训练、1 位被试测试,共 32 折 | 73,160 / 2,360 | 未见被试泛化 |
**窗口重叠与平滑的信息共享。**相邻窗口共享 1 秒波形,LDS 平滑还利用整个 trial 的时间序列。window10 虽然样本索引不重叠,但原始信号来源和 trial 信息可以共享。trial10 将整个 trial 隔离;LOSO 进一步隔离被试。三个协议应分别解读。
论文只标记 DEAP 为 10-fold,并未公开全部划分索引或说明是否逐被试独立训练。我们依据其"训练与测试均含所有被试"的文字采用汇总训练;不将其视为作者未公开流水线的精确重放。少数被试某类 trial 少于 10 个时,trial 分层无法保证每折该被试都有两类,我们保留这些被试并记录 sklearn 提示。
4.3 结果统计规则
我们的主指标是固定第 200 epoch 的测试准确率。每折还记录 200 轮中的最高测试准确率,命名为"测试最高轮";它只用于观察上游报告方式的乐观偏差,不参与训练决策。均值与总体标准差采用 ddof=0:10 折按折统计,LOSO 按 32 位被试统计。没有挑最好的一折,也没有以最好一次运行代替全部结果。
基础 seed 为 42;实际模型 seed 加上折编号,Arousal 再加 1000 偏移。本次只有一组基础 seed,不代表多随机种子重复实验。完整训练量为 2 × (10 + 10 + 32) = 104 个模型,共 20,800 epochs。所有样本在每种协议/目标的折外预测(OOF)中恰好出现一次。
05 / RESULTS完整实验结果与论文基线对比
所有 104 次训练均完成 200 epochs,启动器于 2026-10-10 17:29:16 正常退出。以下单位均为百分比,格式为平均准确率 ± 标准差。原论文中的其他方法未在本次重新训练;它们是引用对照,不构成在完全相同预处理和数据划分下的受控排名。
**读表说明。**灰白行:原论文表 1 / 表 2 中的 DEAP 数值;绿色行:本次固定第 200 轮的主结果;浅橙行:本次每折测试最高轮的诊断值。"---"表示原论文未给出该方法在 DEAP 上的对应结果,而不是零准确率。论文未充分交代标准差的汇总单位,不能仅比较标准差大小就认定稳定性优劣。
5.1 被试相关 10 折:与论文表 1 对比
| 方法 | Valence / % | Arousal / % | |
|---|---|---|---|
| KNN | 67.40 ± 7.28 | 67.80 ± 6.94 | |
| SVM | 65.80 ± 4.62 | 69.89 ± 5.60 | |
| LSTM | 74.76 ± 3.41 | 71.81 ± 3.99 | |
| DGCNN | 84.69 ± 6.20 | 83.02 ± 7.07 | |
| BiHDM | --- | --- | |
| RGNN | --- | --- | |
| PGCN | --- | --- | |
| Conformer | 80.71 ± 2.30 | 79.42 ± 3.03 | |
| 我们的方法 · 固定 200 轮 | 83.96 ± 1.12 | 84.96 ± 2.14 | |
| 我们的方法 · 测试最高轮 | 84.72 ± 0.73 | 86.11 ± 1.34 |
固定训练轮次下,我们在 Valence、Arousal 上得到 83.96 ± 1.12% 与 84.96 ± 2.14%,分别比原论文 FAT 值低 6.14 和 4.22 个百分点。即使从测试曲线中挑最高轮,均值仍为 84.72%、86.11%,没有达到原论文的 90.10%、89.18%。
数值上,本次固定轮 Valence 略低于论文 DGCNN 的 84.69%,Arousal 高于其 83.02%;两项均高于论文 Conformer 的 80.71%、79.42%。由于并未重跑这些基线且 DEAP 划分细节缺失,我们不将这些差异表述为经过同条件验证的性能优越性。
5.2 跨被试 LOSO:与论文表 2 对比
| 方法 | Valence / % | Arousal / % | |
|---|---|---|---|
| KNN | 55.35 ± 4.30 | 52.86 ± 4.22 | |
| SVM | 54.70 ± 0.36 | 55.90 ± 0.76 | |
| LSTM | 60.31 ± 0.24 | 59.78 ± 0.27 | |
| DGCNN | 59.72 ± 1.38 | 57.26 ± 1.29 | |
| BiHDM | --- | --- | |
| RGNN | --- | --- | |
| PGCN | --- | --- | |
| Conformer | 62.40 ± 0.20 | 59.90 ± 0.60 | |
| 我们的方法 · 固定 200 轮 | 50.77 ± 8.17 | 52.96 ± 14.14 | |
| 我们的方法 · 测试最高轮 | 62.42 ± 6.84 | 66.51 ± 8.66 |
固定第 200 轮时,Valence 为 50.77 ± 8.17% ,Arousal 为 52.96 ± 14.14%,低于原论文 FAT 的 62.70%、60.00%。两项也低于本次按训练多数类得到的测试基线 55.31%、57.58%。这说明当前固定训练方案没有得到稳定有效的跨被试泛化。
但是,若每折选择测试最高轮,结果变为 62.42 ± 6.84% 与 66.51 ± 8.66% ,相较固定最后轮提高 11.65 和 13.55 个百分点。Valence 均值接近论文,Arousal 均值超过论文;此时标准差仍与论文报告不同。这种"接近或超过"依赖测试集选轮,不能作为独立验证集选模后的泛化成绩。
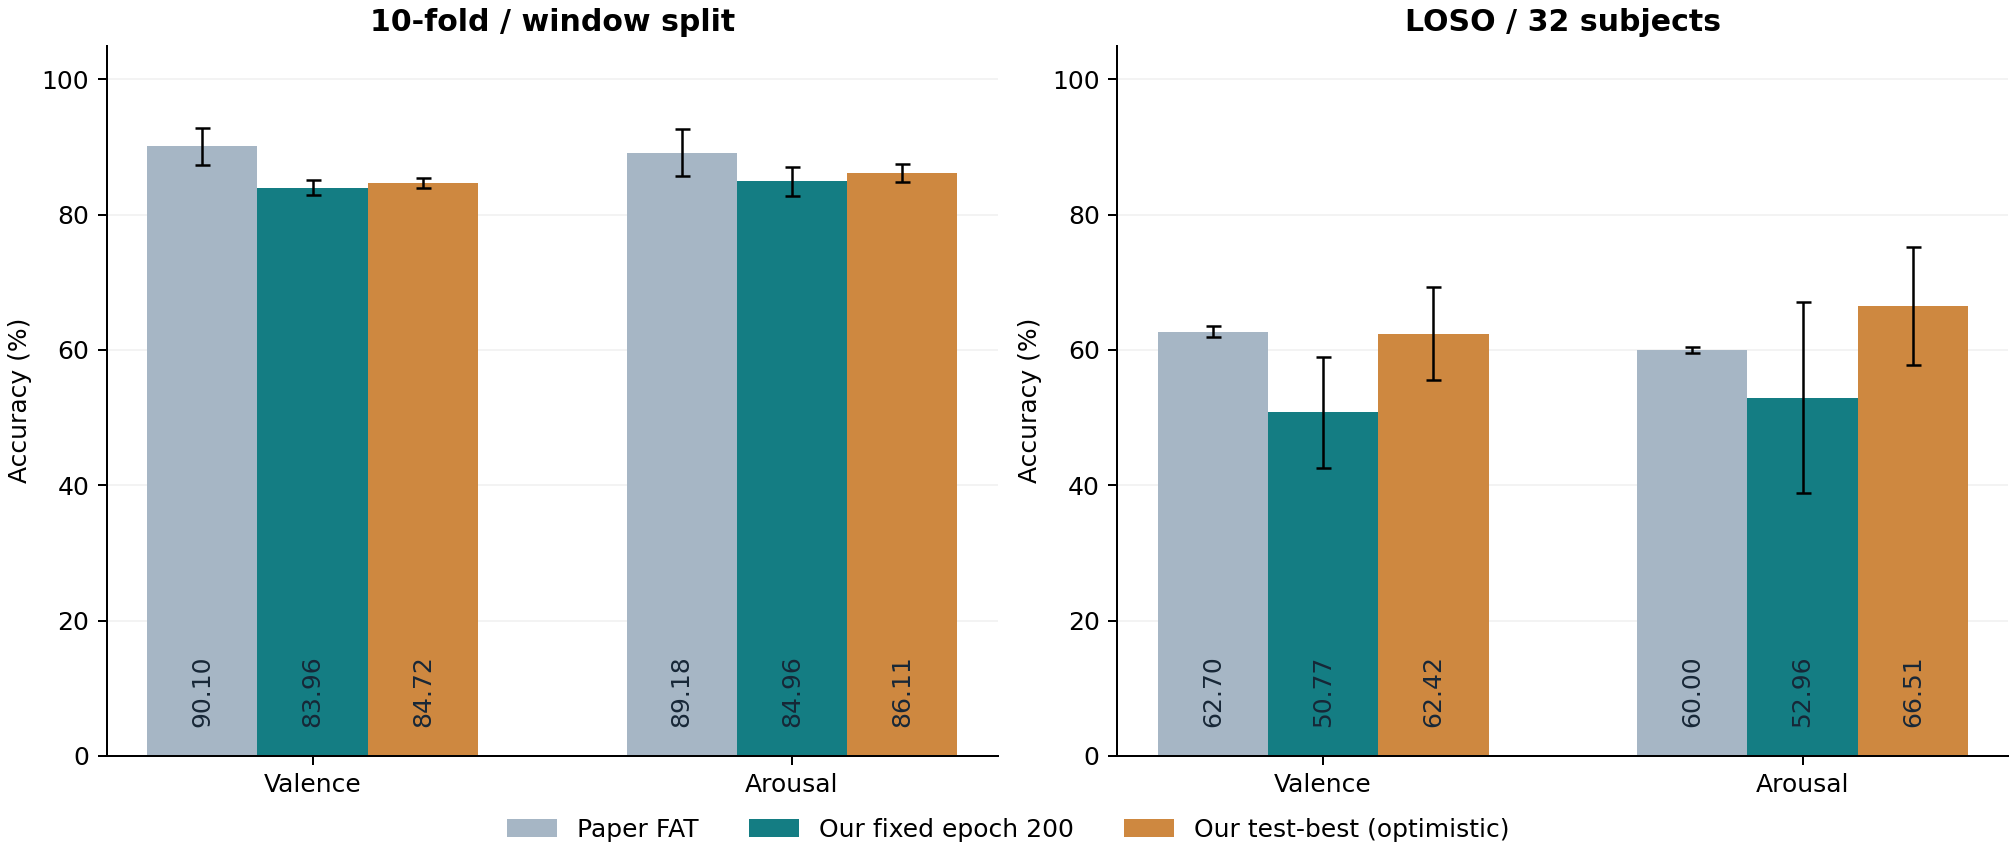
图 2|FAT 的论文报告与本次实验对比。误差线表示各自统计口径下的标准差;论文统计单位未完全明确。纵轴从 0 开始,浅橙色为具有测试选择偏差的诊断值。图中仅展示 FAT 的不同来源/统计口径。
5.3 trial 隔离对照与完整统计
| 协议 | 目标 | 完成折数 | 固定 200 轮 / % | 测试最高轮 / % | 训练多数类基线 / % |
|---|---|---|---|---|---|
| window10 | valence | 10/10 | 83.96 ± 1.12 | 84.72 ± 0.73 | 55.31 ± 0.09 |
| window10 | arousal | 10/10 | 84.96 ± 2.14 | 86.11 ± 1.34 | 57.58 ± 0.05 |
| trial10 | valence | 10/10 | 63.12 ± 2.81 | 67.71 ± 2.71 | 55.31 ± 5.30 |
| trial10 | arousal | 10/10 | 62.97 ± 3.58 | 67.78 ± 2.89 | 57.58 ± 2.84 |
| loso | valence | 32/32 | 50.77 ± 8.17 | 62.42 ± 6.84 | 55.31 ± 9.14 |
| loso | arousal | 32/32 | 52.96 ± 14.14 | 66.51 ± 8.66 | 57.58 ± 15.69 |
trial10 中 Valence 为 63.12 ± 2.81% ,Arousal 为 62.97 ± 3.58%。相对于 window10,固定轮结果分别下降 20.84、21.99 个百分点。这表明"在同一 trial 的窗口之间插值"和"识别未参与训练的 trial"是难度不同的任务;重叠窗口与整段平滑使前者具有较强的 trial 信息共享。本次对照没有进一步分离共享波形、平滑和其他分布差异各自的因果贡献。
5.4 学习曲线:为什么最高轮与最后轮差距很大
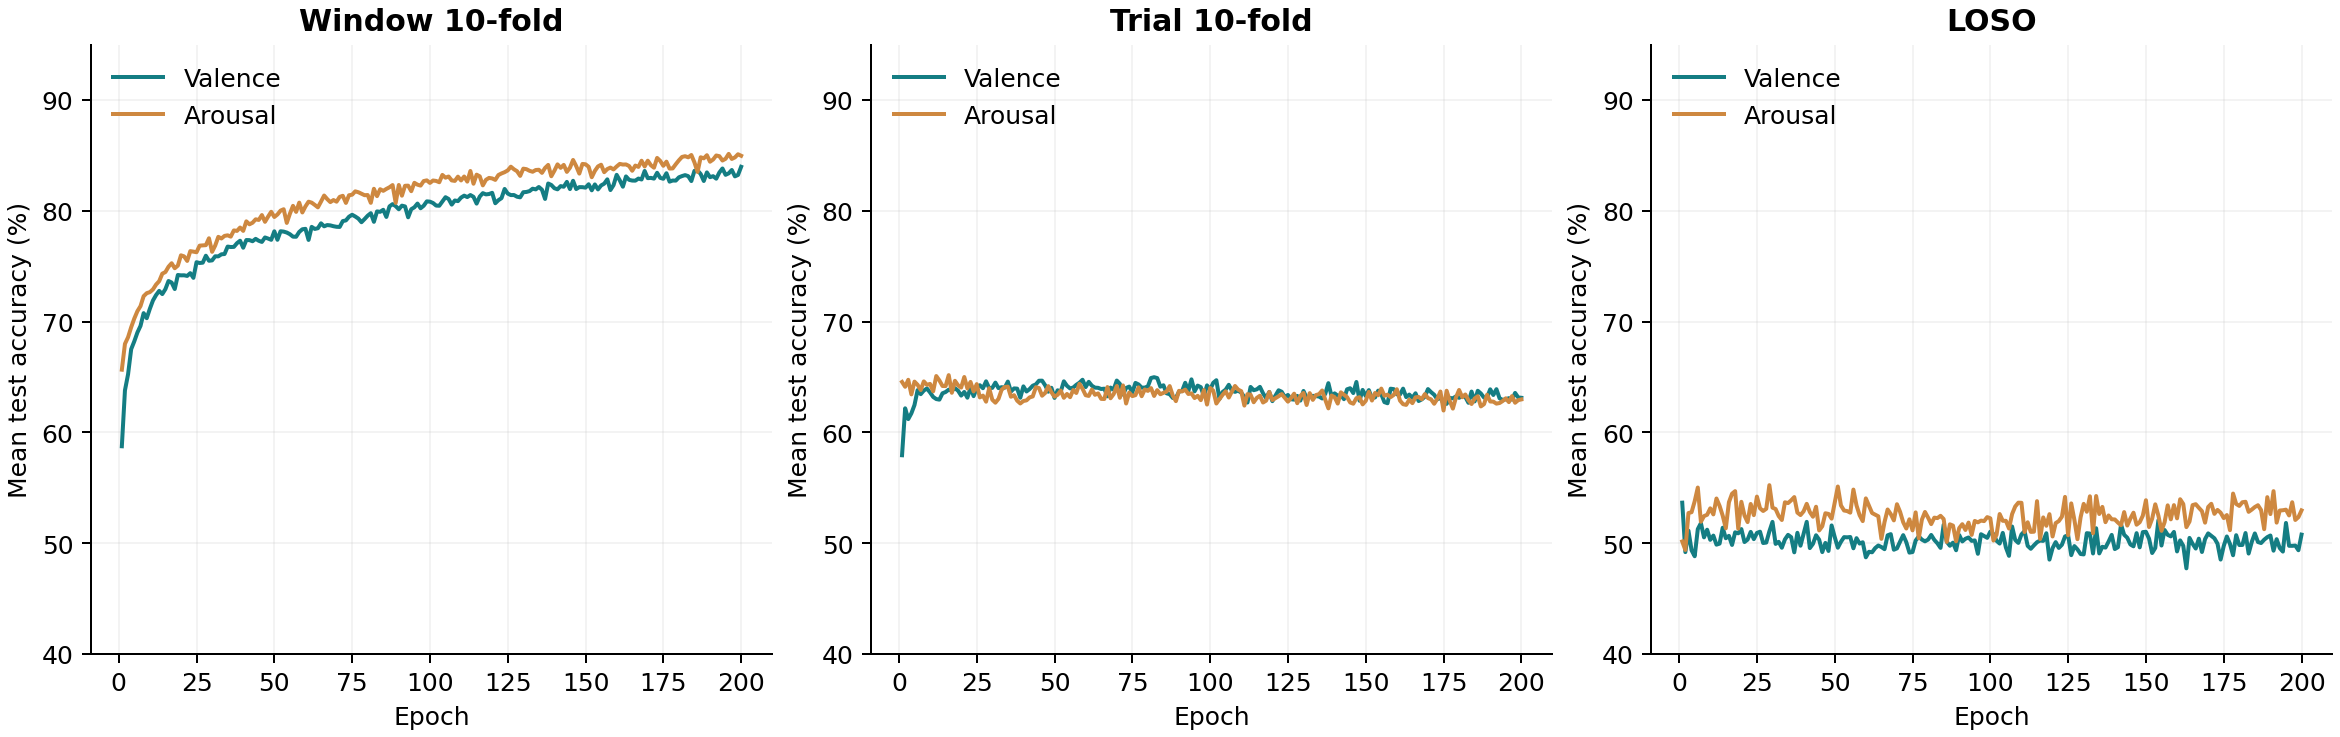
图 3|同一 epoch 上对所有折的测试准确率求均值。曲线仅用于事后诊断,没有参与本次训练控制。特别注意:"逐折最高值的平均"不等于"平均曲线的最高值",不能用这幅图替代逐折最佳轮的统计。
跨 trial 和跨被试任务中,训练后期的测试表现未必继续改善。合理的模型选择应在训练数据内部建立独立验证集:trial 泛化任务按 trial 划分验证集,跨被试任务可留出训练被试作验证。然后只在最终测试集上评价选定模型。本次未运行这种嵌套验证,也未将其可能带来的改善计入结果。
展开 104 次训练的逐折结果
每行对应一个独立训练任务,均完成 200 epochs。完整 CSV 保存在工程的 results/deap_seed42/final_results.csv 中。
| 协议 | 目标 | 折 | 固定 200 轮 / % | 测试最高 / % | 最高分轮次 |
|---|---|---|---|---|---|
| loso | arousal | 1 | 40.47 | 59.49 | 16 |
| loso | arousal | 2 | 64.70 | 65.34 | 105 |
| loso | arousal | 3 | 22.54 | 49.19 | 31 |
| loso | arousal | 4 | 45.38 | 56.36 | 113 |
| loso | arousal | 5 | 44.07 | 56.23 | 180 |
| loso | arousal | 6 | 44.24 | 64.19 | 172 |
| loso | arousal | 7 | 62.97 | 67.16 | 70 |
| loso | arousal | 8 | 54.62 | 65.21 | 6 |
| loso | arousal | 9 | 59.53 | 66.99 | 146 |
| loso | arousal | 10 | 56.06 | 62.75 | 7 |
| loso | arousal | 11 | 37.50 | 61.19 | 1 |
| loso | arousal | 12 | 75.55 | 82.50 | 1 |
| loso | arousal | 13 | 85.00 | 86.02 | 25 |
| loso | arousal | 14 | 67.50 | 69.11 | 65 |
| loso | arousal | 15 | 62.37 | 71.14 | 16 |
| loso | arousal | 16 | 54.96 | 64.15 | 9 |
| loso | arousal | 17 | 54.70 | 66.19 | 68 |
| loso | arousal | 18 | 61.61 | 65.38 | 54 |
| loso | arousal | 19 | 33.81 | 68.86 | 3 |
| loso | arousal | 20 | 41.06 | 75.38 | 50 |
| loso | arousal | 21 | 59.58 | 80.00 | 77 |
| loso | arousal | 22 | 40.51 | 43.52 | 155 |
| loso | arousal | 23 | 58.56 | 73.94 | 52 |
| loso | arousal | 24 | 17.50 | 73.22 | 67 |
| loso | arousal | 25 | 65.89 | 72.63 | 20 |
| loso | arousal | 26 | 48.94 | 60.08 | 98 |
| loso | arousal | 27 | 56.53 | 67.71 | 146 |
| loso | arousal | 28 | 43.64 | 63.01 | 5 |
| loso | arousal | 29 | 68.90 | 73.64 | 181 |
| loso | arousal | 30 | 49.15 | 58.73 | 54 |
| loso | arousal | 31 | 53.60 | 68.94 | 59 |
| loso | arousal | 32 | 63.26 | 70.00 | 179 |
| loso | valence | 1 | 47.54 | 51.44 | 135 |
| loso | valence | 2 | 42.80 | 55.55 | 2 |
| loso | valence | 3 | 47.03 | 58.01 | 36 |
| loso | valence | 4 | 42.97 | 59.19 | 138 |
| loso | valence | 5 | 52.42 | 59.66 | 169 |
| loso | valence | 6 | 64.32 | 75.47 | 142 |
| loso | valence | 7 | 46.57 | 72.37 | 17 |
| loso | valence | 8 | 49.92 | 68.18 | 28 |
| loso | valence | 9 | 47.16 | 65.08 | 16 |
| loso | valence | 10 | 43.31 | 53.52 | 154 |
| loso | valence | 11 | 48.31 | 63.01 | 1 |
| loso | valence | 12 | 43.18 | 53.14 | 85 |
| loso | valence | 13 | 41.95 | 50.04 | 35 |
| loso | valence | 14 | 41.65 | 50.13 | 111 |
| loso | valence | 15 | 41.53 | 62.12 | 3 |
| loso | valence | 16 | 54.41 | 65.38 | 12 |
| loso | valence | 17 | 46.57 | 59.75 | 52 |
| loso | valence | 18 | 55.08 | 67.12 | 171 |
| loso | valence | 19 | 43.64 | 67.92 | 3 |
| loso | valence | 20 | 65.97 | 73.60 | 181 |
| loso | valence | 21 | 55.42 | 63.26 | 73 |
| loso | valence | 22 | 64.66 | 66.74 | 133 |
| loso | valence | 23 | 61.27 | 67.63 | 159 |
| loso | valence | 24 | 45.97 | 56.91 | 11 |
| loso | valence | 25 | 46.95 | 55.04 | 52 |
| loso | valence | 26 | 38.77 | 63.81 | 4 |
| loso | valence | 27 | 67.25 | 71.91 | 176 |
| loso | valence | 28 | 48.22 | 62.50 | 1 |
| loso | valence | 29 | 60.85 | 70.34 | 87 |
| loso | valence | 30 | 63.98 | 66.86 | 25 |
| loso | valence | 31 | 53.86 | 62.97 | 9 |
| loso | valence | 32 | 51.19 | 58.90 | 30 |
| trial10 | arousal | 1 | 66.50 | 71.35 | 16 |
| trial10 | arousal | 2 | 70.17 | 72.72 | 3 |
| trial10 | arousal | 3 | 65.61 | 70.41 | 126 |
| trial10 | arousal | 4 | 63.67 | 67.77 | 190 |
| trial10 | arousal | 5 | 57.02 | 67.77 | 12 |
| trial10 | arousal | 6 | 61.12 | 64.08 | 160 |
| trial10 | arousal | 7 | 60.05 | 66.70 | 15 |
| trial10 | arousal | 8 | 60.90 | 62.99 | 26 |
| trial10 | arousal | 9 | 63.80 | 67.57 | 153 |
| trial10 | arousal | 10 | 60.88 | 66.49 | 58 |
| trial10 | valence | 1 | 58.32 | 65.57 | 3 |
| trial10 | valence | 2 | 64.35 | 70.41 | 9 |
| trial10 | valence | 3 | 63.44 | 69.70 | 76 |
| trial10 | valence | 4 | 64.27 | 70.23 | 43 |
| trial10 | valence | 5 | 67.65 | 70.42 | 138 |
| trial10 | valence | 6 | 64.34 | 66.26 | 38 |
| trial10 | valence | 7 | 58.00 | 62.67 | 116 |
| trial10 | valence | 8 | 62.05 | 64.50 | 106 |
| trial10 | valence | 9 | 64.68 | 70.13 | 155 |
| trial10 | valence | 10 | 64.09 | 67.21 | 57 |
| window10 | arousal | 1 | 87.39 | 87.61 | 191 |
| window10 | arousal | 2 | 82.32 | 84.97 | 137 |
| window10 | arousal | 3 | 80.99 | 83.20 | 184 |
| window10 | arousal | 4 | 86.45 | 86.45 | 200 |
| window10 | arousal | 5 | 85.18 | 85.50 | 198 |
| window10 | arousal | 6 | 86.20 | 87.04 | 172 |
| window10 | arousal | 7 | 84.98 | 86.73 | 141 |
| window10 | arousal | 8 | 84.89 | 85.92 | 199 |
| window10 | arousal | 9 | 88.10 | 88.10 | 200 |
| window10 | arousal | 10 | 83.09 | 85.61 | 190 |
| window10 | valence | 1 | 83.47 | 83.50 | 189 |
| window10 | valence | 2 | 83.86 | 84.26 | 196 |
| window10 | valence | 3 | 84.41 | 84.48 | 171 |
| window10 | valence | 4 | 84.97 | 85.55 | 197 |
| window10 | valence | 5 | 84.11 | 84.83 | 174 |
| window10 | valence | 6 | 86.18 | 86.30 | 194 |
| window10 | valence | 7 | 83.41 | 84.12 | 185 |
| window10 | valence | 8 | 81.63 | 84.68 | 160 |
| window10 | valence | 9 | 84.16 | 84.77 | 184 |
| window10 | valence | 10 | 83.43 | 84.73 | 169 |
06 / ENVIRONMENT运行环境与安装方法
6.1 本次已验证环境
| 组件 | 实际版本 / 设置 |
|---|---|
| 操作系统 | Ubuntu 22.04.5 LTS,Linux x86_64 |
| GPU / NVIDIA 驱动 | RTX 3090 24 GB,仅 GPU0;驱动 570.195.03 |
| Python | 3.10.20 |
| PyTorch / CUDA runtime | 2.2.2+cu121 / CUDA 12.1 |
| 核心依赖 | NumPy 1.23.5、SciPy 1.14.1、einops 0.8.0、scikit-learn 1.6.0、pykalman 0.10.2 |
| 数值与执行设置 | FP32;TF32 关闭;PyTorch/cuDNN 确定性算法;CUDA Graph 训练步加速 |
| 上游代码提交 | 3f70685bf5917325a659fad93038c82b21e91702 |
6.2 准备代码与 Python 环境
以下命令假设已取得本工作区完整工程 ,其中包含新增的 experiments/ 目录。仅克隆原始 GitHub 仓库不能获得本次补充的 DEAP 入口。先进入工程根目录;如换机器,将第一行改为自己的工程路径。机器需已安装 Python 3.10(含 venv)以及可用的 NVIDIA 驱动。
cd /home/ubuntu/lishuo/code/FAT

# 新机器首次安装使用;当前工作区已有可用 .venv,无需重建
python3.10 -m venv .venv
.venv/bin/python -m pip install --upgrade pip

# 精确锁定本次训练依赖(优先使用)
.venv/bin/python -m pip install -r experiments/requirements.lock.txt
如果只需安装 DEAP 入口所用的核心依赖,可改用 experiments/requirements.txt。完整锁文件进一步固定了 CUDA runtime 相关依赖和间接依赖。不要在本项目的 Python 3.10 环境中将 NumPy 随意升级到 2.x;本次 PyTorch 2.2.2 组合已固定为 NumPy 1.23.5。
# 核心依赖安装方案(二选一)
.venv/bin/python -m pip install -r experiments/requirements.txt

# 已安装 uv 的机器也可使用
uv venv --python python3.10 .venv
uv pip install --python .venv/bin/python -r experiments/requirements.lock.txt
PyTorch 的这一安装组合包含运行所需的 CUDA 用户态库,训练本代码通常无需另行编译或安装整套 CUDA Toolkit;系统 NVIDIA 驱动仍必须可用。原仓库根目录的 requirements.txt 包含更多模型/绘图相关依赖,本次 DEAP 入口使用 experiments/ 下的清单,额外补上了原清单缺失的 pykalman。
6.3 验证 GPU0 与依赖
export CUDA_DEVICE_ORDER=PCI_BUS_ID
export CUDA_VISIBLE_DEVICES=0
export OMP_NUM_THREADS=1
export MKL_NUM_THREADS=1
export OPENBLAS_NUM_THREADS=1

nvidia-smi
.venv/bin/python - <<'PY'
import torch, numpy, scipy, sklearn, einops
print('PyTorch:', torch.__version__, 'CUDA runtime:', torch.version.cuda)
print('NumPy:', numpy.__version__, 'SciPy:', scipy.__version__)
print('scikit-learn:', sklearn.__version__, 'einops:', einops.__version__)
assert torch.cuda.is_available()
assert torch.cuda.device_count() == 1
print('Visible GPU:', torch.cuda.get_device_name(0))
PY
训练入口内部也设置了 GPU0 可见性。可通过 nvidia-smi --query-compute-apps=gpu_uuid,pid,process_name --format=csv 将训练 PID 与物理卡对应。仅看到显存空闲较多并不意味着计算没有充分执行;当前模型参数量较小,主要开销来自大量小 batch 的重复计算与调度。
展开完整依赖锁文件
07 / REPRODUCIBILITY从数据到完整实验的运行步骤
7.1 目录与数据准备
FAT/
├── FAT_model.py / FANLayer.py / utils.py
├── 0161_paper.pdf / model.jpg
├── experiments/
│   ├── prepare_deap.py          # 预处理、标签和数据摘要
│   ├── run_deap.py              # 三种协议、两类目标、结果汇总
│   ├── cuda_step.py             # CUDA Graph 训练步
│   ├── check_deap.py            # 特征等价性与分折检查
│   ├── check_cuda_step.py       # 图捕获与 eager 数值检查
│   ├── check_resume.py          # 连续训练与续训检查
│   ├── launch_deap.sh           # 检查 + 数据准备 + 完整训练
│   └── requirements.lock.txt
├── data/deap_raw/s01.mat ... s32.mat
├── data/deap_features/          # 预处理后自动生成
├── results/deap_seed42/         # 本次已完成实验,保留不覆盖
└── report/                     # 本 HTML 与文档生成源文件
把标准 s01.mat 至 s32.mat 放到 data/deap_raw/。这些文件应来自 data_preprocessed_matlab,不是原始 BDF,也不是已经提取好的 DE 特征。每个文件需包含 data 与 labels。
.venv/bin/python experiments/check_deap.py
.venv/bin/python experiments/check_cuda_step.py
.venv/bin/python experiments/check_resume.py
.venv/bin/python experiments/prepare_deap.py
预处理输出包含每人特征、四维评分与原始文件 SHA-256;manifest.json 保存数据列表与预处理参数。输出存在时会验证原始数据摘要。新一轮训练前若变更预处理算法,应使用新的特征输出目录,避免旧缓存混入新实验。
7.2 先做短程检查
# 完整数据、第 1 折、2 epochs;仅检查流程,不用于论文结论
.venv/bin/python experiments/run_deap.py \
  --protocols window10 --targets valence --folds 1 \
  --epochs 2 --checkpoint-every 1 --out results/smoke_new
7.3 正式训练
以下使用新输出目录保护现有最终结果。第一个命令运行 104 次完整队列;第二个命令仅运行两项 window10,各自 10 折。运行时选择所需的一种,不要同时在 GPU0 启动两个队列。
# 完整队列:window10 + LOSO + trial10,两个目标,各 200 epochs
bash experiments/launch_deap.sh results/deap_seed42_replay

# 或:仅复现被试相关 window10(20 个模型)
.venv/bin/python experiments/run_deap.py \
  --protocols window10 --targets valence arousal \
  --epochs 200 --out results/window10_seed42_new
完整队列按折交错运行协议与目标。已完成的实验原样保存,配置、源码摘要与输出目录不匹配时拒绝继续。不要在完整训练中途把 200 改成 50 后仍将结果标为同一实验。
7.4 后台执行、监控与续跑
mkdir -p results/deap_seed42_replay
nohup bash experiments/launch_deap.sh results/deap_seed42_replay \
  > results/deap_seed42_replay/launcher.log 2>&1 &
echo $! > results/deap_seed42_replay/launcher.pid

tail -f results/deap_seed42_replay/launcher.log
cat results/deap_seed42_replay/status.json
cat results/deap_seed42_replay/summary.json

# 中断后,用原命令及原输出目录继续
bash experiments/launch_deap.sh results/deap_seed42_replay
每 5 epochs 原子保存一次检查点,包括模型、Adam 状态及 Python / NumPy / PyTorch / CUDA 随机状态。恢复时会重算未保存的尾部 epochs;已完成的折会跳过。目录锁防止同一队列误启动多个进程。summary.json 从首个完整任务结束后才出现;completed.json 只在指定队列全部完成后生成。
7.5 输出文件与检查依据
| 文件 | 用途 |
|---|---|
| config.json | 训练参数、依赖版本、上游提交及核心源文件摘要 |
| status.json / launcher.log | 最新 epoch 指标与完整运行过程 |
| 每折 split.npz | train/test 索引、仅训练集拟合的均值和标准差 |
| 每折 epochs.jsonl / result.json | 200 条训练轮日志与该折最终统计 |
| 每折 latest.pt / predictions.npz | 最后检查点、最终轮逐样本预测及真实标签 |
| summary.json / final_results.csv | 汇总统计与 104 次完整结果;CSV 为结束后导出的审计表 |
| completed.json / launcher_exit.txt | 完成标记及启动器退出时间、退出码 |