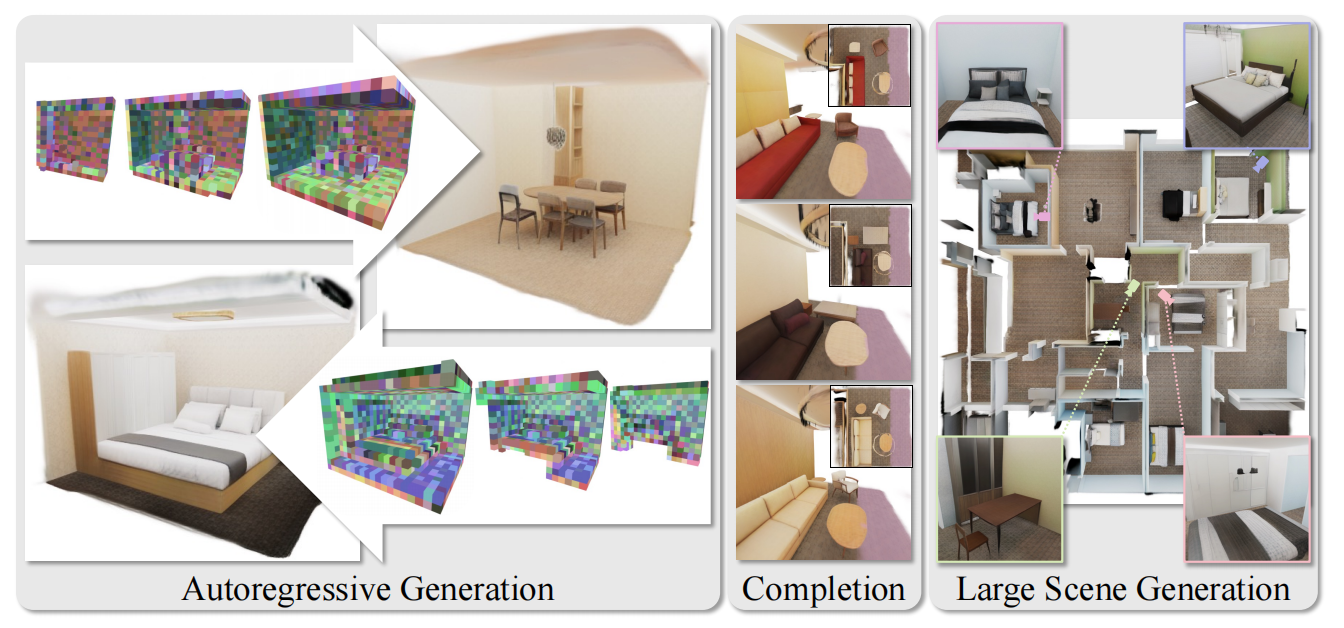
图 1:GaussianGPT 是一种用于三维高斯场景生成的纯自回归方法 。本方法仅需单一模型,即可实现无条件场景生成、场景补全以及大规模场景合成。
目录
- 摘要
- [1. 3D场景压缩与离散化](#1. 3D场景压缩与离散化)
- [2. 训练损失函数](#2. 训练损失函数)
- [3. 潜在3D网格的自回归建模](#3. 潜在3D网格的自回归建模)
- [4. 3D旋转位置编码与网络架构](#4. 3D旋转位置编码与网络架构)
- [5. 场景生成与补全](#5. 场景生成与补全)
- 实验
标题:GaussianGPT: Towards Autoregressive 3D Gaussian Scene Generation
来源:德国慕尼黑工业大学
摘要
GaussianGPT 提出了一种用于3D高斯场景生成的全自回归(Autoregressive)模型 ,有别于目前主流的基于扩散(Diffusion)或流匹配(Flow-matching)的全局去噪方法。该模型将3D场景构建视为一个序列预测过程,通过预测下一个Token来逐步生成3D高斯基元,从而自然地支持场景的增量构建、补全和外扩(Outpainting)。
1. 3D场景压缩与离散化
为了使(基于离散Token序列的)Transformer能够处理3D数据,GaussianGPT首先将连续的3DGS,转换为紧凑的离散潜在网格表示:
- 稀疏3D特征网格 (Sparse 3D Feature Grid):输入场景由一组高斯基元组成(包含位置、不透明度、大小、旋转和颜色等属性)。模型将这些基元分配到世界坐标系中的体素中,将绝对位置替换为相对于体素中心的偏移量,并通过轻量级编码头将特征拼接为统一的体素特征向量。
- 稀疏3D卷积编解码器 (Sparse 3D CNN Encoder-Decoder):输入特征网格通过稀疏3D卷积编码器进行渐进式下采样,得到紧凑的潜在表示。该设计保留了空间局部性和平移等变性。
- 向量量化 (Vector Quantization):模型采用无查找表量化(Lookup-free quantization, LFQ),通过对编码器输出的符号进行二值化(0或1离散化),直接映射到码本索引,从而提高码本利用率和生成质量。
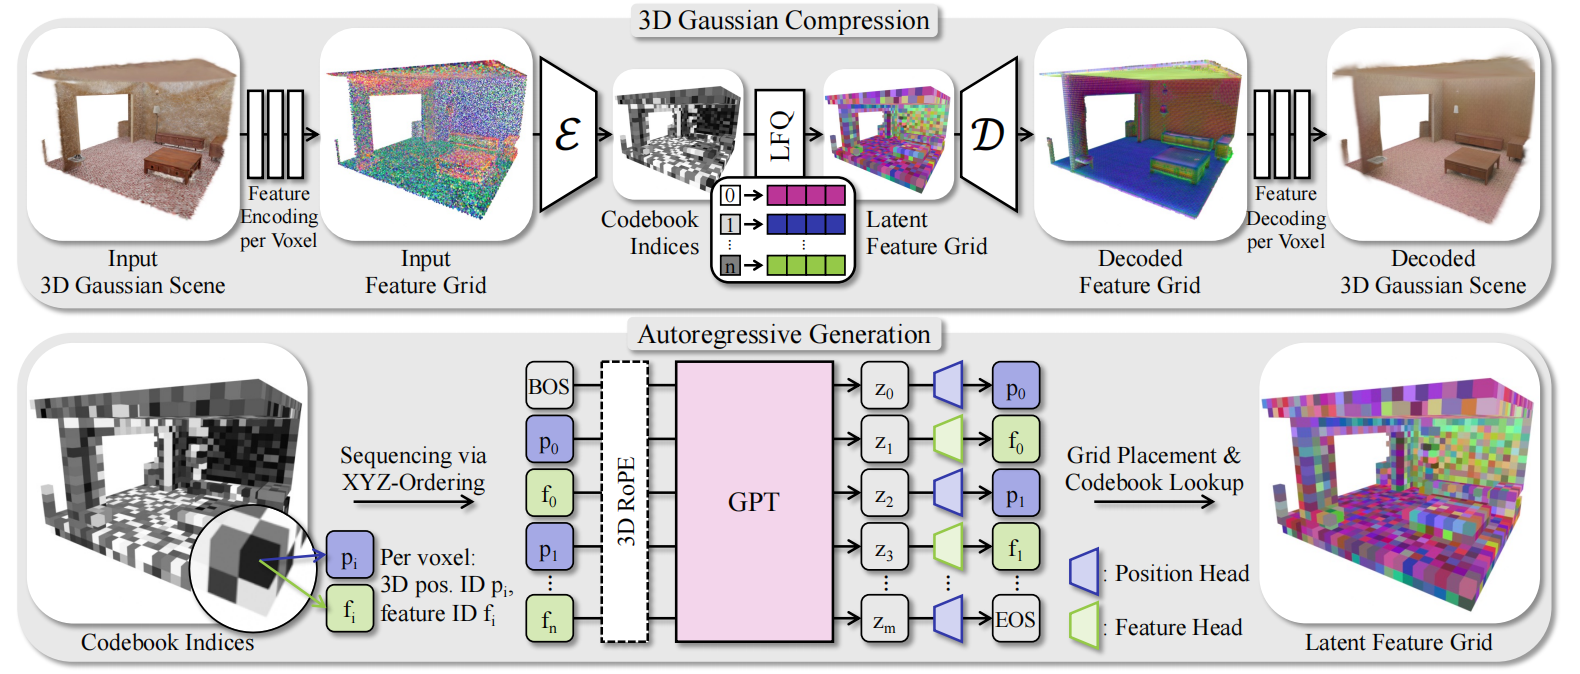
图2:GaussianGPT 概览。1.将3dgs子采样至稀疏体素网格 ,并编码为每个体素的特征。稀疏三维卷积神经网络 将该网格压缩为离散的码本索引 。2.生成的潜在网格通过 xyz 顺序序列化,表示为交错的位置标记 p i p_i pi 和特征标记 f i f_i fi。3.带有三维 RoPE 的因果Transformer 预测交替的位置与特征标记,这些标记被映射回体素位置,并通过 LFQ 解码,最终重建出三维高斯场景。
2. 训练损失函数
网络基于随机选择的图像进行训练,结合了重渲染 (Re-rendering)、占用率 (Occupancy)和码本(Codebook)损失 。重渲染损失包含 L 1 L_1 L1 颜色损失和基于VGG19的感知损失;占用率预测通过二元交叉熵损失指导;LFQ码本损失旨在增加码本熵。整体损失函数公式如下: L = λ R G B L R G B + λ p e r c L p e r c ⏟ re-rendering + λ o c c L o c c ⏟ occupancy + λ L F Q softplus ( L L F Q + 5 ) ⏟ codebook entropy \mathcal{L} = \underbrace{\lambda_{RGB}\mathcal{L}{RGB} + \lambda{perc}\mathcal{L}{perc}}{\text{re-rendering}} + \underbrace{\lambda_{occ}\mathcal{L}{occ}}{\text{occupancy}} + \underbrace{\lambda_{LFQ}\text{softplus}(\mathcal{L}{LFQ} + 5)}{\text{codebook entropy}} L=re-rendering λRGBLRGB+λpercLperc+occupancy λoccLocc+codebook entropy λLFQsoftplus(LLFQ+5)
3. 潜在3D网格的自回归建模
3D网格序列化 (3D Grid Serialization ):模型采用固定的 x y z xyz xyz 遍历顺序将3D结构线性化为1D序列。为了控制序列长度,模型在场景的数据块(Chunks)上运行,每个体素被分配相对于当前数据块的相对位置索引,而非绝对位置。
词汇表设计 (Vocabulary Design ):模型为位置(Position)和特征(Feature)Token使用独立的词汇表,并交替进行预测。位置头预测下一个被占用的体素索引,特征头预测前一个位置的特征。这种设计解耦了几何结构与外观建模的相互干扰。
4. 3D旋转位置编码与网络架构
3D旋转位置编码 (3D RoPE ):由于序列化后的1D序列无法真实反映3D空间邻近性,模型将实际的体素坐标注入注意力机制中,引入了3D RoPE。模型还为旋转嵌入扩展了第4个维度,用于指示Token类型(位置或特征),以进一步分离几何与外观信息。
Transformer架构:采用基于GPT-2的 Decoder-only 因果Transformer架构。
自回归目标函数 :给定标记化的场景序列 t = ( t 1 , ... , t T ) \mathbf{t} = (t_1, \dots, t_T) t=(t1,...,tT),模型通过标准自回归交叉熵损失进行教师强制(Teacher forcing)训练: L C E = − ∑ i = 1 T log p θ ( t i ∣ t < i ) \mathcal{L}{CE} = - \sum{i=1}^{T} \log p_{\theta}(t_i \mid t_{<i}) LCE=−i=1∑Tlogpθ(ti∣t<i)
5. 场景生成与补全
在推理阶段,场景从序列起始(BOS)Token开始,交替预测位置和特征Token,直到生成序列结束(EOS)Token。这种自回归公式允许模型在给定部分场景(作为前缀提示)的情况下,自然地推断缺失的几何形状和外观,从而实现场景补全和超出现有数据块大小的大规模场景外扩(Outpainting)。
实验
数据 。为了增加3D-FRONT数据集 的数据多样性,采用了旋转和翻转的数据增强方法,数据集规模扩大8倍。此外,为了进行大规模场景建模,研究还使用了来自Aria Synthetic Environments (ASE) 的高斯场景,该数据集包含25,000个具有多样化布局、物体排列和外观的室内场景。
实验设置:
- 自编码器 :场景自编码器的基础体素大小为 0.025 m 0.025\text{m} 0.025m ,经过三次下采样后,潜在网格的体素大小变为 20 cm 20\text{cm} 20cm。 对于物体(Objects),形状在 128 3 128^3 1283 的网格上离散化,并进行两次下采样以匹配先前的研究。 场景不建立视角相关(View-dependent)的外观模型,而物体则使用一阶球谐函数(Spherical harmonics)。 所有实验中的码本(Codebook)大小固定为4,096。 损失权重设置:场景的重渲染损失中 λ R G B = 7.5 \lambda_{RGB} = 7.5 λRGB=7.5, λ p e r c = 0.3 \lambda_{perc} = 0.3 λperc=0.3(使用12张图像);物体的重渲染损失中 λ R G B = 12.5 \lambda_{RGB} = 12.5 λRGB=12.5, λ p e r c = 0.1 \lambda_{perc} = 0.1 λperc=0.1(使用4张图像);占用率损失 λ o c c = 1.0 \lambda_{occ} = 1.0 λocc=1.0,LFQ损失 λ L F Q = 0.1 \lambda_{LFQ} = 0.1 λLFQ=0.1。
- Transformer配置 :场景建模使用GPT-2中型(Medium)Transformer,上下文窗口(Context window)为16,384个Token ,足以覆盖完全占用的数据块。 物体生成使用GPT-2小型(Small)Transformer,上下文窗口为8,192个Token 。 所有结果均使用 0.9 0.9 0.9 的温度(Temperature)和 p = 0.9 p = 0.9 p=0.9 的核采样(Nucleus Sampling)生成。
- 训练策略 :场景训练在具有固定垂直位置的空间数据块(Spatial chunks)上进行,以对齐不同场景的数据集中的地板高度。训练期间会根据最低占用阈值随机采样数据块位置。 ASE场景的自编码器训练监督信号来自渲染的真实(Ground-truth)高斯,而3D-FRONT场景则使用之前渲染的图像进行监督。 物体实验中,自编码器和Transformer都在完整的形状上进行训练,不使用分块。 优化与计算 (Optimization and Compute):自编码器使用Adam优化器进行训练,学习率为 10 − 4 10^{-4} 10−4。 Transformer使用AdamW和Muon的组合进行训练。 两种模型均采用余弦学习率衰减(Cosine learning rate decay),最终衰减至初始值的10%。 硬件配置:自编码器在4块RTX A6000 GPU上训练(场景有效批次大小为8,物体为24);Transformer在4块GH200 GPU上训练(有效批次大小为64)
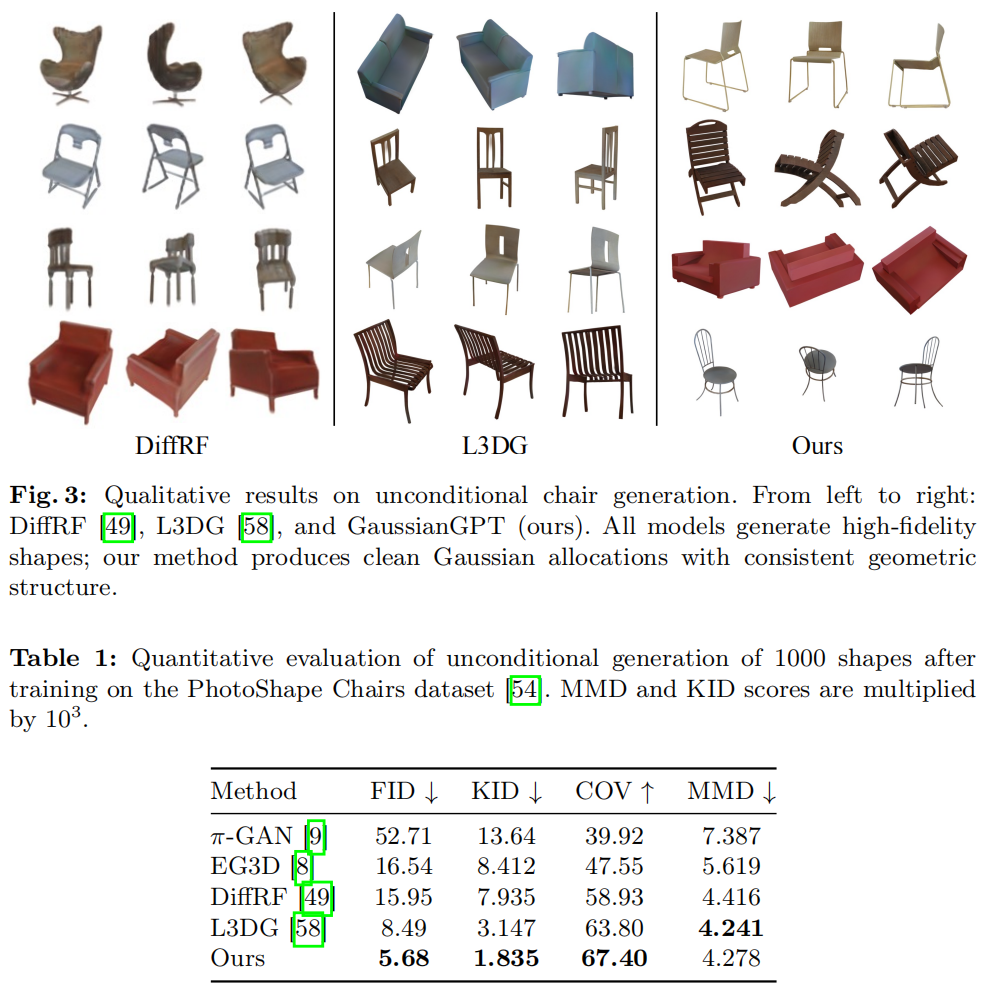
形状合成 (Shape Synthesis) :在PhotoShape数据集上的无条件椅子生成任务中,GaussianGPT在多项指标上表现优异。渲染质量通过在 128 × 128 128 \times 128 128×128 图像上计算的FID和KID进行评估,几何质量则通过从生成高斯中提取的网格表面点计算的覆盖率(COV)和最小匹配距离(MMD)进行评估。
定量评估结果:GaussianGPT在FID(5.68)、KID(1.835)和COV(67.40)指标上均取得了最佳成绩,超越了 π \pi π-GAN、EG3D、DiffRF和L3DG,同时在MMD(4.278)上保持了极强的竞争力,表明其生成结果在外观和几何形状上均与目标分布高度对齐。
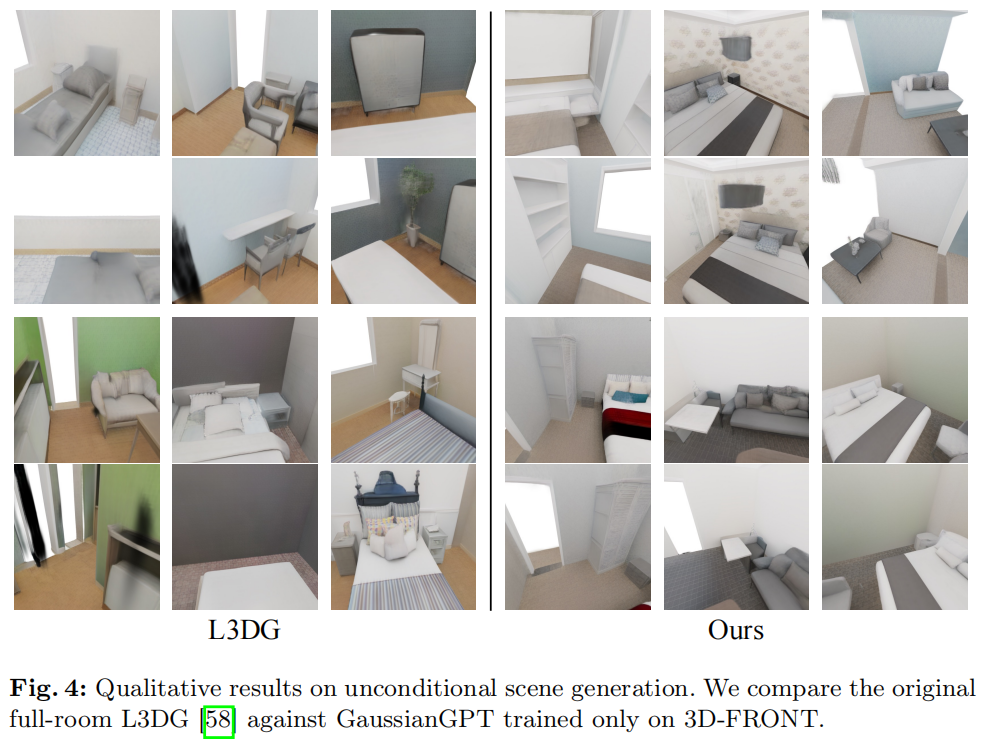
定性评估结果:与DiffRF和L3DG相比,GaussianGPT能够生成具有一致几何结构的清晰高斯分配,生成的高保真形状在视觉上更加整洁且结构合理。