综述:看了很多,总的来说,不利用外部信息的都基本比较扯淡。
Adaptive Rollout Allocation for Online Reinforcement Learning with Verifiable Rewards
链接:https://arxiv.org/pdf/2602.01601
本文的核心理论即我们到底选择哪些样本去学习,DAPO的逻辑是把全对全错的去掉,但是这个属于先rollout再评价好坏;本文提出可以事先根据query进行预测答对的概率。本文先证明了一个重要的前提,答对概率越接近50%的题目越具有信息量,优先采样这部分会对训练更有效。
为此,本文设计了一个非常巧妙的纯数学计算的方法,动态的维护题目答对的可能性。已经答过的题的答对概率被更新,未答过的题通过query的embedding被以相似性的方式更新。
核心公式:
mt,Btc⋆=mt,Btc+ΣBtcBtΣBtBt−1(g^Bt−mt,Bt)m^\star_{t,B_t^c} = m_{t,B_t^c} + \Sigma_{B_t^c B_t} \Sigma_{B_t B_t}^{-1} (\hat{g}{B_t} - m{t,B_t})mt,Btc⋆=mt,Btc+ΣBtcBtΣBtBt−1(g^Bt−mt,Bt)
当前batch的观测和真实的差值衡量这一batch的残差,然后乘自协方差矩阵的逆消除这一轮问题重复性的影响,最后乘跨组的协方差矩阵度量未采样题目和已采样题目的相似性。
接下来就是如何根据概率分配采样次数,根据概率计算个体的危险系数,按照数学公式计算出来分配给概率接近0.5的更多,远离0.5的更少的权重。这个具体可以看论文的公式,比较复杂。
Attention as a Compass: Efficient Exploration for Process-Supervised RL in Reasoning Models
链接:https://arxiv.org/pdf/2509.26628
本文还是在采样的角度着手,首先提出了一个FCI指标,即某个token被后续token注意的程度来衡量这个token的重要性。去掉这些FCI高的20%token的注意力设为0比高熵token和后80%的token对结果影响大的多,也就是模型是否确定的指标不如模型反复参考的信息重要。此外对早期的注意力置0的影响更大。
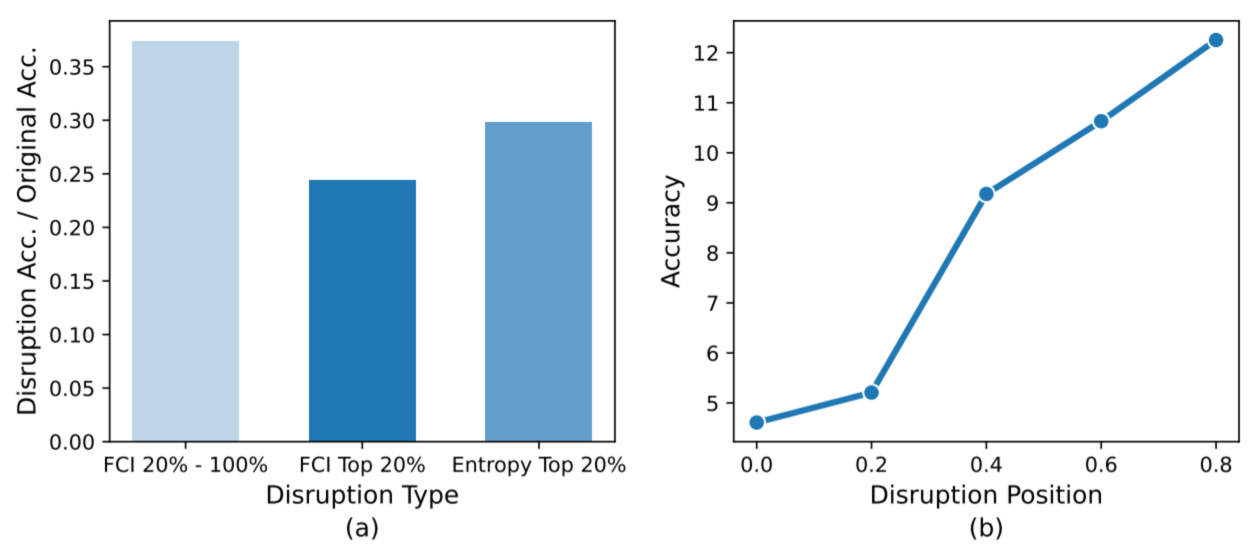
这个图说明了FCI高的token重要,且早期出问题影响更大。
第一个问题是筛选什么样的题。
得到FCI指标后,对题目计算平均FCI可以反映这个题目的一个水平。
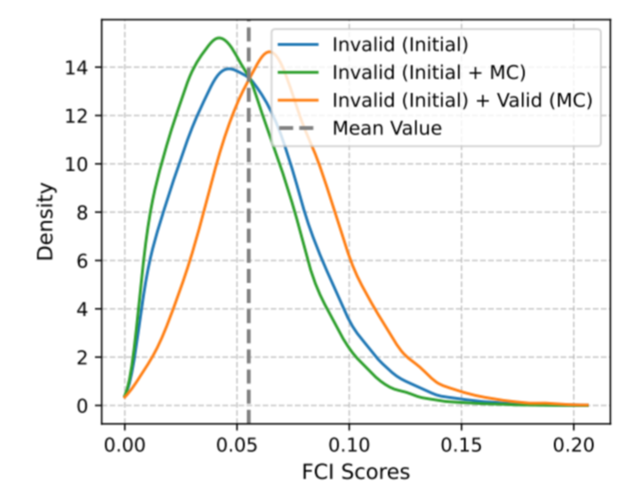
论文设计了一个实验,我们从这个实验中能知道题目维度怎么筛选。
第二个问题是针对不同难度采样的设计,根据正确性进行调整。
首先是让大模型采样多次,计算出来正确性,然后进行MC采样。MC采样会对难题多采,简单题少采,如下公式修正MC采样系数。MC采样是在FCI前20%的step进行采样。
第三步是batch训练时,如何保证GPU利用率?优势值为0的这些垃圾题目比较多话,GPU吃不够,训练低效。因此文章设计了一个动态的机制来处理每一次采样的题目数量。
Bm=Round(λBm−1+(1−λ)B′B′′Bm−1)B_m = \text{Round}\left(\lambda B_{m-1} + (1 - \lambda) \frac{B'}{B''} B_{m-1}\right)Bm=Round(λBm−1+(1−λ)B′′B′Bm−1)
Count Counts: Motivating Exploration in LLM Reasoning with Count-based Intrinsic Rewards
链接:https://arxiv.org/pdf/2510.16614
本文的核心逻辑是除了正确性之外加上新颖程度这个指标来评价回答好坏,增加模型的探索性。对于难样本而言,std=0 加上探索的优势依然能产生差距。
(1)硬币投掷网络
一枚硬币正+1,负-1,随机 n 次,由于每一次采样都是独立的,其均值 znz_nzn 的二阶矩(Second Moment,即样本均值的方差)满足以下雷打不动的物理铁律:M2(zn)=Ezn2=Vzn=V1n∑i=1nXi=1n2∑i=1nVXi=1n2⋅(n⋅1)=1nM_2(z_n) = \mathbb{E}z_n\^2 = \mathbb{V}z_n = \mathbb{V}\left \\frac{1}{n} \\sum_{i=1}\^n X_i \\right = \frac{1}{n^2} \sum_{i=1}^n \mathbb{V}X_i = \frac{1}{n^2} \cdot (n \cdot 1) = \frac{1}{n}M2(zn)=Ezn2=Vzn=Vn1∑i=1nXi=n21∑i=1nVXi=n21⋅(n⋅1)=n1
(2)CFN 网络
先将 token 序列通过一个 text-embedding,然后随机采样 d 维的硬币投掷向量作为 token 序列的监督标签,最小化均方误差作为损失函数。由于模型参数有限,相似输入对应多个冲突的输出标签,模型做出的数学最优解就是输出这些标签的均值。这样就实现了对状态的计数。网络对于状态计算出来的这个值的模长就能代表新颖程度。
(3)探索奖励
归一化后的模长进行开平方根处理,并加上天花板截断限制,
得到第 ttt 个 Token 的最终局部认知不确定性(即每个 Token 位置的新颖度奖励):u^t=min(umax,1d∥fϕ(st)∥2)=min(umax,1d∥fϕ(st)∥)\hat{u}t = \min \left( u{max}, \sqrt{\frac{1}{d} \|f_\phi(s_t)\|^2} \right) = \min \left( u_{max}, \frac{1}{\sqrt{d}} \|f_\phi(s_t)\| \right)u^t=min(umax,d1∥fϕ(st)∥2 )=min(umax,d 1∥fϕ(st)∥)
(4)句子的不确定性
考虑时间序列加权时的完整展开形式应该写为:B=1l∑i∈I(γl−i⋅1d∥fϕ(sihidden)∥2)B = \sqrt{\frac{1}{l} \sum_{i \in I} \left( \gamma^{l - i} \cdot \frac{1}{d} \|f_\phi(s_i^{hidden})\|^2 \right)}B=l1∑i∈I(γl−i⋅d1∥fϕ(sihidden)∥2)
消除不同的题目之间新颖程度差别,类似于 grpo ,需要进行群体的 z-score 归一化。
(5)最终优势
主线任务得分记为 A^iold\hat{A}_i^{old}A^iold,把探索分记为 γA^iexploration\gamma \hat{A}_i^{exploration}γA^iexploration,然后用分段函数进行强行压制:A^inew={min(A^iold+γA^iexploration,(1+α)A^iold),如果 A^iold≥0min(A^iold+γA^iexploration,(1−α)A^iold),如果 A^iold<0\hat{A}_i^{new} = \begin{cases} \min \left( \hat{A}_i^{old} + \gamma \hat{A}_i^{exploration}, \mathbf{(1 + \alpha) \hat{A}_i^{old}} \right), & \text{如果} \; \hat{A}_i^{old} \ge 0 \\ \min \left( \hat{A}_i^{old} + \gamma \hat{A}_i^{exploration}, \mathbf{(1 - \alpha) \hat{A}_i^{old}} \right), & \text{如果} \; \hat{A}_i^{old} < 0 \end{cases}A^inew=⎩ ⎨ ⎧min(A^iold+γA^iexploration,(1+α)A^iold),min(A^iold+γA^iexploration,(1−α)A^iold),如果A^iold≥0如果A^iold<0