Linux库的底层原理:ELF文件格式、静态链接、程序加载、虚拟地址空间与GOT/PLT详解
🔥 星恒随风: 个人主页 ❄️ 个人专栏: 《指针合集》 | 《C语言基础》 | 《数据结构》 | 《机器学习导论》 | 《前端基础》 | 《python基础》 | 《C++从入门到入土》 | 《Linux的学习之旅》 ✨ 数据即知识,压缩即智能
文章目录
- Linux库的底层原理:ELF文件格式、静态链接、程序加载、虚拟地址空间与GOT/PLT详解
- 一、重新理解程序的编译与链接
-
- [1.1 编译和链接并不是同一个过程](#1.1 编译和链接并不是同一个过程)
- [1.2 为什么需要单独的链接阶段?](#1.2 为什么需要单独的链接阶段?)
- 二、目标文件.o是什么?
-
- [2.1 分别编译两个源文件](#2.1 分别编译两个源文件)
- [2.2 使用file查看目标文件](#2.2 使用file查看目标文件)
- [2.3 为什么.o还不能直接运行?](#2.3 为什么.o还不能直接运行?)
- 三、ELF究竟是什么?
-
- [3.1 ELF的基本概念](#3.1 ELF的基本概念)
- [3.2 ELF文件的宏观布局](#3.2 ELF文件的宏观布局)
- [四、ELF Header:操作系统怎样识别一个ELF文件?](#四、ELF Header:操作系统怎样识别一个ELF文件?)
-
- [4.1 为什么文件需要头部?](#4.1 为什么文件需要头部?)
- [4.2 使用readelf查看ELF头部](#4.2 使用readelf查看ELF头部)
-
- [4.2.1 Magic](#4.2.1 Magic)
- [4.2.2 Class](#4.2.2 Class)
- [4.2.3 Type](#4.2.3 Type)
- [4.2.4 Machine](#4.2.4 Machine)
- [4.2.5 Entry Point](#4.2.5 Entry Point)
- 五、Section:从链接视角理解ELF
-
- [5.1 Section是什么?](#5.1 Section是什么?)
- [5.2 .text:代码节](#5.2 .text:代码节)
- [5.3 .rodata:只读数据节](#5.3 .rodata:只读数据节)
- [5.4 .data:已初始化的可写数据](#5.4 .data:已初始化的可写数据)
- [5.5 .bss:未初始化或零初始化数据](#5.5 .bss:未初始化或零初始化数据)
- [5.6 .symtab:符号表](#5.6 .symtab:符号表)
- [5.7 .dynsym与.symtab有什么区别?](#5.7 .dynsym与.symtab有什么区别?)
- 六、静态链接的核心:符号解析
-
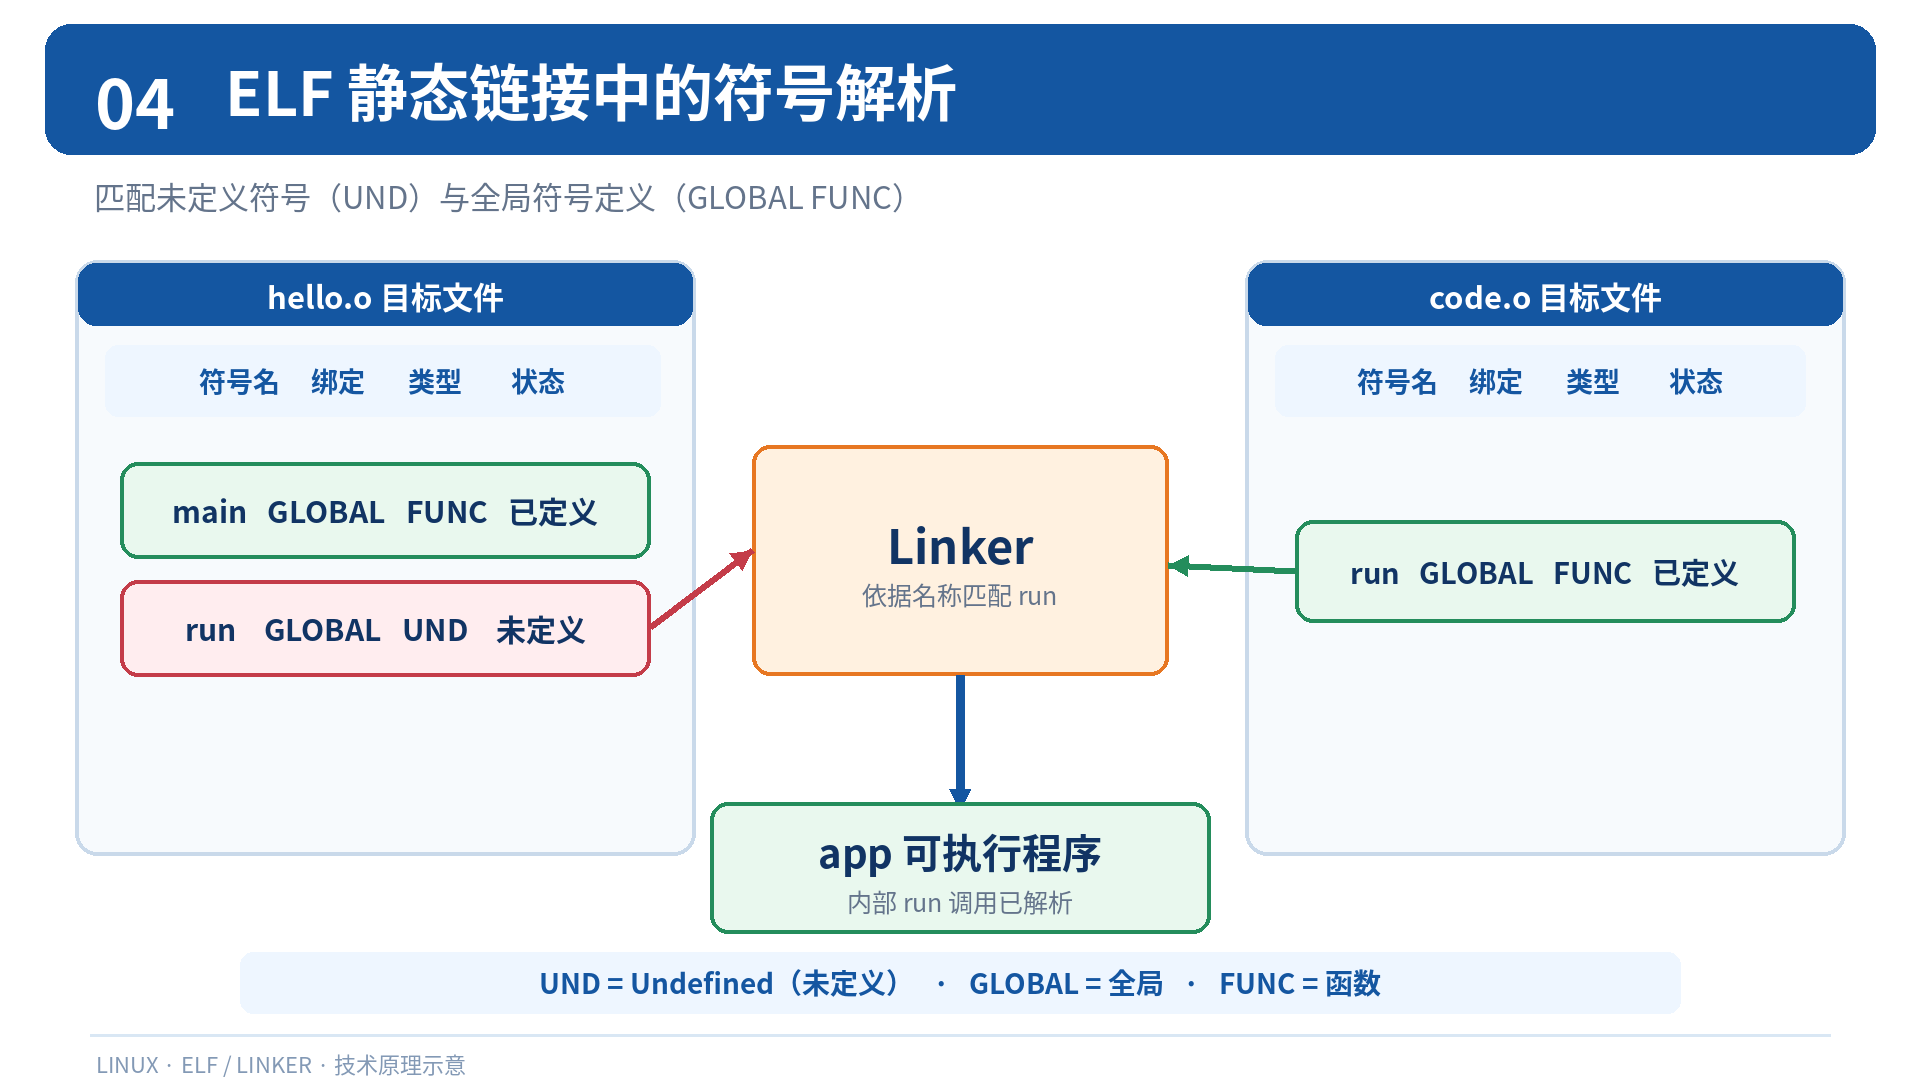
- [6.1 为什么hello.o不知道run在哪里?](#6.1 为什么hello.o不知道run在哪里?)
- [6.2 使用readelf观察未定义符号](#6.2 使用readelf观察未定义符号)
- [6.3 查看code.o](#6.3 查看code.o)
- [6.4 将两个目标文件链接起来](#6.4 将两个目标文件链接起来)
- 七、仅仅找到函数还不够:地址重定位
-
- [7.1 为什么需要重定位?](#7.1 为什么需要重定位?)
- [7.2 查看目标文件中的重定位信息](#7.2 查看目标文件中的重定位信息)
- [7.3 链接器怎样完成地址修正?](#7.3 链接器怎样完成地址修正?)
- [7.4 静态链接不只是简单拼接](#7.4 静态链接不只是简单拼接)
- 八、Segment:从执行视角理解ELF
-
- [8.1 为什么已经有Section,还需要Segment?](#8.1 为什么已经有Section,还需要Segment?)
- [8.2 Section和Segment的区别](#8.2 Section和Segment的区别)
- [8.3 使用readelf观察Section和Segment](#8.3 使用readelf观察Section和Segment)
- [8.4 Section如何组织到Segment中?](#8.4 Section如何组织到Segment中?)
- [九、理解Program Header Table](#九、理解Program Header Table)
-
- [9.1 为什么程序头表如此重要?](#9.1 为什么程序头表如此重要?)
- [9.2 PT_LOAD包含哪些重要字段?](#9.2 PT_LOAD包含哪些重要字段?)
-
- [9.2.1 p_offset](#9.2.1 p_offset)
- [9.2.2 p_vaddr](#9.2.2 p_vaddr)
- [9.2.3 p_filesz](#9.2.3 p_filesz)
- [9.2.4 p_memsz](#9.2.4 p_memsz)
- [9.2.5 p_flags](#9.2.5 p_flags)
- [9.3 为什么Section Header Table不等于Program Header Table?](#9.3 为什么Section Header Table不等于Program Header Table?)
- 十、现代可执行文件为什么可能是ET_DYN?
-
- [10.1 实际观察](#10.1 实际观察)
- [10.2 为什么需要PIE?](#10.2 为什么需要PIE?)
- [10.3 怎样生成传统ET_EXEC?](#10.3 怎样生成传统ET_EXEC?)
- 十一、程序加载:从ELF文件到进程地址空间
-
- [11.1 ELF在磁盘上时有没有地址?](#11.1 ELF在磁盘上时有没有地址?)
- [11.2 execve与ELF加载的关系](#11.2 execve与ELF加载的关系)
- [11.3 虚拟地址空间是如何建立的?](#11.3 虚拟地址空间是如何建立的?)
- 十二、动态链接:为什么程序能调用动态库?
-
- [12.1 从第一篇的例子开始](#12.1 从第一篇的例子开始)
- [12.2 如何查看程序依赖了哪些动态库?](#12.2 如何查看程序依赖了哪些动态库?)
- [12.3 动态加载器是谁?](#12.3 动态加载器是谁?)
- [12.4 先运行动态加载器,再进入程序入口](#12.4 先运行动态加载器,再进入程序入口)
- 十三、为什么多个进程可以共享动态库?
-
- [13.1 静态链接与动态链接的内存关系](#13.1 静态链接与动态链接的内存关系)
- [13.2 共享的是虚拟地址吗?](#13.2 共享的是虚拟地址吗?)
- [13.3 为什么数据不能全部共享?](#13.3 为什么数据不能全部共享?)
- 十四、PIC:为什么动态库不需要固定加载地址?
-
- [14.1 动态库加载位置可能变化](#14.1 动态库加载位置可能变化)
- [14.2 相对寻址的基本思想](#14.2 相对寻址的基本思想)
- 十五、GOT:全局偏移表
-
- [15.1 为什么需要GOT?](#15.1 为什么需要GOT?)
- [15.2 GOT的基本作用](#15.2 GOT的基本作用)
- [15.3 为什么GOT适合与PIC配合?](#15.3 为什么GOT适合与PIC配合?)
- [15.4 如何查看GOT?](#15.4 如何查看GOT?)
- 十六、PLT:过程链接表
-
- [16.1 PLT是什么?](#16.1 PLT是什么?)
- [16.2 PLT和GOT是什么关系?](#16.2 PLT和GOT是什么关系?)
- [16.3 什么是延迟绑定?](#16.3 什么是延迟绑定?)
- [16.4 如何观察PLT?](#16.4 如何观察PLT?)
- 十七、从程序启动到调用动态库:完整流程
-
- [17.1 第一阶段:构建程序](#17.1 第一阶段:构建程序)
- [17.2 第二阶段:内核加载程序](#17.2 第二阶段:内核加载程序)
- [17.3 第三阶段:动态加载器处理依赖](#17.3 第三阶段:动态加载器处理依赖)
- [17.4 第四阶段:进入程序入口](#17.4 第四阶段:进入程序入口)
- [17.5 第五阶段:调用库函数](#17.5 第五阶段:调用库函数)
- 十八、Linux中常用的ELF分析工具
-
- [18.1 建议的一组实验命令](#18.1 建议的一组实验命令)
- 十九、深入实验:动态加载器如何查找共享库?
- 二十、链接和加载有什么根本区别?
-
- [20.1 链接主要做什么?](#20.1 链接主要做什么?)
- [20.2 加载主要做什么?](#20.2 加载主要做什么?)
- [20.3 为什么不能将二者混为一谈?](#20.3 为什么不能将二者混为一谈?)
- 二十一、常见误区总结
-
- [21.1 .o文件已经包含机器代码,所以可以直接执行?](#21.1 .o文件已经包含机器代码,所以可以直接执行?)
- [21.2 链接就是把多个.o直接拼接在一起?](#21.2 链接就是把多个.o直接拼接在一起?)
- [21.3 ET_DYN一定是动态库?](#21.3 ET_DYN一定是动态库?)
- [21.4 所有Section都要装载到内存?](#21.4 所有Section都要装载到内存?)
- [21.5 ELF加载时会立即把所有内容读入物理内存?](#21.5 ELF加载时会立即把所有内容读入物理内存?)
- [21.6 两个进程使用同一个.so,就拥有相同虚拟地址?](#21.6 两个进程使用同一个.so,就拥有相同虚拟地址?)
- [21.7 PIC就是代码里完全没有任何地址?](#21.7 PIC就是代码里完全没有任何地址?)
- [21.8 GOT始终是可以修改的?](#21.8 GOT始终是可以修改的?)
- [21.9 动态函数调用一定先进入PLT?](#21.9 动态函数调用一定先进入PLT?)
- [21.10 所有外部函数都会在第一次调用时才解析?](#21.10 所有外部函数都会在第一次调用时才解析?)
- 二十二、完整知识体系总结
- 总结
前言:我们已经会制作库,但库到底是如何工作的?
在上一篇文章中,我们已经掌握了静态库和动态库的制作与使用。
对于静态库:
bash
ar rcs libmystdio.a my_stdio.o my_string.o对于动态库:
bash
gcc -shared -o libmystdio.so my_stdio_pic.o my_string_pic.o还学习了通过:
bash
gcc main.c -L. -lmystdio完成链接。
但是,如果只掌握这些命令,我们还不能真正理解链接器和操作系统到底完成了什么。
例如:
- 为什么分别编译的两个
.o文件能够调用彼此的函数? - 链接器如何知道某个函数的机器指令位于哪里?
- 为什么
.o、.so和可执行文件都可以采用 ELF 格式? - 程序尚未运行时,为什么 ELF 文件中已经存在虚拟地址?
- 操作系统执行
execve()时,究竟怎样把 ELF 文件装载到进程地址空间? - 动态库加载位置不固定,程序为什么仍然能够正确调用其中的函数?
- GOT、PLT、PIC 分别是什么?它们之间又有什么关系?
这些问题构成了 Linux 程序链接与加载的核心知识体系。
本篇文章将以 ELF 文件为主线,从两个 .o 文件的静态链接开始,逐步分析可执行文件的生成、装载,以及动态库在进程地址空间中的工作原理。
需要说明:下面的实验主要使用 Linux x86-64、GCC、GNU binutils 和 ELF。部分动态链接细节与编译器选项、架构及链接器实现有关。
一、重新理解程序的编译与链接
1.1 编译和链接并不是同一个过程
在日常开发中,我们经常执行:
bash
gcc main.c -o main表面上看,只需要一条命令就能生成可执行文件。
但 GCC 实际上会协调多个工具完成不同工作。
可以概念化为:
text
C源代码
   |
   v
预处理
   |
   v
编译
   |
   v
汇编
   |
   v
目标文件.o
   |
   v
链接
   |
   v
可执行文件
其中,前面的阶段负责将源代码翻译为机器代码及相关信息。
链接阶段则需要将多个目标文件与所需库组合起来,完成符号解析和地址重定位等工作。
1.2 为什么需要单独的链接阶段?
假设一个项目有两个源文件。
hello.c:
c
#include <stdio.h>

void run(void);

int main(void)
{
    puts("hello world");

    run();

    return 0;
}code.c:
c
#include <stdio.h>

void run(void)
{
    puts("running...");
}
其中:
c
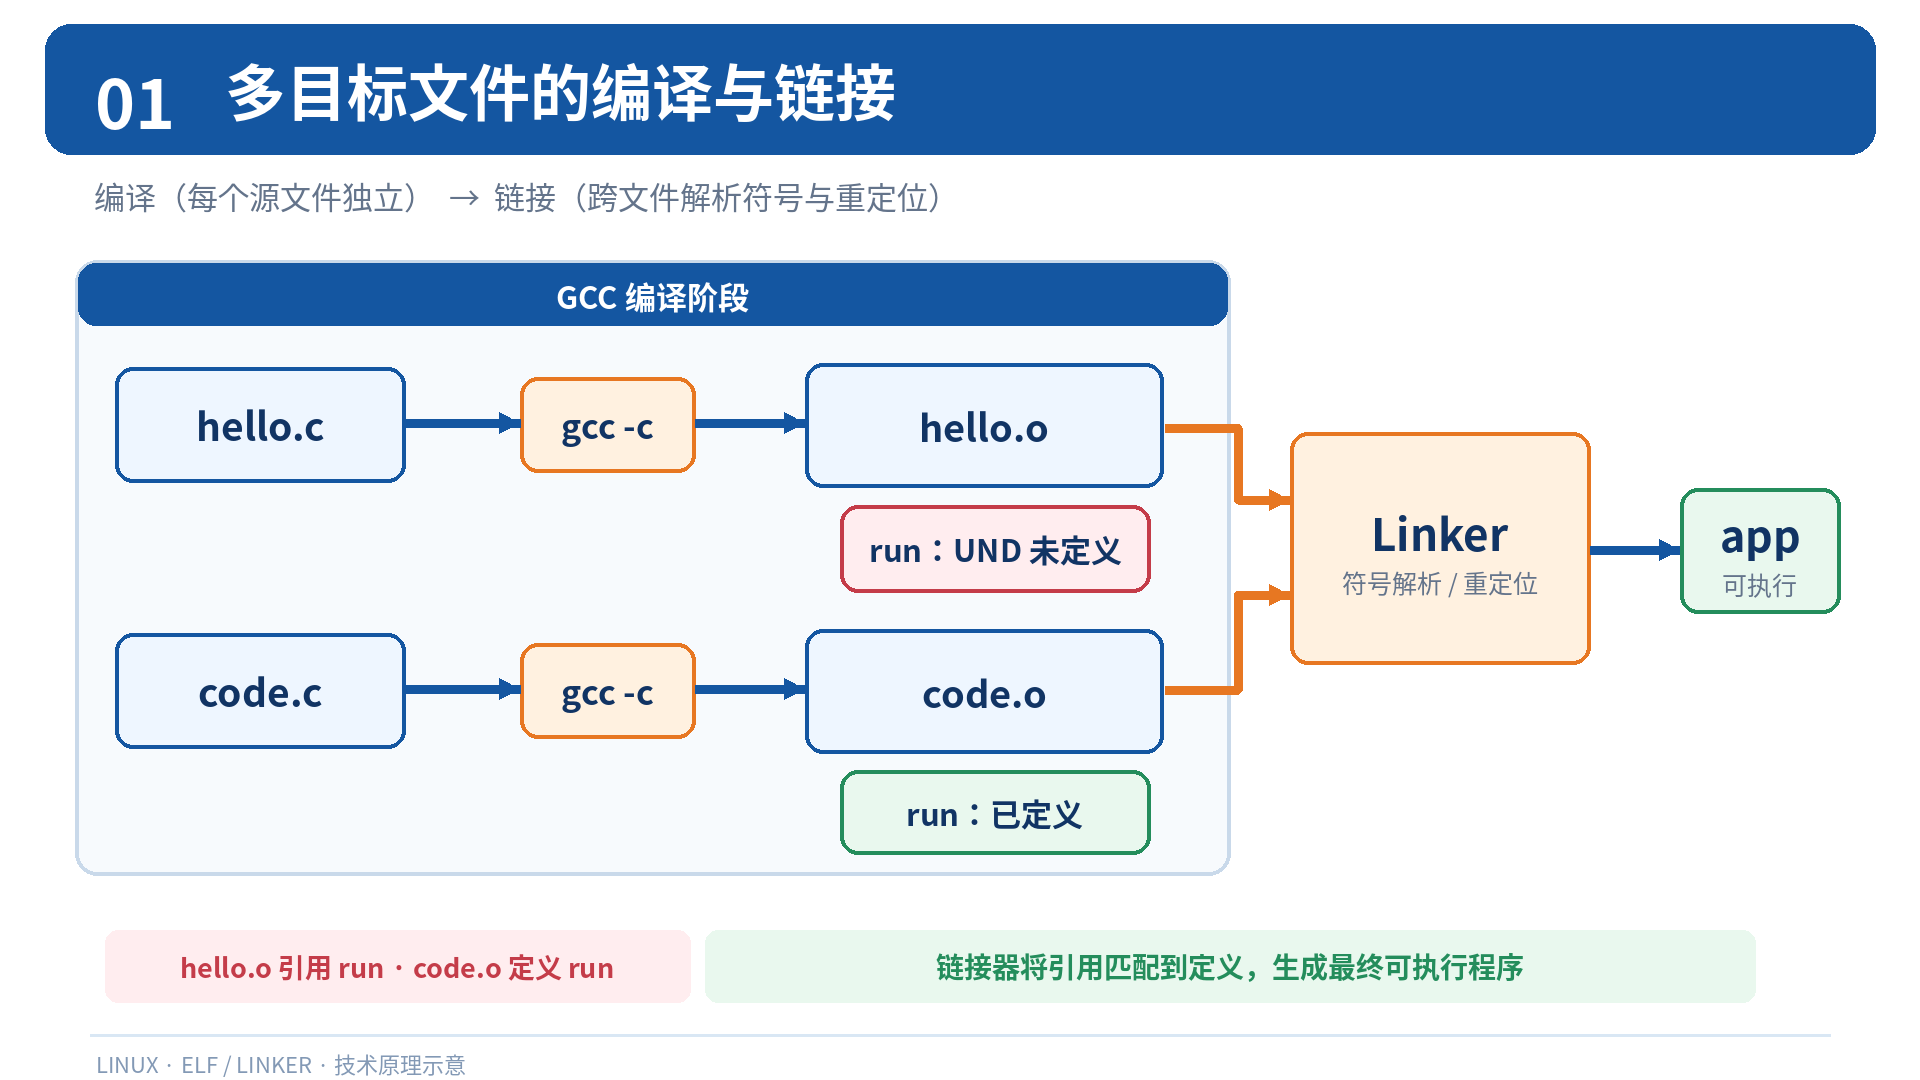
run();在 hello.c 中被调用,但实际定义在 code.c 中。
如果只编译 hello.c:
bash
gcc -c hello.c -o hello.o编译器可以根据声明知道:
c
void run(void);这个函数应该怎样被调用。
但是编译器还不知道它最终会位于可执行程序的哪个地址。
因此,编译完成后,hello.o 中仍然需要记录:
text
我需要一个名叫run的函数而 code.o 中则保存:
text
我定义了一个名叫run的函数链接器负责将二者对应起来。
二、目标文件.o是什么?
2.1 分别编译两个源文件
执行:
bash
gcc -O0 -c hello.c -o hello.o
gcc -O0 -c code.c -o code.o
其中:
bash
-O0表示关闭常规优化,便于观察生成的目标代码。
现在目录中包含:
text
hello.c
hello.o
code.c
code.o
2.2 使用file查看目标文件
执行:
bash
file hello.o在 Linux x86-64 上,可能看到:
text
ELF 64-bit LSB relocatable, x86-64重点关注:
text
ELF与:
text
relocatable其中:
text
ELF代表目标文件采用 ELF 格式。
而:
text
relocatable意味着它是可重定位目标文件,适合进一步参与链接。
2.3 为什么.o还不能直接运行?
因为 .o 通常还不是完整的可执行程序。
例如:
text
hello.o
   |
   +-- 定义main
   |
   +-- 调用run
   |
   +-- 调用puts
其中:
text
run的定义在另一个目标文件中。
而:
text
puts由相应的 C 标准库实现提供。
在最终链接之前,这些外部符号尚未完成全部解析。
因此:
目标文件已经包含机器代码,但还不等于一个能够独立启动的完整程序。
三、ELF究竟是什么?
3.1 ELF的基本概念
ELF 全称:
text
Executable and Linkable Format即:
text
可执行与可链接文件格式它是 Linux 中广泛使用的一种二进制文件格式。
ELF 不仅用于可执行程序,也用于目标文件与共享对象。
常见类型如下:
| ELF类型 | 含义 | 常见示例 |
|---|---|---|
ET_REL |
可重定位目标文件 | hello.o |
ET_EXEC |
传统可执行文件 | 非 PIE 可执行程序 |
ET_DYN |
共享对象或位置无关可执行文件 | libxxx.so、PIE程序 |
ET_CORE |
Core Dump 文件 | 进程异常转储文件 |
这里有一个非常重要的细节:
在现代 Linux 中,可执行程序不一定显示为 ET_EXEC。
启用 PIE(Position Independent Executable)的程序通常采用:
text
ET_DYN因此不能简单地认为:
text
ET_DYN = 动态库3.2 ELF文件的宏观布局
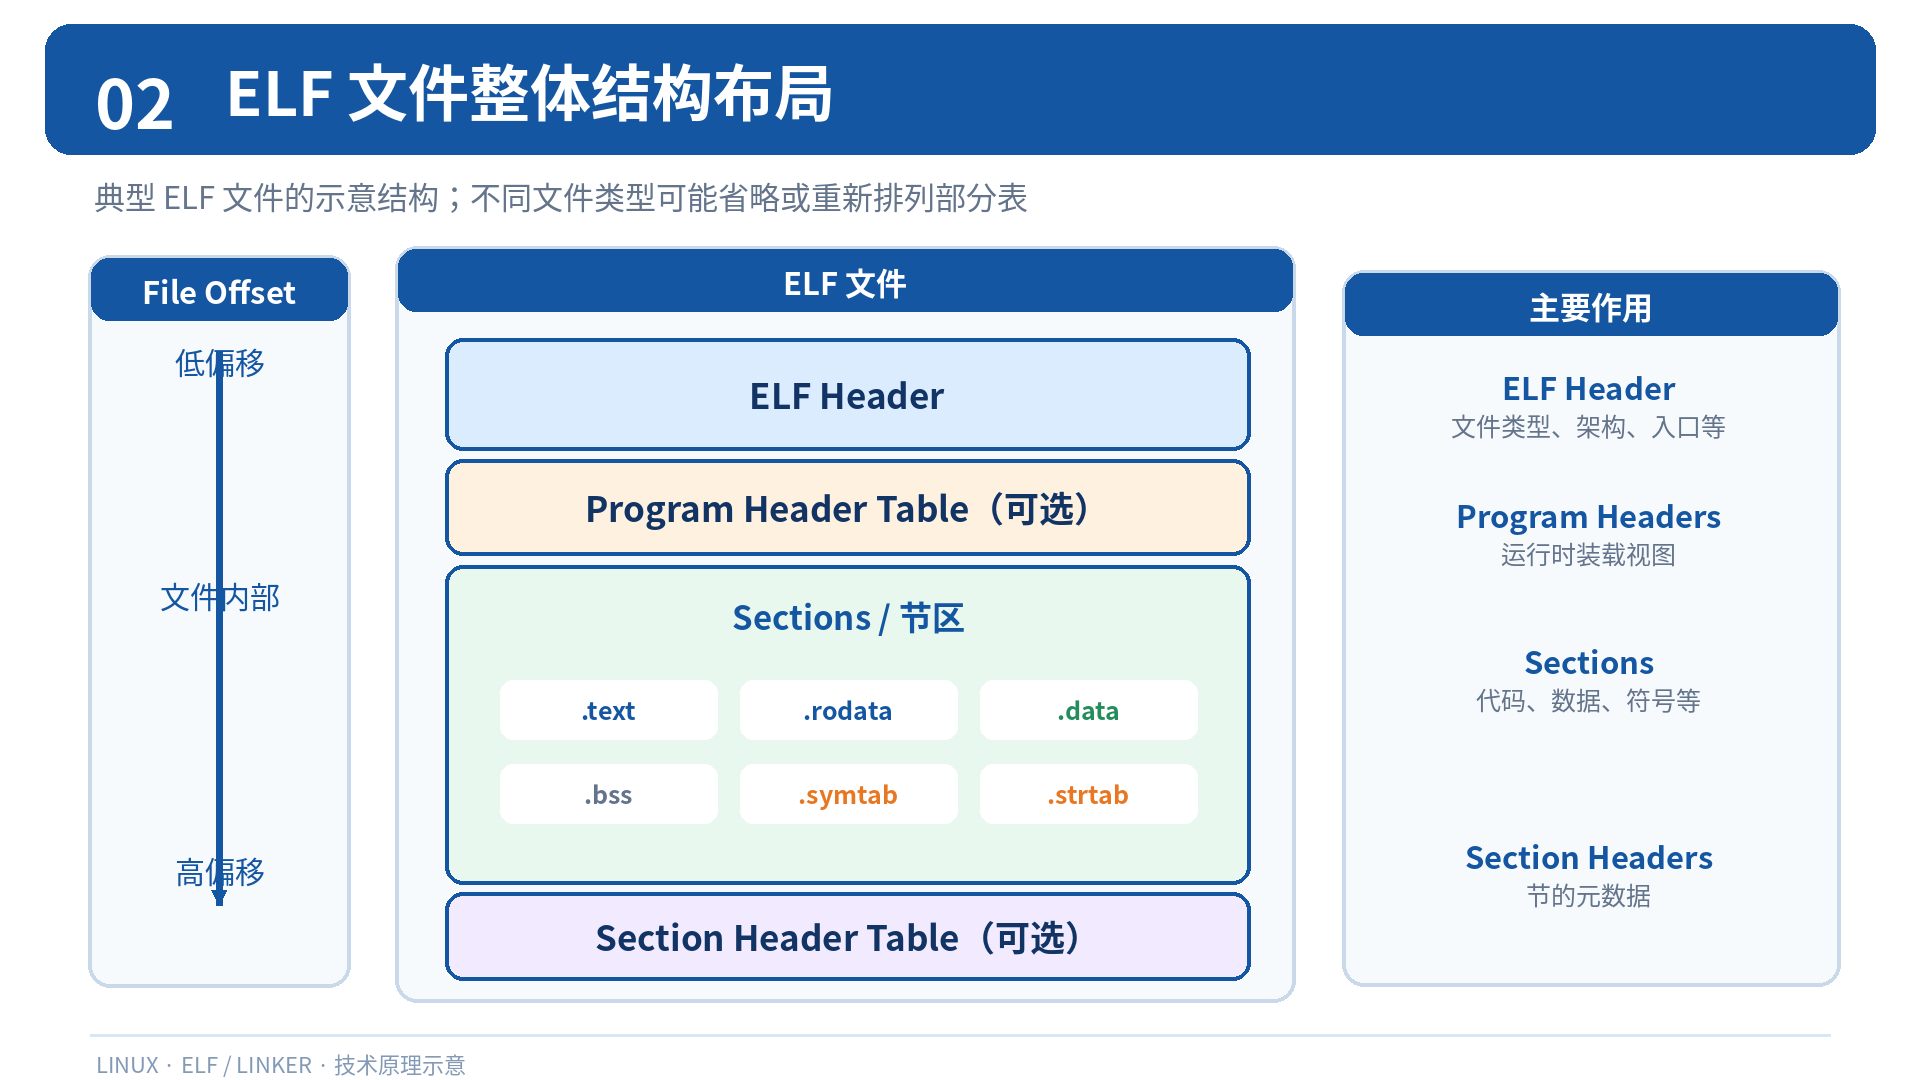
一个典型 ELF 文件可以包含:
- ELF Header。
- Program Header Table。
- Section。
- Section Header Table。
这些结构主要从两个角度描述 ELF 文件:
链接视角: 关注 Section(节)。
执行视角: 关注 Segment(段)。
需要注意,并非每一种 ELF 文件都必须同时具备所有这些表。例如,部分可重定位目标文件通常没有用于装载的程序头表。
四、ELF Header:操作系统怎样识别一个ELF文件?
4.1 为什么文件需要头部?
假设操作系统准备执行某个程序。
它首先需要知道:
text
这个文件是什么格式?
是32位还是64位?
适用于什么处理器?
入口地址是什么?
程序头表在文件的什么位置?
这些重要信息通常保存在 ELF Header 中。
因此:
ELF Header 是解释 ELF 文件其他结构的入口。
4.2 使用readelf查看ELF头部
执行:
bash
readelf -h hello.o可以看到类似:
text
ELF Header:
  Magic: ...
  Class: ELF64
  Data: 2's complement, little endian
  Type: REL (Relocatable file)
  Machine: Advanced Micro Devices X86-64
  Entry point address: 0x0
  Start of program headers: ...
  Start of section headers: ...
其中几个字段值得重点理解。
4.2.1 Magic
通常以:
text
7f 45 4c 46开头。
其中后面三个字节对应:
text
ELF这是 ELF 文件的重要标识。
4.2.2 Class
例如:
text
ELF64表示采用 64 位 ELF 格式。
4.2.3 Type
对于:
text
hello.o通常是:
text
REL表示可重定位目标文件。
4.2.4 Machine
表示目标处理器架构。
例如:
text
Advanced Micro Devices X86-64对应 x86-64 架构。
4.2.5 Entry Point
对于可执行程序,入口地址表示装载后开始执行的入口位置。
但对于普通 .o 文件,该字段通常不表示一个可以直接运行的有效程序入口。
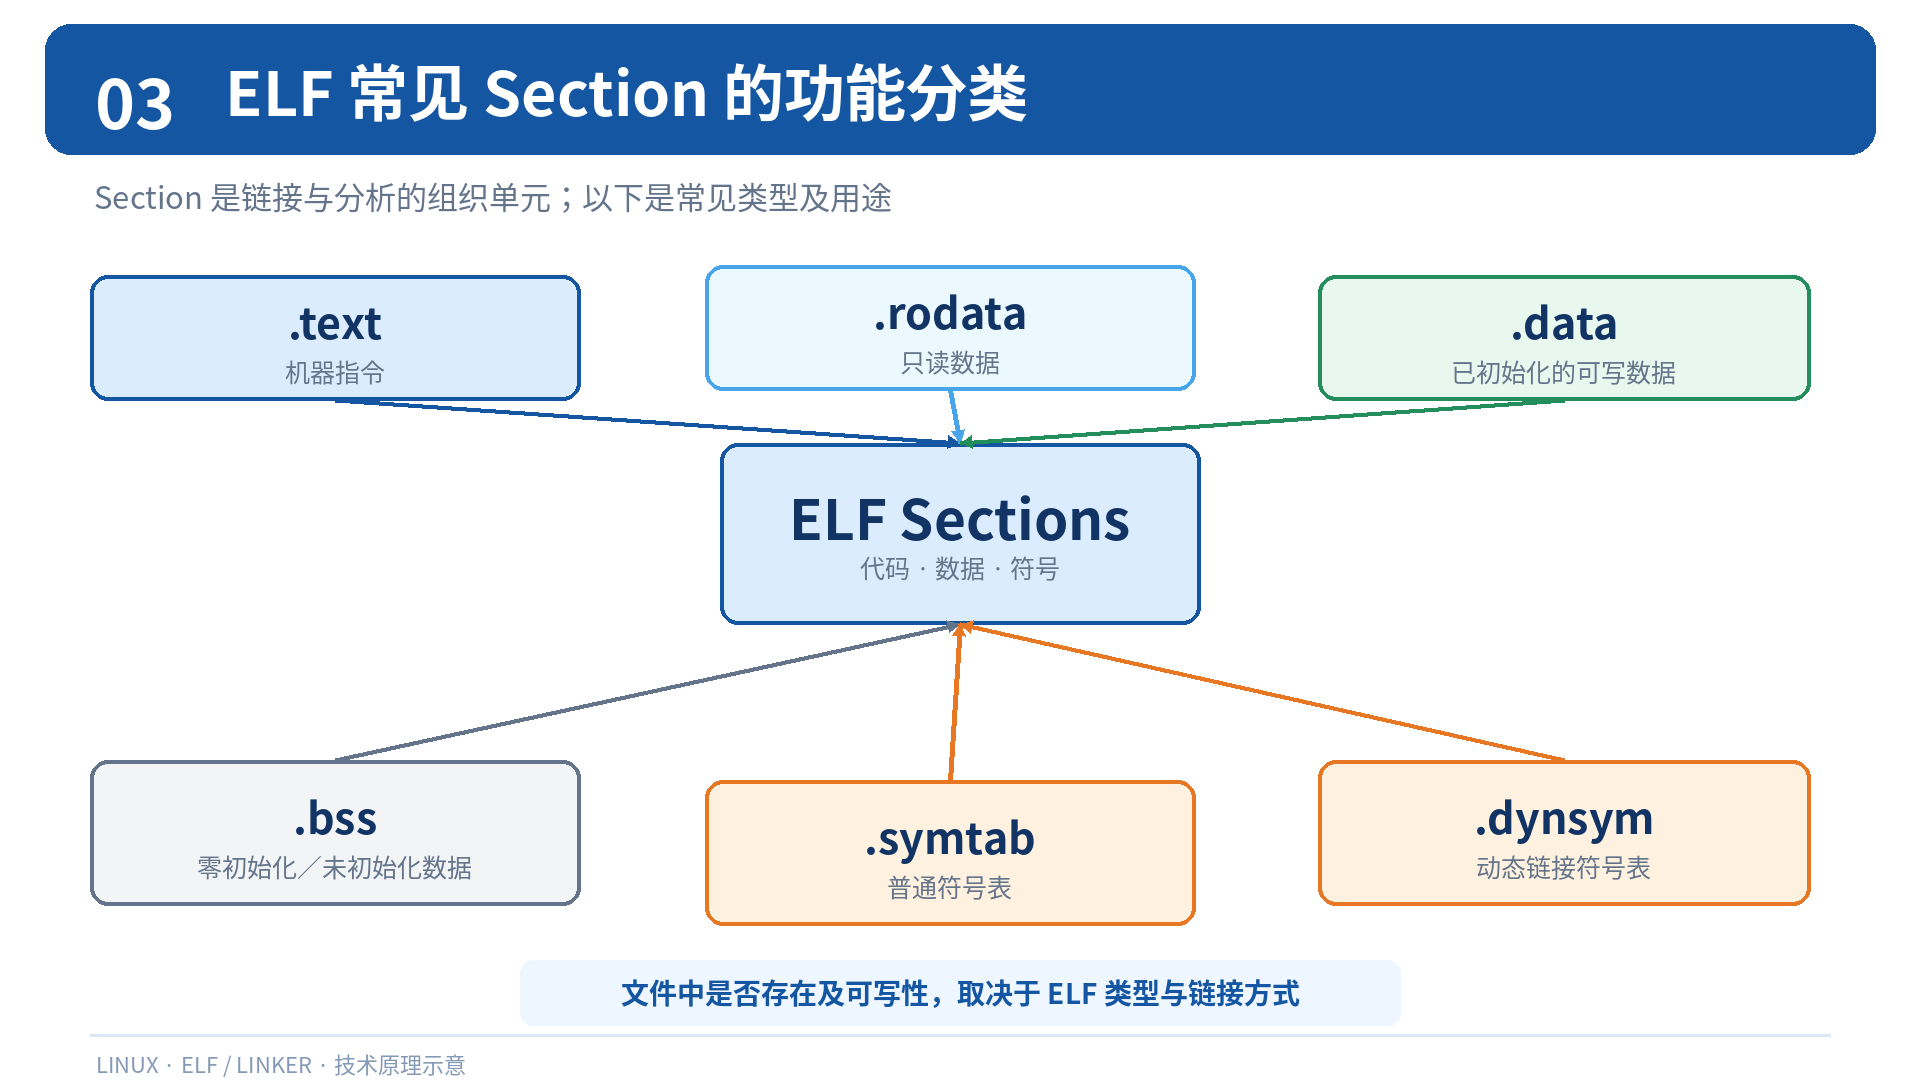
五、Section:从链接视角理解ELF
5.1 Section是什么?
Section 通常译为:
text
节ELF 使用不同的节组织具有不同用途的数据。
例如:
text
.text
.rodata
.data
.bss
.symtab
.strtab
它们分别保存代码、只读数据、可写数据以及符号和字符串信息等。
5.2 .text:代码节
.text 通常用于保存程序的机器指令。
例如:
c
int add(int a, int b)
{
    return a + b;
}
编译得到的函数指令,通常位于 .text 中。
可以使用:
bash
objdump -d hello.o查看反汇编结果。
5.3 .rodata:只读数据节
例如:
c
puts("hello world");其中字符串:
text
hello world通常会被编译器放在只读数据区域。
对于 ELF,常见的对应 Section 是:
text
.rodata其内容在装载后的访问权限通常与只读数据相匹配。
5.4 .data:已初始化的可写数据
例如:
c
int global_num = 100;如果这个全局变量需要在运行时修改,它通常保存在 .data 中。
5.5 .bss:未初始化或零初始化数据
例如:
c
int global_count;这样的全局变量通常会占据 .bss 相关的运行时内存空间。
.bss 的一个重要特点是:它在 ELF 中通常属于 SHT_NOBITS 类型,不需要把全部零初始化内容实际存储在文件中。
这也是为什么 ELF 文件大小与运行时占用的内存大小并不总是相同。
5.6 .symtab:符号表
符号表记录程序中各类符号的信息,例如:
text
函数名称
变量名称
符号类型
符号所在节
符号值
符号绑定属性
例如:
text
main
run
puts
可以使用:
bash
readelf -s hello.o查看符号表。
5.7 .dynsym与.symtab有什么区别?
.symtab 主要用于常规静态链接、符号分析等场景。
.dynsym 则保存动态链接需要使用的动态符号信息。
它们并不完全等价。
例如,某个可执行文件即使被剥离了普通 .symtab,仍然可能保留动态链接所必需的 .dynsym 等信息。
六、静态链接的核心:符号解析
6.1 为什么hello.o不知道run在哪里?
回顾:
hello.c:
c
void run(void);

int main(void)
{
    run();
    return 0;
}code.c:
c
void run(void)
{
    // 函数实现
}
它们分别编译:
bash
gcc -c hello.c
gcc -c code.c
编译器在生成 hello.o 时,知道:
text
run是一个函数但尚不知道它最终的运行时调用地址。
所以目标文件中需要保留相关符号引用及重定位信息。
6.2 使用readelf观察未定义符号
对于前面实际使用的 hello.c,执行:
bash
readelf -s hello.o可以观察到类似:
text
GLOBAL DEFAULT UND run
GLOBAL DEFAULT UND puts
其中:
text
UND表示:
text
Undefined即该符号在当前目标文件中没有定义。
但这并不意味着程序一定有错误。
因为链接器还可以从其他目标文件或库中寻找定义。
6.3 查看code.o
执行:
bash
readelf -s code.o能够找到 run 的定义,常见表现类似:
text
FUNC GLOBAL ... run因此:
text
hello.o
    |
    +-- 需要run

code.o
    |
    +-- 定义run
链接器就可以根据符号信息将两者对应起来。
6.4 将两个目标文件链接起来
执行:
bash
gcc hello.o code.o -o app然后:
bash
./app输出:
text
hello world
running...
说明:
text
hello.o中的 run() 调用,已经成功关联到:
text
code.o中定义的函数。
七、仅仅找到函数还不够:地址重定位
7.1 为什么需要重定位?
前面虽然已经知道:
text
run定义在code.o中但是程序最终运行时,需要执行 CPU 指令。
例如,在 x86-64 中,函数调用可能使用:
asm
call ...这条指令最终必须具有正确的调用目标。
问题在于:
不同目标文件分别编译时,并不知道最终被链接到可执行文件中的具体布局。
因此,链接器还需要修正代码或数据中的相关地址引用。
这一过程就是:
text
Relocation重定位。
7.2 查看目标文件中的重定位信息
执行:
bash
readelf -r hello.o或者:
bash
objdump -dr hello.o在 x86-64 环境下,可能看到类似:
text
R_X86_64_PLT32 run-0x4这表示相应位置存在针对 run 的重定位请求。
这里的 PLT32 是 x86-64 ELF 中的一种重定位类型,具体处理还要结合符号是否最终解析到本地定义等情况。
7.3 链接器怎样完成地址修正?
可以分为两个阶段理解。
首先,目标文件分别包含自己的代码节及符号信息。
text
hello.o
    |
    +-- main
    |
    +-- 需要run的调用位置

code.o
    |
    +-- run函数实现
然后链接器组织输出文件中的代码布局,并处理重定位条目。
例如,确定:
text
main位于某个地址

run位于另一个地址
之后,就可以计算具体调用指令需要的相对位移或其他地址表示。
因此:
text
未确定的符号引用
        |
        v
链接器解析符号
        |
        v
计算地址或位移
        |
        v
应用重定位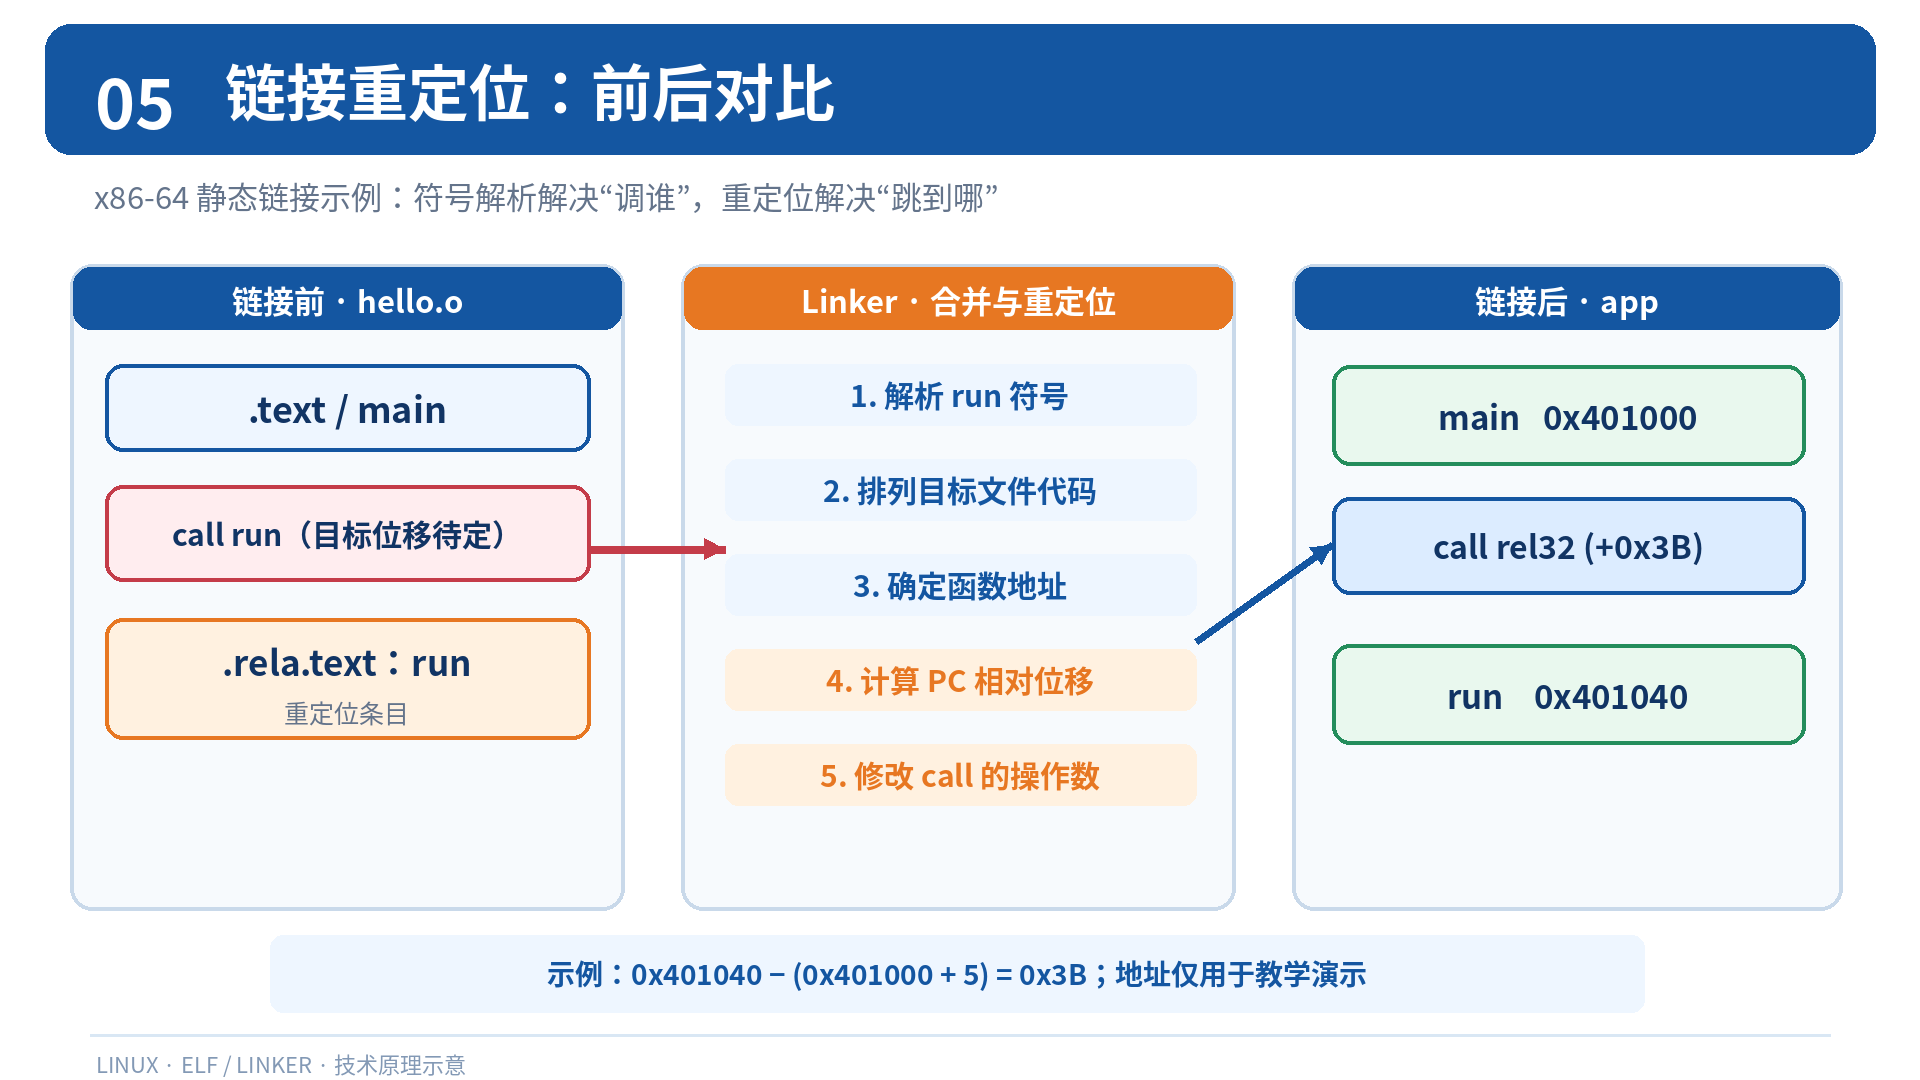
7.4 静态链接不只是简单拼接
很多初学者可能认为:
text
hello.o + code.o = app只是把两个二进制文件直接拼起来。
但真实链接过程至少包括:
- 处理输入目标文件。
- 组织和合并相应的 Section。
- 解析全局符号。
- 从静态库中选择所需成员。
- 处理重定位。
- 生成目标 ELF 文件及相关装载信息。
所以:
链接不是普通文件拼接,而是具有明确符号与地址语义的二进制构建过程。
八、Segment:从执行视角理解ELF
8.1 为什么已经有Section,还需要Segment?
我们已经知道 Section 适合从链接视角组织内容。
但是操作系统执行程序时,并不需要把每一个 Section 都单独当作一个映射单元。
例如:
text
.text
.rodata
.data
.bss
这些节在装载时具有不同的内存权限和初始化要求。
为此,ELF 提供:
text
Program Header Table程序头表。
其中的 Program Header 描述装载器如何处理相关 Segment。
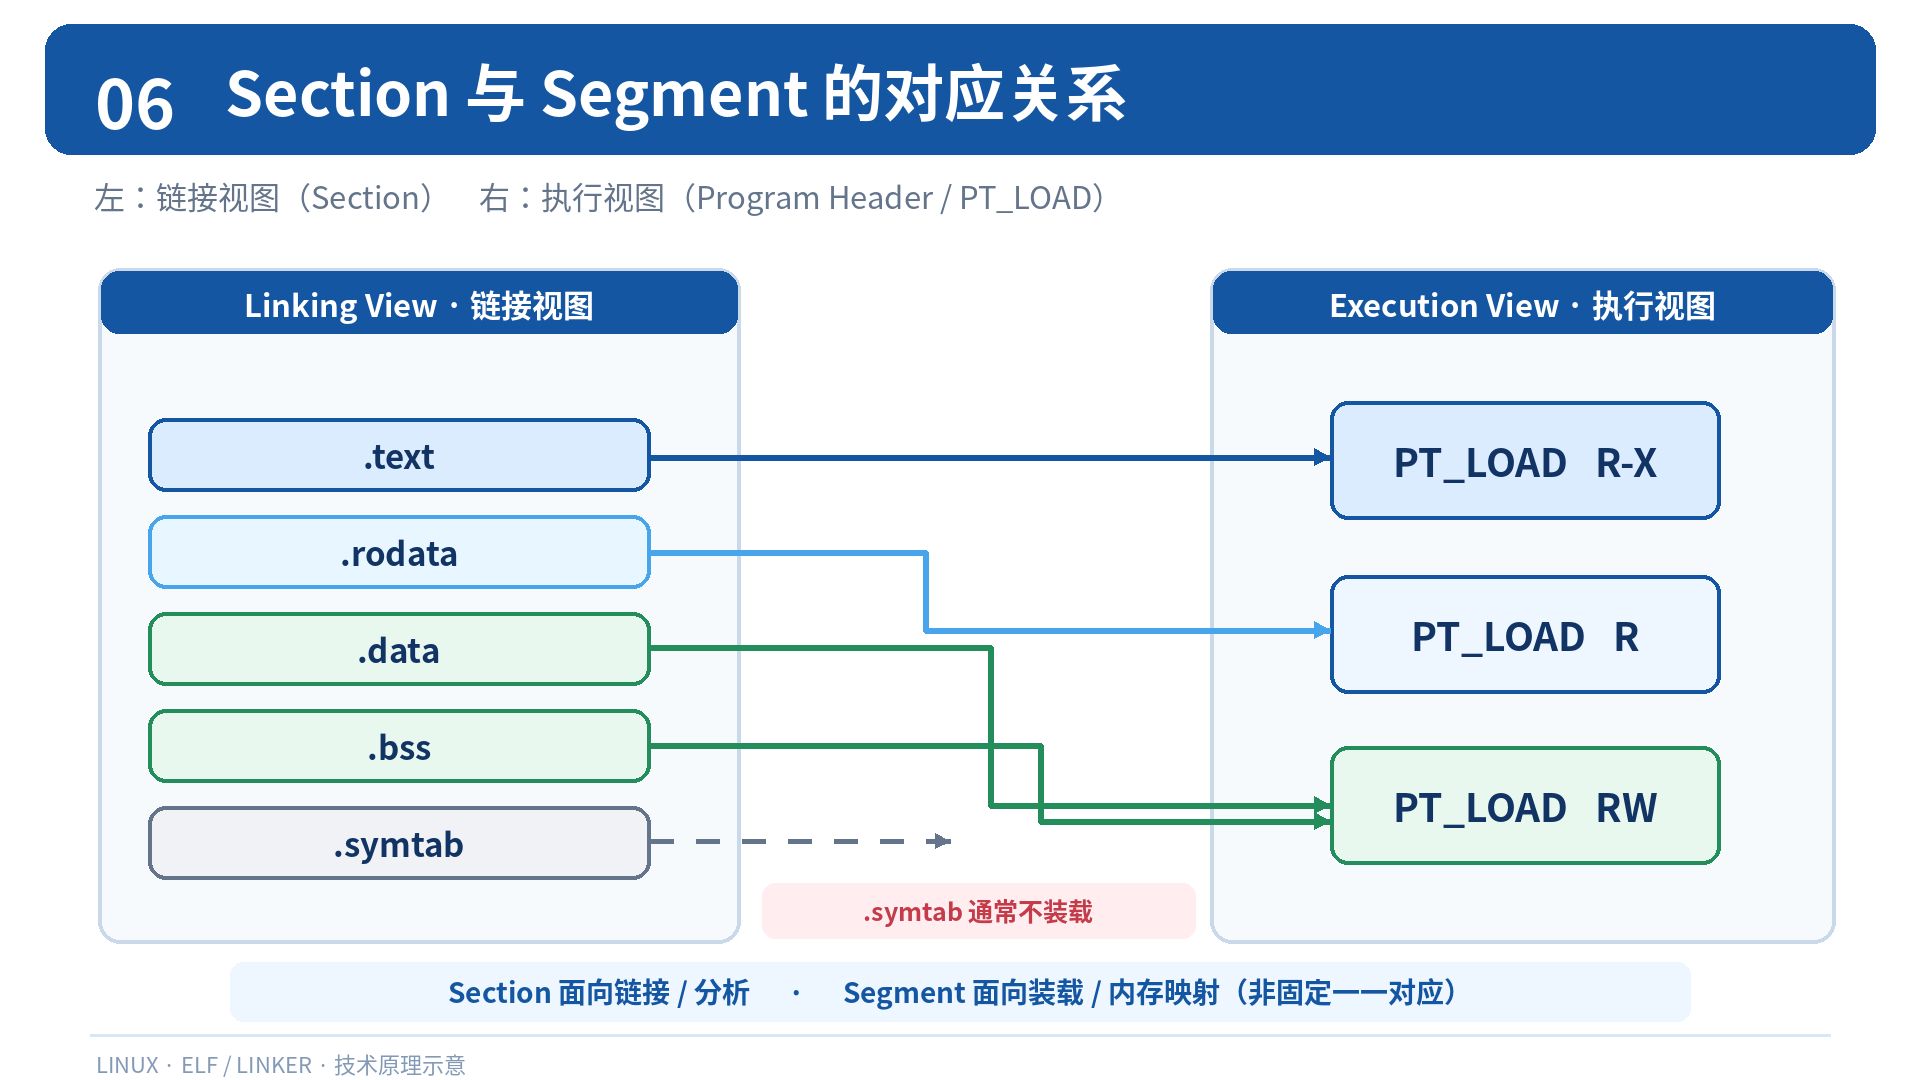
8.2 Section和Segment的区别
Section
主要用于组织链接与分析所需的不同类型内容。
Segment
主要用于描述程序运行时需要装载和管理的内存区域。
最重要的装载类型之一是:
text
PT_LOAD它描述需要映射到进程虚拟地址空间中的部分。
例如:
text
可读可执行区域
可读区域
可读可写区域
现代工具链还可能将只读数据、代码以及可写数据分别放入不同的 PT_LOAD Segment。
8.3 使用readelf观察Section和Segment
查看节头表:
bash
readelf -S app查看程序头表:
bash
readelf -l app在 readelf -l 输出中,通常能看到:
text
LOAD以及对应的:
text
Offset
VirtAddr
FileSiz
MemSiz
Flags
Align
这些字段对理解程序加载非常重要。
8.4 Section如何组织到Segment中?
在构建最终 ELF 文件时,链接器根据链接脚本及目标文件的相关属性安排输出节和段。
例如,一个包含机器代码的 Section 可能位于可执行的 PT_LOAD Segment 中。
一个保存可写数据的 Section 则可能位于可读写的 PT_LOAD Segment 中。
但是:
不是所有 Section 都需要映射到进程运行时地址空间。
例如,某些调试信息主要服务于工具分析,不需要作为程序执行所需的数据装载。
九、理解Program Header Table
9.1 为什么程序头表如此重要?
假设我们执行:
bash
./app操作系统需要知道:
text
程序的哪些文件区域需要映射?
应该映射到哪个虚拟地址?
应该设置什么访问权限?
需要初始化多少内存?
这些信息主要由程序头表描述。
9.2 PT_LOAD包含哪些重要字段?
9.2.1 p_offset
表示相应 Segment 在 ELF 文件中的偏移量。
9.2.2 p_vaddr
表示相应 Segment 的虚拟地址。
对于位置无关程序,还需要结合实际装载基址理解最终地址。
9.2.3 p_filesz
表示相应 Segment 在文件中占用的字节数。
9.2.4 p_memsz
表示装载到进程内存中后,需要具有的内存大小。
有时:
text
p_memsz > p_filesz例如存在需要零初始化的数据区域时,就可能出现这种情况。
9.2.5 p_flags
描述 Segment 的访问权限。
常见:
text
R:Read

W:Write

E:Execute
例如:
text
R E通常表示可读、可执行。
而:
text
RW表示可读、可写。
9.3 为什么Section Header Table不等于Program Header Table?
可以这样理解:
text
Section Header Table
    |
    v
帮助链接器与分析工具理解节

Program Header Table
    |
    v
帮助装载器理解运行时内存布局
两者服务于不同的阶段。
一个可执行 ELF 即使不再保留供普通分析使用的完整节头表,也可能仍然可以根据程序头表正常装载和执行。
十、现代可执行文件为什么可能是ET_DYN?
10.1 实际观察
执行:
bash
gcc hello.o code.o -o app然后:
bash
readelf -h app在较新的 Ubuntu 等 Linux 环境中,可能看到:
text
Type: DYN (Position-Independent Executable file)这并不意味着 app 是普通共享库。
它可能是一个:
text
PIE即可位置无关的可执行程序。
10.2 为什么需要PIE?
PIE 允许可执行程序在不同运行中使用不同的装载基址。
这有利于:
text
ASLR即地址空间布局随机化。
可以将 PIE 理解为:
text
程序内部尽量不依赖固定装载基址配合操作系统的地址空间随机化策略,使程序的实际装载位置可以变化。
10.3 怎样生成传统ET_EXEC?
在支持相应选项的 GCC/x86-64 环境下:
bash
gcc -no-pie hello.o code.o -o app_exec然后:
bash
readelf -h app_exec通常可以看到:
text
Type: EXEC (Executable file)因此:
| 类型 | 常见用途 |
|---|---|
ET_REL |
可重定位目标文件 |
ET_EXEC |
非PIE可执行文件 |
ET_DYN |
共享对象或PIE可执行程序 |
ELF 类型需要结合程序头和动态段等信息判断,不能仅看 Type 就推断所有运行行为。
十一、程序加载:从ELF文件到进程地址空间
11.1 ELF在磁盘上时有没有地址?
有。
ELF 文件可以保存:
text
虚拟地址信息例如 Program Header 中的:
text
p_vaddr但是这些地址信息不等于物理内存地址。
程序运行之前,ELF 只是一个磁盘文件。
当程序启动时,操作系统才会创建或替换相应的进程内存映像。
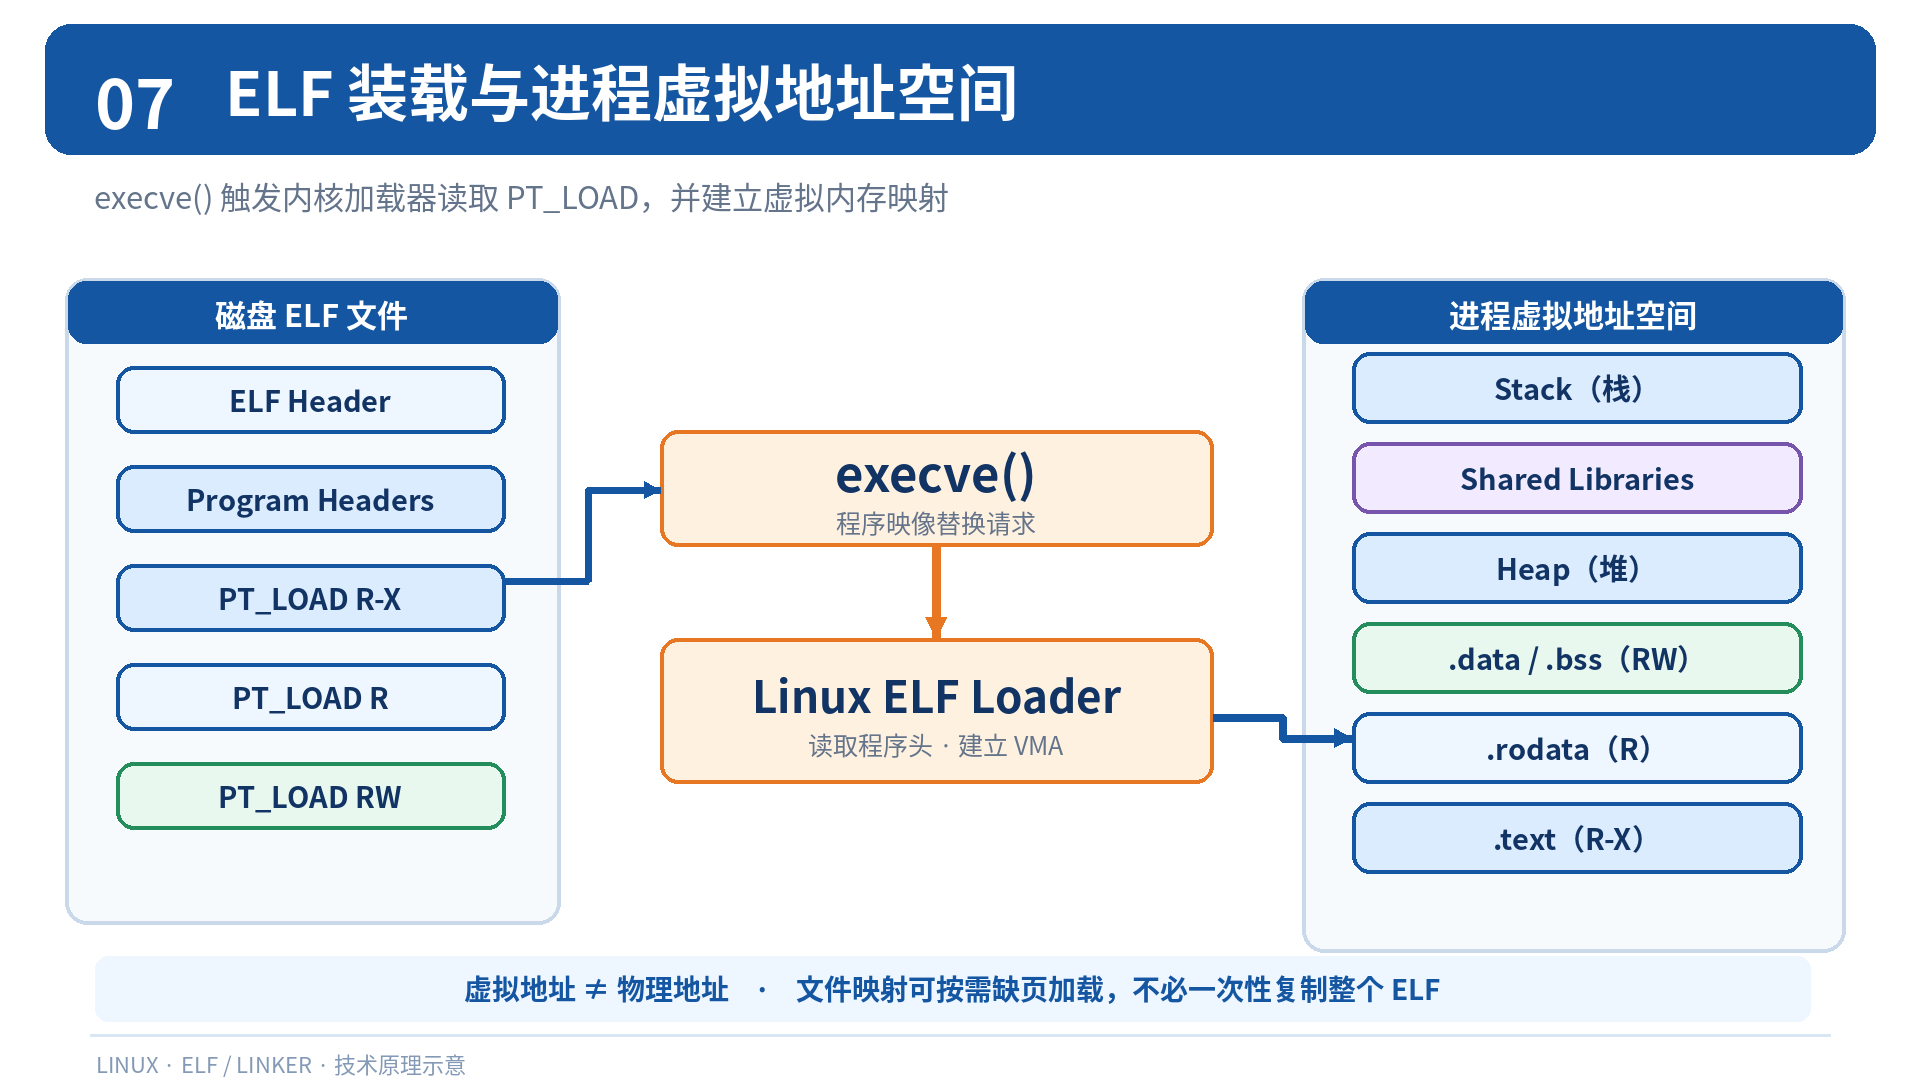
11.2 execve与ELF加载的关系
前面我们学习 MiniShell 时,使用:
c
execvp(argv[0], argv);在 Unix/Linux 中,execvp() 最终可以通过底层执行接口完成程序映像替换。
对于典型 ELF 可执行程序,加载过程可以概念化为:
- 内核打开并检查可执行文件。
- 读取 ELF Header 和相关 Program Header。
- 建立新的进程内存映像与虚拟内存映射。
- 根据
PT_LOAD等信息安排程序段。 - 对动态链接程序,安排 ELF 指定的程序解释器。
- 为新程序准备栈、参数、环境变量等初始运行条件。
- 将执行控制权交给适当的程序入口。
这里需要注意:
exec不会创建一个全新的进程PID,而是用新程序映像替换当前进程的相关执行内容。
这与你之前实现 MiniShell 的:
text
fork()
   |
   v
execvp()
完全对应。
11.3 虚拟地址空间是如何建立的?
Linux 进程使用虚拟地址空间。
进程管理中,我们曾经学习:
text
task_struct
mm_struct
vm_area_struct
这些内核结构与进程内存管理有关。
对于 ELF 程序,内核可以根据其装载信息建立相应的虚拟内存区域。
例如:
text
可执行代码映射
只读数据映射
可写数据映射
进程堆
进程栈
共享库映射
但并不需要在执行开始前,就把所有文件内容一次性全部读入物理内存。
实际加载通常结合虚拟内存映射、页缓存和按需缺页处理等机制。
十二、动态链接:为什么程序能调用动态库?
12.1 从第一篇的例子开始
我们已经生成了:
text
libmystdio.so然后执行:
bash
gcc main.c -L. -lmystdio -o main_shared虽然链接成功,但 main_shared 中通常没有把该共享库完整的函数实现复制进去。
那么程序运行时为什么还能调用:
c
my_strlen(msg);答案是:
动态加载器会根据程序记录的依赖信息定位共享库、映射共享对象,并完成必要的符号解析和重定位。
12.2 如何查看程序依赖了哪些动态库?
执行:
bash
readelf -d main_shared其中可能存在:
text
NEEDED条目。
例如:
text
Shared library: [libmystdio.so]
Shared library: [libc.so.6]
这些动态段信息告诉加载器程序需要哪些共享库。
也可以:
bash
ldd ./main_shared查看共享库依赖的解析结果。
注意:ldd 适合检查可信程序;分析来源不可信的二进制文件时,优先考虑 readelf -d 等静态检查方式。
12.3 动态加载器是谁?
在 GNU/Linux x86-64 系统中,经常能看到类似路径:
text
/lib64/ld-linux-x86-64.so.2它是 glibc 动态加载器的一种常见路径。
ELF 文件中的:
text
PT_INTERP程序头可以指定需要使用的程序解释器。
对于动态链接的 ELF 程序,通常就是相关动态加载器。
可以执行:
bash
readelf -l main_shared查看:
text
INTERP相关信息。
12.4 先运行动态加载器,再进入程序入口
需要特别区分执行顺序。
对于典型动态链接程序:
text
execve()
    |
    v
内核处理ELF
    |
    v
装载并进入动态加载器
    |
    v
解析依赖与完成必要重定位
    |
    v
进入程序的_start入口
    |
    v
C运行时初始化
    |
    v
main()
因此,不能简单地认为:
text
main先执行,然后才去找动态库也不能笼统地认为:
text
_start负责直接调用动态加载器完成一切在典型的 ELF 动态链接程序中,动态加载器会在可执行程序自身的 _start 获得控制权之前完成其必要的启动工作。
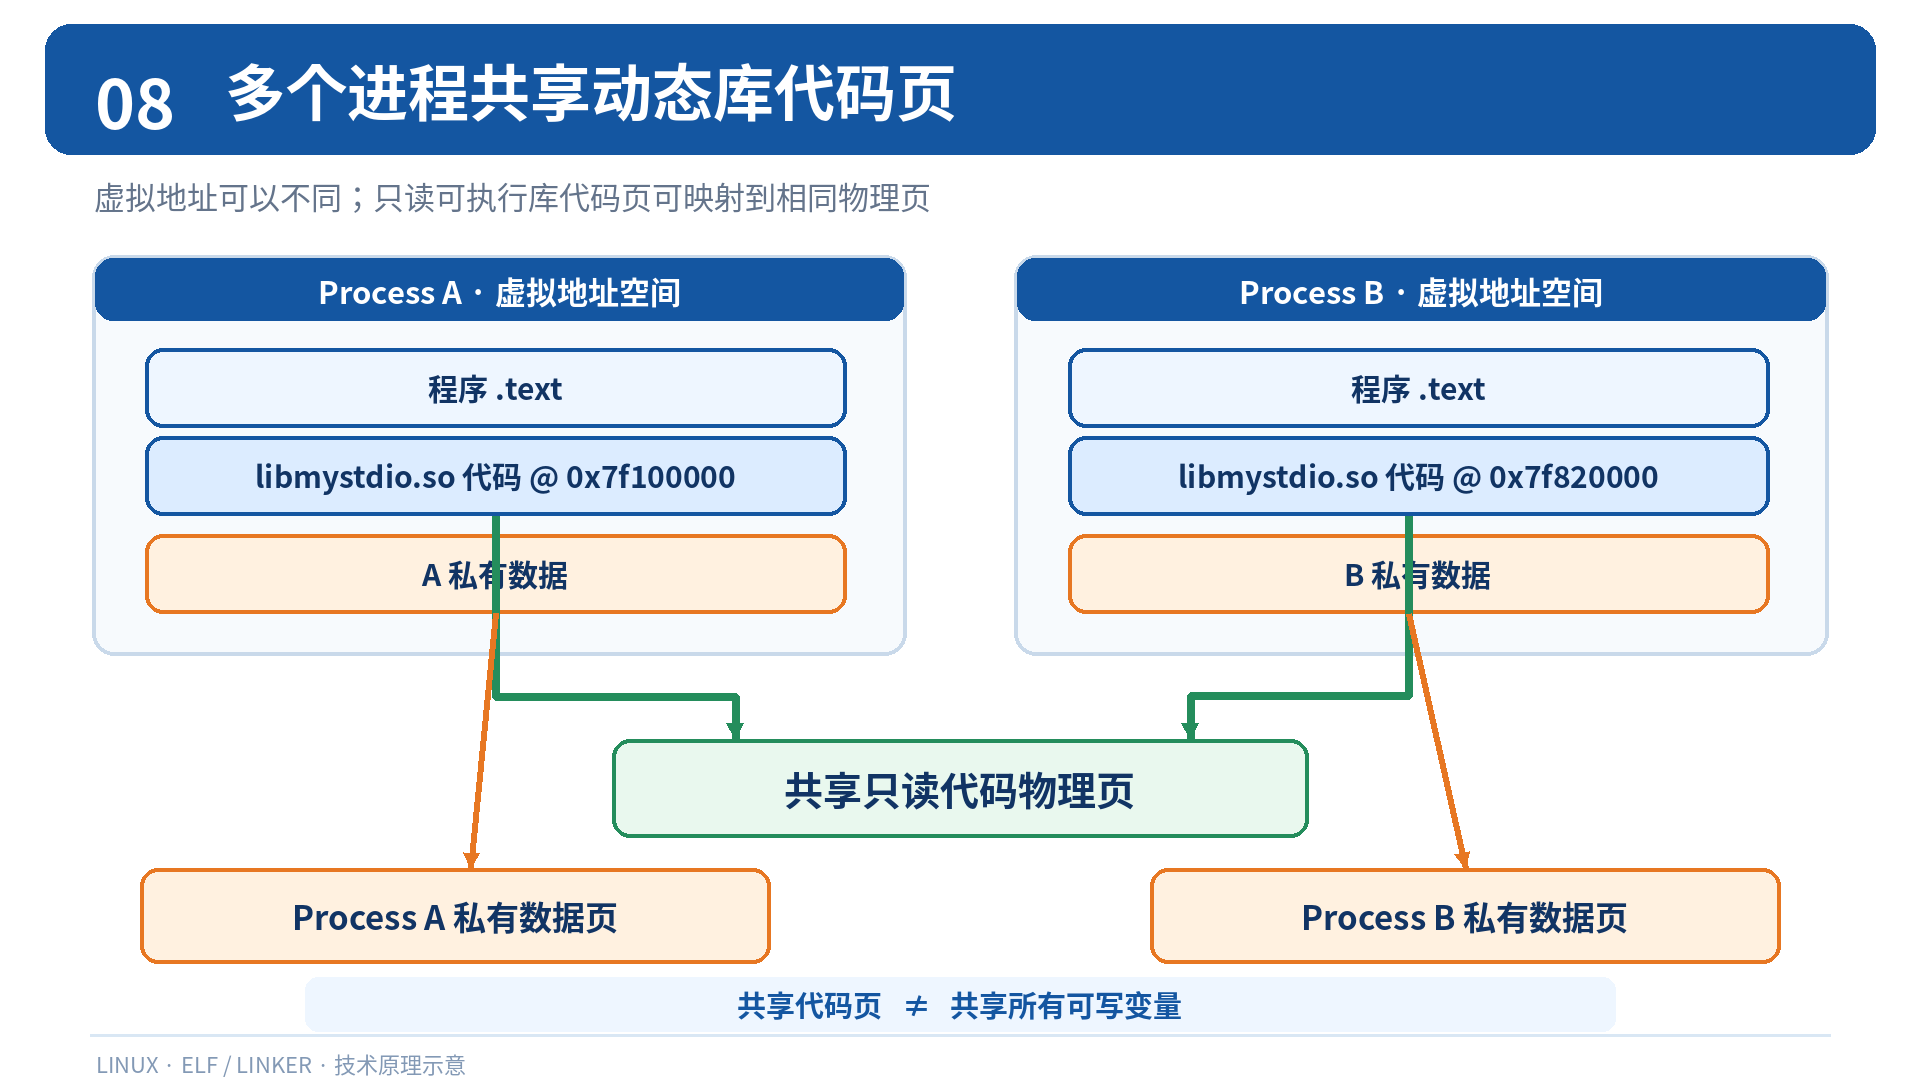
十三、为什么多个进程可以共享动态库?
13.1 静态链接与动态链接的内存关系
假设程序 A 和程序 B 都使用某个公共库。
如果两个程序分别静态链接了该库中的实现代码:
text
Program A
    |
    +-- Library Code

Program B
    |
    +-- Library Code
不同可执行文件中可能分别包含相应的机器代码。
而动态链接中:
text
Program A ---> libxxx.so

Program B ---> libxxx.so
两个进程可以将同一个共享对象映射进各自的虚拟地址空间。
对于适合共享的代码页,内核可以使两个进程的映射关联到相同的物理内存页。
13.2 共享的是虚拟地址吗?
不一定。
例如:
text
进程A虚拟地址:0x7f...1000

进程B虚拟地址:0x7e...2000
它们可能不同。
但底层适合共享的文件映射页,可以关联到同样的物理页。
这是因为:
text
虚拟地址与:
text
物理地址之间存在地址转换机制。
所以:
动态库能够在多个进程间共享代码页,并不意味着每个进程都必须用相同虚拟地址访问它。
13.3 为什么数据不能全部共享?
因为进程之间通常需要隔离可写状态。
例如某个共享库内部有:
c
int counter = 0;一般情况下,普通进程各自拥有相应的可写数据状态,不会因为使用同一个 .so 文件就自动共享 counter 的更新结果。
这与虚拟内存的私有映射、写时复制等机制有关。
十四、PIC:为什么动态库不需要固定加载地址?
14.1 动态库加载位置可能变化
假设某个共享库被映射到:
text
进程A:Base_A

进程B:Base_B
不同进程中的实际虚拟基址可能不同。
如果库的机器指令全部依赖固定绝对地址,就会增加装载时地址修正的复杂度,也不利于只读代码页共享。
因此,需要尽量减少对固定装载地址的依赖。
这就是位置无关代码(PIC)的主要动机。
14.2 相对寻址的基本思想
假设某个函数位于库内的固定相对位置。
即使库整体装载到不同基址:
text
进程A:

函数地址 = Base_A + Offset

进程B:

函数地址 = Base_B + Offset
这里:
text
Offset可以保持相同。
因此,只要能够确定库的实际装载基址和对应符号的相对位置,就能计算目标地址。
当然,真正的动态链接还涉及符号可见性、符号抢占、重定位类型等问题。
所以不能把所有外部函数调用都简化为一次 Base + Offset 加法。
十五、GOT:全局偏移表
15.1 为什么需要GOT?
在动态链接中,程序可能要访问:
text
共享库中的函数

共享库中的全局变量
它们的最终地址有些需要在运行时才能确定。
如果每次都去修改只读代码中的绝对地址,不仅不方便,还会降低代码共享效率。
因此,ELF 动态链接机制中常使用:
text
GOT即:
text
Global Offset Table全局偏移表。
15.2 GOT的基本作用
可以将 GOT 理解为保存某些运行时地址信息的表。
例如:
text
程序代码
    |
    v
读取GOT表项
    |
    v
取得目标地址
    |
    v
访问目标函数或数据
这样程序代码就可以通过适当的相对寻址方式找到 GOT,再取得需要的运行时地址。
15.3 为什么GOT适合与PIC配合?
因为程序或共享库内部代码与 GOT 的相对位置可以在链接时确定。
对于需要运行时解析的目标地址,可以通过对应的重定位处理 GOT 表项。
于是就能尽量减少修改可执行代码页的需求。
不过需要注意:
GOT 并不保证在整个程序运行期间都可写。
现代 ELF 程序常用 RELRO 等保护机制。在完成相关重定位后,部分 GOT 区域可能被设置为只读。
因此,不能简单把 GOT 理解成始终位于可写 .data 中的一张普通表。
15.4 如何查看GOT?
执行:
bash
readelf -S main_shared可能找到:
text
.got
.got.plt
也可以:
bash
readelf -rW main_shared查看重定位条目。
不同工具链、架构及链接选项下,具体 Section 名称与布局可能有所不同。
十六、PLT:过程链接表
16.1 PLT是什么?
PLT 全称:
text
Procedure Linkage Table即过程链接表。
在常见的 x86-64 ELF 动态链接实现中,PLT 可以为外部函数调用提供跳转入口。
例如:
c
puts("hello world");在相关构建方式下,反汇编结果可能出现:
asm
call puts@plt其中:
text
puts@plt并不是 puts 函数在 libc 中的真正实现地址。
它是可执行文件中与外部函数调用相关的一个跳转入口。
16.2 PLT和GOT是什么关系?
以常见的通过 PLT 进行外部函数调用的形式为例:
text
程序代码
    |
    v
PLT入口
    |
    v
读取对应GOT表项
    |
    v
跳转到实际目标地址
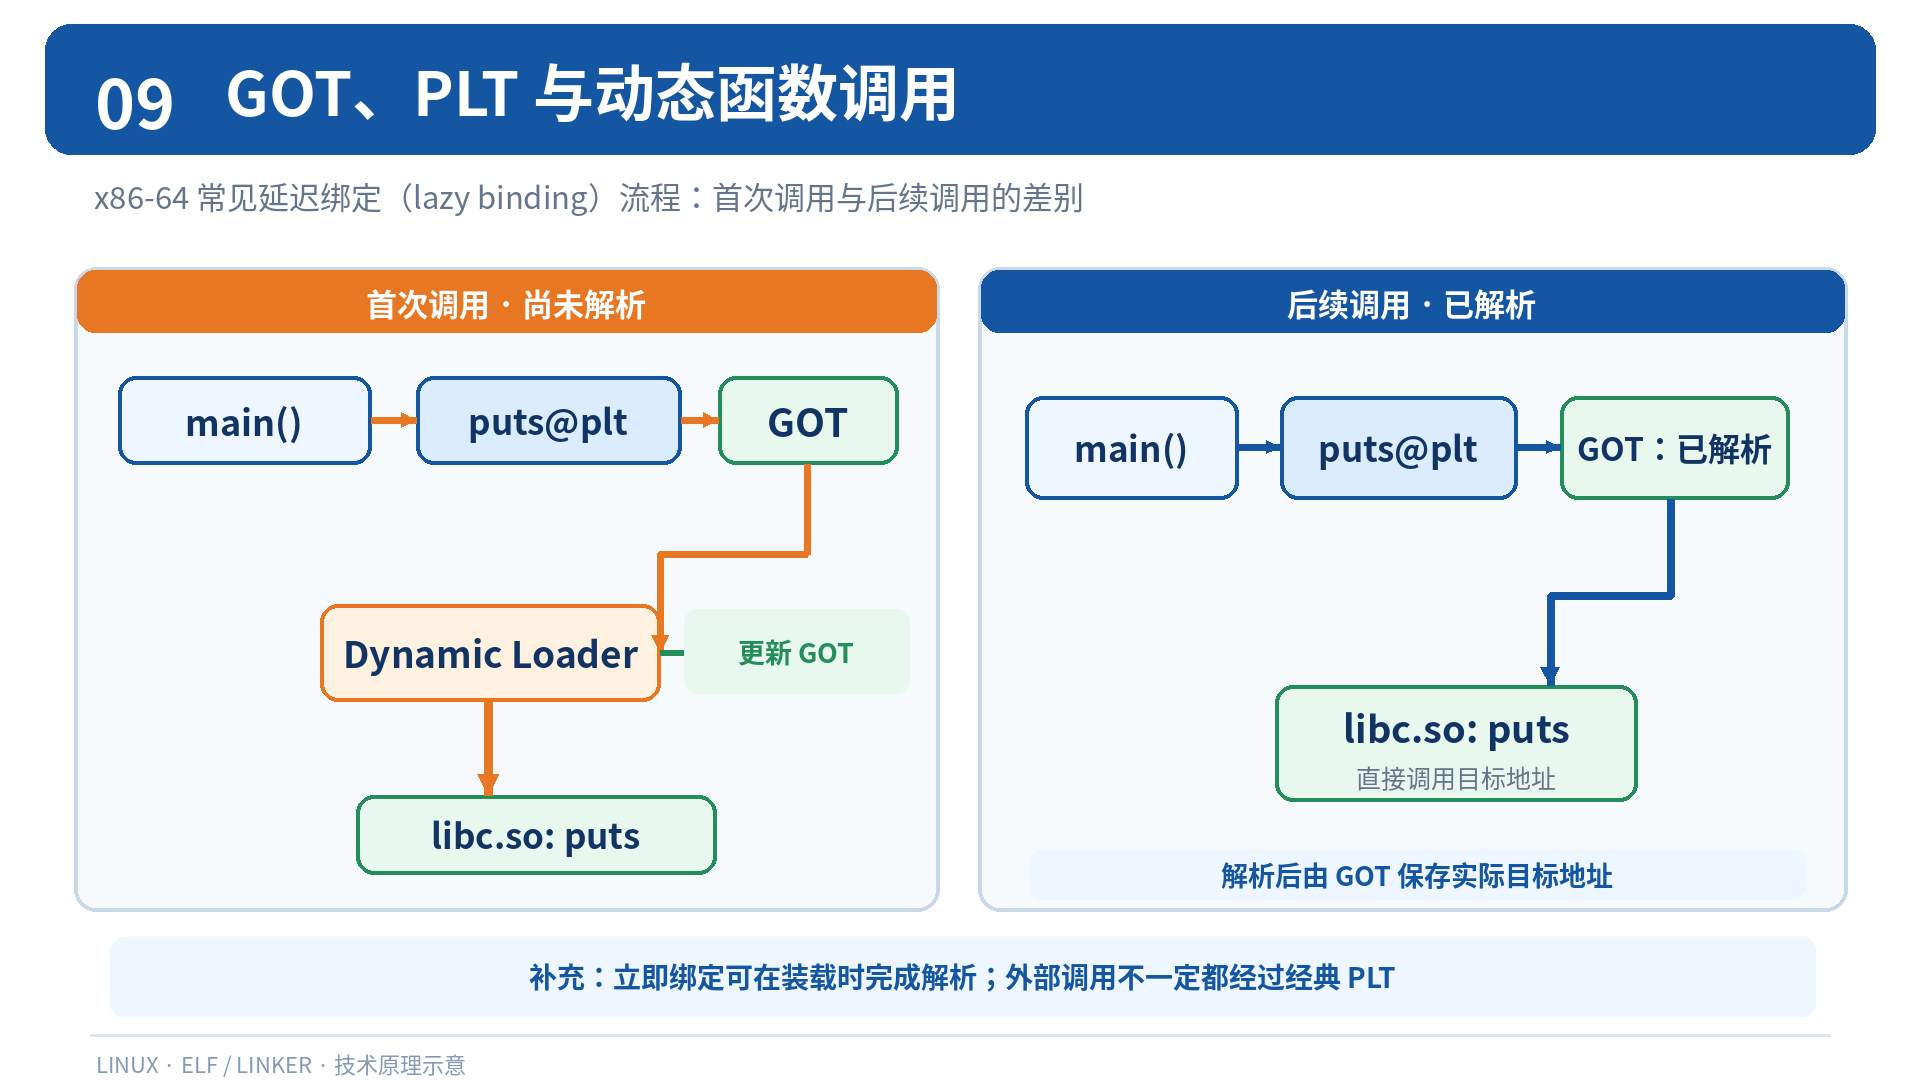
如果对应的运行时地址还未完成解析,某些实现可以通过延迟绑定机制,调用动态加载器完成符号解析。
16.3 什么是延迟绑定?
延迟绑定(Lazy Binding)是一种动态链接优化方式。
其核心思想是:
text
并非所有外部函数都一定要在启动时完成最终绑定部分函数可以在第一次调用时才完成相关解析。
第一次调用:
text
程序调用外部函数
       |
       v
进入PLT
       |
       v
需要符号解析
       |
       v
动态加载器解析目标
       |
       v
更新相关跳转信息
       |
       v
调用实际函数
后续调用:
text
程序调用外部函数
       |
       v
PLT
       |
       v
直接跳转已解析目标
但要注意:
延迟绑定并不是所有现代 ELF 程序都必须采用的方式。
如果使用立即绑定(Now Binding),相关符号会在加载阶段完成解析。
例如,可以通过:
bash
gcc hello.o code.o -Wl,-z,now -o app_now请求相应的立即绑定行为。
另外,编译器也可能生成不经过经典 PLT 入口的调用形式,例如某些 -fno-plt 构建方式。
16.4 如何观察PLT?
可以执行:
bash
objdump -d app在具有相应 PLT 调用的构建中,可能出现:
asm
call puts@plt对于 x86-64 GCC,可以在教学实验中显式尝试:
bash
gcc -O0 -fno-builtin -fplt \
    hello.c code.c -o app
然后:
bash
objdump -d app观察外部函数调用。
具体机器指令形式会受到 GCC、链接器和系统版本影响。
十七、从程序启动到调用动态库:完整流程
现在我们可以把前面的知识串起来。
假设有:
text
main_shared它依赖:
text
libmystdio.so
libc.so.6
可以分成几个主要阶段。
17.1 第一阶段:构建程序
GCC 和链接器需要完成:
text
源码编译
    |
    v
生成.o
    |
    v
解析可以在链接期处理的符号
    |
    v
组织ELF节与段
    |
    v
生成动态依赖和重定位信息
    |
    v
得到可执行ELF
17.2 第二阶段:内核加载程序
用户执行:
bash
./main_shared系统进入相应的执行程序流程。
内核读取 ELF 装载信息,建立新程序的内存映像。
如果是典型的动态链接 ELF 程序,则需要进入相应动态加载器。
17.3 第三阶段:动态加载器处理依赖
动态加载器根据 ELF 动态段和运行环境,定位需要的共享库。
随后完成必要的共享对象映射、依赖处理与重定位。
对于使用延迟绑定的符号,部分解析可能在以后第一次调用时完成。
17.4 第四阶段:进入程序入口
当必要的装载和初始化工作完成后,执行控制权进入程序入口。
典型的 glibc 环境还需要经过 C 运行时初始化,最终调用:
c
main();17.5 第五阶段:调用库函数
例如:
c
my_strlen(msg);程序可以通过已经建立的动态链接信息或适当的调用入口,转移到共享库中对应的函数实现。
完成调用后,再返回原程序继续执行。
这里的关键是:
动态库通过进程虚拟地址空间中的映射参与程序执行,并不需要每调用一次库函数就重新从磁盘加载一次整个 .so 文件。
十八、Linux中常用的ELF分析工具
本篇涉及的工具比较多,下面统一整理。
| 工具 | 常用命令 | 作用 |
|---|---|---|
file |
file app |
查看文件类型 |
readelf |
readelf -h app |
查看ELF Header |
readelf |
readelf -S app |
查看Section Header Table |
readelf |
readelf -l app |
查看Program Header Table |
readelf |
readelf -s app |
查看符号表 |
readelf |
readelf -r app |
查看重定位信息 |
readelf |
readelf -d app |
查看动态段 |
nm |
nm hello.o |
查看符号 |
objdump |
objdump -dr hello.o |
反汇编并显示重定位信息 |
ldd |
ldd ./app |
查看可信程序的共享库依赖解析 |
size |
size app |
查看常见节大小统计 |
18.1 建议的一组实验命令
对前面编译的两个目标文件执行:
bash
file hello.o

readelf -h hello.o

readelf -S hello.o

readelf -s hello.o

readelf -r hello.o

objdump -dr hello.o
然后链接:
bash
gcc hello.o code.o -o app继续:
bash
file app

readelf -h app

readelf -S app

readelf -l app

readelf -d app

ldd ./app

objdump -d app
建议重点对比:
text
hello.o与app的Type字段以及:
text
hello.o与app的符号、重定位、程序头表有什么不同。
十九、深入实验:动态加载器如何查找共享库?
如果你已经完成上一篇 libmystdio.so 的制作,可以继续使用:
bash
LD_LIBRARY_PATH=. ./main_shared还可以使用:
bash
LD_DEBUG=libs LD_LIBRARY_PATH=. ./main_shared观察 glibc 动态加载器对共享库的搜索与加载信息。
由于输出可能较长,可以将它保存到文件:
bash
LD_DEBUG=libs LD_LIBRARY_PATH=. \
    ./main_shared 2> loader.log
然后查看:
bash
less loader.log这里的:
text
LD_DEBUG=libs适合学习动态加载器搜索依赖库的过程。
对于不同动态加载器实现,调试环境变量和输出内容可能有所不同。
可以重点观察:
- 程序需要加载哪些共享库。
- 动态加载器从哪些目录查找。
- 最终定位到了哪个共享对象。
- 动态加载器如何执行初始化相关工作。
二十、链接和加载有什么根本区别?
这是本篇最需要弄清楚的问题之一。
20.1 链接主要做什么?
链接发生在程序构建阶段。
它主要负责:
text
组织目标代码和数据
解析符号
完成链接期重定位
记录动态依赖
生成最终ELF
例如:
bash
gcc hello.o code.o -o app主要涉及链接器的工作。
20.2 加载主要做什么?
加载发生在程序执行阶段。
它主要涉及:
text
解释ELF装载信息
建立进程内存映像
映射相应文件区域
准备程序运行环境
处理动态加载依赖
移交执行控制权
对于使用动态库的程序,动态加载器还会进行相应动态链接工作。
20.3 为什么不能将二者混为一谈?
因为有些地址可以在链接期确定。
例如,两个普通目标文件被链接进同一个可执行程序后,链接器可以确定部分内部函数调用的相对关系。
但某些外部共享库符号的最终地址,可能需要在运行时完成处理。
所以:
text
静态链接期的地址处理和:
text
动态装载期的地址处理是相关但不同的机制。
二十一、常见误区总结
21.1 .o文件已经包含机器代码,所以可以直接执行?
不一定。
普通 .o 是可重定位目标文件,通常还需要经过链接才能成为完整可执行程序。
21.2 链接就是把多个.o直接拼接在一起?
不对。
链接还包括符号解析、重定位、节布局以及其他必要的二进制组织工作。
21.3 ET_DYN一定是动态库?
不对。
PIE 可执行程序也通常使用 ET_DYN。
21.4 所有Section都要装载到内存?
不对。
程序加载主要依据 Program Header Table 中的装载信息。
并非每个 Section 都是程序执行所必需的内存映射内容。
21.5 ELF加载时会立即把所有内容读入物理内存?
不对。
现代 Linux 通常使用虚拟内存映射、按需缺页以及页缓存等机制。
不能把装载理解为简单地一次性复制整个可执行文件。
21.6 两个进程使用同一个.so,就拥有相同虚拟地址?
不一定。
不同进程可以使用不同虚拟地址映射共享库,但适合共享的代码页仍可以共享底层物理内存。
21.7 PIC就是代码里完全没有任何地址?
不对。
PIC 的重点是减少对固定绝对装载地址的依赖,通过相对寻址及相关表结构等机制适应不同装载位置。
21.8 GOT始终是可以修改的?
不对。
某些 GOT 区域可能在动态重定位完成后受到 RELRO 等保护,变为只读。
21.9 动态函数调用一定先进入PLT?
不一定。
具体调用形式受编译器、架构、链接选项和符号属性影响。
某些构建可以使用不同于经典 PLT 调用的方式。
21.10 所有外部函数都会在第一次调用时才解析?
不对。
动态链接可以使用延迟绑定,也可以使用立即绑定。
实际行为取决于 ELF 属性、链接器选项和加载器实现。
二十二、完整知识体系总结
现在从源代码开始,建立一条完整的执行链路。
text
C/C++源代码
     |
     v
预处理、编译、汇编
     |
     v
可重定位目标文件.o
     |
     +-- .text
     |
     +-- .data
     |
     +-- .symtab
     |
     +-- Relocations
     |
     v
链接器
     |
     +-- 符号解析
     |
     +-- Section布局
     |
     +-- 重定位
     |
     +-- 静态库成员提取
     |
     +-- 动态依赖信息生成
     |
     v
可执行ELF
     |
     v
execve()
     |
     v
内核ELF装载处理
     |
     v
进程虚拟地址空间
     |
     v
动态加载器(如需要)
     |
     +-- 搜索共享库
     |
     +-- 映射共享库
     |
     +-- 完成必要重定位
     |
     v
程序入口_start
     |
     v
C运行时初始化
     |
     v
main()
     |
     v
调用库函数
其中需要重点理解三个概念。
第一:符号解析
解决:
text
函数或变量的定义在哪里?第二:重定位
解决:
text
相应机器代码或数据中的地址引用应该怎样修正?第三:动态加载
解决:
text
共享库在哪里?
它应该怎样映射进进程?
需要完成哪些运行时符号处理?
这三个问题共同构成了 Linux 程序从构建到执行的重要基础。
总结
本文从两个源文件开始,逐步分析了 Linux 库与可执行程序底层工作的关键机制。
首先,我们知道普通 .o 文件是 ELF 可重定位目标文件,编译器可以分别生成不同模块的机器代码,而链接器负责组织这些目标文件,完成符号解析和重定位。
随后,我们通过 ELF 结构理解了:
text
Section和:
text
Segment的区别。
Section 更适合从链接与分析角度组织 ELF 内容,而 Segment 主要服务于程序装载与运行时内存映射。
接下来,我们分析了:
text
execve()如何配合 ELF Program Header 和虚拟内存机制建立进程运行环境。
对于动态链接程序,动态加载器还需要定位共享库、建立映射、处理重定位,并最终让程序能够正确调用所依赖的函数。
最后,我们学习了:
text
PIC
GOT
PLT
三个关键概念。
它们帮助我们理解:
即使一个共享库在不同进程中的虚拟装载位置不同,程序也能够通过动态链接机制正确访问库中的函数和数据。
将两篇文章联系起来,可以得到:
- 第一篇解决的是:如何制作、链接和交付库?
- 第二篇解决的是:链接器和操作系统为什么能够让这些库正常工作?
至此,我们不再只是机械地使用:
bash
gcc -shared
gcc -fPIC
ar rcs
而是可以从 ELF、符号、重定位和虚拟地址空间的角度,理解这些命令背后的工作机制。