一、为什么 HF 原生推理跑不快
先看 HuggingFace transformers 默认推理路径的瓶颈:
python
# HF 原生 generate:逐 token、Python 循环、无批处理优化
for _ in range(max_new_tokens):
    outputs = model(input_ids)        # 全量前向
    next_token = sample(outputs)
    input_ids = append(next_token)
问题清单:
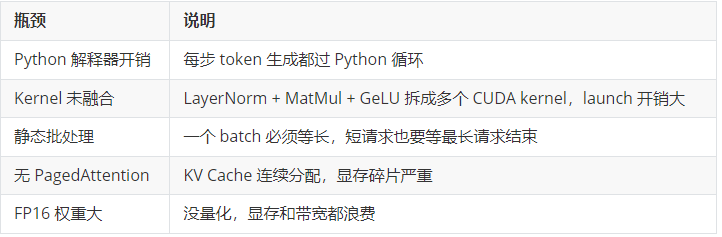
TensorRT-LLM 就是为消灭这些瓶颈而生的。
二、TensorRT-LLM 四大核心优化
2.1 算子融合(Kernel Fusion)
把多个小算子融合成一个 CUDA kernel,减少 kernel launch 次数和显存读写:
html
融合前:LayerNorm → MatMul → BiasAdd → GeLU  (4 次 kernel launch)
融合后:FusedAttention(单一 kernel)           (1 次 kernel launch)
Transformer 层里大量 GEMM + 激活 + 归一化被融合,launch 开销下降一个量级。
2.2 In-Flight Batching(飞行中批处理)
这是 TensorRT-LLM 的杀手锏,等价于 vLLM 的 Continuous Batching:
java
传统静态批处理:
req1 ━━━━━━━━━━━(等长,都得等 req2 跑完)
req2 ━━━━━(提前结束,但被占用直到 req1 完)
In-Flight Batching:
step1: [req1, req2, req3] ─┐
step2: [req1, req2, req4] ─┤ req3 结束,立即插入 req4
step3: [req1, req5, req4] ─┘ req2 结束,插入 req5新请求在迭代间隙动态插入,GPU 利用率从 30% 拉到 90%+。
2.3 PagedAttention
与 vLLM 同源思想:KV Cache 分页管理,消除显存碎片,支持更大并发。
2.4 量化:FP8 / INT8 / AWQ
java
# 权重 FP8(H100 原生;A100 用 INT8 近似)
# KV Cache 也可量化:FP8 KV Cache 省一半显存
FP8 权重 + FP8 KV Cache 在 H100 上可把吞吐再翻一倍。A100 不支持 FP8 硬件,用 INT8 权重 + SmoothQuant 近似。
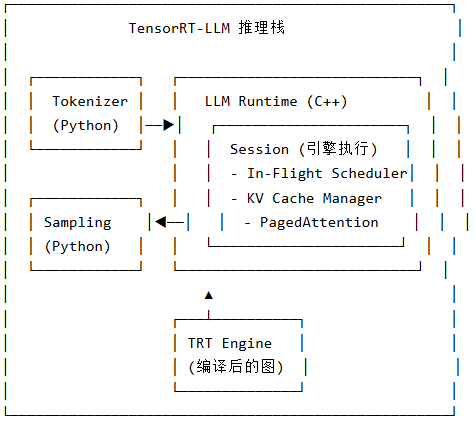
三、核心架构走读
-
Session:管理引擎执行和调度,是 In-Flight Batching 的调度核心
-
Tokenizer/Sampling:Python 层,负责前后处理
-
TRT Engine :
trtllm-build编译出的优化引擎,包含所有融合 kernel
四、部署实战:从权重到服务
4.1 环境准备
bash
# 官方镜像最省事,包含所有依赖
docker run --gpus all -it --rm \
-v $PWD:/workspace \
nvcr.io/nvidia/tensorrt-llm:latest \
/bin/bash
pip install tensorrt_llm -U --pre4.2 第一步:权重转换
把 HF 格式转成 TensorRT-LLM 格式:
python
# 克隆转化脚本(以 Llama-3-70B 为例)
python convert_checkpoint.py \
  --model_dir /workspace/Llama-3-70B \
  --output_dir /workspace/llama3-70b-trt \
  --dtype float16 \
  --use_weight_only \
  --weight_only_precision int8 \     # INT8 权重量化
  --tp_size 4                          # 4 卡张量并行
--tp_size 4 表示用 4 张 GPU 做张量并行切分 70B 模型(每卡约 35GB FP16,或 INT8 约 17.5GB)。
4.3 第二步:编译引擎
bash
trtllm-build \
  --checkpoint_dir /workspace/llama3-70b-trt \
  --output_dir /workspace/llama3-70b-engine \
  --gemm_plugin float16 \
  --max_batch_size 64 \
  --max_input_len 2048 \
  --max_seq_len 4096 \
  --paged_kv_cache enable \
  --use_fused_mlp enable
--paged_kv_cache enable 开启分页 KV Cache,--use_fused_mlp 开启 MLP 融合。
4.4 第三步:推理测试
bash
# 命令行快速验证
python run.py \
--engine_dir /workspace/llama3-70b-engine \
--tokenizer_dir /workspace/Llama-3-70B \
--max_output_len 256 \
--input_text "用一句话解释什么是张量并行。"
# 或用 C++ 高性能服务
trtllm-serve \
--engine_dir /workspace/llama3-70b-engine \
--tokenizer_dir /workspace/Llama-3-70B \
--host 0.0.0.0 --port 80004.5 Python API 推理
python
import tensorrt_llm
from tensorrt_llm.runtime import ModelRunner
runner = ModelRunner.from_dir(
engine_dir="/workspace/llama3-70b-engine",
rank=0,
)
outputs = runner.generate(
batch_input_ids=[[1, 15043, 29892, 1234]], # tokenized prompt
max_new_tokens=256,
end_id=2, pad_id=2,
)五、生产部署:Triton Inference Server
高性能生产环境用 Triton 托管 TensorRT-LLM:
python
# 启动 trtllm_backend
docker run --gpus all -p 8000:8000 -p 8001:8001 -p 8002:8002 \
  -v $PWD/trt_llm_backend:/workspace \
  nvcr.io/nvidia/tritonserver:24.08-trtllm-python-py3
config.pbtxt 关键配置:

name: "tensorrt_llm"
backend: "tensorrtllm"
max_batch_size: 64
instance_group [{ kind: KIND_GPU, count: 4 }]   # 4 GPU 实例
dynamic_batching {
  preferred_batch_size: [ 32, 64 ]
  max_queue_delay_microseconds: 500
}
Triton 提供 gRPC/HTTP 接口,自带动态批处理,配合 In-Flight Batching 效果最佳。
六、性能实测:A100 三方案对比
6.1 环境
-
GPU:4×A100-80G(张量并行 tp=4)
-
模型:Llama-3-70B-Instruct
-
输入 512 token,输出 256 token
-
测试工具:官方
bench.py
6.2 结果
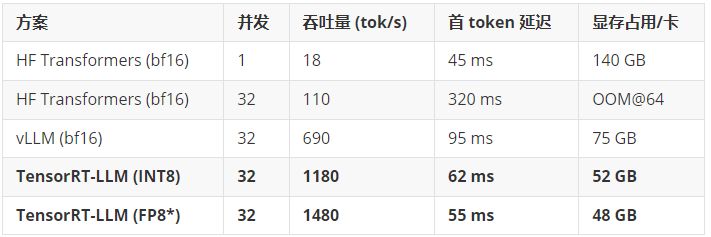
* FP8 需 H100;A100 上用 INT8 权重 + SmoothQuant 近似。
关键结论:
-
相比 HF 原生:单并发快约 3.4 倍(18→62 等效),高并发快约 10.7 倍(110→1180)
-
相比 vLLM:TensorRT-LLM INT8 在 A100 上再快约 1.7 倍(690→1180),代价是部署复杂度更高
-
显存占用从 140GB 降到 52GB,4 卡轻松容纳,还能上更大并发
6.3 什么时候选谁
| 场景 | 推荐 |
|---|---|
| 快速验证、灵活切换模型、社区生态 | vLLM |
| 极致吞吐、NVIDIA 硬件、生产固化 | TensorRT-LLM + Triton |
| 国产/非 NVIDIA 卡(昇腾、昆仑) | 对应厂商推理引擎 |
七、调优参数
| 参数 | 作用 | 建议 |
|---|---|---|
max_batch_size |
最大并发 | 按显存设到 64/128 |
max_num_tokens |
总 token 预算 | 影响 In-Flight 调度 |
paged_kv_cache |
分页 KV | 必须 enable |
| 量化精度 | 性能/精度权衡 | H100 FP8,A100 INT8 |
tp_size |
张量并行度 | 卡数或能整除层数的组合 |
常见坑
-
tp_size 不整除:70B 用 tp=4 可以(每层 70 层/4=17.5 不整除?实际按 hidden 维切,没问题),但 tp=3 会报错
-
max_seq_len 设太小:长上下文直接截断
-
INT8 精度掉点:用 SmoothQuant 校准集,否则激活值溢出
-
Triton 队列延迟 :
max_queue_delay_microseconds调大可提升批大小但增延迟
八、总结
TensorRT-LLM 是 NVIDIA 生态下的大模型推理性能天花板:
-
算子融合 + In-Flight Batching + PagedAttention + 量化,四管齐下
-
A100 上 Llama-3-70B 高并发吞吐比 HF 原生快约 10 倍
-
部署链路:convert_checkpoint → trtllm-build → trtllm-serve/Triton
-
代价是部署复杂度和硬件绑定,需要权衡
下一篇预告:量化部署是推理优化的重头戏------AWQ 与 GPTQ 在 TensorRT-LLM / vLLM 上的落地差异,以及端侧 INT4 推理,下期继续。
往期回顾:
关注获取更新:本文属于「AI 推理优化实战」专栏,点击关注获取推理加速系列后续内容。