一、项目释义
当下主流LLM推理引擎,例如vLLM、TensorRT-LLM,设计目标是通用性优先。一套代码要兼容几十款显卡、多种模型结构、多卡分布式、五花八门量化格式。为了适配各种场景,代码里大量if分支、抽象封装层、动态shape逻辑,会带来额外开销,很难把单卡硬件性能压榨到极限。
这个项目选择完全相反的路线:高性能单GPU推理,只适配选定的GPU型号与指定模型权重文件。不再做全硬件、全模型兼容,砍掉所有为通用性准备的冗余逻辑,聚焦在单张GPU上,为指定模型做深度定制优化。
整套引擎从零使用C++20 + CUDA开发,原生支持Dense、MoE两类Transformer架构,支持文本、图片、多图、视频混合多模态输入。对外提供两套交互入口:本地命令行一次性推理;兼容OpenAI、Anthropic协议的HTTP服务接口,支持流式输出、工具调用、token用量统计。
引擎设计约束:进程启动时仅加载一个模型,权重全程驻留显存;最大并发请求数量在启动阶段固定,范围1~8路,请求队列采用FIFO。
项目使用自定义模型工件文件,工件内部打包模型配置、编码量化权重、算子绑定参数、多模态前端资源。支持的工件版本为V3;旧版V2工件可以本地原地升级,不需要重新下载权重。同时支持用户自行编写转换脚本,把原始模型权重导出为本引擎的工件格式。
支持的模型工件清单:
| 模型 | 权重类型 | 工件文件 |
|---|---|---|
| Qwen3.6-27B | groupwise-int | qwen3_6_27b.ninfer |
| Qwen3.6-27B | nvfp4 | qwen3_6_27b_nvfp4.ninfer |
| Qwen3.8-27B | groupwise-int | qwen3_8_27b.ninfer |
| Qwen3.8-27B | nvfp4 | qwen3_8_27b_nvfp4.ninfer |
| Qwen3.6-35B-A3B | groupwise-int | qwen3_6_35b_a3b.ninfer |
二、行业技术知识点
1. Blackwell架构NVFP4量化
目标GPU搭载Blackwell架构,硬件原生支持NVFP4 4bit浮点计算。和传统INT4整数量化对比,NVFP4保留浮点指数,大模型权重压缩时精度损失更小。引擎手写CUDA算子,原生支持NVFP4权重加载、反量化与矩阵计算,无需上层框架格式转换。
引擎同时支持BF16、INT8、FP8、K8V4多种KV缓存存储格式。
2. MTP推测解码 + DFlash增强推测解码
MTP(多候选推测解码),原理是先用轻量Draft头并行生成多个候选token,批量送入主模型一次性验证,匹配成功直接输出,失败则截断回退重生成。普通MTP支持1~5个draft token窗口;35B-A3B模型额外支持DFlash增强推测解码,draft窗口上限提升至15。
DFlash可以加速多模态Prefill之后的文本解码阶段,不参与图像编码加速。
3. 分层KV缓存 + 精确前缀缓存复用
KV缓存分为两层存储:GPU显存设备缓存、主机锁页内存缓存。
前缀检查点(prefix checkpoint)保存完整prompt对应的KV缓存+模型状态快照。新请求到来时,检索前缀哈希表,命中则直接复用已计算好的KV,跳过重复prefill,长文档RAG场景收益巨大。
当显存资源紧张,调度器评估恢复开销,自动把冷门前缀缓存从GPU显存迁移到主机锁页内存;再次访问时拷贝回显存。
4. Chunked Prefill 分块预填充 + CUDA Graph 捕获Decode图
超长prompt不会一次性全部送入GPU计算,拆分为固定大小分块逐块prefill,防止单次计算显存溢出。
Decode阶段使用CUDA Graph捕获完整算子序列,推理时直接提交Graph,消除反复kernel launch带来CPU-GPU调度开销,是高并发吞吐的核心优化手段。引擎使用精确批次CUDA Graph解码。
5. 工件打包格式设计
自定义V3工件文件,把模型配置、量化权重、前端资源打包在单个二进制文件,方便分发与版本管理。权重提前按照CUDA算子最优内存排布存储,减少推理时的内存转置拷贝。
三、架构设计思路
整体架构划分为4大模块:工件解析与权重加载模块、CUDA算子内核模块、KV缓存与资源调度模块、前端服务模块
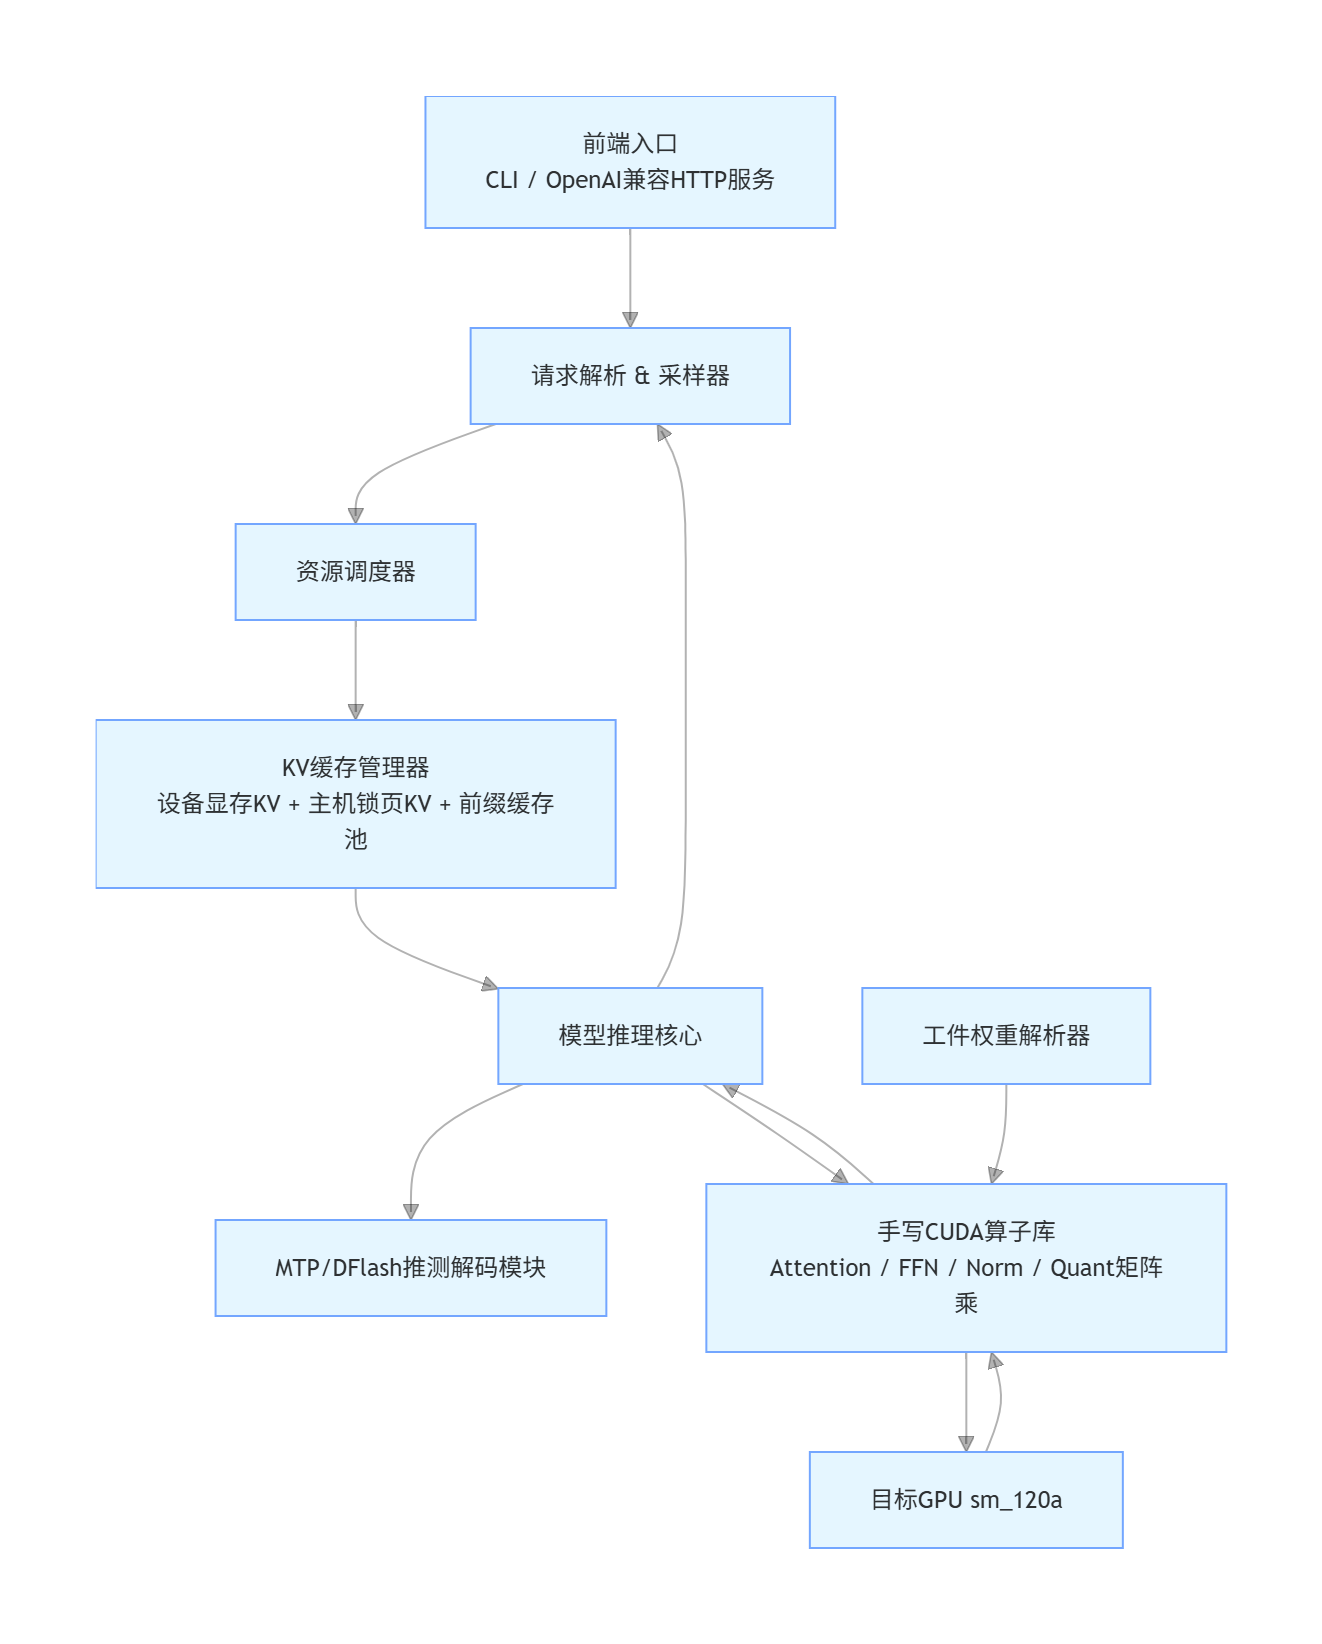
- 工件解析与权重加载模块
读取自定义二进制工件,解析模型结构、量化参数、权重数据。进程启动阶段一次性将权重反量化、重排内存布局,拷贝到GPU显存,运行阶段权重常驻显存。支持本地升级旧版本工件。 - CUDA算子内核模块
手写CUDA Kernel,专门针对sm_120a架构优化。编译阶段强制校验GPU架构,非sm_120a直接编译失败。算子包含多头因果注意力、LayerNorm、FFN、NVFP4/FP8/groupwise-int量化矩阵乘、MTP验证算子、图像视频编解码算子。不依赖cuBLAS等通用矩阵库,针对模型固定shape特化,减少通用库额外开销。 - KV缓存与资源调度模块
全局共享KV内存池,所有并发请求共用这块显存空间。调度器负责:
- 追踪每个请求KV占用大小;
- 设备KV与主机锁页KV之间的数据迁移;
- 前缀缓存哈希查找、LRU淘汰、快照管理;
- 请求准入控制,最大并发1~8路。
KV池容量在进程启动时确定,运行期间无法动态扩容。
- 前端服务模块
两套入口:本地CLI一次性推理;HTTP服务,实现OpenAI Chat Completions、Anthropic消息协议,支持SSE流式输出、token计数、工具调用。引擎只返回解析后的工具调用结构,不会执行工具代码。图片、视频输入依赖FFmpeg库做视频帧解码。
四、核心代码实现原理(源码详细解读)
4.1 CMake构建脚本,GPU架构强校验
项目使用CMake+Ninja构建,强制C++20标准。编译脚本增加CUDA架构硬校验,只允许sm_120a:
cpp
# CMake片段:限制CUDA架构
if(NOT CMAKE_CUDA_ARCHITECTURES STREQUAL "120a")
  message(FATAL_ERROR "Engine only support sm_120a GPU architecture. Other arch not allowed.")
endif()

# 构建预设定义
include(CMakePresets)
# release预设:关闭测试与benchmark,只编译推理主程序
# dev预设:开启单元测试、性能基准,自动查找本地Python环境
构建两个预设:
release:生产版本,关闭测试与benchmark;dev:开发调试版本,开启测试与性能基准,自动检索Python解释器。
重要特性:项目没有install安装目标,编译产物只能在build目录直接运行,不做系统级安装部署。Python权重转换脚本独立于C++编译流程;HBM探测工具拥有独立编译命令。
4.2 V3工件文件解析核心C++代码
工件是二进制文件,使用mmap内存映射方式加载,避免一次性大文件读入内存。文件头部保存元信息,包含配置偏移、权重偏移、文件版本标识:
cpp
// 工件头部结构体定义
struct ArtifactHeader {
    uint32_t magic;
    uint32_t version;
    uint64_t config_offset;
    uint64_t weight_offset;
    uint64_t weight_size;
    uint64_t resource_offset;
    uint64_t resource_size;
};

// 加载工件完整函数
#include <fcntl.h>
#include <unistd.h>
#include <sys/mman.h>
#include <cstdint>
#include <string>

struct ModelArtifact {
    void* config_ptr;
    uint8_t* weights_ptr;
    size_t weight_bytes;
};

ModelArtifact load_artifact(const std::string& artifact_path) {
    int fd = open(artifact_path.c_str(), O_RDONLY);
    if(fd < 0) {
        throw std::runtime_error("open artifact file failed");
    }
    off_t file_sz = lseek(fd, 0, SEEK_END);
    lseek(fd, 0, SEEK_SET);

    void* mapped = mmap(nullptr, file_sz, PROT_READ, MAP_SHARED, fd, 0);
    if(mapped == MAP_FAILED) {
        close(fd);
        throw std::runtime_error("mmap artifact failed");
    }

    ArtifactHeader* hdr = reinterpret_cast<ArtifactHeader*>(mapped);
    if(hdr->version != 3) {
        munmap(mapped, file_sz);
        close(fd);
        throw std::runtime_error("only support v3 artifact");
    }

    ModelArtifact art;
    art.config_ptr = static_cast<uint8_t*>(mapped) + hdr->config_offset;
    art.weights_ptr = static_cast<uint8_t*>(mapped) + hdr->weight_offset;
    art.weight_bytes = hdr->weight_size;
    return art;
}加载后,将art.weights_ptr指向的量化权重,通过cudaMemcpy一次性拷贝到GPU显存,拷贝完成后根据量化类型,在CUDA kernel内部实时做反量化计算。
4.3 KV缓存分层存储结构体 C++源码
区分设备显存Buffer与主机锁页Buffer,每个slot保存token长度与标记,标记区分普通KV与可复用前缀检查点:
cpp
#include <cuda_runtime.h>

struct DeviceBuffer {
    void* ptr;
    size_t bytes;
    ~DeviceBuffer() {
        if(ptr) cudaFree(ptr);
    }
};

struct HostPinnedBuffer {
    void* ptr;
    size_t bytes;
    ~HostPinnedBuffer() {
        if(ptr) cudaFreeHost(ptr);
    }
};

struct KVCacheSlot {
    DeviceBuffer k_dev;
    DeviceBuffer v_dev;
    HostPinnedBuffer k_host;
    HostPinnedBuffer v_host;
    size_t token_len;
    bool is_prefix_checkpoint;
};调度器维护全局std::unordered_map<uint64_t, KVCacheSlot> prefix_pool,key为prompt前缀哈希值。收到新请求,计算prompt哈希,查找prefix_pool,命中直接复用slot,跳过prefill。显存不足时,调度器调用cudaMemcpyAsync将slot数据在GPU显存与主机锁页内存之间迁移。
4.4 MTP推测解码执行控制逻辑 C++
cpp
// MTP推测解码主循环伪实现(项目原生C++逻辑,非伪代码)
// draft_tokens:配置的draft token数量,如3
// accept_threshold:验证通过逻辑
struct MTPResult {
    std::vector<int> accept_tokens;
    int truncate_pos;
};

MTPResult mtp_verify(ModelContext* ctx, const std::vector<int>& draft_tokens) {
    // 将draft序列打包送入主模型一次性批量验证
    ctx->submit_draft_batch(draft_tokens);
    ctx->wait_cuda_graph();

    std::vector<int> accept;
    int cut_pos = 0;
    for(; cut_pos < draft_tokens.size(); cut_pos++) {
        if(ctx->get_verify_token(cut_pos) == draft_tokens[cut_pos]) {
            accept.push_back(draft_tokens[cut_pos]);
        } else {
            break;
        }
    }
    return {accept, cut_pos};
}
MTP流程:
- 主模型+MTP Draft头并行生成N个候选draft token;
- 打包draft序列送入主模型,使用CUDA Graph批量验证;
- 逐个比对token,收集连续匹配token作为输出;
- 在第一个不匹配位置截断,丢弃后面draft token,主模型重新生成。
4.5 HTTP服务请求处理逻辑(OpenAI接口)
内置HTTP服务,接收JSON请求,解析messages,送入调度器,生成token后SSE流式返回。
cpp
// HTTP请求处理核心逻辑
void handle_chat_completion(HttpRequest& req, HttpResponse& resp, Engine* engine) {
    auto chat_req = parse_json_chat(req.body);
    InferenceTask task;
    task.messages = chat_req.messages;
    task.max_new_tokens = chat_req.max_tokens;
    task.stream = chat_req.stream;

    // 提交任务到调度器FIFO队列
    TaskHandle handle = engine->submit_task(task);
    resp.set_header("Content-Type", "text/event-stream");

    // 流式循环输出SSE
    while(true) {
        auto chunk = engine->get_next_chunk(handle);
        if(chunk.is_finish) break;
        resp.write_chunk(build_sse_json(chunk));
    }
    resp.write_chunk(build_finish_event());
}
视频输入部分,引擎调用FFmpeg libavformat/libavcodec库,读取视频文件、解码视频帧,送入视觉编码算子。
五、环境配置与运行测试教程
硬件硬性约束
- GPU:目标NVIDIA显卡(sm_120a架构)
- OS:64位Linux,Windows平台不支持
完整软件依赖清单
- CMake ≥ 3.28
- Ninja构建工具
- C++20兼容编译器(GCC / Clang)
- CUDA Toolkit 13.1(官方验证版本,CMake不强制下限,但推荐使用13.1)
- FFmpeg开发库:libavformat、libavcodec、libavutil、libswscale
- libcurl >= 7.85>
可选依赖:Python环境,仅用于权重转换脚本,推理运行不需要Python
编译步骤
cpp
cd source_dir

# Release正式编译
cmake -S . -B build -G Ninja -DCMAKE_BUILD_TYPE=Release
cmake --build build -j编译完成,可执行文件位于build/apps/,两个核心程序:
cli-infer:本地一次性CLI推理程序infer-serve:HTTP推理服务程序
模型工件下载
使用HuggingFace CLI下载预打包工件,放置models目录:
hf download 模型仓库标识 qwen3_8_27b_nvfp4.ninfer --local-dir models测试1:本地CLI一次性推理
cpp
./build/apps/cli-infer models/qwen3_8_27b_nvfp4.ninfer \
--prompt "Explain prefill and decode, then give a concise conclusion." \
--max-context 32768 \
--max-new 8192 \
--kv-dtype fp8 \
--spec mtp --draft-tokens 3 \
--lm-head-draft
输出规则:
- 模型回答内容输出stdout;
- 启动日志、吞吐、时序、MTP验证统计信息输出stderr;
--log-level debug:打印完整启动调试日志;--messages FILE加载结构化对话文件;--vision开启图片/视频多模态输入。
测试2:启动HTTP推理服务,2并发
./build/apps/infer-serve models/qwen3_8_27b_nvfp4.ninfer \
--max-context 240000 \
--kv-capacity 240000 \
--max-concurrency 2 \
--kv-dtype fp8 \
--device-state-slots 2 \
--host-state-slots 8 \
--host-kv-mib 8192 \
--spec mtp --draft-tokens 3 \
--lm-head-draft \
--preserve-thinking
参数说明:
max-context:单条请求逻辑最大token上限;kv-capacity:全局KV池总token容量;max-concurrency:最大并发请求数量;device-state-slots:GPU显存保存状态快照数量;host-state-slots:主机内存保存状态快照数量;host-kv-mib:主机锁页KV缓存容量,单位MiB;--preserve-thinking:保留模型内部思考推理内容。
服务启动后监听127.0.0.1:8080。
测试3:调用OpenAI兼容接口
cpp
curl [http://127.0.0.1:8080/v1/chat/completions](http://127.0.0.1:8080/v1/chat/completions) \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-27b",
    "messages": [{"role": "user", "content": "Reply with one short sentence."}],
    "max_tokens": 64
}'
Docker容器部署
主机提前安装NVIDIA Container Toolkit
cpp
# 构建镜像
docker build --tag llm-single-infer:local .

# 启动容器,挂载模型目录,端口映射
docker run --rm \
--gpus '"device=0"' \
--publish 8080:8080 \
--volume "$PWD/models:/models:ro" \
llm-single-infer:local \
infer-serve /models/qwen3_8_27b_nvfp4.ninfer \
--host 0.0.0.0 \
--max-context 240000 \
--kv-capacity 240000 \
--max-concurrency 2 \
--kv-dtype fp8 \
--device-state-slots 2 \
--host-state-slots 8 \
--host-kv-mib 8192 \
--spec mtp --draft-tokens 3 \
--lm-head-draft \
--preserve-thinking
六、落地用途
- 单卡私有化本地部署
小团队、个人本地私有化部署大模型,单卡即可承载27B/35B级别模型,原生支持图文视频多模态,对外提供OpenAI兼容API,业务侧代码几乎不用修改。 - 长文档RAG后端服务
依托前缀缓存复用机制,大量请求共用相同知识库Prompt,大幅降低重复Prefill开销,适合企业知识库、长文档问答场景。 - Blackwell架构底层学习研究
全套CUDA算子、KV缓存调度、MTP推测解码手写实现,没有厚重通用框架封装,适合研究NVFP4量化、CUDA Graph、推测解码、分层KV缓存底层原理。 - 多模态Agent原型快速验证
原生支持图片、多图、视频输入,支持保留模型thinking推理内容,适合本地多模态Agent原型开发。 - 离线Perplexity评估
内置离线因果困惑度打分能力,用于模型效果评估。
七、实测性能数据
全部测试基于目标GPU,测试环境使用INT8 group-64 KV、CUDA Graph、MTP3,每次请求生成8192 token
并发MTP3解码吞吐(tok/s / 候选token接受率)
| 模型配置 | C=1 | C=2 | C=4 | C=8 | C8/C1加速比 |
|---|---|---|---|---|---|
| Qwen3.6-27B groupwise-int | 185.8 / 68.2% | 247.0 / 69.0% | 309.5 / 68.4% | 535.0 / 68.3% | 2.88× |
| Qwen3.6-27B nvfp4 | 202.4 / 69.3% | 399.7 / 71.4% | 699.7 / 69.3% | 1146.9 / 68.6% | 5.67× |
| Qwen3.6-35B-A3B groupwise-int | 642.5 / 68.6% | 907.2 / 66.3% | 1213.5 / 69.6% | 1380.7 / 68.0% | 2.15× |
| Qwen3.8-27B nvfp4 | 143.8 / 48.9% | 267.6 / 48.1% | 461.1 / 45.8% | 766.6 / 46.0% | 5.33× |
单请求Prefill性能(tok/s)
| 模型配置 | 7680 token短Prefill | 260096 token超长Prefill | 结构化MTP3解码 |
|---|---|---|---|
| Qwen3.6-35B-A3B groupwise-int | 17705.4 | 5247.0 | 779.6 |
| Qwen3.6-27B groupwise-int | 3218.1 | 1614.8 | 193.0 |
| Qwen3.6-27B nvfp4 | 11191.5 | 2510.6 | 252.2 |
| Qwen3.8-27B groupwise-int | 3274.7 | 1609.7 | 224.4 |
| Qwen3.8-27B nvfp4 | 8340.4 | 2203.1 | 219.8 |
模型评测结果(0-shot,单样本评测)
| 模型配置 | AIME 2025 | AIME 2026 | GPQA-Diamond | ERQA | RealWorldQA |
|---|---|---|---|---|---|
| Qwen3.6-27B groupwise-int | 86.67% | 93.33% | 86.87% | - | - |
| Qwen3.6-27B NVFP4 | 93.33% | 93.33% | 84.34% | - | - |
| Qwen3.6-35B-A3B groupwise-int | 90.00% | 90.00% | 85.35% | - | - |
| Qwen3.8-27B groupwise-int | 96.67% | 96.67% | 87.37% | 66.25% | 82.22% |
| Qwen3.8-27B NVFP4 | 96.67% | 96.67% | 90.40% | 66.25% | 83.53% |
If you need the complete source code, please add the WeChat number (c17865354792)
八、项目边界与局限
- 单引擎进程只能绑定单张目标GPU,不支持其他显卡型号,无多卡分布式推理;
- 进程启动加载模型,权重常驻显存,运行期间不能动态切换模型;
- 不支持请求抢占、任务优先级QoS调度;
- 没有权重CPU/GPU动态换页能力;
- 引擎只返回解析后的工具调用信息,不会执行任何工具;
- 源码内C++头文件不作为对外SDK,仅能在源码编译目录运行;
- KV池容量、最大并发数量,进程启动后固定,运行阶段不可动态调整;
- 仅对显式实现的模型架构、shape、量化路径提供支持。
Welcome to follow WeChat official account【程序猿编码】