在数字化时代,互联网上沉淀了海量的数据。如何高效、自动地获取这些公开数据,是数据分析、机器学习等领域的重要前提。本文将介绍网络机器人(网络爬虫)的基础概念、合规抓取准则、网页的基本组成结构,以及如何使用 Python 中的 requests 库完成一次基础的数据获取实践。
一、 网络机器人与数据清洗概述
在了解爬虫技术之前,我们需要明确"网络机器人"与"数据清洗"这两个核心概念。
1. 什么是网络机器人?
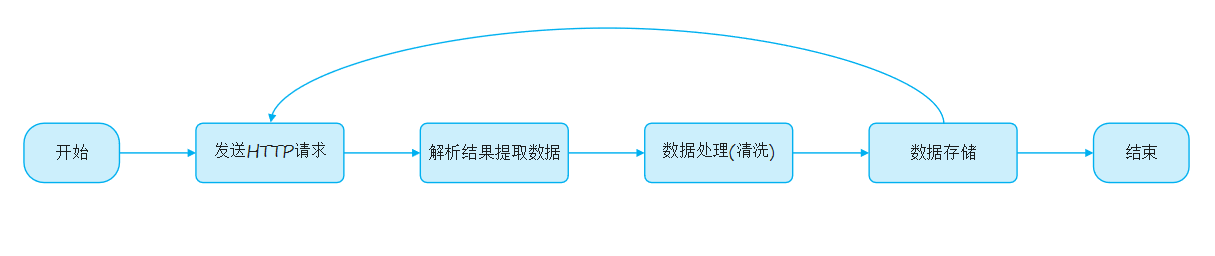
网络机器人 (Network Robot),在数据采集领域通常被称为网络爬虫 (Web Scraper)或网页蜘蛛(Web Spider)。它是一种按照预设规则,自动浏览网络并抓取公开网页数据的程序或脚本。其基本工作流程通常包括:发送请求 -> 获取响应 -> 解析内容 -> 存储数据。
2. 什么是数据清洗?
从网络上直接抓取下来的原始数据(Raw Data)往往夹杂着大量的 HTML 标签、多余空格、乱码或无效信息。
数据清洗(Data Cleaning)是指对这些采集到的原始数据进行处理、修正、转换和标准化的过程。
- 目的:去除噪声,让数据变得规范、准确,以便后续的数据分析或入库存储。
二、 爬虫界的君子协定:Robots 协议
在互联网中进行数据采集时,必须遵守一定的行业规范与道德底线。Robots 协议就是其中最重要的一项"君子协定"。
1. 什么是 Robots 协议?
Robots 协议(全称 Robots Exclusion Protocol,爬虫协议/规则)通常是网站根目录下存放的一个名为 robots.txt 的纯文本文件。它用于告诉网络爬虫哪些页面可以抓取,哪些页面不能抓取。
2. robots.txt 的常见指令总结
你可以通过在网站主域名后添加 /robots.txt(例如 https://www.tiobe.com/robots.txt)来查看该网站的抓取规则。常见的指令项如下表所示:
| 指令 (Directive) | 作用说明 | 示例 |
|---|---|---|
| User-Agent | 指定该规则适用的爬虫身份。* 代表所有爬虫。 |
User-Agent: * |
| Disallow | 不允许访问的资源或路径。 | Disallow: /admin/ |
| Allow | 允许访问的资源或路径(通常用于在 Disallow 目录中排除特例)。 | Allow: /admin/public/ |
| Sitemap | 网站地图的 URL,方便爬虫快速检索整站结构。 | Sitemap: https://xxx.com/sitemap.xml |
| Crawl-delay | 限制爬虫两次访问之间的时间间隔(单位:秒),防范服务器过载。 | Crawl-delay: 5 |
三、 网页的基石:前端网页结构
要想精准地从网页中提取数据,必须理解网页的构成。一个标准的网页通常由以下三部分组成,它们各司其职,共同构建了我们在浏览器中看到的用户界面:
| 组成部分 | 全称/简称 | 核心职责 | 比喻 |
|---|---|---|---|
| HTML | HyperText Markup Language(超文本标记语言) | 负责网页的结构。定义页面上的文字、标题、图片、视频等内容元素。 | 房屋的钢筋混凝土骨架 |
| CSS | Cascading Style Sheets(层叠样式表) | 负责网页的表现。定义元素的外观、位置、颜色、大小、布局等。 | 房屋的装修与刷漆 |
| JS | JavaScript | 负责网页的行为。实现页面元素的交互效果、动态数据加载、按钮点击事件等。 | 房屋中的电器和开关系统 |
深入理解 HTML
- 超文本:指它超越了普通文本的限制,除了文字外,还可以定义图片、音频、视频、超链接等丰富的内容形式。
- 标记语言 :由一堆预定义好的标签(如
<h1>、<img>、<video>等)构成的语言。这些标签不直接显示在页面上,而是由浏览器进行解析,并转化为用户可见的视觉元素。
四、 Python Requests 库基础与实战
在 Python 生态中,进行 HTTP 网络请求最基础且实用的库之一就是 requests。
1. Requests 库的作用
requests 是一个优雅且简单的 HTTP 客户端库。它封装了底层复杂的网络连接细节,允许开发者通过极其简短的代码发送 GET、POST 等各种 HTTP 请求,并轻松获取响应状态码、响应头以及网页源码。
2. 环境安装
在使用前,需要通过 Python 的包管理器 pip 进行安装:
bash
pip install requests3. 代码实践:访问 TIOBE 网站获取数据
下面是一段基础的 Python 脚本,演示了如何请求 TIOBE(一家著名的编程语言流行度指数网站)的主页并输出其 HTML 源码。
python
import requests

# 1. 定义目标 URL
# TIOBE 指数排行榜可以反映编程语言的流行趋势
target_url = "https://www.tiobe.com/tiobe-index/"

# 2. 发送 GET 请求
# requests.get() 会向目标服务器发起一个 HTTP GET 请求,并返回一个 Response 对象
response = requests.get(target_url)

# 3. 输出响应状态码与网页内容
# response.status_code 用于检查请求是否成功(200 表示成功)
print(f"响应状态码: {response.status_code}")

# response.text 包含了服务器返回的 HTML 文本数据
print("--- 网页源码前 500 个字符 ---")
print(response.text[:500])
4. 代码逻辑简析
- 导入模块 :首先导入
requests模块。 - 设置目标 :将变量
target_url设定为我们需要抓取的 TIOBE 排行榜页面。 - 发起请求 :调用
requests.get(target_url)。此时,Python 程序模拟浏览器的行为,向 TIOBE 服务器请求该页面。服务器处理后,将网页的 HTML 骨架作为响应返回给我们的程序。 - 打印输出 :通过
response.text获取网页源码。通过这些源码,后续我们可以使用解析库(如BeautifulSoup或lxml)提取出具体的编程语言排名数据。
五、 总结与注意事项
- 合规合规再合规 :在编写网络机器人时,务必首先阅读目标网站的
robots.txt,避开禁止抓取的目录。 - 控制访问频率:不要短时间内发起高频请求,这不仅可能导致对方服务器不堪重负,也极易导致您的 IP 被网站防火墙封禁。
- 模拟浏览器 :在实际开发中,许多网站会拦截没有携带
User-Agent的请求。后续可以通过在requests.get()中添加headers参数来模拟真实浏览器。