一、RAGFlow 是什么
RAGFlow 是一个开源的 RAG(Retrieval-Augmented Generation,检索增强生成)引擎。它的核心目标是将企业内部或个人的私有文档转化为可供大语言模型(LLM)使用的结构化知识,从而让 LLM 在回答问题时能够引用这些文档中的真实内容,而不是仅依赖训练时的固定知识。
与简单的向量数据库不同,RAGFlow 提供了一套完整的数据处理流程:从文档上传、深度解析、智能分块、向量索引,到混合检索、重排序,最后与 LLM 结合生成带引用的回答。它特别强调对复杂文档(如扫描版 PDF、表格、图片、PPT 等)的深度理解能力。
二、什么背景下建议使用
建议在以下场景中选择 RAGFlow:
- 不想从零搭建 RAG 基础设施 如果你需要 RAG 能力,但不想自己处理文档解析、分块策略、向量索引、检索优化、提示词工程等一系列底层细节,RAGFlow 提供了开箱即用的完整方案。你只需上传文档、配置模型,即可快速获得生产级的检索增强生成能力。
- 需要基于私有文档的问答系统 当你拥有大量内部文档(如产品手册、技术规范、法律法规、论文、邮件记录),希望构建一个能准确引用这些内容的智能问答助手时。RAGFlow 的混合检索机制在精确术语匹配上表现优于纯向量搜索。
- 文档格式复杂且多样 如果你的知识源包含扫描版 PDF、图文混排文档、Excel 表格、PPT 演示文稿等,RAGFlow 的深度文档解析能力(基于 OCR 和版面分析)能更准确地提取结构化内容。
- 需要可解释、带引用的回答 RAGFlow 的检索结果会附带来源文档、页码位置、相似度评分等元数据,便于用户验证回答的可靠性。这在医疗、法律、金融等高风险领域尤为重要。
- 希望避免供应商锁定RAGFlow 是开源的(Apache 2.0 协议),支持自托管。它实现了 MCP(Model Context Protocol),可以灵活对接不同的 LLM 和嵌入模型,不绑定特定云厂商。
- 需要构建多步骤的 Agent 工作流 RAGFlow 内置了可视化的 AI Agent 工作流构建器,支持将检索、推理、工具调用等步骤组合成复杂的自动化流程。
三、RAGFlow 的本质
RAGFlow 的本质是一个端到端的知识处理与检索服务平台,它包含三个核心层面:
数据层:负责将非结构化文档(PDF、Word、图片等)解析为结构化的文本块(Chunk),并生成向量嵌入和关键词索引。
检索层:提供混合检索能力,同时利用向量相似度(语义匹配)和 BM25(关键词匹配),再通过重排序模型对结果进行精排。
生成层:将检索到的文本块作为上下文,结合用户问题,调用 LLM 生成带引用的自然语言回答。
此外,RAGFlow 还提供了会话管理、Agent 编排、长期记忆等高级功能,使其不仅是一个 RAG 工具,更是一个完整的知识应用开发平台。
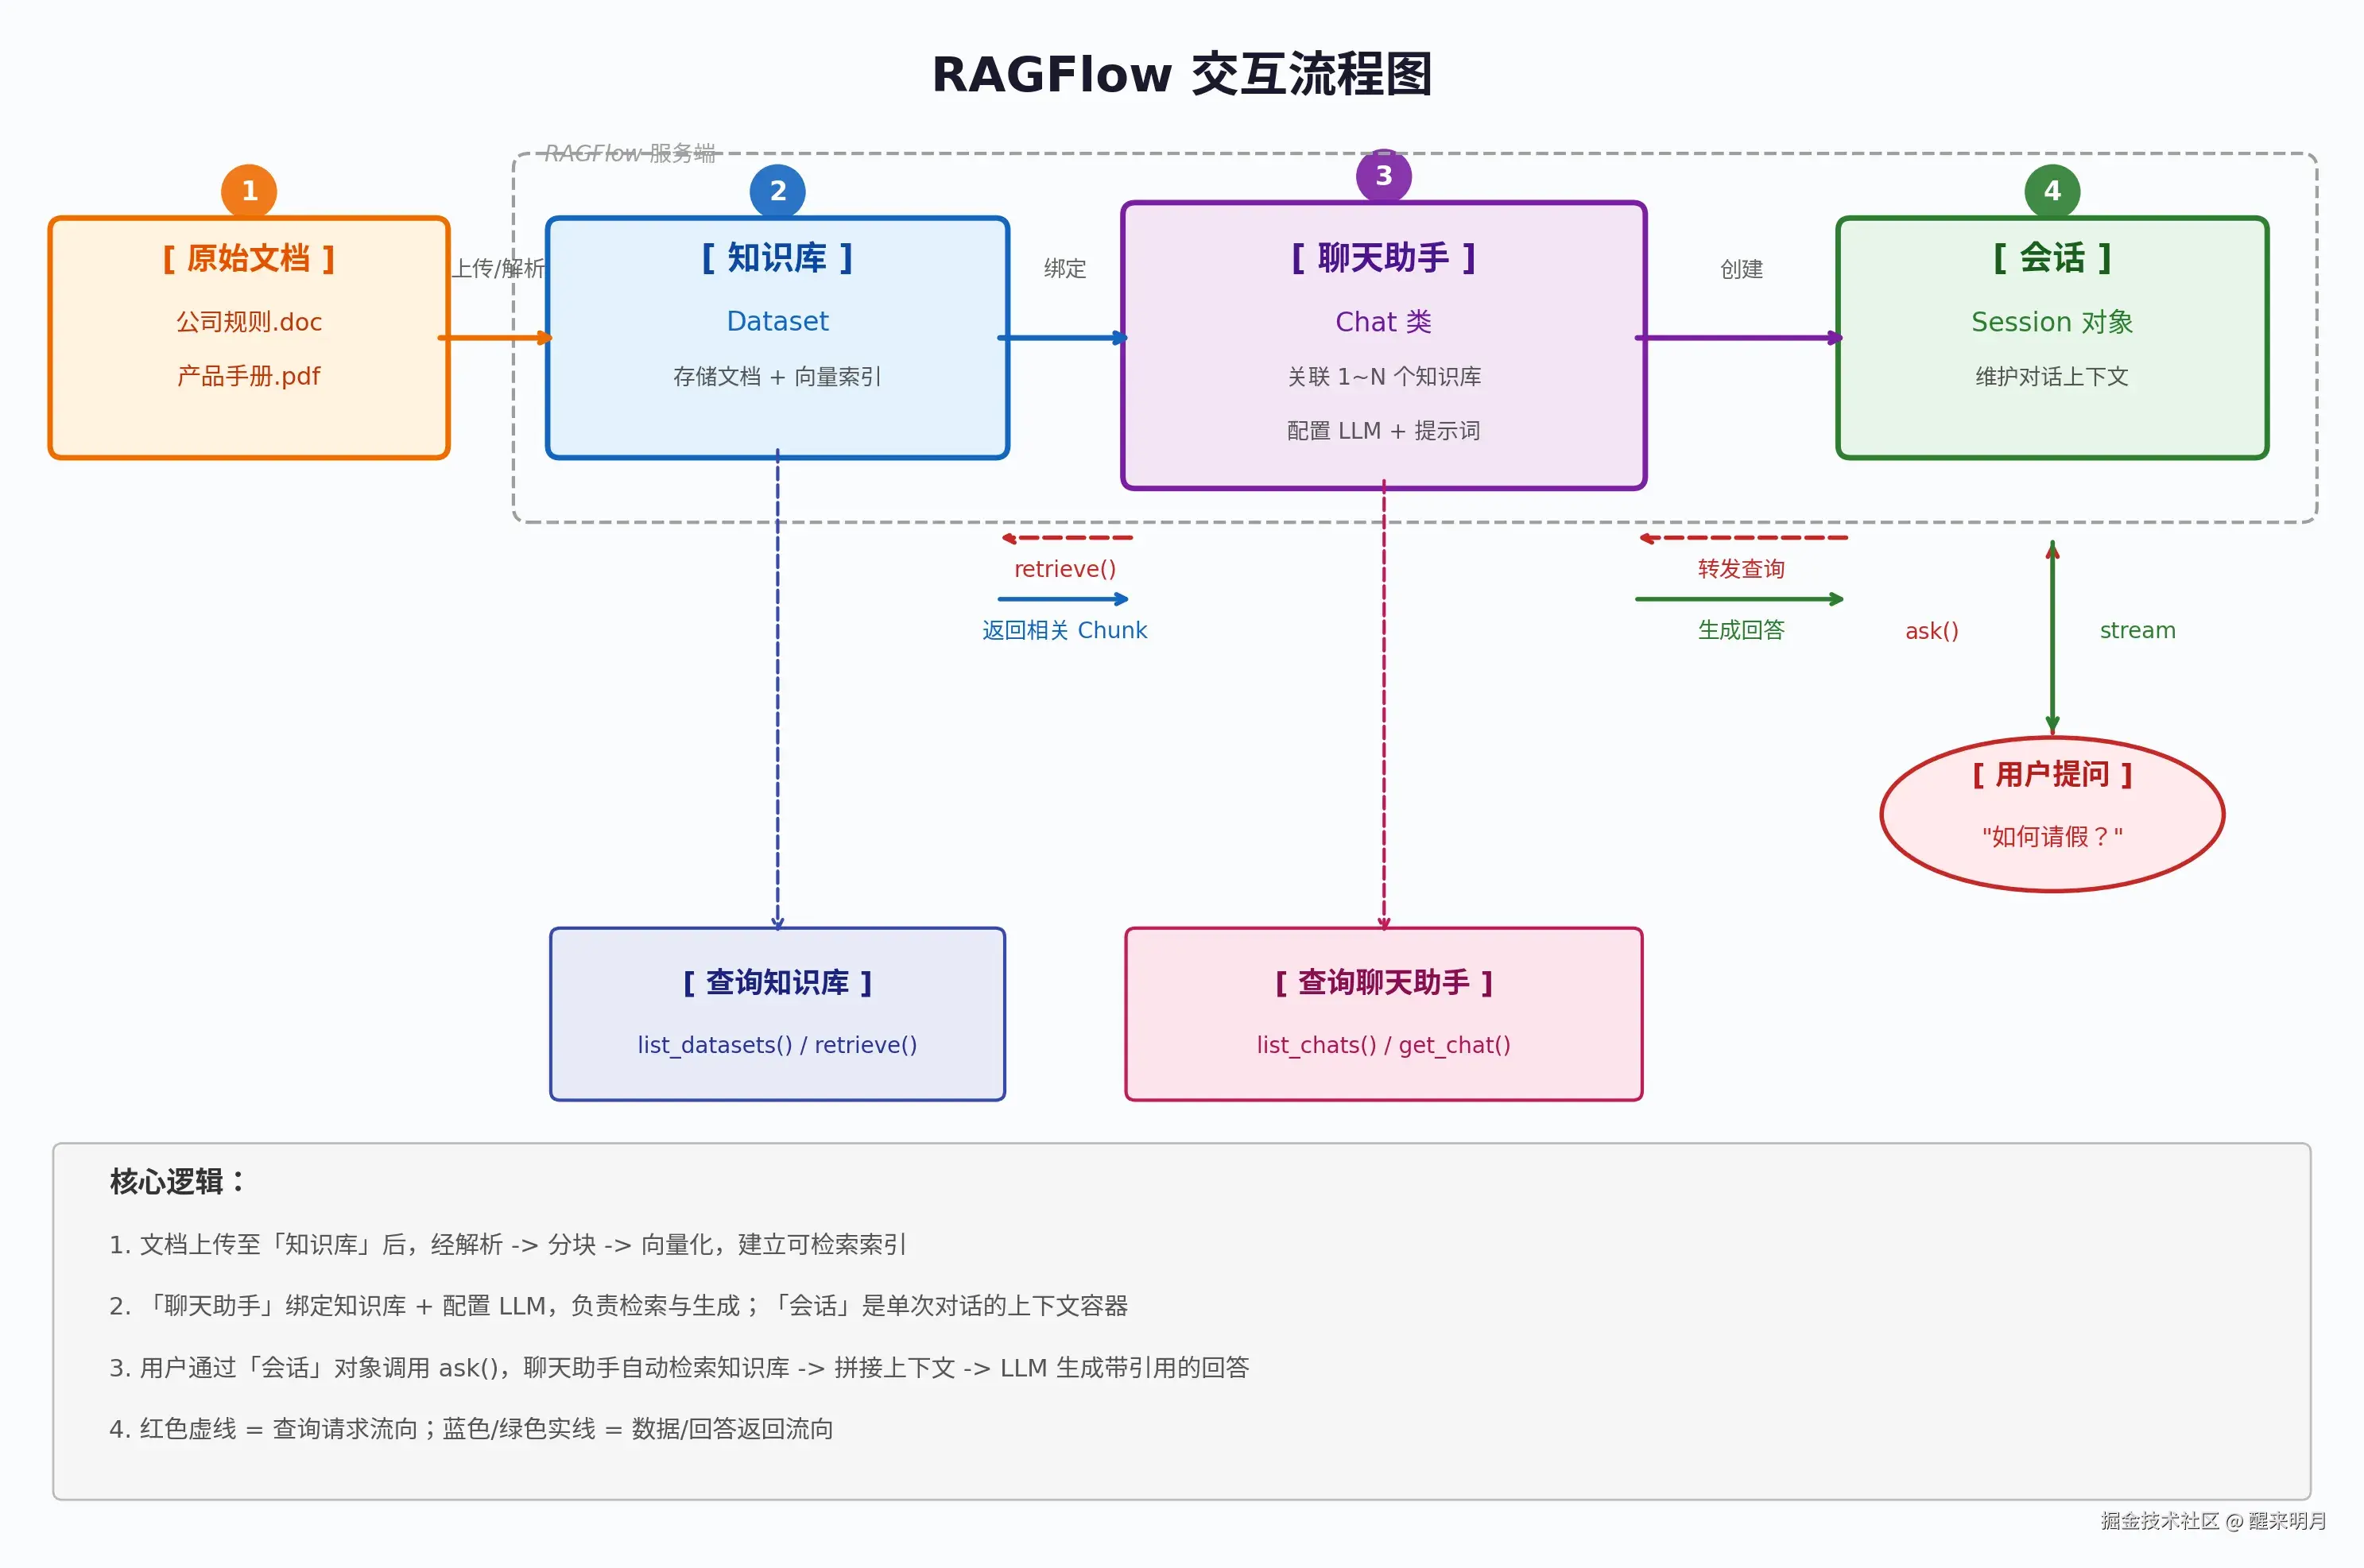
四、系统结构
RAGFlow 的系统由多个组件协同工作:
4.1 后端存储组件
- Elasticsearch / Infinity:负责存储文档的向量嵌入和倒排索引,执行混合检索。
- MySQL:存储元数据,包括用户信息、知识库配置、文档列表、会话记录等。
- Redis:用于缓存和任务队列,加速高频查询。
4.2 核心处理模块
- 文档解析器:支持多种文档类型的深度解析,包括版面识别、表格提取、OCR 文字识别。
- 分块器(Chunker) :提供 11 种分块策略(如通用模式、论文模式、书籍模式、表格模式、问答模式等),根据文档类型选择最优切分方式。
- 嵌入模型:将文本块转换为高维向量。
- 检索引擎:执行向量检索 + 关键词检索 + 重排序。
4.3 应用层概念
RAGFlow 在业务逻辑上围绕以下核心对象组织:
| 对象 | 说明 |
|---|---|
| Dataset(知识库) | 存储同一主题文档的集合,配置独立的嵌入模型和分块策略 |
| Document(文档) | 知识库中的单个文件,记录解析状态和元数据 |
| Chunk(块) | 文档被切分后的最小检索单元,包含文本、关键词、位置信息 |
| Chat(聊天助手) | 绑定一个或多个知识库,配置特定 LLM 和提示词的对话机器人 |
| Session(会话) | 与聊天助手或 Agent 的一次连续对话,维护上下文历史 |
| Agent(智能体) | 通过可视化画布编排的多步骤工作流,可包含检索、判断、工具调用等节点 |
| Memory(记忆) | 长期记忆存储,支持语义记忆、情景记忆、程序记忆等多种类型 |
五、架构设计
RAGFlow 的架构设计基于以下核心考量:
1. 深度文档理解优先于简单切分 传统 RAG 系统往往将文档粗暴地按固定长度切分,导致表格被拆散、段落上下文丢失。RAGFlow 针对不同类型的文档(论文、法律条文、书籍、邮件)设计了专门的解析和分块策略,确保语义单元的完整性。
2. 混合检索解决语义盲区 纯向量检索在处理专业术语、产品型号、法律条款编号等精确匹配需求时容易失效。RAGFlow 将向量检索与 BM25 关键词检索融合,并通过 RRF(Reciprocal Rank Fusion)或加权融合进行结果合并,显著提升了对精确术语的召回率。
3. 重排序提升精度 初步检索返回的结果可能包含大量噪声。RAGFlow 引入重排序(Rerank)模型,对候选结果进行二次精排,确保最相关的块排在前面,减少 LLM 的上下文窗口浪费。
4. 可视化降低 Agent 开发门槛 通过拖拽式画布构建工作流,非开发人员也能设计复杂的多跳检索、条件判断、工具调用逻辑,降低了 RAG 应用的工程门槛。
5. 模块化与可扩展性 各组件(解析器、嵌入模型、LLM、向量数据库)均可独立替换。用户可以根据数据特点选择不同的嵌入模型,或对接自托管的 LLM。
六、在 Python 项目中接入
在实际项目中,接入 RAGFlow 的核心思路是:创建知识库并上传文档 → 查询已配置好的资源 → 创建会话 → 发起对话。你不需要关心文档如何分块、向量如何检索,这些由 RAGFlow 服务端自动处理(这里不再赘述服务端部署步骤)。
6.1 安装 SDK
bash
uv add ragflow-sdk6.2 初始化客户端
python
from ragflow_sdk import RAGFlow

# 初始化 RAGFlow 客户端
# api_key: 在 RAGFlow 管理后台的 API 菜单中创建
# base_url: RAGFlow 服务的地址,默认端口 9380
rag = RAGFlow(
    api_key="your-api-key",
    base_url="http://your-ragflow-server:9380"
)
6.3 创建知识库并上传文档
python
# 1. 创建知识库
dataset = rag.create_dataset(
    name="公司产品文档",  # 知识库名
    description="存储所有产品相关的技术资料", # 描述
    chunk_method="naive",  # 通用分块策略
    embedding_model="BAAI/bge-large-zh-v1.5@BAAI" # 向量模型,name@provider
)

# 2. 上传文档
with open("./product_manual.pdf", "rb") as f:
    docs = dataset.upload_documents([
        {"display_name": "product_manual.pdf", "blob": f.read()}
    ])
6.4 查询已有的聊天助手
python
# 列出所有聊天助手
for assistant in rag.list_chats():
    print(f"ID: {assistant.id}, 名称: {assistant.name}")

# 或通过名称精确查找
assistants = rag.list_chats(name="产品客服助手")
assistant = assistants[0]

# 查看该助手绑定了哪些知识库
print(f"关联知识库 IDs: {assistant.dataset_ids}")
6.5 查询知识库信息
python
# 列出所有知识库
for dataset in rag.list_datasets():
    print(f"知识库: {dataset.name}, ID: {dataset.id}")

# 查看某个知识库下的文档列表
dataset = rag.list_datasets(name="产品手册库")[0]
for doc in dataset.list_documents():
    print(f"文档: {doc.name}, 状态: {doc.run}, 块数: {doc.chunk_count}")
6.6 创建会话并对话
这是最常见的接入模式。会话(Session)是单次连续对话的上下文容器,由聊天助手创建。
对某个助手发起提问: → 创建会话 → 提问 → 关闭会话
python
# 1. 获取聊天助手
chat = rag.list_chats(name="产品客服助手")[0]

# 2. 创建会话(可指定名称,也可留空自动生成)
session = chat.create_session(name="用户咨询-001")

# 3. 流式提问
question = "如何申请年假?"
print(f"用户: {question}\n")

# 4. 获取结果,注意结果是覆盖式的
response = session.ask(question=question,stream=True)
result = ""
# 流的每一部分的对象 part
for part in response:
# 数据存在对象中content上
  print(part.content)
  result = part.content

 # 5. 关闭会话
chat.delete_sessions(ids=[session.id])
6.7 非流式对话(一次性返回)
如果不需要打字机效果,可以直接获取完整回答:
python
message = session.ask("公司的报销流程是什么?", stream=False)
print(message.content)

# 查看引用
for ref in message.reference:
    print(f"来源: {ref.document_name}, 位置: {ref.position}")
6.8 使用 Agent
RAGFlow 还支持通过 Agent 进行更复杂的多步骤交互。接入方式与会话类似:
python
from ragflow_sdk import Agent

# 获取已发布的 Agent
agent = rag.get_agent("your-agent-id")

# 创建会话并对话
session = agent.create_session()
response = session.ask("帮我分析上个月的销售数据", stream=False)
print(response.content)
6.9 直接检索
只有在不经过聊天助手、直接查询知识库内容 的特殊场景下,才需要调用底层的 retrieve()。绝大多数业务场景通过上面的 session.ask() 即可满足。
python
# 直接检索知识库(返回 Chunk 列表)
chunks = rag.retrieve(
    dataset_ids=[dataset.id],
    question="保修政策",
    page_size=5
)
for chunk in chunks:
    print(chunk.content)
核心原则 :应用层代码只跟 Chat 和 Session 打交道,把 RAGFlow 当作一个"带知识检索能力的 LLM 服务"来调用。
七、数据存储
7.1 原始文档存储
上传的原始文件(PDF、Word 等)以二进制形式保存在对象存储或文件系统中,可通过 Document.download() 方法随时下载回原始文件。
7.2 向量与索引存储
解析后的文本块经过嵌入模型转换为向量,连同关键词索引一起存入 Elasticsearch 或 Infinity(RAGFlow 团队自研的高性能搜索引擎)。这决定了检索的速度和召回质量。
7.3 元数据存储
知识库配置、文档列表、解析状态、用户信息、会话历史等结构化数据存储在 MySQL 中。Redis 则用于缓存热点数据和任务调度。
7.4 记忆存储(Memory)
RAGFlow 支持长期记忆功能,可以按类型(原始对话、语义知识、情景事件、程序技能)存储用户与 Agent 的交互历史。记忆数据同样通过嵌入模型向量化后存储,支持语义检索和基于时间的遗忘策略(如 FIFO)。
八、查询机制详解
RAGFlow 的查询流程是一个多阶段流水线:
8.1 混合检索阶段
当用户输入问题时,系统同时执行:
- 向量检索:将问题向量化,在向量空间中寻找语义相近的文本块。
- 关键词检索(BM25) :提取问题中的关键词,通过倒排索引查找包含这些词的文档块。
8.2 结果融合阶段
将两种检索的结果通过加权融合或 RRF 算法合并为一个统一的结果列表。vector_similarity_weight 参数控制两者的权重分配。
8.3 重排序阶段
使用专门的 Rerank 模型(如 BGE-Reranker)对融合后的候选结果进行精排,计算问题与每个候选块的相关性分数,确保最相关的内容排在前面。
8.4 上下文构建阶段
从排序后的结果中选取 Top-N 个文本块,按格式组装成上下文,插入到 LLM 的系统提示词中。
8.5 生成阶段
LLM 基于提供的上下文生成回答。如果启用了引用(quote=True),系统会在回答中标注每个论断对应的来源文档和具体位置。
8.6 可调参数
similarity_threshold:过滤低质量检索结果。top_k:控制初始候选池大小。top_n:最终送入 LLM 的块数量。keyword:是否启用关键词检索。use_kg:是否启用知识图谱辅助的多跳检索。cross_languages:是否进行跨语言检索。
九、完整示例:构建一个最小可用系统
python
from ragflow_sdk import RAGFlow

def main():
    # 初始化
    rag = RAGFlow(api_key="your-key", base_url="http://localhost:9380")

    # 创建知识库
    ds = rag.create_dataset(
        name="技术文档库",
        chunk_method="naive",
        embedding_model="BAAI/bge-zh-v1.5@BAAI"
    )

    # 上传并解析文档
    with open("api_doc.pdf", "rb") as f:
        docs = ds.upload_documents([{"display_name": "api_doc.pdf", "blob": f.read()}])

    # 等待解析完成
    ds.parse_documents([d.id for d in docs])

    # 创建助手
    chat = rag.create_chat(
        name="API助手",
        dataset_ids=[ds.id],
        llm_id="glm-4-flash@ZHIPU-AI",
        prompt_config={"system": "你是一个API文档专家。", "quote": True}
    )

    # 对话
    session = chat.create_session()
    for msg in session.ask("如何获取用户列表?", stream=True):
        print(msg.content, end="", flush=True)

if __name__ == "__main__":
    main()
十、总结
RAGFlow 是一个面向生产环境设计的完整 RAG 平台。它的核心价值在于:
- 深度文档解析:不只是提取文字,而是理解文档结构。
- 混合检索:语义匹配与精确匹配相结合,减少漏召回。
- 端到端集成:从文档上传到对话生成,提供完整的 Python SDK 和 REST API。
- 可扩展架构:组件可替换,支持自托管和多云部署。