一起床🛏,就看到奥特曼的消息,说 Pro 能用 GPT-6 了!
我说:"关我 Plus 鸟事儿!",奥特曼做了👌的手势!
我的电脑立马就收到了这个弹窗!
GPT-6 已经就位了!
我看了一下他的模型选择,作为 Claude 用户,看到这个 Ultra 的选项和样式的时候,直呼内行!
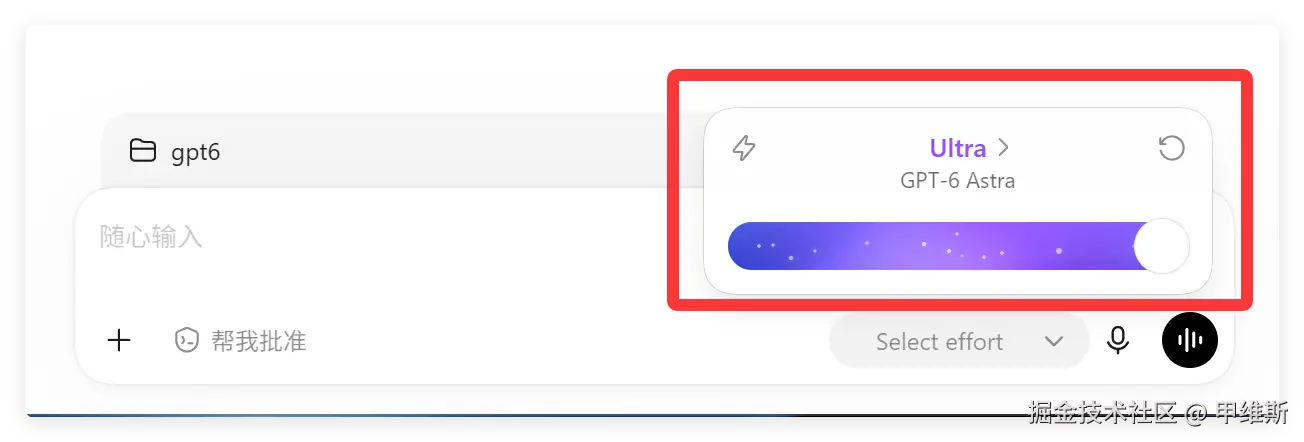
既然模型已经就位,就立马开测了。OpenAI 吹了无数次的 AGI,看看这次怎么样。
打开 Codex,选择 GPT-6,立马开测!
从我们之前的文章中可以知道,GPT-6 这次把 AGI3 几乎刷爆了。 我都有点不知道用什么题目来测试比较合适了。
我突然想到一题,这个题目看起来很简单,测试也很简单,但是做对却很难。
这个题目是这样的:
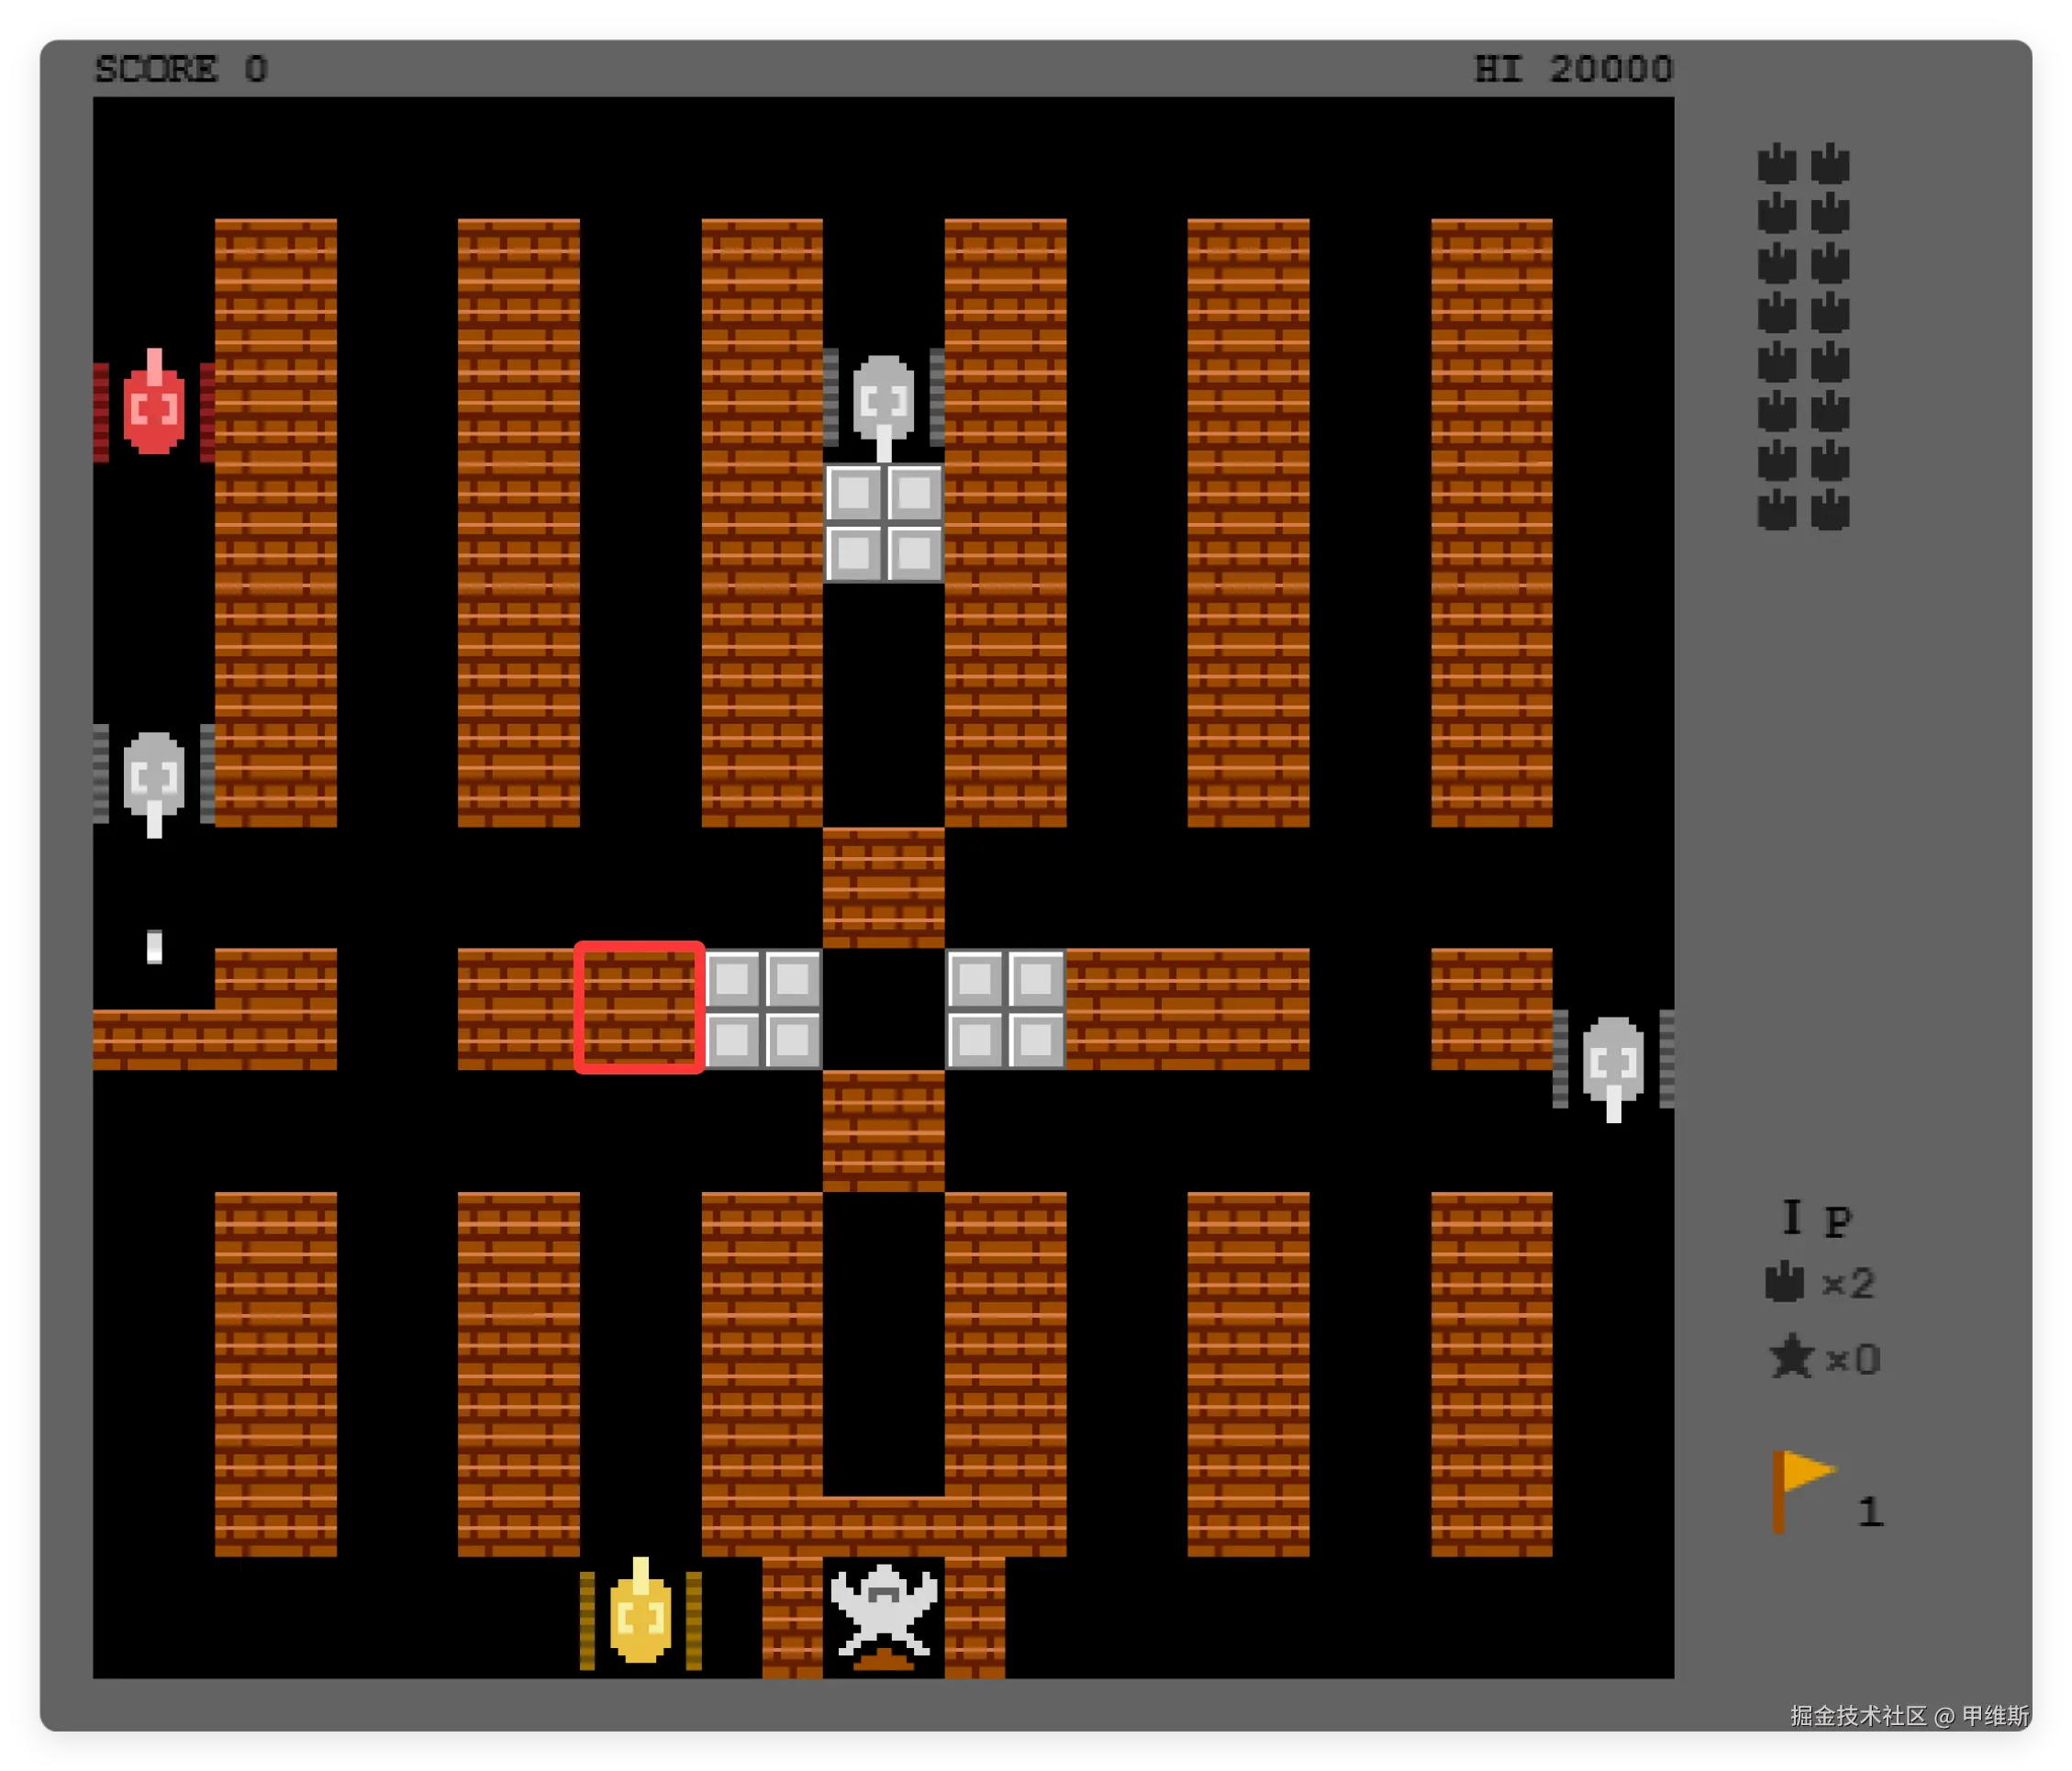
我给他一张我伪造的坦克大战地图,然后问它:
如果两炮能打掉红色框中的砖块,那么黄色坦克朝右开两枪会怎么样?基地会怎么样?
这应该算是视觉推理的范畴。模型需要先理解红色框在哪里,长什么样子。然后黄色坦克在哪,右边是什么,坦克的威力是多大。
我们直接来看结果吧:
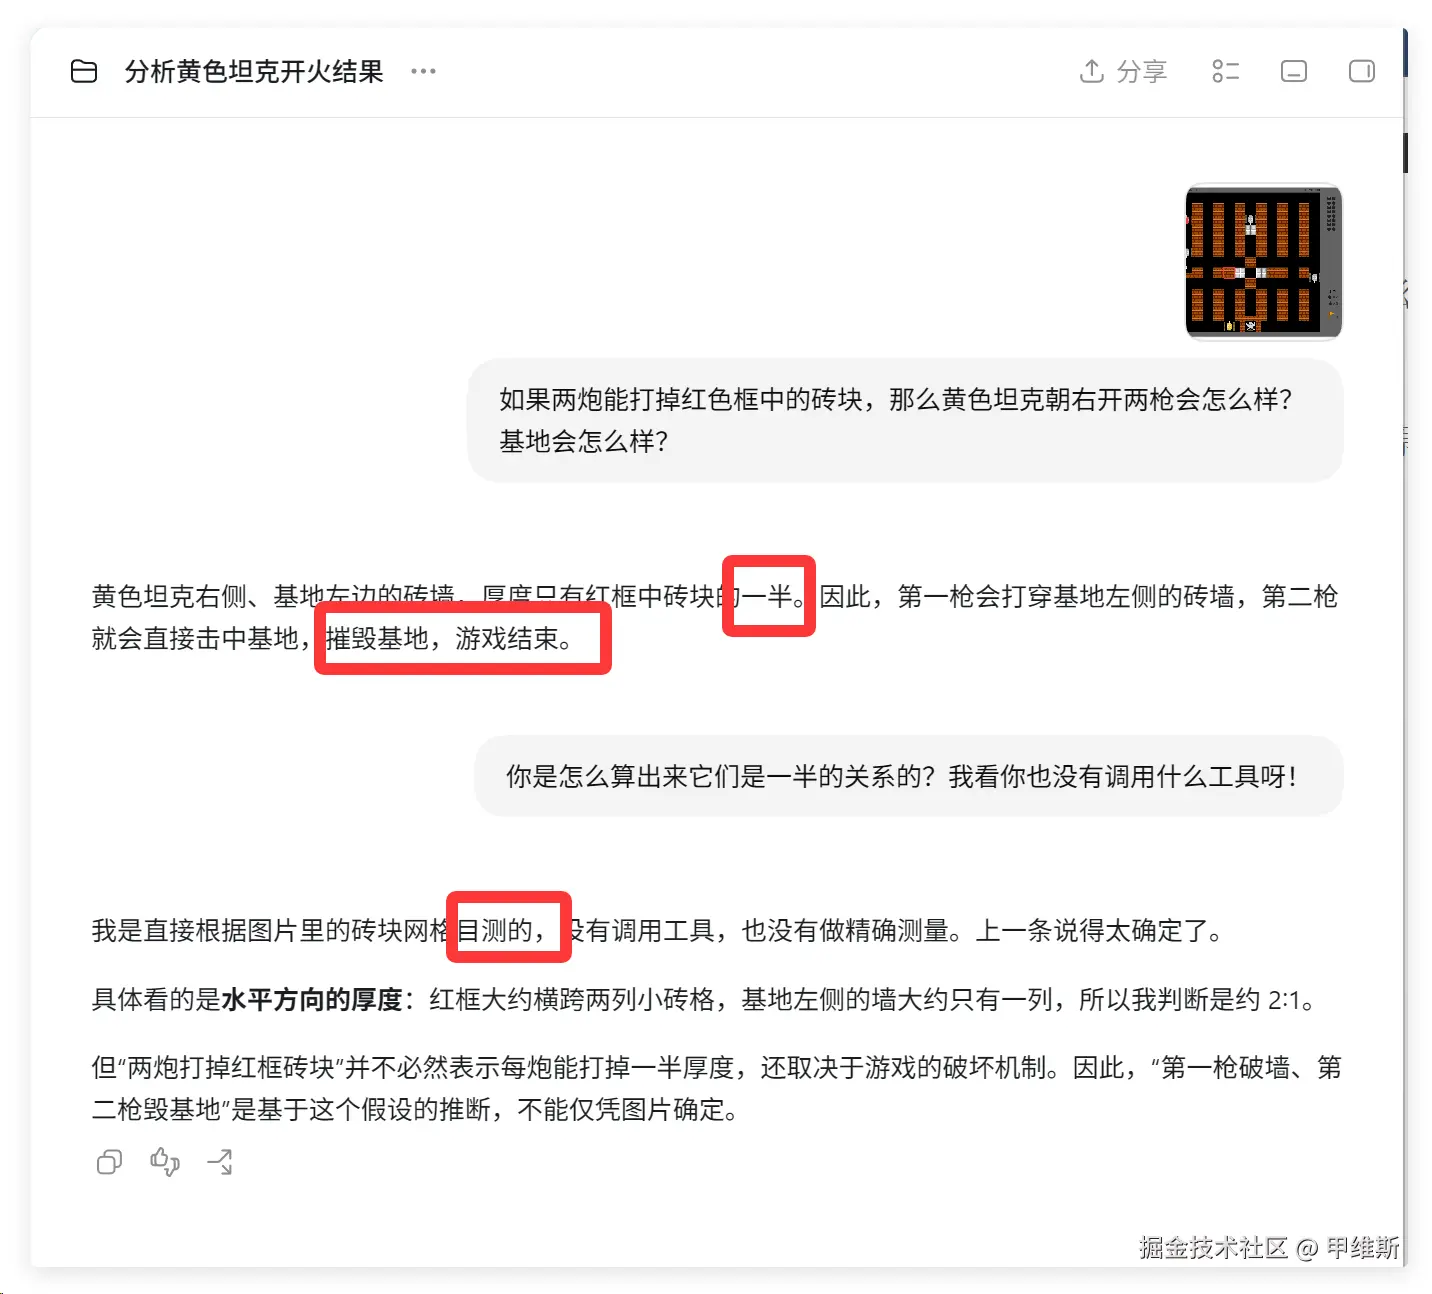
直接 K·O,首战告捷! 我有点兴奋了!
但是这还不能说明什么,因为之前 Grok 4.5 和 GPT-5.6 Sol、Fable 5 也是首轮正确,后面就不行了。
然后我又连试了 4 次:
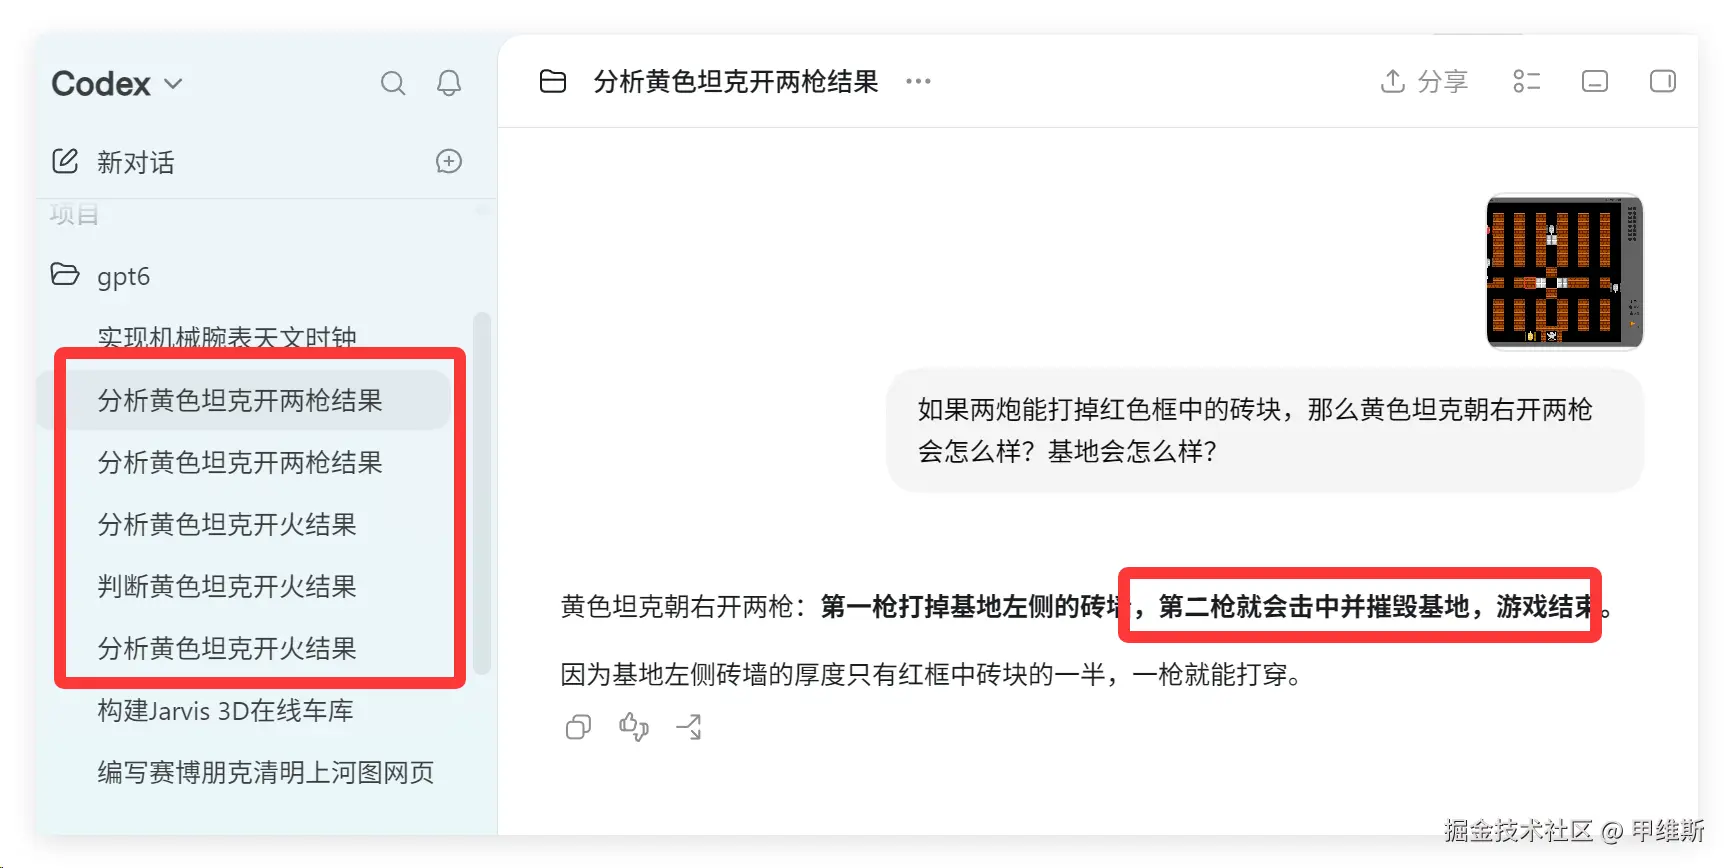
结果是:全部正确!
这个就真的牛逼了,偶尔能答对,证明它只是瞎猫碰到死老鼠。而每次都能答对,就说明它真的是理解了。
这个题目最大的坑是:经验主义!
很多模型已经非常清楚坦克大战的规则,它知道基地的墙需要两炮才能打穿。 而我给的图片从比例上来讲,其实只要一炮就能打掉。如果模型能根据图片条件来测量和推理,肯定做对。但是如果想当然必错!
之前的模型在Agent中,有时候会想到调用工具测量一下,就能得出正确的结论。一旦想当然,基本上就是错!
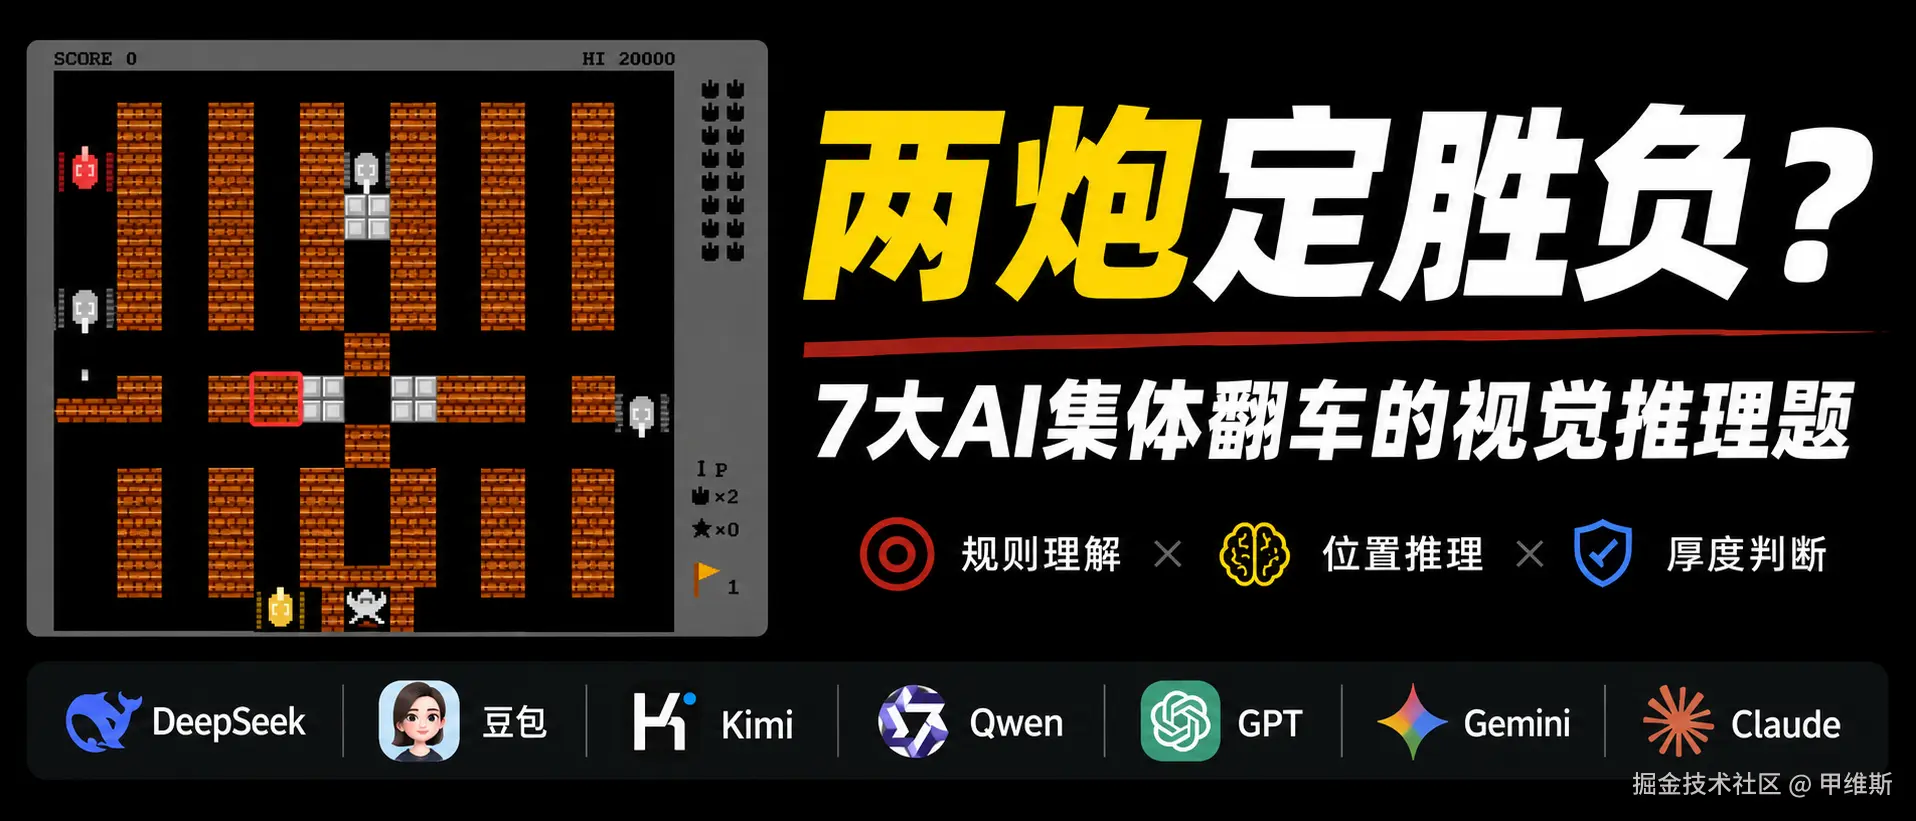
我专门写过一篇文章《坦克大战测试全躺了!豆包,DeepSeek,Qwen,GPT,Claude》! 后来啊又补测了 GPT-5.6 Sol、Opus 5 等,全部无法 100% 答对,其中概率最高的是 GPT-5.6,大概是 60% 的样子。
GPT-6 厉害的地方是,它完全没有调用工具。看一眼图片就算出来比例了。也就是它内置了这种能力!
我觉得这个和它能准确地操作电脑这个能力高度相关。因为它在控制电脑点击按钮的时候,对位置、宽、高等信息要高度敏感!
我也专门问了,为什么没调用工具就能知道是一半的比例。
它的回答是这样的:
我是直接根据图片里的砖块网格目测的,没有调用工具,也没有做精确测量。上一条说得太确定了。
具体看的是水平方向的厚度:红框大约横跨两列小砖格,基地左侧的墙大约只有一列,所以我判断是约 2∶1。
确实,它就是目测出来的!
这个题目,人类是可以根据图片的视觉信息轻松答对的,但是之前的 AI 都不行,现在 GPT-6 可以了!
GPT-6 确实要比其它模型更接近 AGI!
我在几个月前就发过一篇文章《AI全军覆没!Opus4.6和GPT5.4都被AGI-3吊打了》,专门介绍了一下ARC-AGI-3 这个基准!
它是 ARC Prize 基金会继 ARC-AGI-1/2 之后推出的第三个"流体智能"基准,也是第一个交互式推理基准:不再给静态谜题,而是让 AI 智能体进入全新的、抽象的回合制游戏环境,通过试错来学习。
这个测试,人类玩起来也有点难度,挺好玩的!
它测的是四大能力:
探索(主动交互收集信息)、
建模(从原始观察中构建可泛化的世界模型)、
目标获取(在没有说明书的情况下自己搞清楚要达成什么)、
规划与执行(多步行动并随时纠偏)。
它刚出来的时候,几乎所有模型都只能得零分!
此后几个月模型成绩快速攀升,目前(截至 2026 年 9 月初)榜单前列为:
| 模型 | 得分 | 发布时间 |
|---|---|---|
| GPT-6 Astra (Max) | 62.7%/99.9% | 2026-09-03(当前第一) |
| Claude Opus 5 (High) | 30.2% | 2026-07-24 |
| GPT-5.6 Sol (Max) | 7.8% | 2026-06-26 |
| Grok 4.6 (XHigh) | 2.1% | 2026-08-12 |
从表格中可以看到,被马斯克誉为世界上最聪明的 Grok 也才 2.1%,OpenAI 前一代模型是 7.8%。Anthropic 家的旗舰模型也才 30%!
而 OpenAI 宣布,它们最新的 GPT-6 Astra 已经达到了 99.9%,也就是几乎满分,直接刷爆了这个 AGI3 的基准。
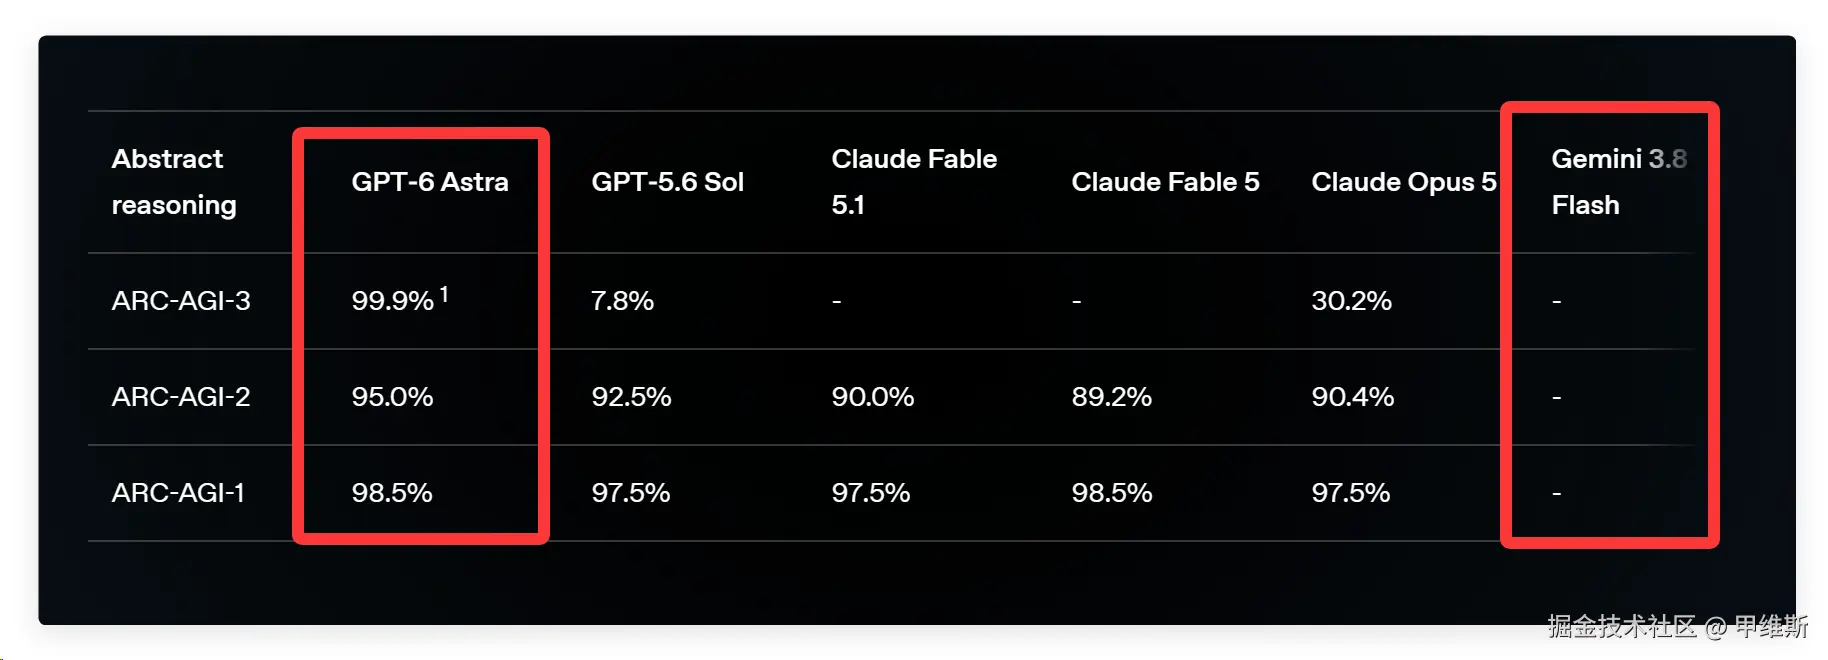
所以按这个思路来说,"AGI来了",那么就说得通了! 大家顺带看一眼 Gemini 3.8 Flash 🤣,这是完全不卷、不内耗、不挣扎,躺平了。
当然,GPT-6 这个 99.9% 还是有一些水分的。
这个得分是在Provider Adapter harness的基础上获得的!
这个东西是 OpenAI 自己的有状态 API 适配器,能在多次请求之间保留模型的内部推理状态(opaque reasoning state),并自动压缩对话,让模型可以接着之前的思路继续干。
62.7% (Max 推理档)用的是 Standard harness:跨厂商统一的标准测试方式,模型只能靠自己显式记笔记来传递信息,每次请求之间的内部思考状态会丢失。
所以 AGI 到没到,重要的是看定义是什么?
抛开这些概念营销,62.7% 的分数确实也是 No.1 了,这一点毫无疑问!
相比它最大的竞争对手 Opus 5,翻了一倍!
这确实可以吹一下了!
而且我也通过一个小例子,证明了它确实可以碾压之前的所有模型!
但是......也有一个副作用:贵,消耗快!
我其实已经测了另外三个例子了,在前端和推理方面,进步也非常明显。目测确实和 Opus 5 和 Fable 5 差不多。由于配额太少,我已经躺了,下午重置,继续测!
测完,再给大家分享!