摘要:Kafka 和 Spark Streaming 对接,两侧都有一堆参数,很多还会互相影响------拉取速率是两边一起管的,offset 也是两边一起管的,配置不对轻则吞吐上不去,重则丢数据或重复消费。这篇把两侧参数按职责拆开,重点讲四个会打架的地方(auto.commit、offset.reset、两侧限流、consumer cache),以及它们怎么协同。
关键词:Spark Streaming, Kafka, 参数配置, auto.offset.reset, enable.auto.commit, maxRatePerPartition
一、先分清两侧的职责
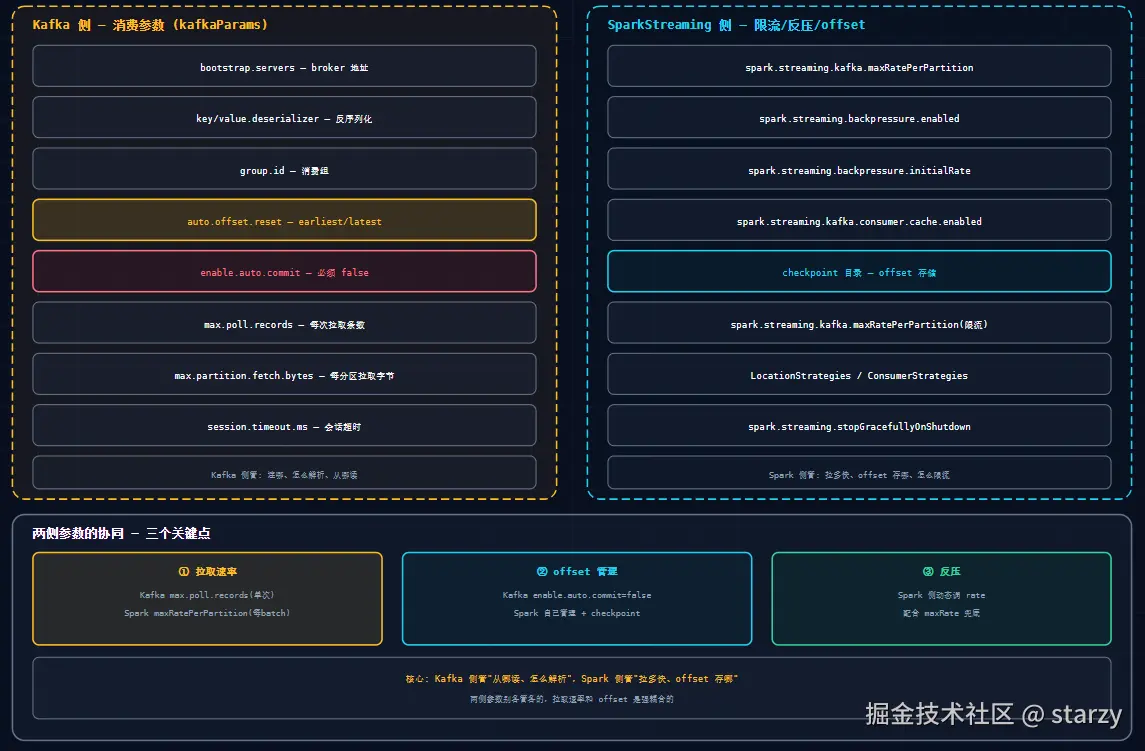
Kafka 侧和 Spark Streaming 侧的参数,管的事情不一样,别混着看:
- Kafka 侧(kafkaParams):管"连哪、怎么解析、从哪读"------broker 地址、反序列化器、消费组、起始 offset、单次拉取量。
- Spark Streaming 侧:管"拉多快、offset 存哪、怎么限流"------限流速率、反压、checkpoint 目录。
一句话:Kafka 管数据源,Spark 管消费节奏。下面分别过一遍,然后重点讲两边耦合的地方。
二、Kafka 侧核心参数
scala
val kafkaParams = Map[String, Object](
  "bootstrap.servers" -> "broker1:9092,broker2:9092",   // broker 地址
  "key.deserializer" -> classOf[StringDeserializer],      // key 反序列化
  "value.deserializer" -> classOf[StringDeserializer],    // value 反序列化
  "group.id" -> "streaming-app",                          // 消费组
  "auto.offset.reset" -> "latest",                        // 起始 offset
  "enable.auto.commit" -> (false: java.lang.Boolean),     // 必须 false
  "max.poll.records" -> "500"                             // 单次拉取条数
)
几个关键点:
auto.offset.reset:只在 offset 不存在时生效(首次启动、或 offset 过期)。earliest从最早开始(适合必须处理全量历史,如对账、补数),latest从最新开始(适合只关心新数据,如实时监控)。选错会丢历史或重复消费。enable.auto.commit必须 false:这是和 Spark 侧最容易打架的地方,下面单独讲。max.poll.records:单次 poll 拉多少条,是"微观"参数,影响网络往返次数。设大点能减少往返。
三、Spark Streaming 侧核心参数
bash
# 限流:每分区每 batch 拉取上限
spark.streaming.kafka.maxRatePerPartition = 10000

# 反压
spark.streaming.backpressure.enabled = true
spark.streaming.backpressure.initialRate = 10000

# consumer 缓存
spark.streaming.kafka.consumer.cache.enabled = truemaxRatePerPartition:每分区每 batch 拉取上限,是"宏观"参数,决定吞吐上限。这是 Spark 侧控制消费速率的直接手段。- 反压相关:上一篇详细讲过,动态调 rate。
- checkpoint 目录:Direct 模式下 offset 存这里,必开。
四、四个会打架的地方
坑一:enable.auto.commit 忘设 false
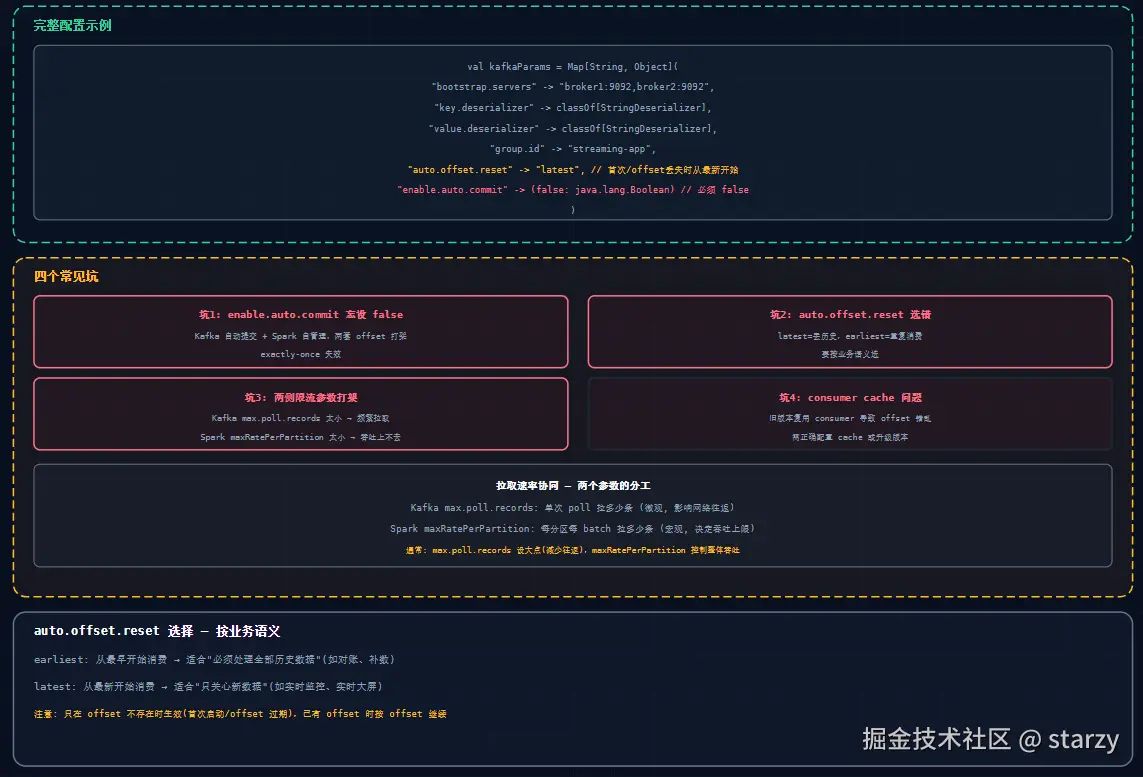
Kafka 默认会自动提交 offset 到 __consumer_offsets。而 Direct 模式下 Spark 自己管理 offset(存 checkpoint)。如果这里不设 false,就是两套 offset 在打架------Kafka 提交的进度和 Spark 记录的对不上,exactly-once 直接失效,重启后可能重复消费或丢数据。
坑二:auto.offset.reset 选错
前面说了,earliest 和 latest 对应不同的业务语义。实时监控场景误设成 earliest,重启后会从最早的数据开始猛拉一遍历史,白耗资源;对账场景误设成 latest,历史数据就丢了。按业务语义选,别无脑 latest。
坑三:两侧限流参数打架
max.poll.records(Kafka 单次拉取)和 maxRatePerPartition(Spark 每 batch)都会影响拉取速率,但维度不同:
max.poll.records太小 → 频繁拉取、网络往返多;maxRatePerPartition太小 → 整体吞吐上不去。
建议 :max.poll.records 设大点减少往返,maxRatePerPartition 控制整体吞吐。别两个都设得特别小,结果吞吐莫名其妙地低。
坑四:consumer cache 问题
旧版本 Spark Streaming 里,spark.streaming.kafka.consumer.cache.enabled 默认会缓存 Kafka consumer 复用。这个缓存早期有 bug,会导致 offset 错乱。如果你用的版本较老,遇到 offset 反复跳变,先怀疑这里。新版本这个问题基本修好了,但保持开启要注意版本。
五、拉取速率是怎么协同的
把两侧的拉取参数放一起看,它们的分工是:
- Kafka
max.poll.records:单次 poll 拉多少条,微观层面控制网络往返。 - Spark
maxRatePerPartition:每分区每 batch 拉多少条,宏观层面决定吞吐上限。
真正的整体吞吐由 maxRatePerPartition × 分区数 决定,max.poll.records 只是每次网络请求的粒度。所以调吞吐优先动 maxRatePerPartition,max.poll.records 保持一个合理的较大值即可。
六、完整配置串起来
scala
import org.apache.kafka.common.serialization.StringDeserializer

val kafkaParams = Map[String, Object](
  "bootstrap.servers" -> "broker1:9092,broker2:9092",
  "key.deserializer" -> classOf[StringDeserializer],
  "value.deserializer" -> classOf[StringDeserializer],
  "group.id" -> "streaming-app",
  "auto.offset.reset" -> "latest",
  "enable.auto.commit" -> (false: java.lang.Boolean),
  "max.poll.records" -> "500"
)

val ssc = new StreamingContext(conf, Seconds(5))
ssc.checkpoint("hdfs://namenode:8020/checkpoint/app")   // offset 存储

val stream = KafkaUtils.createDirectStream[String, String](
  ssc, PreferConsistent,
  Subscribe[String, String](Array("topic-a"), kafkaParams))
提交侧配合限流和反压:
bash
spark-submit \
  --conf spark.streaming.kafka.maxRatePerPartition=10000 \
  --conf spark.streaming.backpressure.enabled=true \
  --conf spark.streaming.backpressure.initialRate=10000 \
  --class com.example.KafkaStreamApp app.jar
七、总结
- 两侧职责分清:Kafka 管"从哪读、怎么解析",Spark 管"拉多快、offset 存哪"。
- 四个坑:enable.auto.commit 必须 false、auto.offset.reset 按业务语义选、两侧限流参数别打架、旧版本注意 consumer cache。
- 拉取速率分工:max.poll.records 管网络往返(设大),maxRatePerPartition 管吞吐上限(按需调)。
- 调吞吐优先动 maxRatePerPartition,配合反压和 checkpoint 构成完整的高可用消费链路。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践