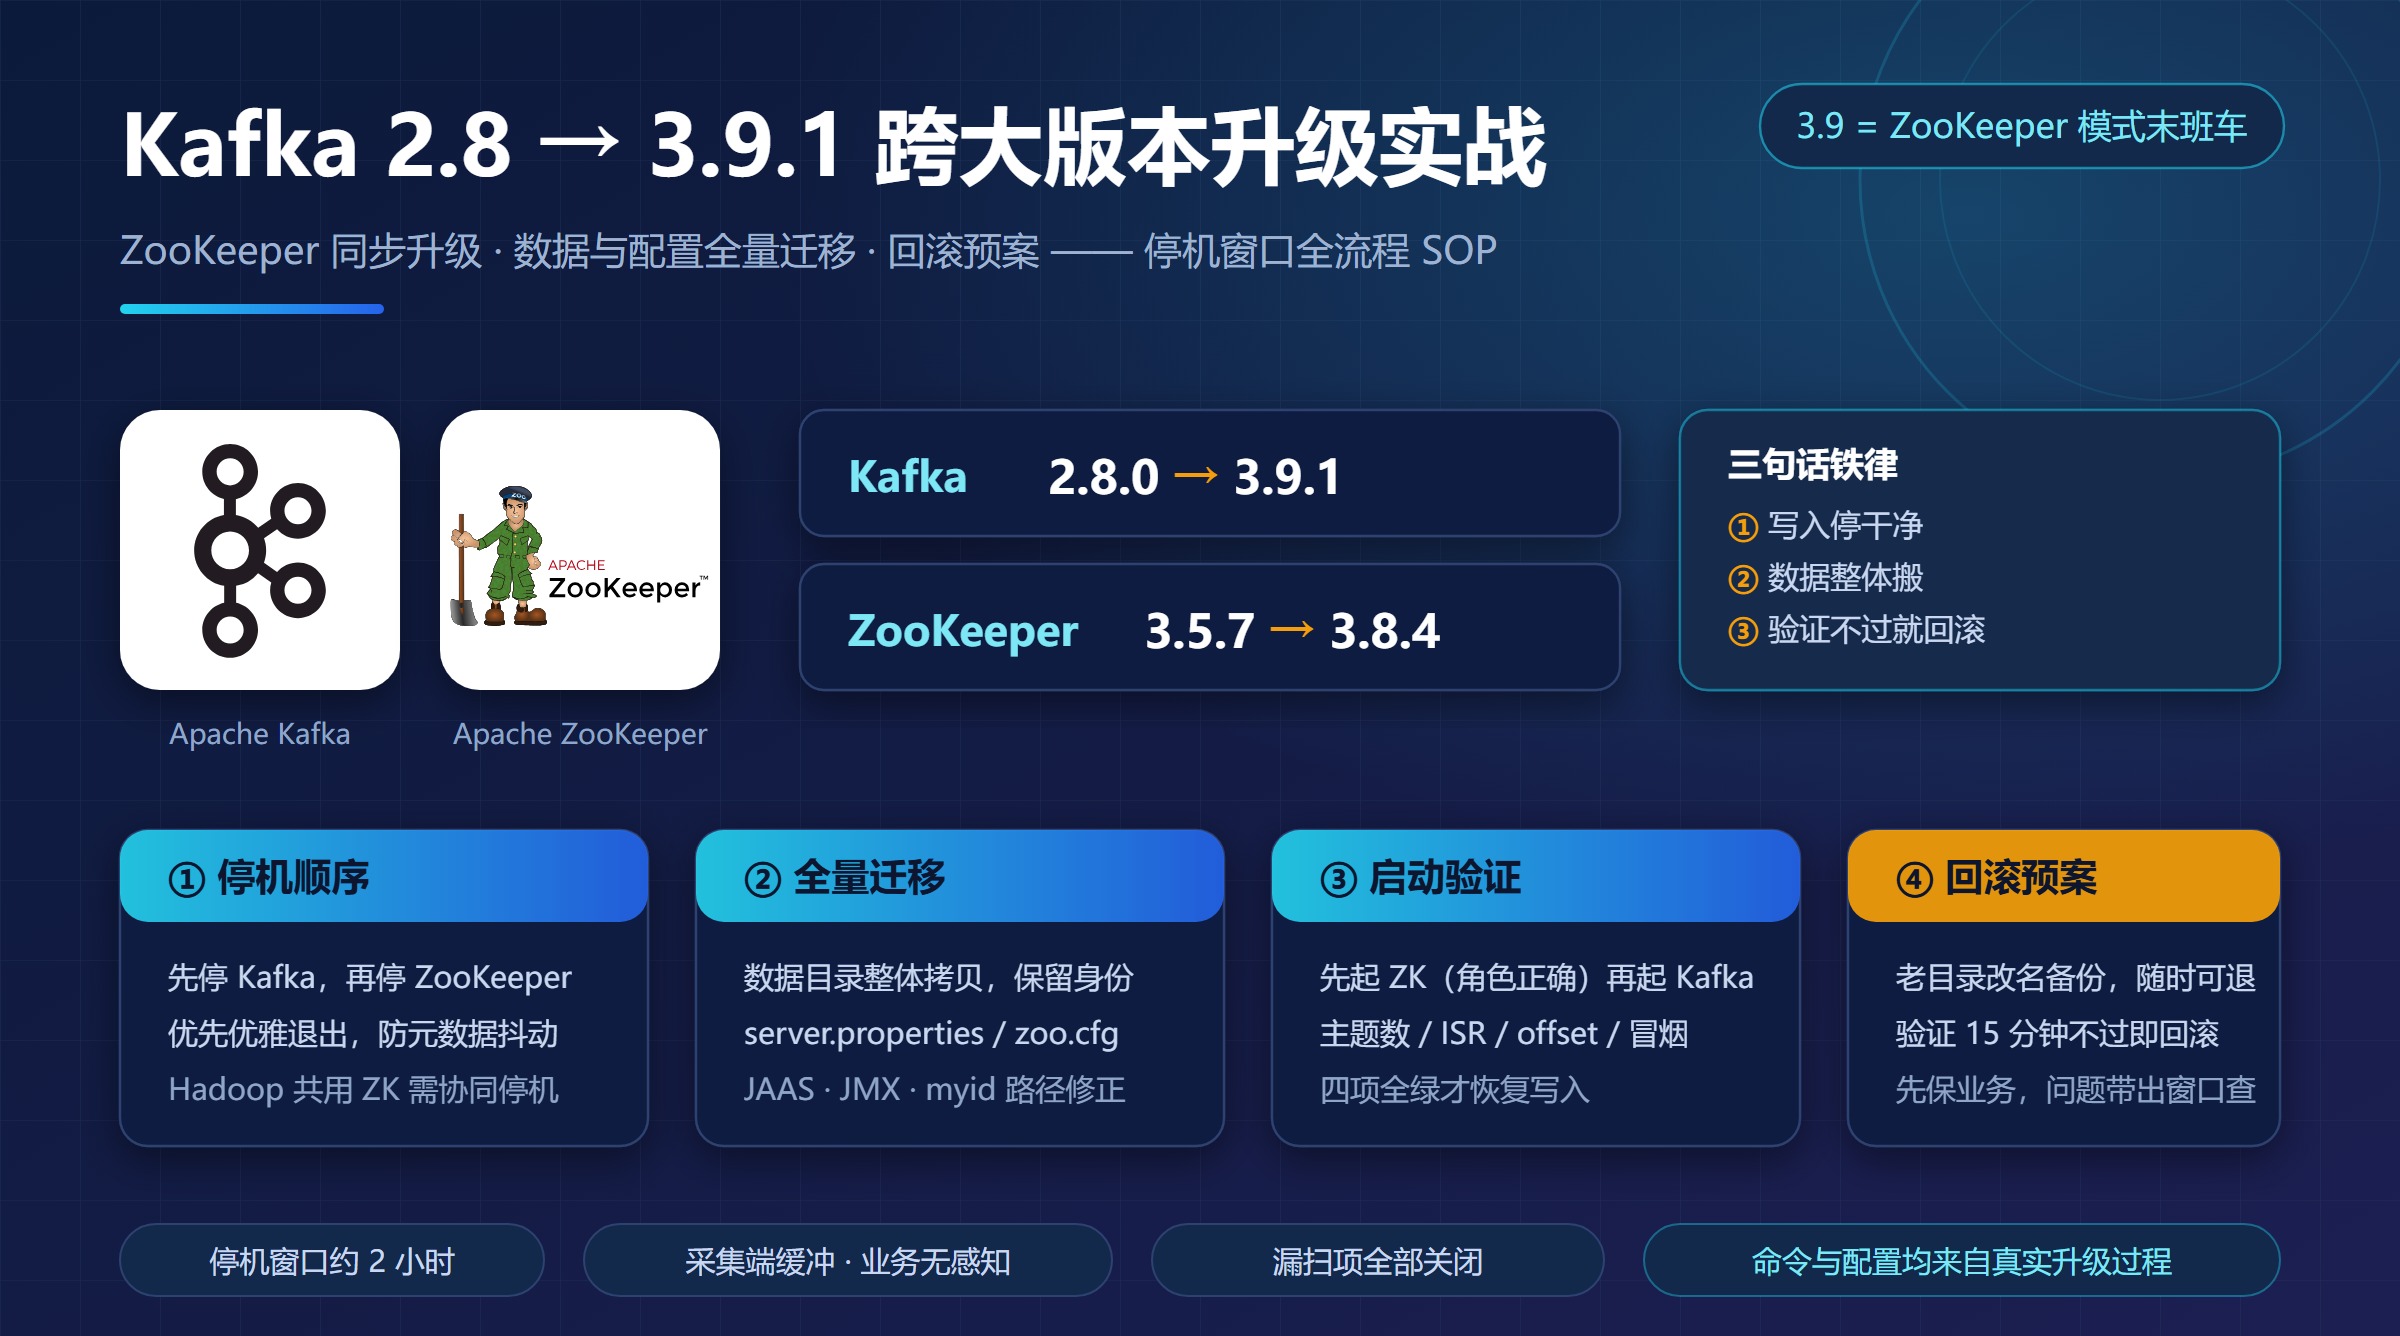
一套跑了多年的日志平台 Kafka 集群(2.8.0,外置 ZooKeeper 3.5)要升级到 3.9.1。跨这么多大版本、还是 ZooKeeper 模式,滚动升级的路基本走不通------本文记录一次停机窗口内全量升级的完整实战:升级路线选择、停止顺序、Kafka 与 ZooKeeper 的数据目录/配置全量迁移、启动验证清单、以及随时可退的回滚预案。文中命令全部来自真实升级过程,IP、路径已做脱敏替换。
一、升级背景:为什么是 2.8 直接到 3.9.1
这套 Kafka 集群承担日志平台的日志采集管道, producer 端是各类采集 Agent,consumer 端是 Flink 消费任务,常年满负荷运行。老版本一直"能用就没动",直到两个问题摆上桌面:
- 版本停更太久:Kafka 2.8 是 2021 年的版本,社区早已停止维护,积累的已知缺陷和安全修复(CVE)都拿不到;
- 配套组件在升级:ZooKeeper 3.5 同样停更,而 ZK 3.5/3.6 系列也存在已披露的安全漏洞,漏扫报告要求限期整改。
目标版本的选择上有一层考量值得说清楚:Kafka 3.9 是支持 ZooKeeper 模式的最后一个大版本线------从 4.0 起社区只保留 KRaft 模式,ZooKeeper 被彻底移除。所以"停在 3.9.1"是深思熟虑的结果:
- 一步跨到 3.9.1,把安全修复和多年性能优化一次吃满;
- 保留 ZooKeeper 模式,集群架构不变,上下游无感知,不引入 KRaft 迁移这个独立大项目;
- KRaft 迁移未来另立项,3.9 本身就提供 ZooKeeper→KRaft 的迁移工具,路是通的。
| 组件 | 老版本 | 目标版本 |
|---|---|---|
| Kafka | 2.8.0 / 3.5.1 | 3.9.1 |
| ZooKeeper | 3.5.7 / 3.6.4 | 3.8.4 |
| JDK | 1.8.0_211 | 1.8.0_211(暂不动,见踩坑 1) |
二、方案选型:为什么停机全量升级,而不是滚动升级
Kafka 官方文档给的升级路径是逐版本滚动升级 :一次升一个版本,靠 inter.broker.protocol.version(ibp)逐级放行新协议,全程不断服。对跨一两个小版本这没问题,但 2.8→3.9 中间隔着 3.0(消息格式默认值变更)、3.5(多个配置默认值调整)等多个分水岭,逐版本滚动意味着:
- 要准备 4~5 套二进制包,每个版本全集群滚动一遍,窗口次数多、周期拉长到数周;
- 每一轮都可能暴露不同的兼容性问题,排查面大;
- ZooKeeper 侧同样要跟着滚动,Hadoop 还共用着这套 ZK(后面细说),滚动次数翻倍。
而日志管道的业务特点给了停机升级的可行性:上游采集 Agent 有本地缓冲/重试,Kafka 短暂不可用不会丢日志,只是延迟入库。所以最终方案是:
申请一个维护窗口(本例实际操作约 2 小时,含验证),停写入 → 停 Kafka → 停 ZK → 全量迁移数据与配置 → 起 ZK → 起 Kafka → 验证 → 恢复写入。回滚预案提前备好,任何一步验证不过就整体退回老版本。
停机全量升级还有一个隐藏好处:所有 broker 同版本、同时重启,ibp 不需要逐级阶梯,可以直接使用 3.9 默认值,省掉了滚动升级里最容易出现脑裂/configuration 不一致风险的阶段。
三、前置准备:一份 checklist 比临场反应可靠
3.1 停掉写入方
把所有向 Kafka 主题写入数据的任务停掉(Flink 写入任务、采集 Agent 的推送),确认主题不再有新数据进来:
bash
# 消费延迟归零、写入 QPS 为 0,才算停干净
kafka-consumer-groups.sh --bootstrap-server 192.168.10.21:9092 --all-groups --describe
这一步没停干净,迁移期间数据目录还在变化,拷出来的数据就不是一致快照了。
3.2 上传安装包并分发
社区官方包(不是内部封装包,命名对照好)上传到三个节点:
text
apache-zookeeper-3.8.4-bin.tar.gz
kafka_2.13-3.9.1.tgz
3.3 确认 ZooKeeper 是不是被 Hadoop 共用
这是最容易漏掉的一步。生产上 Kafka 集群常和 Hadoop 共用一套 ZooKeeper(HDFS NameNode HA 的 ZKFC、YARN 的状态存储都依赖 ZK)。升级 ZK 前必须确认:
bash
# 在 Hadoop 配置里查 ZooKeeper 引用(core-site.xml / yarn-site.xml)
grep -i zookeeper /opt/bigdata/hadoop/etc/hadoop/core-site.xml
grep -i zookeeper /opt/bigdata/hadoop/etc/hadoop/yarn-site.xml
如果存在 ha.zookeeper.quorum 指向这套 ZK,升级窗口内 ZK 停机的后果是:ZKFC 会话超时、NameNode 可能主动退出 Standby/触发一次 HA 切换。所以要么把 Hadoop 的相关服务也一并停了 (窗口内一起操作),要么和 Hadoop 侧约定好 ZK 停机时长预期,把 session timeout 相关影响评估到位。本次升级选择了前者:窗口内 HDFS/YARN 一并停机,全部升级完成后再统一拉起。
3.4 备份与磁盘检查
老版本安装目录整体改名备份(比 cp 快,磁盘不够时尤其重要):
bash
cd /opt/bigdata
mv kafka kafka_bak
mv zookeeper zookeeper_bak磁盘空间按峰值三份 估算:新安装包解压 + 老安装目录 + 老数据目录拷贝到新数据目录。df -h 确认余量,别在拷贝到 80% 的时候才发现磁盘不够。
集群拓扑(IP 为示例):
| 主机名 | IP | 角色 |
|---|---|---|
| kafka-node1 | 192.168.10.21 | Kafka broker + ZooKeeper |
| kafka-node2 | 192.168.10.22 | Kafka broker + ZooKeeper |
| kafka-node3 | 192.168.10.23 | Kafka broker + ZooKeeper |
四、停止集群:顺序是"先 Kafka,后 ZooKeeper"
停止顺序有讲究:必须先停 Kafka,再停 ZooKeeper。反过来的话,ZK 先没了,三个 broker 的 controller 会话超时、开始反复选举,日志刷屏不说,还可能在停机过程中触发一次不必要的 leader 迁移。
每个节点依次执行(先优雅、后强制):
bash
# 1. 停 Kafka:先 kill -15 优雅退出,等 30s 仍在再 kill -9
ps -ef | grep java | grep server.properties   # 拿到 Kafka 进程号
kill -15 <kafka_pid>

# 2. Kafka 全停后,再停 ZooKeeper(进程名 QuorumPeerMain)
ps -ef | grep java | grep -E "zookeeper|QuorumPeerMain"
kill -15 <zk_pid>
老 SOP 里写的是直接
kill -9。在"写入已停、马上要换版本"的窗口里kill -9也能接受(broker 重启时会做日志恢复),但优先kill -15是更稳的习惯------优雅退出能把页缓存刷盘、注册的优雅下线流程走完,重启时的恢复时间也更短。
三台节点逐台确认进程全部退出后,再进入下一步。
五、安装新版本
三台节点依次执行。解压社区包到约定目录:
bash
mkdir -p /opt/bigdata/pkg && cd /opt/bigdata/pkg

# ZooKeeper
tar -zxf apache-zookeeper-3.8.4-bin.tar.gz -C /opt/bigdata/
ln -s /opt/bigdata/apache-zookeeper-3.8.4-bin /opt/bigdata/zookeeper

# Kafka
tar -zxf kafka_2.13-3.9.1.tgz -C /opt/bigdata/
ln -s /opt/bigdata/kafka_2.13-3.9.1 /opt/bigdata/kafka
用软链接的好处:配置和脚本里出现的是 /opt/bigdata/kafka 这种版本无关路径,下次升级只要改链接,路径修正的坑一次治好。
JDK 沿用 /opt/bigdata/jdk1.8.0_211(3.9 官方推荐服务端 JDK 11/17,JDK 8 实测可以正常启动运行,见踩坑 1 的说明)。
六、核心环节:数据与配置全量迁移
这是整个升级的灵魂。新版本装好后不要直接启动------先把老集群的数据和配置搬过来,新集群才能"带着记忆"接替老集群。
6.1 ZooKeeper:数据目录 + zoo.cfg
ZooKeeper 的全部状态就是数据目录里的快照和事务日志(3.5/3.6 → 3.8 存储格式完全兼容,直接搬),加上配置文件:
bash
# a. 清空新版本数据目录(以 zoo.cfg 中 dataDir 为准)
cd /opt/bigdata/zookeeper/dataDir && rm -rf ./*

# b. 拷贝老版本数据目录(老 dataDir 从 kafka_bak 同级的 zoo.cfg 里查)
cp -R /opt/bigdata/zookeeper_bak/dataDir/* /opt/bigdata/zookeeper/dataDir/

# c. 拷贝配置文件
cp /opt/bigdata/zookeeper_bak/conf/zoo.cfg /opt/bigdata/zookeeper/conf/zoo.cfg
两个细节:
myid文件在数据目录里 ,跟着 b 步骤一起搬过来,千万不要漏------三台节点的myid各不相同,搬错/漏搬会导致 ZK 集群选举异常;- zoo.cfg 里的
dataDir、dataLogDir若包含老版本路径,记得改成新路径。
6.2 Kafka:数据目录 + 配置 + 定制脚本
Kafka 要搬的东西比 ZK 多,列个清单逐项过:
bash
# a. 清空新版本数据目录(目录以 server.properties 的 log.dirs 为准)
cd /opt/bigdata/kafka/kafka_data_dir && rm -rf ./*

# b. 拷贝老版本数据目录(老 log.dirs 从老 server.properties 里查)
cp -R /opt/bigdata/kafka_bak/kafka_data_dir/* /opt/bigdata/kafka/kafka_data_dir/数据目录整体拷贝的意义在于:分区副本日志、**meta.properties(broker.id、cluster.id)**原样保留,新进程起来仍然是"原来那个 broker",controller 元数据、副本分配、__consumer_offsets 全部无缝延续。消息格式向后兼容,历史消息不需要任何转换。
bash
# c. 拷贝老版本 config 目录,并修正其中的路径
cp /opt/bigdata/kafka_bak/config/server.properties      /opt/bigdata/kafka/config/
cp /opt/bigdata/kafka_bak/config/producer.properties    /opt/bigdata/kafka/config/
cp /opt/bigdata/kafka_bak/config/consumer.properties    /opt/bigdata/kafka/config/

# d. 拷贝老版本 bin 目录下的定制文件(如有)
#    典型如:kafka-run-class.sh(改过 JVM/JMX 参数)、JMX password/access 文件
cp /opt/bigdata/kafka_bak/bin/kafka-run-class.sh /opt/bigdata/kafka/bin/ 2>/dev/null拷完必须做路径修正,这是最容易翻车的地方。老配置里所有指向老安装目录的绝对路径,都要改成新路径,重点扫这几处:
| 位置 | 检查项 |
|---|---|
server.properties |
log.dirs 是否指向新数据目录 |
server.properties |
listener.security.protocol.map、SASL 相关配置引用的 JAAS 路径 |
kafka-run-class.sh 等 bin 定制 |
KAFKA_JVM_PERFORMANCE_OPTS、JMX、java.security.auth.login.config 指向的 JAAS 文件路径 |
| 环境变量 / 启动脚本 | JAVA_HOME、KAFKA_HOME、CLASSPATH 里的老路径 |
如果老集群配置了 SASL 认证(JAAS 文件),路径修正后还要确认 JAAS 文件本身也拷到了新位置,具体配置方法可以看这篇:Kafka 集群内置 ZooKeeper 添加 SASL 认证全流程。
七、启动与验证:按清单来,不凭感觉
7.1 先起 ZooKeeper,逐台确认
bash
cd /opt/bigdata/zookeeper
bin/zkServer.sh start

# 每台都确认进程存在 + 角色正确(应出现 1 个 leader、2 个 follower)
ps -ef | grep java | grep QuorumPeerMain
bin/zkServer.sh status
三台 ZK 状态都正常(mode 显示 leader/follower,而不是 standalone 或报连接异常)才继续。
7.2 再起 Kafka
bash
# 赋权(Kafka 用 kafka 用户跑的话)
chown -R kafka:kafka /opt/bigdata/kafka

cd /opt/bigdata/kafka
bin/kafka-server-start.sh -daemon config/server.properties

# 逐台确认进程
ps -ef | grep java | grep server.properties
7.3 验证清单(全过才算升级成功)
bash
BS=192.168.10.21:9092

# 1. 主题列表与升级前一致,数量不少
kafka-topics.sh --bootstrap-server $BS --list | wc -l

# 2. 关键主题分区全部有 leader、ISR 满员(每行 ISR 数 = 副本数)
kafka-topics.sh --bootstrap-server $BS --describe --topic tran_log_raw

# 3. 消费组偏移量仍在(offset 不归零,lag 数值与停机前对得上)
kafka-consumer-groups.sh --bootstrap-server $BS --all-groups --describe

# 4. 端到端冒烟:手工生产一条、消费一条
kafka-console-producer.sh --bootstrap-server $BS --topic tran_log_raw
kafka-console-consumer.sh --bootstrap-server $BS --topic tran_log_raw --from-beginning --max-messages 1
逐项核对:主题数与升级前记录一致、ISR 无缩水、消费组 offset 延续、消息可生产可消费。四项全绿,才算升级完成,再通知上游恢复写入(启动采集任务/Flink 写入任务),观察 15 分钟消费延迟回落正常,窗口收尾。
八、回滚预案:窗口开始前就准备好退路
回滚方向和升级方向正好相反:
- 停止新版本:先停 Kafka(kill -15),再停 ZooKeeper;
- 备份新版本目录(改名
kafka_new_bak,留档供事后分析); - 恢复老版本目录名:
mv kafka_bak kafka、mv zookeeper_bak zookeeper; - 按老流程先起 ZK、再起 Kafka,验证三步走(进程/主题/消费);
- 恢复上游写入。
触发回滚的条件建议提前写死,避免现场纠结:启动报元数据/存储格式错误、主题或消费组偏移丢失、验证清单 15 分钟内过不去,任何一条命中就回滚。停机窗口时间过半仍未定位出问题,也回滚------先保业务,问题带出窗口慢慢查。
九、踩坑与注意事项
踩坑 1:JDK 8 沿用要心里有数。 Kafka 3.9 官方推荐服务端使用 JDK 11/17;实测 JDK 8 也能正常启动运行(本次现场如此),但这属于"能跑"而非"官方保障",且部分新特性(如 ZGC 相关调优)在 JDK 8 上不可用。建议把 JDK 升级列为升级后的独立事项,不要和 Kafka 大版本升级混在一个窗口里做。
踩坑 2:Hadoop 共用 ZK,窗口内必须协同。 3.3 节的检查如果漏掉,ZK 一停,HDFS 的 ZKFC 会话超时,NameNode 状态可能异常,把一次计划内升级变成一次故障。凡是共用 ZK 的组件(Hadoop、HBase、其他中间件),升级窗口内要么一起停、要么明确其 ZK 客户端超时时间并评估影响。
踩坑 3:JAAS/JMX 路径修正别只 grep server.properties。 SASL 场景下 JAAS 路径可能出现在三处:server.properties、kafka-run-class.sh 的 JVM 参数、系统环境变量。只改一处另两处还指向 /opt/bigdata/kafka_bak/...,因为老目录还在,启动不报错 ,等回滚时把老目录一删才爆------隐蔽性极强。路径修正后务必全目录 grep -r "kafka_bak" 验证清零。
踩坑 4:kill -9 的代价在重启时偿还。 强杀 broker 后重启,会先做一段日志恢复(recovery),数据目录大的时候这段不可忽略。给窗口排期时把恢复时间算进去,或者按第四节的做法优先优雅停止。
踩坑 5:跨大版本升级前,先盘点客户端兼容性。 服务端 3.9 对旧客户端协议是兼容的,但有些"顺手"的东西会变:老的 --zookeeper 参数在 3.x 全系移除(只能用 --bootstrap-server),基于 ZooKeeper 的老管理脚本/巡检脚本要提前改。升级前把日常运维脚本里的 --zookeeper 全部搜一遍。
踩坑 6:ZooKeeper 的 ACL/superDigest 配置别丢。 如果老 ZK 开了 ACL(digest 认证、superDigest),相关配置在 zoo.cfg / JVM 参数里,跟 6.1 的配置迁移一起搬。丢了的话 Kafka 的 znode 可能读不了,broker 起不来。
十、收尾:升级完成后的三件事
- 观察 24 小时:重点看 ISR 抖动、消费延迟、broker GC 日志,确认无版本相关的异常模式;
- 老版本目录留档一周 再删:
kafka_bak/zookeeper_bak是最后的实物退路,一周内无回滚需求再清理释放磁盘; - 把 KRaft 迁移提上日程 :3.9 是 ZooKeeper 模式的末班车,4.0 起只有 KRaft。趁现在版本新、社区迁移工具成熟,规划 ZooKeeper→KRaft 的迁移(Kafka 提供了
kafka-storage.sh format与 ZK 迁移 API),避免两年后再面对一次"不得不跨更多版本"的被动升级。
另外,ZooKeeper 升级后的调优(G1 回收器、autopurge 快照清理、syncLimit 等)可以参考这篇:Hadoop YARN 任务全部挂掉排查实录与 ZooKeeper 调优。
相关阅读:
Kafka 集群内置 ZooKeeper 添加 SASL 认证全流程
结语
跨大版本升级 Kafka 最怕的不是操作本身,而是"没停干净就动手、没备份就覆盖、没验证就放行"。这套停机全量升级的方法论概括成三句话:写入停干净、数据整体搬、验证不过就回滚。窗口期两个小时,业务靠采集端的本地缓冲无感知过渡,升级后漏扫项全部关闭。
如果这篇文章帮到了你,点赞收藏支持一下;你们团队的 Kafka 还停在哪个版本、升级走的滚动还是停机,欢迎评论区交流。