文章目录
-
-
- 0、引言
- 第一步:加载包和数据
- 第二步:数据可视化
- 第三步:构建三个递进的混合效应模型
-
- 模型1:普通线性回归(无随机效应,作为基准)
- [模型2:随机截距模型(Random Intercept)](#模型2:随机截距模型(Random Intercept))
- [模型3:随机截距 + 随机斜率模型(最完整)](#模型3:随机截距 + 随机斜率模型(最完整))
- 第四步:模型比较与选择
- 第五步:查看模型结果并解释
- 第六步:可视化模型预测结果
- 总结与建议
-
0、引言
本文基于 R语言 介绍完整实战案例。我们将使用内置数据集 sleepstudy,它记录了10名受试者在连续0-9天内的睡眠剥夺后,对反应时间(Reaction)的影响。这是一个典型的纵向数据(重复测量),非常适合用混合效应模型来分析。
这个案例会从数据探索 、模型构建 、模型比较 到结果可视化,逐步带你走一遍完整流程。
第一步:加载包和数据
首先,我们需要加载必要的R包并查看数据。
r
# 安装必要的包(如果尚未安装)
# install.packages("lme4")
# install.packages("lmerTest")  # 提供p值
# install.packages("ggplot2")

# 加载包
library(lme4)      # 混合效应模型核心包
library(lmerTest)  # 提供p值
library(ggplot2)   # 绘图

# 加载内置数据集
data("sleepstudy")
head(sleepstudy)
输出示例:
  Reaction Days Subject
1 249.5600    0     308
2 258.7047    1     308
3 250.8006    2     308
4 321.4398    3     308
5 356.8519    4     308
6 414.6901 5 308- Reaction:反应时间(毫秒),因变量(连续型)
- Days:睡眠剥夺的天数(0-9天),自变量(连续型)
- Subject:受试者编号(1-18),分组变量(分类)
第二步:数据可视化
我们先画一张图,直观地看看不同受试者的变化趋势。
r
# 绘制每个受试者的反应时间随天数的变化
ggplot(sleepstudy, aes(x = Days, y = Reaction, color = Subject)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +  # 每个受试者单独拟合回归线
  theme_minimal() +
  labs(title = "不同受试者睡眠剥夺后的反应时间变化",
       x = "睡眠剥夺天数", y = "反应时间 (毫秒)")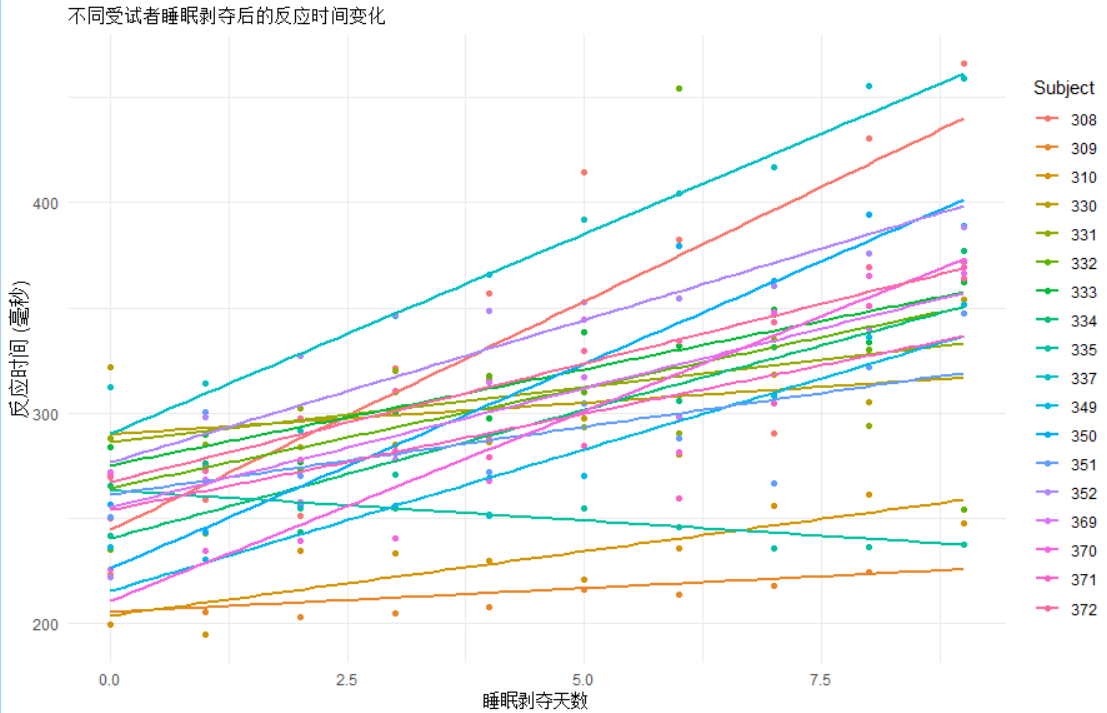
从图中你会发现:
- 大部分受试者的反应时间随天数增加而上升(正向斜率)。
- 但不同受试者的**起点(截距)和上升速度(斜率)**差异很大。这就是引入随机效应的原因。
第三步:构建三个递进的混合效应模型
我们逐步从简单到复杂构建三个模型,并比较它们的优劣。
模型1:普通线性回归(无随机效应,作为基准)
r
m0 <- lm(Reaction ~ Days, data = sleepstudy)
summary(m0)
This model assumes that all subjects share exactly the same intercept and slope, ignoring the "clustered" structure of the data.
模型2:随机截距模型(Random Intercept)
允许不同受试者的**起点(截距)不同,但斜率(Days的影响)**相同。
r
m1 <- lmer(Reaction ~ Days + (1 | Subject), data = sleepstudy)
summary(m1)
(1 | Subject)表示:随机效应只作用于截距,不同受试者的截距围绕总体平均值随机波动。
模型3:随机截距 + 随机斜率模型(最完整)
允许不同受试者既有不同的起点,又有不同的变化速度。
r
m2 <- lmer(Reaction ~ Days + (1 + Days | Subject), data = sleepstudy)
summary(m2)
(1 + Days | Subject)表示:截距和斜率都随受试者变化,且两者之间可能存在相关性。
第四步:模型比较与选择
我们可以用 anova() 进行似然比检验,比较哪个模型更好。
r
# 比较模型1(m0)和模型2(m1)
# 注意:lm 和 lmer 不能直接比较,这里比较 m1 和 m2
anova(m1, m2)
输出示例:
t
Data: sleepstudy
Models:
m1: Reaction ~ Days + (1 | Subject)
m2: Reaction ~ Days + (1 + Days | Subject)
    npar    AIC    BIC  logLik deviance  Chisq Df Pr(>Chisq)
m1    4 1802.1 1814.8 -897.04   1794.1
m2 6 1763.9 1783.1 -875.97 1751.9 42.139 2 7.072e-10 ***解读:
- AIC和BIC值:m2(1763.9)明显小于m1(1802.1),说明m2拟合更好。
- 似然比检验:p值极小(
7.07e-10),表明随机斜率模型(m2)显著优于随机截距模型(m1)。这说明不同受试者受睡眠剥夺影响的程度确实不同。
因此,我们最终选择模型 m2作为最优模型。
第五步:查看模型结果并解释
r
summary(m2)关键输出解读:
固定效应部分:
r
Fixed effects:
            Estimate Std. Error     df t value Pr(>|t|)
(Intercept)  251.405      6.825  17.00  36.838  < 2e-16 ***
Days 10.467 1.546 17.00 6.771 2.68e-06 ***- 截距 (251.4):当Days=0时,受试者的平均反应时间约为251.4毫秒。
- 斜率 (10.47):睡眠剥夺每增加1天,反应时间平均增加约10.47毫秒,且这个效应非常显著(p < 0.001)。
随机效应部分:
r
Random effects:
 Groups   Name        Variance Std.Dev. Corr
 Subject  (Intercept) 612.10   24.741
          Days         35.07    5.922   0.07
Residual 654.94 25.592 - Subject截距方差 (612.10):不同受试者起点差异很大。
- Days斜率方差 (35.07):不同受试者受睡眠剥夺影响的程度差异很大。
- Corr = 0.07:截距和斜率的相关系数接近0,说明起点高的人不一定下降得慢。
第六步:可视化模型预测结果
最后,我们提取每个受试者的随机效应,并画出各自的拟合线,直观展示模型如何捕捉个体差异。
r
>  coef(m1)
$Subject
    (Intercept)     Days
308    292.1888 10.46729
309    173.5556 10.46729
310    188.2965 10.46729
330    255.8115 10.46729
331    261.6213 10.46729
332    259.6263 10.46729
333    267.9056 10.46729
334    248.4081 10.46729
335    206.1230 10.46729
337    323.5878 10.46729
349    230.2089 10.46729
350    265.5165 10.46729
351    243.5429 10.46729
352    287.7835 10.46729
369    258.4415 10.46729
370    245.0424 10.46729
371    248.1108 10.46729
372    269.5209 10.46729

attr(,"class")
[1] "coef.mer"
r
# 提取每个受试者的随机效应系数
coef_m1 <- coef(m1)$Subject
head(coef_m1)
coef(m1)
# 绘制原始数据 + 模型拟合线
ggplot(sleepstudy, aes(x = Days, y = Reaction, color = Subject)) +
  geom_point() +
  geom_abline(data = coef_m1,
              aes(intercept = `(Intercept)`, slope = Days, color = rownames(coef_m1)),
              show.legend = FALSE) +
  theme_minimal() +
  labs(title = "混合效应模型(随机截距+斜率)拟合结果",
       x = "睡眠剥夺天数", y = "反应时间 (毫秒)")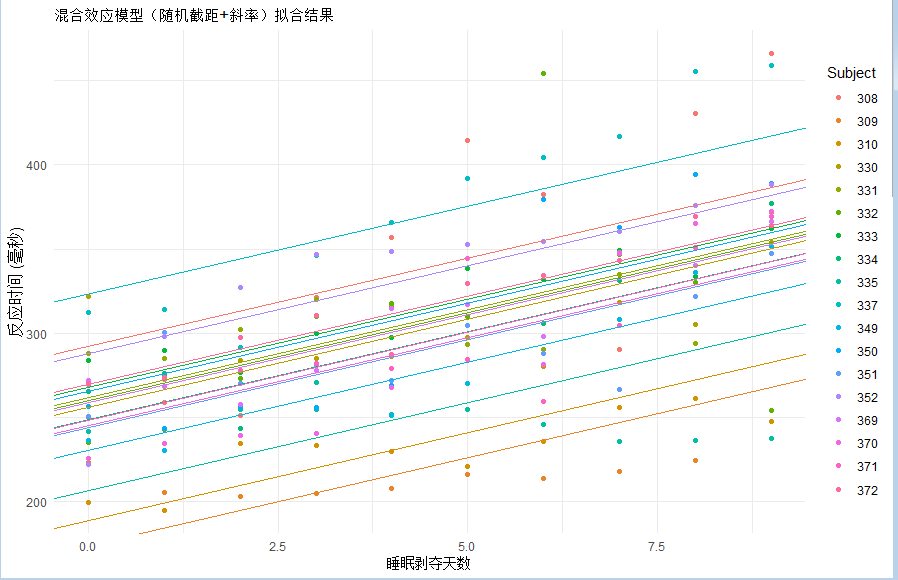
r
# 提取每个受试者的随机效应系数
coef_m2 <- coef(m2)$Subject
head(coef_m2)

# 绘制原始数据 + 模型拟合线
ggplot(sleepstudy, aes(x = Days, y = Reaction, color = Subject)) +
  geom_point() +
  geom_abline(data = coef_m2,
              aes(intercept = `(Intercept)`, slope = Days, color = rownames(coef_m2)),
              show.legend = FALSE) +
  theme_minimal() +
  labs(title = "混合效应模型(随机截距+斜率)拟合结果",
       x = "睡眠剥夺天数", y = "反应时间 (毫秒)")
r
> coef_m2
    (Intercept)       Days
308    253.6637 19.6662617
309    211.0064  1.8476053
310    212.4447  5.0184295
330    275.0957  5.6529356
331    273.6654  7.3973743
332    260.4447 10.1951090
333    268.2456 10.2436499
334    244.1725 11.5418676
335    251.0714 -0.2848792
337    286.2956 19.0955511
349    226.1949 11.6407181
350    238.3351 17.0815038
351    255.9830  7.4520239
352    272.2688 14.0032871
369    254.6806 11.3395008
370    225.7921 15.2897709
371    252.2122  9.4791297
372    263.7197 11.7513080
> 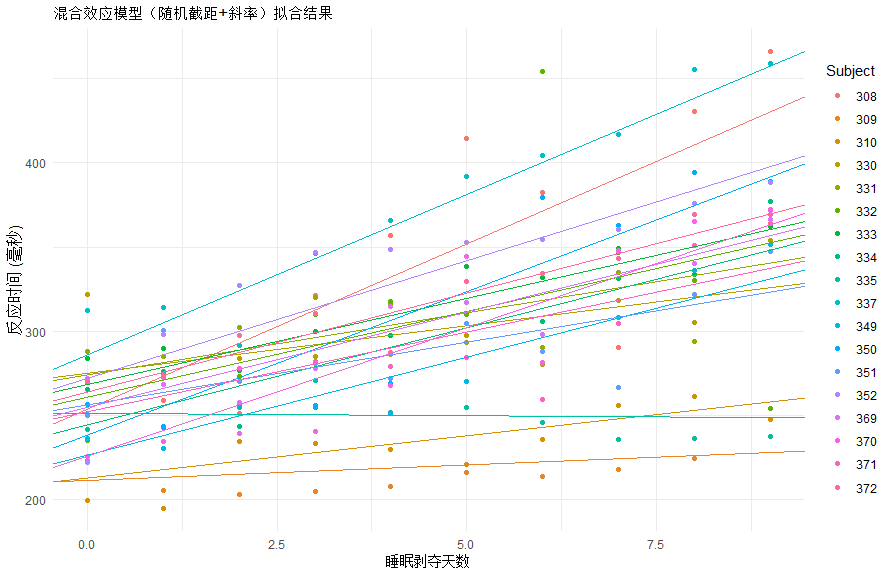
你会看到:每个受试者都有一条属于自己的回归线,截距和斜率各不相同,完美地拟合了各自的个体差异。
总结与建议
| 模型 | 公式 | 适用场景 |
|---|---|---|
| 随机截距模型 | `lmer(y ~ x + (1 | group))` |
| 随机截距+斜率 | `lmer(y ~ x + (1 + x | group))` |
注意事项:
- 如果你的分组数很少(如 < 5),随机效应可能估计不准,需谨慎。
- 如果数据量较大,可以考虑
glmer()用于广义混合效应模型(如逻辑回归、泊松回归)。 - 模型收敛问题:若遇到收敛警告,可尝试调整优化器参数或中心化自变量。