一、迭代周期(神经网络训练里的完整概念:epoch、batch、iteration )
(一)名词解释
1. ① Iteration(迭代 / 迭代步数)
- 一次 iteration = 一次前向传播 + 一次反向传播 + 一次参数更新
-
你拿一个批次 (batch)的数据送入网络
-
前向:算出预测值、算出损失 loss
-
反向:autograd 自动求导算出梯度

-
更新:
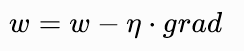
-
做完上面整套动作,就叫1 次迭代 (iteration)。
- 迭代周期狭义上常指:完成一次参数更新所经历的完整运算周期。
举例:
数据集一共 1000 张图片,batch_size=100
那么跑完 1 个 batch,就是 1 iteration。
跑完所有数据需要:1000/100 = 10 iterations
2. ② Epoch(轮次 / 世代)1 个 Epoch = 把全部训练数据集完整过一遍
-
也就是用所有样本,全部完成一轮前向‑反向‑更新。
一个 epoch 里面包含很多次 iteration。
-
例子延续上面:
- 数据集 1000 张,batch=100
- 1 epoch = 10 iterations训练的时候写 for epoch in range(50):
- 含义:完整遍历全部数据集 50 轮。
3.总结
- Iteration:一批数据,更新一次权重(最小迭代周期)
- Batch:一次 iteration 所用样本数量
- Epoch:全集数据跑完一轮
二、PyTorch‑Autograd 自动微分到底是什么
(一) 最核心作用:不用手动推导链式法则、手动写反向传播导数公式。
- 只要写完前向传播代码,autograd 自动帮你算出所有权重的梯度
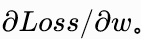
- 手动反向传播时要一步步算:
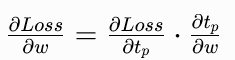
autograd 帮你把这条链式求导全部干完。
(二)两个核心角色:Tensor + grad_fn当你创建张量时设置:w = torch.tensor(1.0, requires_grad=True)
- requires_grad=True 代表:开启梯度追踪,告诉 autograd,这个张量后续所有运算要记下来。
- tensor.data:存张量本身的数值
- tensor.grad:用来存放损失对该张量的导数(梯度),一开始是空的
- tensor.grad_fn:运算历史记录,记录这个张量是通过哪一个数学运算得来的(加法、乘法、sigmoid...)
(三)autograd 工作的两大阶段
1.阶段 1:
- 前向传播 --- 跟踪运算,搭建计算图你正常写前向代码,autograd 在后台默默记录每一步操作。
- 不会立刻算导数,只是记账。
2.阶段 2:
- 反向传播 loss.backward()从损失 Loss 这个终点,沿着已经建好的计算图,反向链式求导,一路算出所有 requires_grad=True 张量的梯度,存入 .grad 属性。
- 调用完 loss.backward() 之后,w.grad 就得到了你最想要的
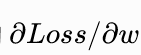
3 误区澄清
- autograd 不是在你写公式的时候就把导数算好了;
- 它是先记录路径,等到 backward 那一刻才一次性反向求导。
三、什么叫「跟踪张量所有运算历史,构建计算图」
(一)
1. 计算图是什么
-
计算图就是把你前向传播里所有数学运算,变成一张有向流程图。
-
举最简单例子:
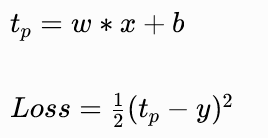
-
对应的计算图链路:
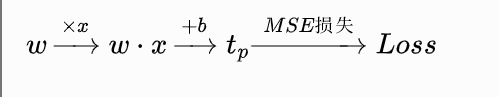
- 圆圈节点:张量(w、x、b、tp、loss)
- 箭头:运算操作(乘、加、平方...)
(二)"跟踪张量运算历史" 到底在干什么
- 当 requires_grad=True,每一次你拿张量做运算:z = a + b
PyTorch 就会:
- 生成新张量 z
- 给 z 打上 grad_fn 标签:记住 "我 z 是由 a 和 b 经过加法得到的"
- 每一步运算都留下这条线索,一步一步串起来,最后就拼成了一张完整的图 ------计算图。
- grad_fn 就是图上的箭头记录。
(三) 计算图的唯一用途:反向传播链式求导当执行
- loss.backward():
- 程序从 Loss 节点往回沿着箭头逆行。
- 每遇到一个运算节点,就调用该运算对应的导数公式,算出局部梯度,然后一路链式相乘,传回最开始的 w,b。
- 这就完美复现了你之前手动推导的链式法则。
(四) 形象类比前向过程:
- 你从山顶(w,b)顺着小路走到谷底(Loss),一路上在路边插路标,记录走过的每一步 → 构建计算图。
- backward ():你从谷底顺着路标原路往回走,边走边算出每一段斜坡的斜率(导数梯度)→ 反向传播求梯度。
(五)重要补充:动态计算图(PyTorch 特性)
- PyTorch 的图是运行时动态生成:你代码跑一遍前向,才生成一张图;跑完 backward 默认就释放掉这张图,下次迭代再重新建一张新图。
- 这也是循环神经网络、条件分支代码能够灵活使用的原因。一条完整链路串起全部概念
- 设置 w.requires_grad=True →开启追踪
- 迭代开始(1 iteration)
- 前向:
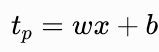
- autograd 记录运算历史,构建计算图
- 计算 Loss
- loss.backward():沿着计算图反向链式求导,算出

- 存入w.grad
- 优化器 optimizer.step():利用梯度更新 w
- optimizer.zero_grad():清空本次梯度,准备下一次迭代
- 不断重复 iteration,直到跑完一个 epoch。
四、什么是*params 参数解包
(一)先认识 params
- 假设你把神经网络所有可训练参数(w、b)放进一个列表 / 元组
python
params = [w, b] # params[0]=w , params[1]=b- 现在有一个函数 model,它接收多个独立参数,而不是接收一个列表:
python
def model(t_u, w, b):
return w * t_u + b- 如果直接写
python
model(t_u, params)- 等于传给函数两个东西:
t_u和一个列表[w,b] - 函数收到的第二个参数是一整个列表,而不是分开的 w 和 b,程序会报错!
- 👉
*params把列表解开,等价于:
python
model(t_u, params[0], params[1])- 星号
*把一个装着一堆元素的包裹拆开,把里面东西一个个单独传给函数。
- 例子
python
def add(a,b):
    return a+b

nums=[3,5]
print(add(*nums))
# *nums →拆开变成 add(3,5) →结果8- 没有星号就会变成
add([3,5]),报错。
拓展:
**字典是解包键‑值对,*列表解包元素。
五、什么是requires_grad=True、梯度、.grad 属性
(一)数学定义
- 梯度=导数

- 含义:w 变一点点,Loss 会变多少;用来更新权重
(二)一个张量开启追踪:w = torch.tensor([2.0], requires_grad=True)
- 张量w现在内部有三块独立存储空间
- w.data :存数值本身,这里就是
2.0,就是权重的值。你平时运算改权重改的就是 data。 - w.grad:一块空的等待写入的内存位置,专门用来存放梯度

刚创建的时候是 None(空) - w.grad_fn:运算历史记录指针(用来构建计算图,反向传播用)。
-
requires_grad=True的含义:"PyTorch,请监视这个张量,记录它所有运算历史;等后面调用
loss.backward()的时候,请算出损失对它的导数,并且把算出来的导数结果放到.grad里面。" -
示例代码
python
import torch

# 1.创建权重张量,开启梯度追踪
w = torch.tensor([2.0], requires_grad=True)
x = torch.tensor([3.0])
y_true = torch.tensor([10.0])

# 2.前向传播运算(autograd悄悄记录运算,构建计算图)
t_p = w * x
loss = (t_p - y_true)**2

#👉此时:w.grad 仍然是空!!!还没有求导!
print(w.grad)  # None

# 3.启动反向传播求导!
loss.backward()

#👉 backward跑完!梯度已经算好,存入 w.grad
print(w.grad)
# ∂Loss/∂w = 2*(w*x‑y_true)*x = 2*(6‑10)*3 = -24
# 输出 tensor([-24.])- 核心结论
.grad就是专门存放梯度(导数结果)的容器- 在
backward()执行之前:.grad= 空 - 在
backward()执行之后:PyTorch 自动算出导数,把结果写入到这个 .grad 容器里面