一、为什么需要量化
模型训练通常使用 FP32 浮点数。它精度高,但参数占用空间较大。量化可以使用更低位数的数据表示参数,从而减少模型体积,并在部分硬件上提升推理速度。
本项目采用 INT8 动态量化,目标是降低 BERT 的 CPU 部署成本。
二、动态量化是什么
动态量化不要求提前准备校准数据,而是在推理时根据输入动态计算量化参数。项目主要对 Linear 层进行量化,Embedding 和部分其他结构保持原格式。
三、核心代码
python
quantized_model = torch.quantization.quantize_dynamic(
    model,
    {torch.nn.Linear},
    dtype=torch.qint8,
)
量化前应确保模型处于评估状态:
python
model.eval()
quantized_model = torch.quantization.quantize_dynamic(
    model, {nn.Linear}, dtype=torch.qint8
)
四、压缩结果
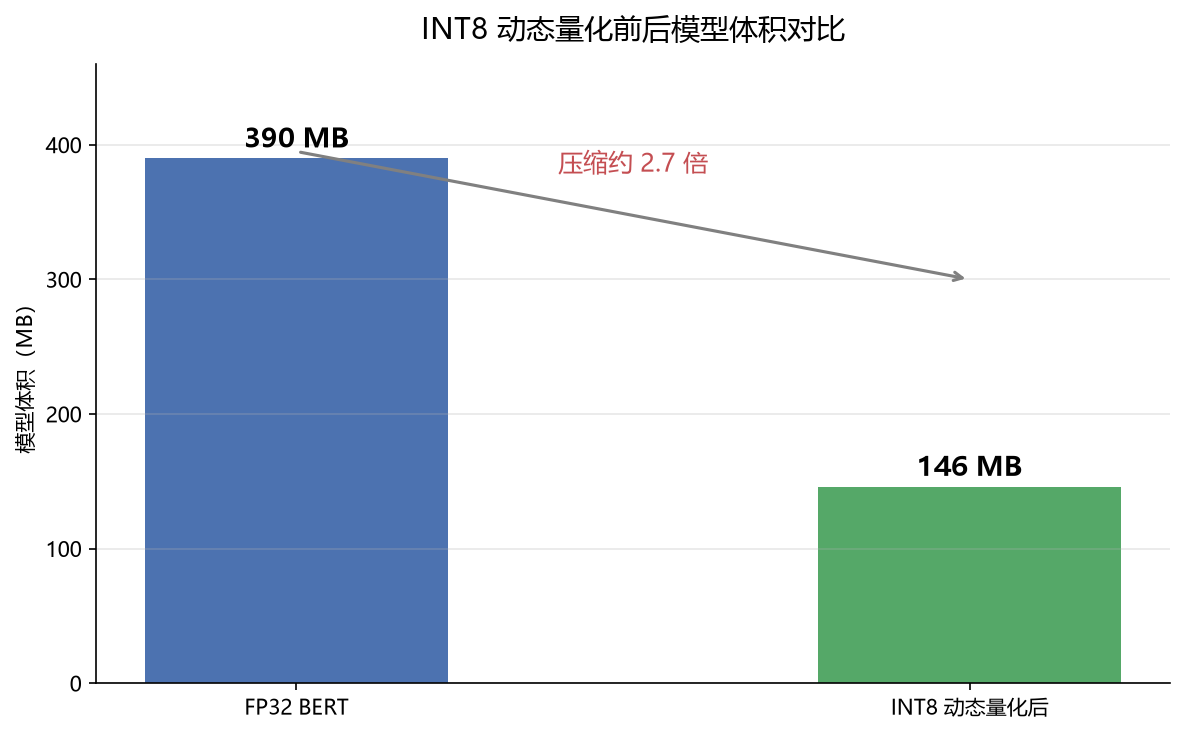
| 项目 | FP32 BERT | INT8 量化后 |
|---|---|---|
| 模型体积 | 约 390MB | 约 146MB |
| 压缩比 | 1 | 约 2.7 倍 |
量化后的体积下降明显,适合资源受限、CPU 推理或本地部署场景。
五、量化遇到的兼容性问题
项目中曾出现 HuggingFace BERT 某些模块与 PyTorch 动态量化不完全兼容的问题,表现为部分标准评测循环报错。
这说明:
- 模型文件能够保存,不代表所有推理路径都已经验证;
- 压缩比不能代替精度和延迟评测;
- 量化后必须用与生产相同的输入和推理路径做回归测试。
因此更严谨的结论应该是:项目完成了量化压缩验证,但完整量化评测链路仍需要进一步完善。
六、为什么没有直接使用 QAT、TensorRT 或 ONNX
QAT
量化感知训练通常需要重新训练或微调,效果可能更好,但工程成本更高。
TensorRT
适合 NVIDIA GPU 高性能推理,但部署环境、算子支持和转换流程更复杂。
ONNX Runtime
适合跨平台推理,但需要增加模型导出、算子兼容和输出一致性验证。
当前项目处于原型和完整链路验证阶段,因此先选择实现成本较低的动态量化。
七、正确的量化验收方式
量化模型上线前至少需要比较:
- 同一测试集上的 Accuracy、Precision、Recall、F1;
- 同一硬件上的 P50、P95 延迟;
- 单条和批量推理吞吐;
- 模型加载时间和内存占用;
- 量化前后的输出差异;
- 长文本、空文本和异常输入。
八、总结
量化不是为了追求一个漂亮的压缩数字,而是为了在真实部署条件下取得更好的成本收益。只有精度、性能、稳定性都经过验证,量化模型才适合进入生产。