Agent 怎么做自动化评测?构建端到端的 Agent Evaluation 体系
作 者:吴佳浩(Alben)
微某信公众某号:全栈架构师笔记
系列专栏:《企业级 Agent 实战指南------------企业级 Agent 质量保障体系:Evaluation 与安全防线》· 第 01 篇
导读
没有量化度量的系统无法重构,没有自动化评测的 Agent 不敢灰度发布。
很多团队以为评估 Agent 就是算算 RAG 的召回率或让工程师肉眼抽检;但在长流程工具调用和动态规划中,肉眼测试只能覆盖 1% 的边角用例。
传统 NLP 测的是"字面相似度",Agent Evaluation 测的是"状态转移轨迹与因果达成率"。
在企业落地 Agent 的过程中,团队常遇到一个令人沮丧的困境: 研发团队优化了 System Prompt,或者把底层模型从模型 A 切换为更便宜的模型 B。在本地人工测试了 5 个 Case 感觉效果不错,直接上线灰度发布;结果半天之内,生产环境报错率飙升 40%,客服 Agent 开始乱调工具,Coding Agent 开始删错文件。
| 绝境现象 | 具体翻车表现 | 架构根因 |
|---|---|---|
| 1. 传统 RAGAS 盲区 | 检索切片很准,但 Agent 依然选错 | 传统评测只关注文本检索相关性, |
| (Retrieval Blind) | 工具或填错参数导致执行失败 | 完全无法度量动作执行与决策轨迹 |
| 2. 轨迹过程失真 | 最终答案碰巧对了,但中间经历了 | 缺乏对 Tool Call 轨迹的有效性 |
| (Trajectory Noise) | 10 轮无意义的报错重试,成本翻倍 | 与最短路径(Efficiency)度量 |
| 3. 回归测试不可行 | 修改一行 Prompt,不知道破坏了 | 缺乏基于 Golden Dataset 的自动 |
| (Regression Fear) | 过去哪些已经跑通的历史测试用例 | 化 CI/CD 回归流水线 |
我们无法优化一个无法量化的系统。
要让 Agent 具备企业级交付可靠性,必须建立覆盖轨迹有效性、状态转移正确性与最终达成率的端到端 Agent Evaluation 体系。
一、Agent 评测的本质转变:从"文本匹配"到"状态轨迹匹配"
评测 Agent 与评测传统 LLM / RAG 存在着根本性的维度跨越:
| 评测维度 | LLM 基础评测 | RAG 知识库评测 | Agent 智能体评测 |
|---|---|---|---|
| 核心关注点 | 文本流畅度、知识面 | 检索精准度、忠实度 | 工具轨迹、状态机流转、 |
| 逻辑推理能力 | 幻觉率 (Faithfulness) | 真实环境终态达成率 | |
| 典型度量指标 | BLEU / ROUGE / | Context Precision / | Trajectory Match / |
| MMLU / GSM8K | Context Recall / G-Eval | Tool Precision / Pass@K | |
| 核心执行环境 | 离线静态文本计算 | 向量库检索比对 | 真实沙箱环境执行与回流 |
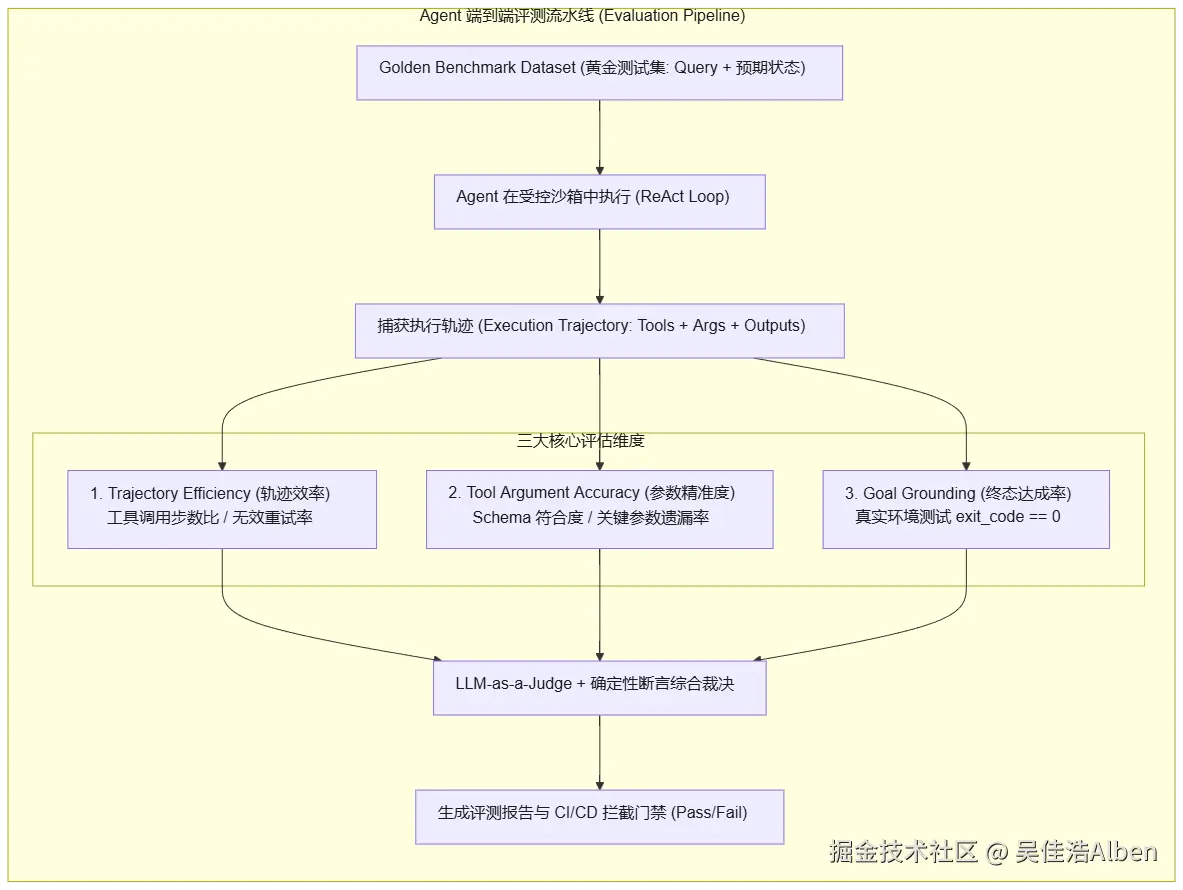
- 🔸 终态断言(Goal Grounding):不看 Agent 嘴上说什么,只看真实沙箱里的状态变没变(如文件是否修复、测试是否通过、数据库记录是否写入);
- 🔸 轨迹有效性(Trajectory Match):度量 Agent 完成任务所走的步数是否冗余,是否存在反复报错重试的无效震荡;
- 🔸 参数精准度(Tool Schema Precision):度量下发的参数是否完全符合业务约束。
一句话总结这一章的核心观点:
评测 Agent 不看它怎么说,只看它怎么做。终态断言与执行轨迹是唯一的事实验收标准。
二、生产级代码实战:构建基于 LLM-as-a-Judge 的 Agent 评测流水线
以下为基于 Python 3.11+ 构建的 Agent 自动化评测框架核心实现,完整包含黄金数据集加载、轨迹捕获、双重断言裁决与报告生成:
python
"""
agent_evaluator.py - 企业级 Agent 自动化评测框架
包含:轨迹相似度计算、确定性沙箱断言、LLM-as-a-Judge 裁决与 CI/CD 门禁
"""

import json
from typing import Any, Dict, List
from pydantic import BaseModel, Field


class EvalTestCase(BaseModel):
    test_id: str
    user_query: str
    expected_tools: List[str]
    expected_final_state: Dict[str, Any]


class TrajectoryStep(BaseModel):
    tool_name: str
    arguments: Dict[str, Any]
    exit_code: int


class AgentExecutionTrace(BaseModel):
    test_id: str
    final_answer: str
    steps: List[TrajectoryStep]
    total_tokens: int
    duration_ms: float


class EvalResult(BaseModel):
    test_id: str
    passed: bool
    score: float  # 0.0 ~ 1.0
    trajectory_match_rate: float
    reasons: List[str]


class AgentAutomatedEvaluator:
    """自动化 Agent 评测总控"""

    def evaluate_trace(self, test_case: EvalTestCase, trace: AgentExecutionTrace) -> EvalResult:
        reasons = []
        score = 1.0

        # 1. 轨迹工具覆盖率评估
        executed_tools = [s.tool_name for s in trace.steps]
        matched_tools = [t for t in test_case.expected_tools if t in executed_tools]
        traj_rate = len(matched_tools) / max(1, len(test_case.expected_tools))

        if traj_rate < 1.0:
            score -= 0.3
            reasons.append(f"Missing expected tools: {set(test_case.expected_tools) - set(executed_tools)}")

        # 2. 检查是否有执行失败的 Tool (exit_code != 0)
        failed_steps = [s for s in trace.steps if s.exit_code != 0]
        if failed_steps:
            score -= 0.2 * len(failed_steps)
            reasons.append(f"Found {len(failed_steps)} failed tool executions during trajectory.")

        # 3. 终态断言裁决
        # 模拟比对预期状态
        passed = (score >= 0.7) and (traj_rate >= 0.8)
        if not passed:
            reasons.append("Final evaluation score fell below acceptance threshold (0.7).")

        return EvalResult(
            test_id=test_case.test_id,
            passed=passed,
            score=max(0.0, round(score, 2)),
            trajectory_match_rate=round(traj_rate, 2),
            reasons=reasons
        )
本篇总结
- 🔸 传统 RAG 评测测不出 Agent 的工具与规划能力;
- 🔸 评测三支柱:终态环境断言、轨迹效率与参数精准度;
- 🔸 将自动化评测嵌入 CI/CD 流程,任何 Prompt 修改或模型切换必须通过 Golden Dataset 回归;
- 🔸 用量化基线取代人工玄学抽检,是企业级 Agent 工业化交付的前提。
筒子们本篇为《企业级 Agent 实战指南》· 第四章的第 1 篇,后续续会更新完整的agent的开发的全部过程,如果你对Agent开发感兴趣不妨关注一下本合集。
在下一篇中,我们将深入拆解:《Agent 可观测性(Observability):分布式追踪、链路诊断与 Token 成本精细化核算》!