第 28 章 案例四:多智能体协作系统
本章要解决的问题
行业分析报告需要研究员、数据员、写手协作完成------多智能体系统的拓扑、通信、可观测性实战。
章节大纲
- 28.1 多 Agent 拓扑设计(主从 + 流水线)
- 28.2 通信协议与任务编排
- 28.3 可观测性与调试
- 28.4 上线与迭代
- 🛠 解决方案:多智能体上下文隔离方案 + 协作效率度量
28.1 场景与拓扑设计
28.1.1 场景:行业分析报告生成
业务:投研团队要生成行业分析报告,人工流程:
研究员查资料 → 数据分析师算指标 → 写手撰写 → 分析师复核为什么适合多智能体(第 16 章三个信号全中):
- 专业隔离:研究员/分析师/写手的角色与工具完全不同。
- 上下文隔离:各角色的工作上下文都很大,混在一起会互相污染。
- 并行收益:部分子任务可并行。
28.1.2 拓扑选择:主从 + 流水线混合
css
                    ┌──► [研究员 Agent] 查资料 → 事实摘要
                    │        │
[主管 Agent] 接任务 ─┼──► [数据分析师] 算指标 → 数据结论
    │ 拆解/派活/汇总  │        │
    │               └──► [写手 Agent] 撰写报告
    │                      │
    └──► [复核 Agent] 质检 → 通过 → 交付 / 不通过 → 打回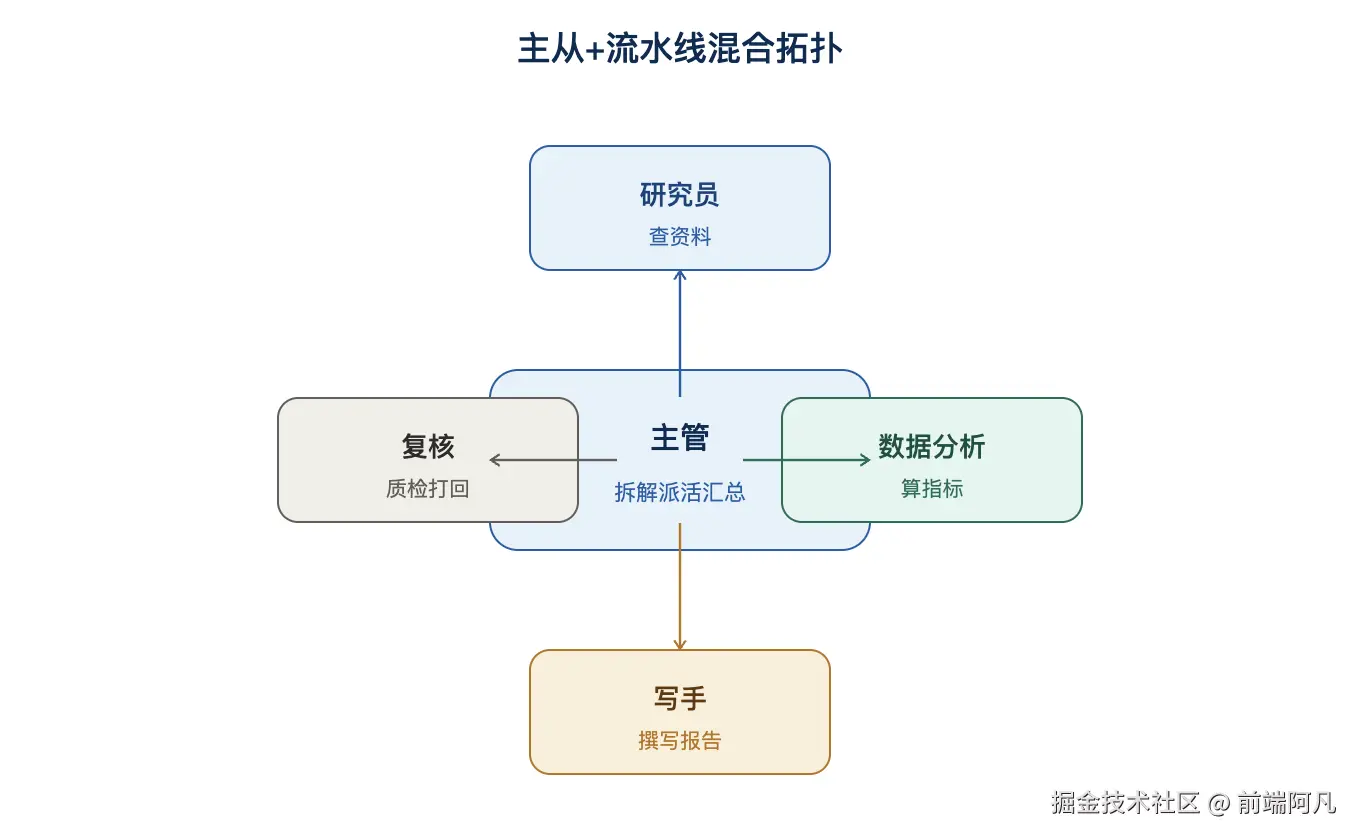
图 1:主从+流水线混合拓扑
设计要点(第 16 章原则):
- 主管-工人:主管负责拆解、派活、汇总------职责清晰。
- 流水线尾部:研究员/分析师 → 写手 → 复核,顺序推进。
- 复核即质检:复核 Agent 是对整个系统的"最后防线"(呼应第 17 章自检)。
28.1.3 角色定义(第 16 章角色四原则)
示例代码:以下代码演示核心结构,省略了异常处理、日志和完整 import。
python
ROLES = {
    "supervisor": {"role": "项目主管:拆解任务、派发给 worker、汇总质检"},
    "researcher": {"role": "行业研究员:检索资料,输出事实与数据摘要",
                   "tools": ["search", "web_fetch"]},
    "analyst":   {"role": "数据分析师:计算行业指标,输出趋势判断",
                  "tools": ["calculator", "data_query"]},
    "writer":    {"role": "报告写手:基于研究+分析结果撰写结构化报告",
                  "tools": []},
    "reviewer":  {"role": "报告复核员:检查报告准确性、完整性、逻辑性",
                  "tools": []},
}角色单一职责:写手没有检索工具(最小权限),复核员不写内容(避免"既当运动员又当裁判")。
28.2 通信协议与任务编排
28.2.1 通信模式:结构化传递(第 16 章)
不用自由对话(群聊会失控),用结构化传递------每个 worker 只输出 JSON 结果:
python
# 研究员输出(数据契约)
researcher_output = {
    "findings": [{"topic": "市场规模", "fact": "...", "source": "..."}],
    "summary": "行业规模约 X 亿元,增速 Y%",
}

# 分析师输出
analyst_output = {
    "metrics": {"market_size": 1200, "growth": 0.15, "concentration": "高"},
    "trend": "头部集中度提升",
}

# 写手输入:只接收上面两个结构化结果(不接收原始聊天)
writer_input = {"research": researcher_output, "analysis": analyst_output}
28.2.2 主管编排:任务图(第 15/16 章)
python
TASK_GRAPH = {
    "researcher": {"depends_on": [], "parallel_group": 1},
    "analyst":    {"depends_on": [], "parallel_group": 1},   # 与研究员并行
    "writer":     {"depends_on": ["researcher", "analyst"]},
    "reviewer":   {"depends_on": ["writer"]},
}

def orchestrate(goal, budget):
    # 伪代码:Agent、ROLES、run_worker 为编排框架的封装,此处仅示意调度结构
    supervisor = Agent(role=ROLES["supervisor"])
    results = {}
    # 第一波:并行跑研究员 + 分析师(第12章)
    group1 = [run_worker("researcher", goal), run_worker("analyst", goal)]
    results["researcher"], results["analyst"] = asyncio.gather(*group1)
    # 第二波:写手(依赖前两者)
    results["writer"] = run_worker("writer", results)
    # 第三波:复核(质检,第17章)
    review = run_worker("reviewer", results)
    if not review["pass"]:
        results["writer"] = revise_writer(results, review["issues"])
        review = run_worker("reviewer", results)   # 复核重跑
    return synthesize(results, review)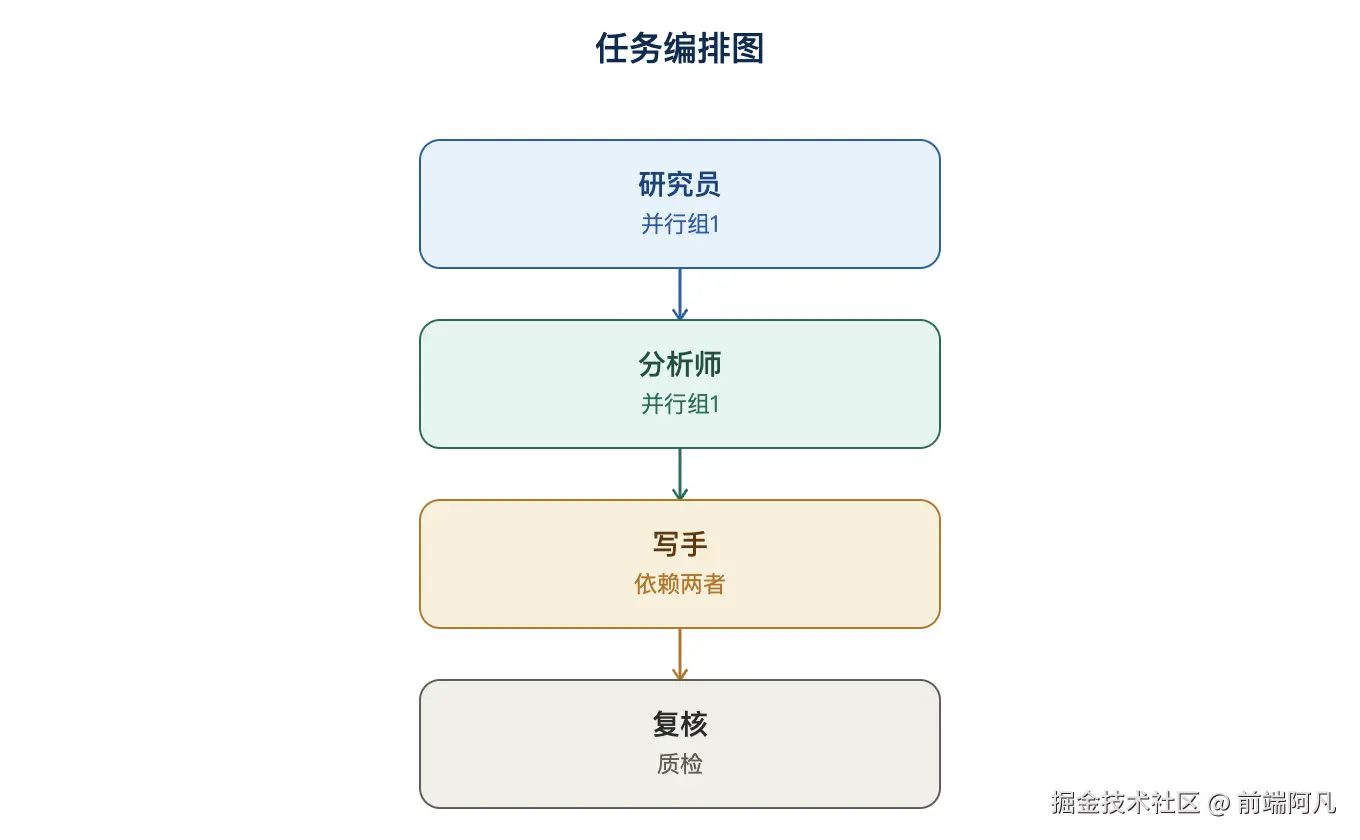
图 2:任务编排图
编排要点:并行组用 asyncio.gather;依赖关系用任务图(depends_on);复核不通过打回写手(闭环)。
28.2.3 上下文隔离:按需投喂(第 16 章核心)
python
def run_worker(name, context):
    # 只给该 worker 需要的部分(不广播全量)
    if name == "researcher":
        feed = {"goal": context["goal"]}                    # 只要目标
    elif name == "analyst":
        feed = {"goal": context["goal"], "data": context["raw_data"]}
    elif name == "writer":
        feed = {"research": context["researcher"],          # 只吃结构化结果
                "analysis": context["analyst"]}
return worker_call(name, feed)隔离三手段(第 16 章):输入隔离(按需投喂)+ 输出隔离(只交换 JSON)+ 状态隔离(各 worker 独立)。
28.3 可观测性与调试
28.3.1 多智能体的可观测性:比单 Agent 难 10 倍
多智能体出问题,可能是:主管拆解错、某个 worker 算错、上下文串扰、通信协议断......没有全链路 trace,根本无从查起。
28.3.2 分层 trace(第 21 章扩展)
python
TRACE = {
    "trace_id": "t-multi-001",
    "task": "生成半导体行业分析报告",
    "spans": [
        {"span_id": "supervisor-plan", "type": "llm",
         "worker": "supervisor", "output": "计划: 研究员+分析师并行→写手→复核"},
        {"span_id": "researcher-1", "type": "llm", "worker": "researcher",
         "input_feed": "目标摘要",          # 记录投喂内容(可查串扰)
         "output": "发现3条事实"},
        {"span_id": "analyst-1", "type": "llm", "worker": "analyst",
         "input_feed": "原始指标数据", "output": "结论: 增长 15%"},
        {"span_id": "writer-1", "type": "llm", "worker": "writer",
         "input_feed": "研究+分析结果", "output": "报告草稿"},
        {"span_id": "reviewer-1", "type": "llm", "worker": "reviewer",
         "output": "不通过: 市场规模数据无出处"},
    ],
}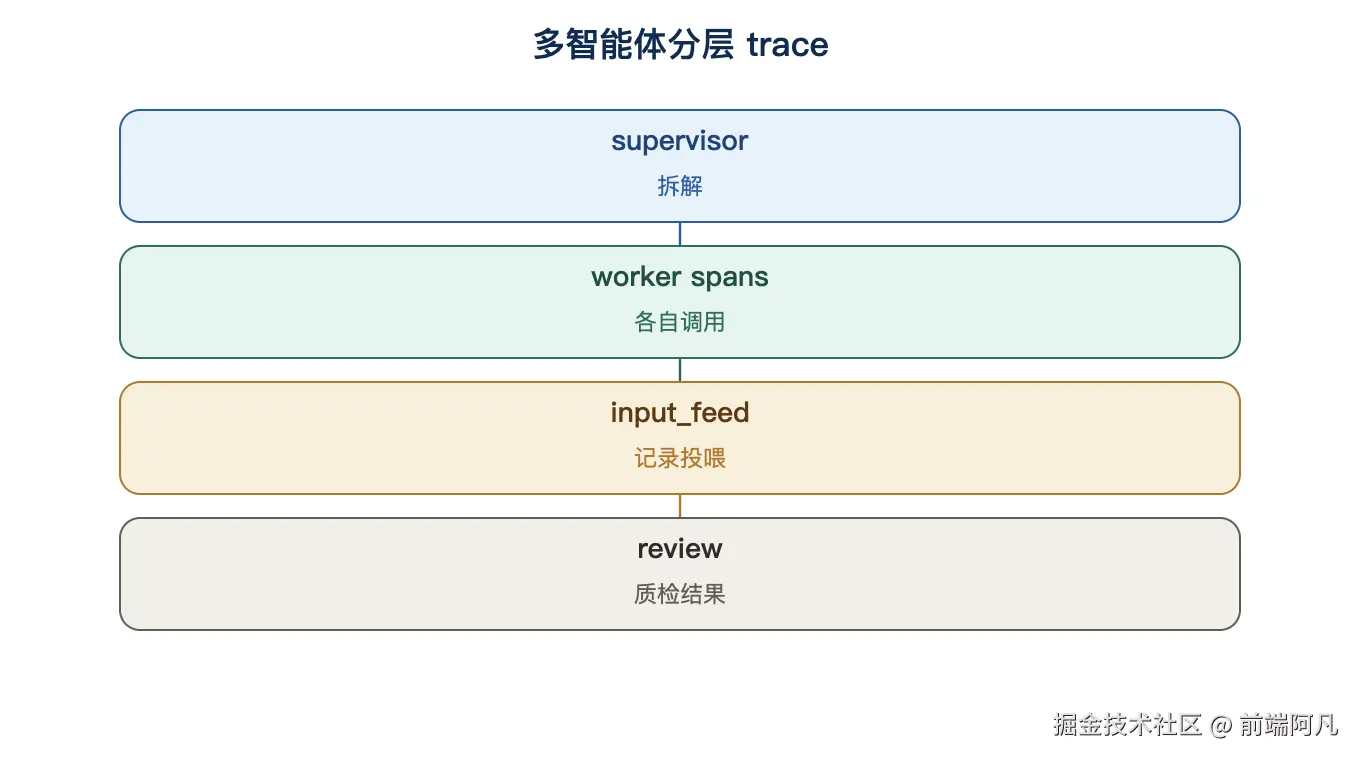
图 3:多智能体分层 trace
关键记录点 :每个 worker span 要记录投喂了什么(input_feed)------串扰排查时,看"这个 worker 到底看到了什么"。
28.3.3 常见多智能体故障定位(第 21 章分类)
| 现象 | trace 特征 | 修复 |
|---|---|---|
| 报告内容不对 | 某个 worker 输出异常 | 看该 worker 的 input_feed 是否被污染 |
| 任务卡住 | 某 span 超时 | 检查该 worker 的工具/依赖 |
| 越权操作 | worker 调了角色外的工具 | 检查权限配置(第 22 章) |
| 复核长期不通过 | 打回循环 | 复核标准太严或写手没接到意见(加轮数上限) |
28.4 上线与迭代
28.4.1 上线检查(第 22 章清单应用)
| 检查项 | 说明 |
|---|---|
| 角色最小权限 | 每个 worker 只配必需工具 |
| 上下文隔离 | 按需投喂 + 结构化传递 |
| 停止条件 | 复核打回上限(2 次) |
| 预算熔断 | 单任务费用上限 |
| trace 开启 | 全链路留痕 |
28.4.2 协作效率度量(第 20 章四维指标扩展)
多智能体要多看两个指标:
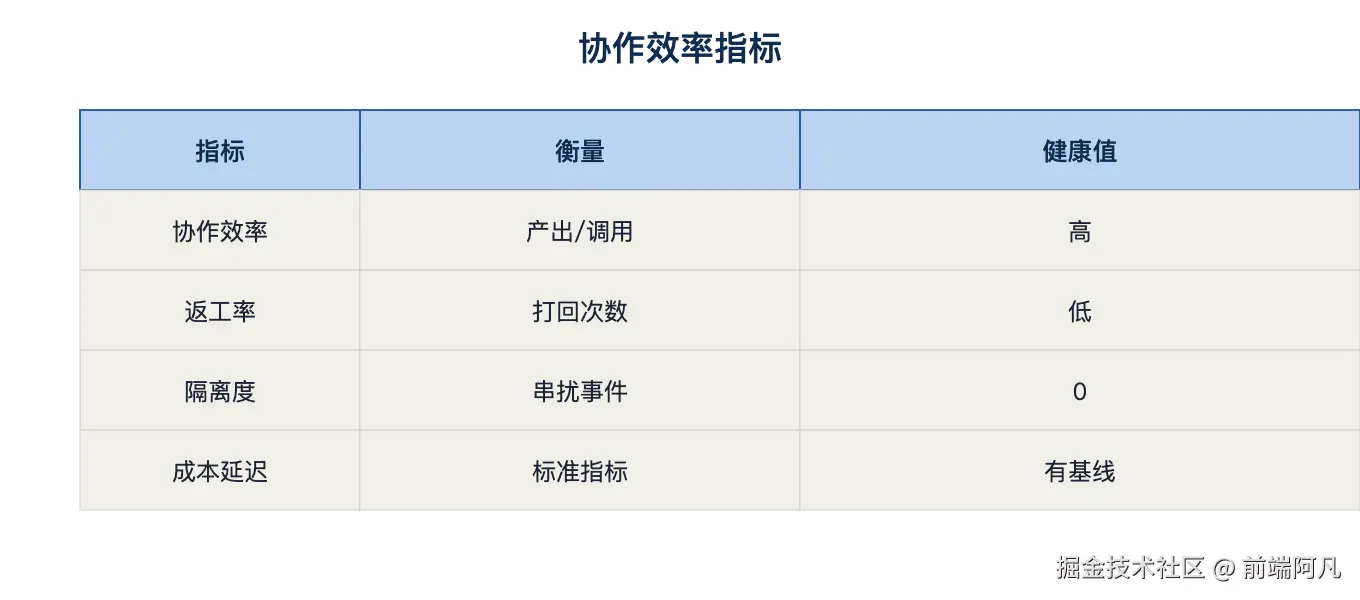
图 4:协作效率指标
| 指标 | 说明 | 健康值 |
|---|---|---|
| 协作效率 | 有效产出 / 总调用次数 | 高(别让 worker 空转) |
| 返工率 | 复核打回次数 / 总任务 | 低(写手一次写对) |
| 上下文隔离度 | 串扰事件数(trace 中查) | 0 |
| 单任务成本/延迟 | 第 20 章标准指标 | 有基线 |
"多智能体不是越多越好":如果协作效率低(大量空转调用),说明任务不需要这么多 Agent------回退到单 Agent 或提示链(第 16 章立场:先证明单 Agent 不行再上)。
28.4.3 迭代节奏
上线 → 每周抽 10 份报告人工评质量(第20章抽评)
  → 收集失败案例 → 更新角色提示词/任务图
  → 评测回归 → 灰度 → 上线
🛠 解决方案:多智能体上下文隔离方案 + 协作效率度量
常见问题
- "worker 互相污染上下文":广播投喂。对策:按需投喂 + 结构化传递(28.2.3)。
- "复核反复打回,任务卡死":无打回上限。对策:打回上限 2 次 + 超限转人工(28.3.3)。
- "写手瞎编数据":数据没传给写手或传了原文。对策:写手只吃结构化结果 + 复核查出处(28.2.2)。
- "某 worker 越权调工具":权限没按角色配。对策:RBAC + 工具白名单(第 22 章)。
- "多智能体比单 Agent 还慢还贵":任务不需要多 Agent。对策:评估协作效率,回退到单 Agent/提示链(28.4.2)。
解决方案速查表
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 上下文串扰 | 广播投喂 | 按需投喂 + 结构化传递 |
| 复核卡死 | 无打回上限 | 上限 2 次 + 转人工 |
| 写手编数据 | 无结构化输入 | 只吃 JSON + 复核查出处 |
| worker 越权 | 权限未配 | RBAC 白名单 |
| 又慢又贵 | 过度多 Agent | 回退单 Agent |
实战提示
- 默认主从 + 流水线混合:主管拆解、worker 干活、复核兜底------最稳形态(第 16 章)。
- 上下文隔离是第一原则:input_feed 记录投喂内容,串扰一眼可见。
- 复核要"独立裁判":复核员不写内容、不给写手工具,保持中立。
- 打回要有上限:2 次打回后转人工,别让系统自己绕圈。
- 用协作效率说话:多智能体跑得值不值,看指标,不看"看起来高级"。