作者:来自 Elastic Parker Timmins, Martijn Van Groningen
第二条规则使空字符串过滤器的速度提升了 1.6 倍。它直接从偏移数组中读取字符串长度,完全不会访问压缩后的字节。这两条规则都源于同一种习惯:运行真实查询,并寻找特殊情况。
想获得 Elastic 认证?了解下一期 Elasticsearch 工程师培训何时开课!你现在可以开始免费云试用,或者立即在你的本地机器上试用 Elastic。
Lucene 查询重写规则让 Elasticsearch 的列式模式中的两个字符串扫描查询分别快 2.3 倍和 1.6 倍。这两条规则都会在运行时识别查询形态,并替换为成本更低的实现。对于 *google* 这样的通配符查询,它会使用子字符串搜索来代替自动机。对于 SearchPhrase != '' 这样的过滤器,则可以跳过 Zstd 解压缩,因为它只需要读取存储在偏移数组中的字符串长度。
列式模式是 Elasticsearch 针对分析优化的列式存储模式,专为日志分析等扫描密集型工作负载而构建。在此模式下,默认情况下,keyword 字段不会建立倒排索引,因此词项查询和通配符查询会扫描文档值。DocValuesSkippers(区域映射)已经可以减少扫描所需访问的数据量,而这些重写规则则进一步降低了剩余数据的处理成本。
Lucene 的查询重写机制如何工作
在 Lucene 中,每个查询都可以选择实现一个 rewrite 方法,该方法返回另一个查询。这个方法返回一个语义相同但实现方式不同的查询。查询引擎会反复调用 rewrite 方法,直到返回的查询不再发生变化。这个最终查询就是实际执行的查询。重要的是,rewrite 可以看到实际的查询参数,并根据这些参数对实现进行专门优化。
例如,在一个查找字符串字段包含值 "foo" 的文档的查询中,rewrite 方法知道我们正在搜索的词项是 "foo"。理论上,rewrite 可以将通用查询 类 替换为专门针对 "foo" 的查询。例如,可以将原始查询类 ScanningBinaryDocValuesTermQuery 替换为 FooQuery。当然,这条规则可能没有实际帮助,但它可以让我们了解查询重写规则能够实现的专门优化程度。
数据库系统 中的重写规则与查询优化
值得将重写规则放在数据库系统这一更大的背景下来看。Lucene 和 Elasticsearch 并不是第一个使用转换规则来优化查询的系统。大多数(或者可能所有)数据库系统都会在查询优化过程中使用某种规则系统。最具影响力的重写规则系统之一是 IBM 的 Starburst 数据库。该系统的核心贡献在于可扩展性;例如,可以添加新的数据类型和存储方法,以及(对我们来说最重要的)优化器重写规则。
每条规则由两部分组成:
-
**条件函数:**一个谓词,用于确定该规则是否适用于当前查询图。
-
**动作函数:**将查询计划重写为更优形式的转换操作。
规则引擎会持续应用匹配的规则,直到满足停止条件。
虽然 Lucene 的 rewrite 方法在表面上与这些条件函数和动作函数有所不同,但它实现了相同的目标。它会检查特定条件是否匹配,如果匹配,就通过返回一个新查询来应用重写。如果条件不匹配,rewrite 会返回 this,即用查询自身替换查询本身,也就是说,不应用该规则。
为什么这些规则位于 Lucene 中,而不是 ES|QL 查询优化器中
Elasticsearch 实际上在 Elasticsearch 查询语言(ES|QL)优化器中包含了一个独立的重写规则系统。这个系统作用于查询的高级结构;例如,通过谓词下推,避免对最终会被过滤掉的文档执行不必要的计算。但将规则系统放在 Lucene 中仍然很有用。由于 Lucene 充当 ES|QL(以及传统 _search)查询的存储层,因此,与在更高层的优化器中实现相比,在 Lucene 中更容易表达能够利用物理数据格式的重写规则。
通配符查询的查询重写规则:更简单的代码,无需自动机
通配符查询支持 ? 和 * 运算符,分别用于匹配任意一个字符和任意多个字符。这些运算符可以在通配符查询中出现任意次数。与 正则表达式 一样,为了判断一个字符串是否匹配通配符查询,我们会根据查询字符串构建一个自动机,然后使用字符串字节在自动机中进行状态转换。这种方式相对较快,但如果必须对每个文档执行一次,延迟就会不断累积。
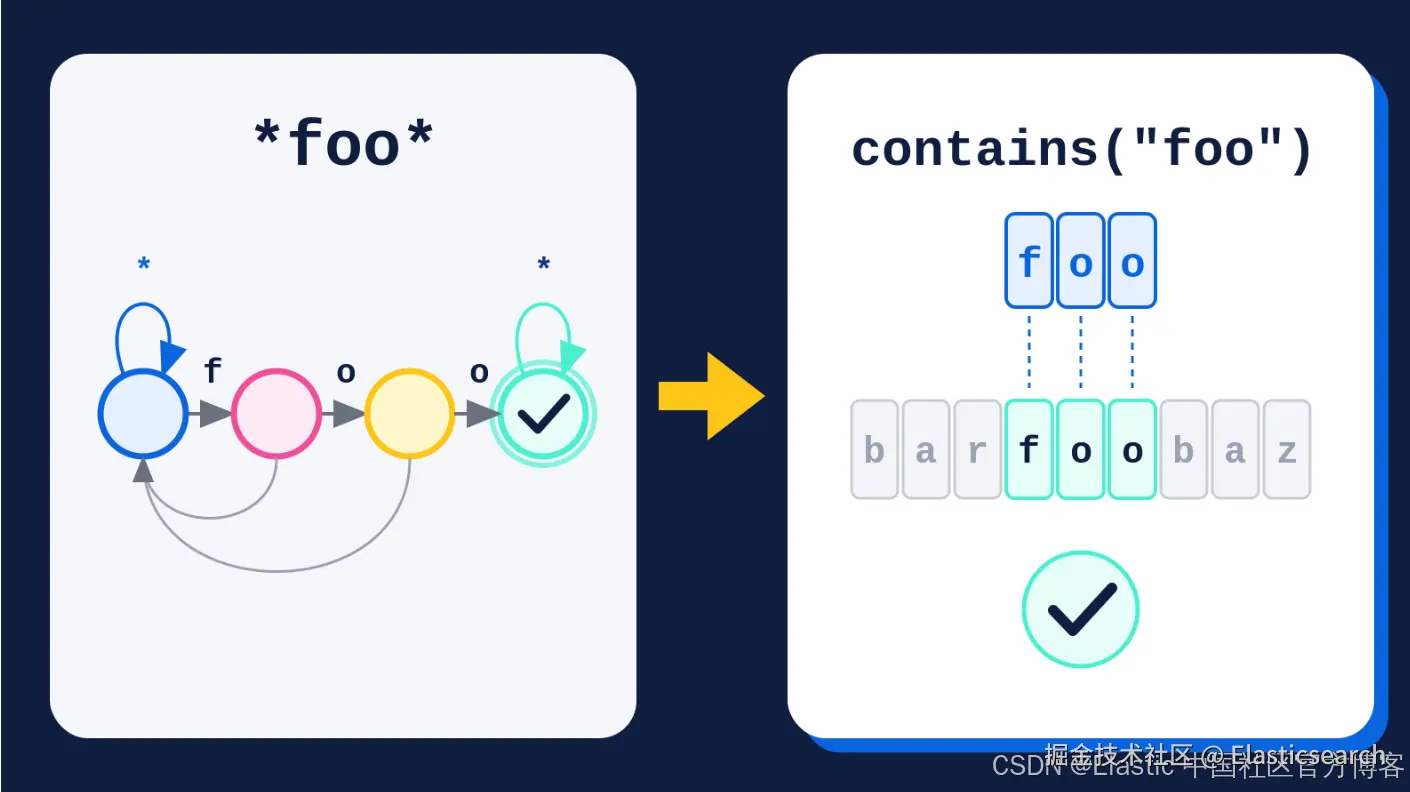
但我们可能并不总是需要运行自动机。考虑一下 *foo* 这样的查询。如果你正在编写一个简单的查询引擎,用于从字符串列表中查找匹配的字符串,你会如何实现?几乎每种编程语言都内置了你需要的工具:一个用于在给定字符串中查找子字符串的方法。这个函数不需要复杂的自动机;它可能只包含几个 for 循环。
当然,我们不能使用这个函数来实现任意通配符查询,但我们也不需要这么做。规则重写系统并不是用于通用形式,而是用于实现特殊情况,并且它可以看到具体的查询。它知道我们正在查找 *foo*,并意识到这个特定情况不需要重量级的自动机机制。对于任何以 * 开头和结尾、且中间包含某个词项的查询,它也可以采用相同的方法。
下面的伪代码展示了这种模式。在顶部,我们有通用的 WildcardQuery。它有两个值得注意的字段:查询字符串(例如 *foo*)以及根据该查询构建的自动机。matches 方法通过使用自动机评估状态转换,检查给定 docId 的字段值是否匹配。更有意思的是,它的重写方法会检查查询是否符合我们的特殊情况。这里我们使用一个正则表达式来检查查询字符串是否以 * 开头、至少包含一次非 * 字符,然后以 * 结尾。如果符合条件,我们就将这个特殊情况作为 ContainsQuery 返回,并传入内部查询字符串(因为它不关心 *)。然后,ContainsQuery 只需执行简单的 contains 检查,以判断词项字节是否存在于值字节中。
python
`
1. class WildcardQuery(query, automaton, docValues):
3. boolean matches(docId):
4. value = docValues.loadValue(docId)
5. return automaton.matches(value)
7. Query rewrite():
8. if query matches r"^\*[^*]+\*$":
9. return ContainsQuery(query[1:-1], docValues)
10. return self
13. class ContainsQuery(term, docValues):
15. boolean matches(docId):
16. value = docValues.loadValue(docId)
17. return value.contains(term)
`Lobster AI在 ClickBench Q20 上对通配符重写进行基准测试
通配符重写很直接,但它真的有效吗?是的,我们可以使用 ClickBench 基准测试,它包含多个这种形式的查询。查询 20(Q20)是 FROM hits | WHERE URL LIKE "*google*" | STATS count = COUNT(*)。它与这条规则匹配的查询形态完全一致:针对通配符查询 *google* 执行字符串匹配。由于该查询只是进行计数,因此我们可以准确看到这种技术的效果。事实证明,它非常有效。在没有过滤器缓存的情况下,Q20 的热查询时间中位延迟提升了 1.75 倍。本文中的所有基准测试均在 Intel Core i9-13900H 上运行。
向子字符串搜索添加 SIMD:从 1.75 倍提升到 2.3 倍
但我们还能做得更好吗?可以。切换到简单的 contains 检查后,就打开了一种新的可能性。我们不必使用两个 for 循环,而是可以将标量逻辑替换为单指令多数据(SIMD)逻辑。Elasticsearch 使用 Panama 向量 API(参见我们关于 Elasticsearch 中 SIMD 的文章),这使我们能够使用 SIMD 实现 contains 检查。对于较长的字符串,这种方式尤其有效,因为它们可以利用宽 SIMD 寄存器;对于长度小于 24 个字符的字符串,我们仍然使用标量方法。通过这一改变,我们又获得了 1.32 倍的性能提升,相对于基于自动机的方法,总体速度提升达到 2.3 倍。
空字符串的查询重写规则:更少的数据,无需解压缩
基于 Lucene 的规则的一个优势是它们处于较低层级,可以适配数据格式。这个规则就是如此,它适用于字符串数据。
列式存储如何编码字符串数据
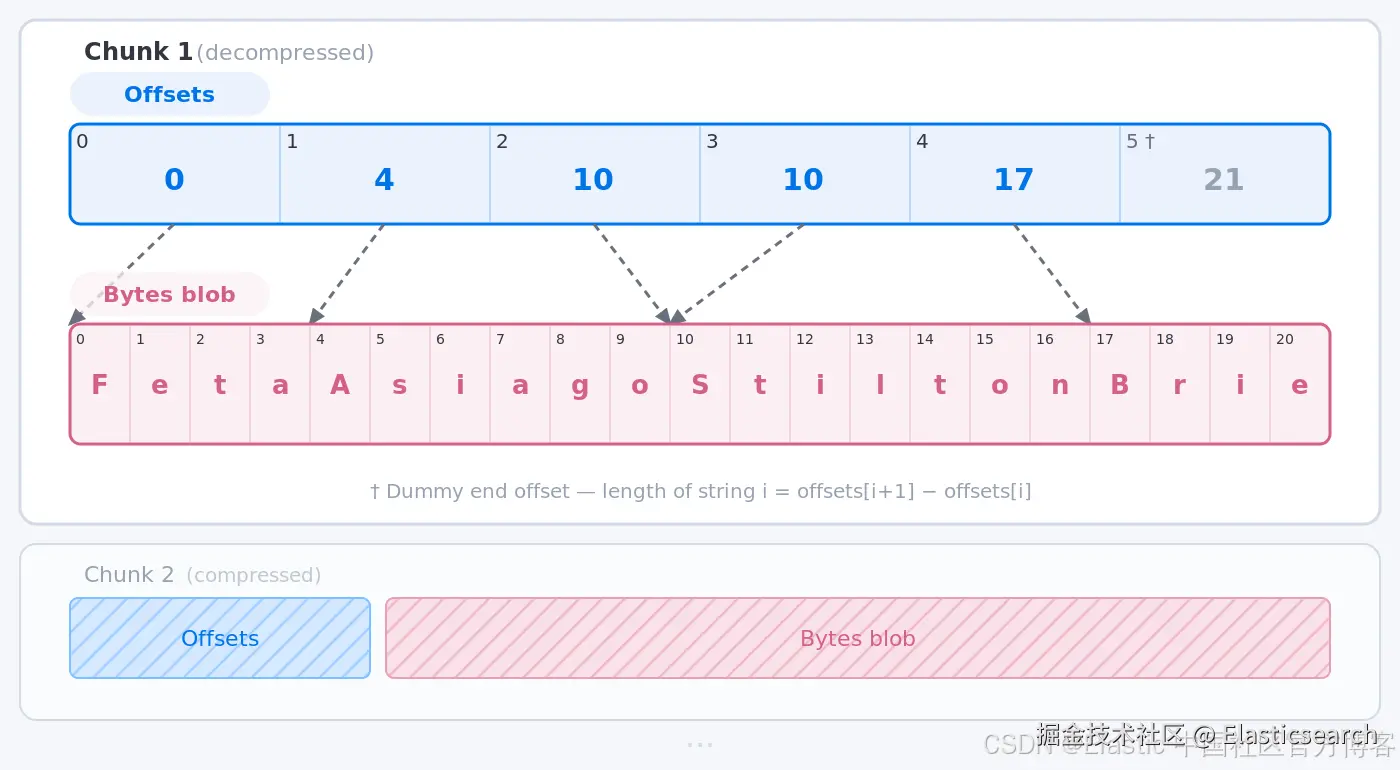
在 Elasticsearch 的标准模式下,字符串值按照文档进行存储;这是一种行式格式。但在列式模式下,顾名思义,数据采用列式格式存储。一列字符串数据会被存储在多个数据块中。每个数据块包含许多字符串值,由一个整数偏移数组和一个(经过 Zstd 压缩的)字符串字节数据块组成。对于索引为 i 的字符串,offsets[i] 指向解压缩后的字节数据块中该字符串开始的位置。因此,可以通过 offset[i+1]-offsets[i] 计算字符串 i 的长度。(末尾还有一个额外的虚拟偏移量,因此我们可以轻松计算最后一个字符串的长度。)下面的图展示了包含字符串 'Feta'、'Asiago'、''、'Stilton' 和 'Brie' 的数据块是如何编码的。
为什么词项查询必须解压数据块
现在我们已经了解了列式格式,接下来回到查询优化。首先,考虑针对查询 foo 的词项查询。我们要查找的是某个字符串字段的值与字符串 foo 完全匹配的文档。那么,如何在上述格式的字符串列上实现这一点呢?算法非常直接:
ini
`

1.  docId = 0
2.  for chunk in chunks:
3.      bytes = zstd_decompress(chunk.bytes)
4.  for i in range(len(chunk.offsets) - 1):
5.          value = bytes[chunk.offsets[i] : chunk.offsets[i+1]]
6.  if value == term:
7.  yield docId
8.          docId++

`Lobster AI
瓶颈在于 Zstd 解压缩步骤。但对此我们其实无能为力;如果我们想检查字节,就必须解压数据块。但请记住,我们并不是要优化一般情况,而是在寻找特殊情况。(实际上,你不会只是凭空想出特殊情况。这些优化最初都是通过先运行一个有用的查询,意识到它本可以更快,然后再寻找改进方法而产生的。)
将空字符串查询重写为长度检查
我们发现一个值得优化的特殊情况,是针对词项 "" 的查询。不得不承认,这是一个有点奇怪的词项,但空字符串到处都是。由于它们很少有用,我们通常会使用类似 term != "" 的查询将它们过滤掉。幸运的是,这是一个可以优化的查询。
考虑一下上面的空字符串词项算法。if value == term 这一行有点奇怪;我们实际上是在问:这个值是否等于空字符串? 我们可以进行这个检查,但由于没有字节需要比较,所以这个检查可以进一步简化:
-
我们只需要知道该值的长度是否为 0。
-
如果我们只需要长度,就不需要在解压后的数据块中查找该值。
-
如果我们完全不查找值,就完全不需要访问数据块中的任何字节。
-
如果我们不需要数据块中的任何字节,就不需要对它进行解压缩。
我们需要的全部信息就是长度,而这些长度存储在偏移数组中。偏移数组本身也是经过压缩的,但使用的是成本较低的整数压缩,而不是 Zstd,因此速度快得多。
有了这一认识,我们就可以重写空字符串词项查询。我们需要的新操作只有一个:docValues.loadLength(docId),它直接从偏移数组读取数据,而不会访问压缩后的字节。结合前面的示例来看,这应该已经很熟悉了。最有意思的部分是 TermEqualsQuery.rewrite;它会找到空字符串这一特殊情况,并将查询替换为更简单的版本,该版本只检查长度。
ini
`
1. class TermEqualsQuery(term, docValues):
3. boolean matches(docId):
4. value = docValues.loadValue(docId) # requires Zstd decompression
5. return value == term
7. Query rewrite():
8. if term == "":
9. return LengthEqualsQuery(0, docValues)
10. return self
13. class LengthEqualsQuery(queryLen, docValues):
15. boolean matches(docId):
16. length = docValues.loadLength(docId) # reads only from offset array
17. return length == queryLen
`Lobster AI对空字符串重写进行基准测试:速度提升 1.6 倍
现在让我们看看它的表现如何。ClickBench 中没有使用这条规则的纯扫描查询,像前面的规则中 Q20 那样直接,因此我们自己创建一个。考虑下面这个查询:FROM hits | WHERE SearchPhrase != '' | STATS count(*)。在这个查询上,我们看到速度提升了 1.6 倍,对于一个相当简单的改动来说,这是一个很大的提升。更好的是,ES|QL 可以直接利用 loadLength。每当 ES|QL 访问字符串的 BYTE_LENGTH,而不需要字符串本身时,请求就会使用这种相同的专用长度加载方式,从而避免不必要的解压缩。
什么样的查询重写规则才是好的
这里介绍的两条规则遵循相同的模式:识别出查询属于一种特殊情况,然后将其替换为成本更低的实现。但它们降低成本的方式不同。
| 通配符规则 | 空字符串规则 |
|---|---|
| 检测到的查询形态 | |
*term* |
field == "" |
| 替换为 | |
| SIMD 子字符串搜索 | 对偏移数组执行长度检查 |
| 降低的成本 | |
| 算法计算量 | 数据访问 |
| 速度提升 | |
| 2.3 倍 | 1.6 倍 |
这里的底层模式值得注意:找到一个性能没有得到充分发挥的查询,找到一个可以优化的特殊情况,然后换用成本更低的实现。困难之处在于找到能够揭示这些优化机会的查询,然后识别出其中的特殊情况。正如这里的两条规则所展示的,实际修复通常相对直接。我们在列式模式上的工作提供了许多运行有趣查询的机会,也让我们能够找出这类确切的性能提升。
这也是为什么规则系统中的可扩展性如此重要。这些规则不可能从一开始就内置到数据库中;它们是通过逐步发现的过程找到的。Lucene 的重写系统使这一过程变得切实可行。随着列式模式不断发展,以处理新的工作负载,这样的规则还会不断出现。
如果你想尝试列式模式以及本文介绍的优化,可以使用 Elastic Cloud 的 Serverless,或者使用 Elasticsearch 9.5 及更高版本,其中列式模式以技术预览形式提供。
原文:How query rewrite rules made Elasticsearch scans 2.3x faster | Elasticsearch Labs