把 Transformer Decoder 用于生成式预训练,并证明预训练得到的语言知识可以迁移到多个 NLP 任务。
1. 想解决的问题
GPT 原论文的全名是:
Improving Language Understanding by Generative Pre-Training
关注的问题:NLP 的标注数据很少,但互联网中存在大量无标注文本,能不能先从这些无标注文本中学习通用的语言知识,再把这些知识迁移到各种具体任务?
因此 GPT 提出了经典的:
Generative Pre-Training + Discriminative Fine-Tuning
也就是:
大量无标注文本
      ↓
   预训练
      ↓
学习通用语言知识
      ↓
针对具体任务微调
      ↓
分类 / 推理 / 问答 / 相似度......
是后来大语言模型发展的重要基础。
2. 网络结构?
GPT 使用 Transformer Decoder。整体结构可以理解为:
输入文本
   ↓
Token Embedding + Position Embedding
   ↓
Transformer Decoder
   ↓
Transformer Decoder
   ↓
...
   ↓
Transformer Decoder
   ↓
每个位置的上下文表示
   ↓
Linear + Softmax
   ↓
预测下一个 Token
原始 GPT 使用12 层 Transformer Decoder,hidden size 为 768,12 个 attention heads,约 117M 参数。
GPT 的重要工作是:
把 Transformer Decoder 用于生成式预训练,并证明预训练得到的语言知识可以迁移到多个 NLP 任务。
3. GPT 是如何进行预训练的?
是 GPT 和 BERT 最重要的区别之一。
GPT 使用的是自回归语言模型(Autoregressive Language Model)。
如:
The cat is sitting on the mat.
GPT 会学习:利用前面的 Token 预测下一个 Token。
The → 预测 cat
The cat → 预测 is
The cat is → 预测 sitting
The cat is sitting → 预测 on
...
数学形式: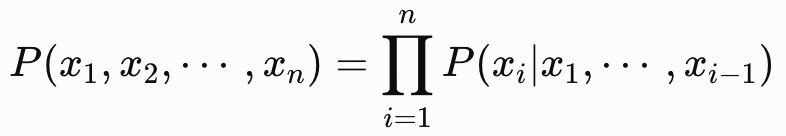
所以 GPT 的训练目标本质上就是:给定前面的词→预测下一个词
4. 为什么 GPT 必须使用 Mask?
因为 GPT 要模拟真正的文本生成过程。
假设:
The cat is sitting当 GPT 预测 sitting 时,它只能看到:
The cat is → sitting不能提前看到:
on the mat否则训练的时候就相当于"作弊"。
因此 GPT 使用 causal mask / causal attention:
        The  cat  is  sitting  on
The      ✓    ✗    ✗     ✗      ✗
cat      ✓    ✓    ✗     ✗      ✗
is       ✓    ✓    ✓     ✗      ✗
sitting  ✓    ✓    ✓     ✓      ✗
on       ✓    ✓    ✓     ✓      ✓
所以 GPT 的 Self-Attention 是:
只能看当前位置及其左侧的 Token。
这也是为什么 GPT 属于 Decoder-only Transformer。
5. 为什么叫"Generative"?
因为它天然具有生成能力。
例如给 GPT:
The weather today is它预测:
The weather today is → good然后把 good 接回去:
The weather today is good再预测:
→ .不断重复:
已有文本 → 预测下一个 Token → 把 Token 加回来 → 继续预测 → ......最终生成完整文本。所以 GPT 的预训练目标本身就和文本生成高度一致。
6. 预训练之后怎么办?
GPT 原论文并不是直接让预训练模型去做所有任务,而是继续进行 Fine-tuning。
如:
情感分类
"I really like this movie." → GPT → 分类层 → Positive文本蕴含
Premise + Hypothesis → GPT → 分类器 → Entailment / Neutral / Contradiction问答
Question + Passage → GPT → 输出答案因此 GPT 的核心范式是:
                    GPT
                     │
          ┌──────────┴──────────┐
          ↓                     ↓
   Unsupervised              Supervised
    Pre-Training             Fine-Tuning
          ↓                     ↓
 大规模无标注文本          下游任务数据
          │                     │
          └──────────┬──────────┘
                     ↓
               下游任务性能
7. GPT 和 BERT 的区别
对理解后面的 LLM 很重要。
| GPT | BERT | |
|---|---|---|
| Transformer | Decoder | Encoder |
| Attention | 单向 | 双向 |
| 预训练目标 | 自回归语言模型 | MLM + NSP |
| 预测方式 | 预测下一个 Token | 预测被 Mask 的 Token |
| 主要特点 | 生成 | 理解 |
| 典型方向 | GPT → GPT-2 → GPT-3 → ChatGPT | BERT → RoBERTa → DeBERTa |
直观理解:
BERT:

The cat is [MASK] on the mat.
             ↑
         左边 + 右边
             ↓
          sitting
而 GPT:
The cat is
     ↓
  sitting
     ↓
The cat is sitting
     ↓
    on
BERT 是"根据上下文填空",GPT 是"根据前文续写"。
8. GPT 原论文真正重要的贡献是什么?
GPT 原论文最值得记住的是下面三个点:
① Generative Pre-Training
利用大量无标注文本训练 Transformer:
先让模型自己从海量文本中学习语言规律。
② Pre-training + Fine-tuning
预训练得到通用语言知识,再针对具体任务进行微调,这成为后来大模型非常重要的基本范式。
通用语言知识 → 迁移 → 具体 NLP 任务③ Transformer Decoder 成为生成式语言模型的核心架构
GPT 证明了:
Decoder-only Transformer + 自回归语言建模,可以学习非常强的通用语言表示。
后面的 GPT-2、GPT-3 则沿着这条路线不断扩大模型和数据规模。
9. 和你前面看的 BERT 放在一起
你可以把两篇论文记成:
BERT(2018)
Transformer Encoder
       ↓
双向 Self-Attention
       ↓
Masked Language Model
       ↓
学习上下文表示
       ↓
理解型 NLP


GPT(2018)
Transformer Decoder
       ↓
单向 Causal Attention
       ↓
Autoregressive LM
       ↓
预测下一个 Token
       ↓
生成型 NLP
一句话总结 GPT:
GPT 基于 Transformer Decoder,通过自回归语言建模在大规模无标注文本上进行生成式预训练,学习通用语言知识,再通过微调迁移到各种下游 NLP 任务,为后续 GPT 系列大语言模型奠定了基础。