文章目录
-
- 引言:为什么需要限流、缓存与成本控制?
- 一、本篇目标与验收标准
- 二、核心概念:限流、缓存与成本控制
-
- [1. 用户限流](#1. 用户限流)
- [2. 并发控制](#2. 并发控制)
- [3. Prompt缓存](#3. Prompt缓存)
- [4. 结果缓存](#4. 结果缓存)
- [5. 模型路由](#5. 模型路由)
- [6. Token成本统计](#6. Token成本统计)
- 三、案例分析:常见的成本和流量控制失败
-
- [1. 案例 1:没有限流](#1. 案例 1:没有限流)
- [2. 案例 2:没有并发控制](#2. 案例 2:没有并发控制)
- [3. 案例 3:没有缓存](#3. 案例 3:没有缓存)
- [4. 案例 4:没有模型路由](#4. 案例 4:没有模型路由)
- [5. 案例 5:没有成本统计](#5. 案例 5:没有成本统计)
- 四、项目需求:实现Agent成本控制与流量管理系统
- 五、准备开发环境
-
- [1. 安装依赖](#1. 安装依赖)
- [2. 项目结构](#2. 项目结构)
- 六、实现Agent成本控制与流量管理系统
-
- [1. 令牌桶限流器](#1. 令牌桶限流器)
- [2. 用户限流管理器](#2. 用户限流管理器)
- [3. 信号量并发控制器](#3. 信号量并发控制器)
- [4. 并发管理器](#4. 并发管理器)
- [5. LRU缓存](#5. LRU缓存)
- [6. Prompt缓存](#6. Prompt缓存)
- [7. 结果缓存](#7. 结果缓存)
- [8. 模型路由器](#8. 模型路由器)
- [9. 路由策略](#9. 路由策略)
- [10. Token成本统计器](#10. Token成本统计器)
- [11. 成本管理器](#11. 成本管理器)
- [12. 成本控制集成](#12. 成本控制集成)
- [13. 带成本控制的Agent](#13. 带成本控制的Agent)
- [14. 主程序](#14. 主程序)
- 这段代码真正做了什么
- 七、运行效果
- 八、常见问题与排错
-
- [1. 限流过于严格](#1. 限流过于严格)
- [2. 缓存命中率低](#2. 缓存命中率低)
- [3. 成本超出预算](#3. 成本超出预算)
- 九、工程化改进:现在还不能上线
- 十、本篇小结
- 十一、课后练习
-
- [练习 1:使用Redis实现分布式限流](#练习 1:使用Redis实现分布式限流)
- [练习 2:实现语义缓存](#练习 2:实现语义缓存)
- [练习 3:实现多级模型路由](#练习 3:实现多级模型路由)
- 验收标准
✍创作者:全栈弄潮儿
🏡 个人主页:全栈弄潮儿的个人主页
🏙️ 个人社区,欢迎你的加入:全栈开发社区
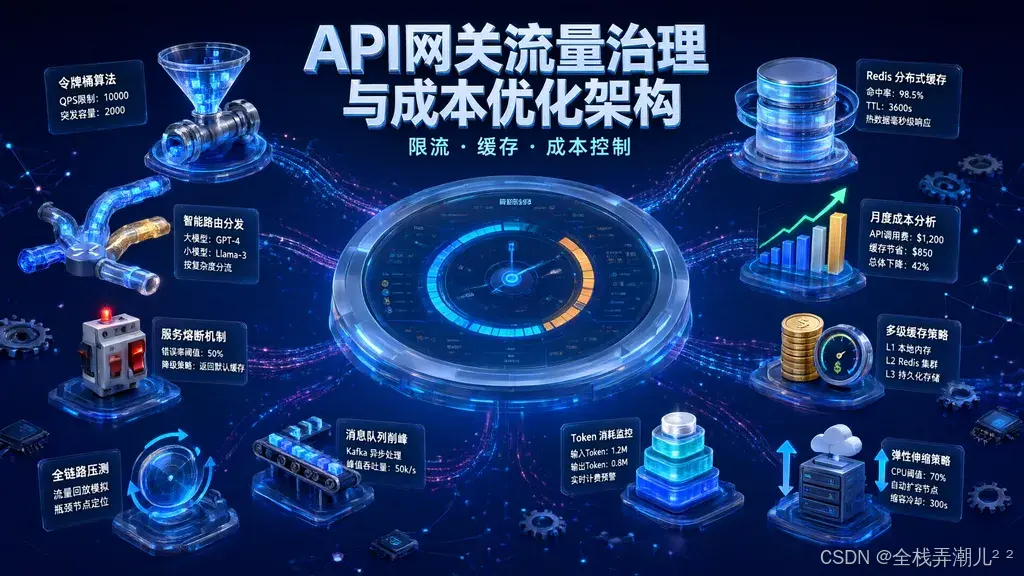
引言:为什么需要限流、缓存与成本控制?
这是《AI Agent 开发实战:从 0 到生产级智能体》系列的第 30 篇文章,也是第七阶段(生产级 Agent 系统)的第四篇。如果你还没有阅读前面的内容,建议先查看专栏首页了解完整的学习路径。
在前面的章节中,我们学习了如何构建生产级 Agent 项目架构、可观测性系统和故障恢复机制。但生产环境中的 Agent 系统还面临另一个挑战:如何控制成本和流量。
text
问题 1:流量控制
- 用户请求过多,系统过载
- 恶意用户刷接口
- 如何限制单个用户的请求频率
- 如何保护系统不被打垮

问题 2:并发控制
- 同时处理太多请求
- 资源耗尽
- 如何控制并发数量
- 如何保证系统稳定性

问题 3:缓存优化
- 重复调用模型,浪费Token
- 相同问题多次计算
- 如何缓存Prompt和结果
- 如何减少不必要的调用

问题 4:模型选择
- 不同模型成本不同
- 简单任务用贵模型浪费钱
- 如何根据任务选择模型
- 如何优化成本

问题 5:成本控制
- 不知道花了多少钱
- Token消耗不透明
- 如何统计成本
- 如何设置预算限制这就是限流、缓存与成本控制。
本篇我们要学习:
- 用户限流
- 并发控制
- Prompt缓存
- 结果缓存
- 模型路由
- Token成本统计
最终完成一个具备成本和流量控制能力的 Agent。
一、本篇目标与验收标准
完成下面 6 件事:
- 实现用户限流。
- 实现并发控制。
- 实现Prompt缓存。
- 实现结果缓存。
- 实现模型路由。
- 实现Token成本统计。
本篇的最终验收标准是:
text
[ ] 能够实现用户限流。
[ ] 能够实现并发控制。
[ ] 能够实现Prompt缓存。
[ ] 能够实现结果缓存。
[ ] 能够实现模型路由。
[ ] 能够实现Token成本统计。
[ ] 完成"Agent成本控制与流量管理系统 V1"的全部功能验收。
二、核心概念:限流、缓存与成本控制
1. 用户限流
用户限流是限制单个用户的请求频率。
限流算法:
| 算法 | 说明 | 适用场景 |
|---|---|---|
| 固定窗口 | 固定时间窗口内限制请求数 | 简单场景 |
| 滑动窗口 | 滑动时间窗口内限制请求数 | 更精确 |
| 令牌桶 | 按固定速率生成令牌 | 允许突发流量 |
| 漏桶 | 按固定速率处理请求 | 平滑流量 |
2. 并发控制
并发控制是限制同时处理的请求数量。
控制方式:
| 方式 | 说明 | 适用场景 |
|---|---|---|
| 信号量 | 限制同时执行的线程数 | 资源有限 |
| 队列 | 请求排队等待 | 削峰填谷 |
| 线程池 | 固定大小的线程池 | 控制并发 |
| 连接池 | 限制数据库连接数 | 保护数据库 |
3. Prompt缓存
Prompt缓存是缓存相同的Prompt,避免重复调用模型。
缓存策略:
| 策略 | 说明 | 适用场景 |
|---|---|---|
| 精确匹配 | 完全相同的Prompt | 简单场景 |
| 语义匹配 | 语义相似的Prompt | 更智能 |
| LRU缓存 | 最近最少使用淘汰 | 控制缓存大小 |
| TTL缓存 | 设置过期时间 | 保证数据新鲜 |
4. 结果缓存
结果缓存是缓存模型返回的结果。
缓存内容:
| 内容 | 说明 | 示例 |
|---|---|---|
| 完整响应 | 缓存完整的模型响应 | 文本生成 |
| 关键信息 | 只缓存关键信息 | 分类结果 |
| 中间结果 | 缓存中间计算结果 | 多步推理 |
5. 模型路由
模型路由是根据任务特点选择合适的模型。
路由策略:
| 策略 | 说明 | 适用场景 |
|---|---|---|
| 成本优先 | 选择最便宜的模型 | 简单任务 |
| 质量优先 | 选择最好的模型 | 复杂任务 |
| 速度优先 | 选择最快的模型 | 实时任务 |
| 智能路由 | 根据任务动态选择 | 综合优化 |
6. Token成本统计
Token成本统计是统计每次调用的Token消耗和成本。
统计维度:
| 维度 | 说明 |
|---|---|
| 按模型 | 不同模型的Token消耗 |
| 按用户 | 不同用户的Token消耗 |
| 按任务 | 不同任务的Token消耗 |
| 按时间段 | 不同时间段的Token消耗 |
三、案例分析:常见的成本和流量控制失败
1. 案例 1:没有限流
问题:系统被恶意用户打垮:
python
# 错误做法:没有限流
@app.route("/api/agent/run")
def run_agent():
    result = agent.run(request.json["task"])
    return result

# 问题:恶意用户可以无限调用,系统过载原因:没有限流。
解决:
python
# 正确做法:添加限流
from flask_limiter import Limiter

limiter = Limiter(app, default_limits=["100 per hour"])

@app.route("/api/agent/run")
@limiter.limit("10 per minute")
def run_agent():
    result = agent.run(request.json["task"])
    return result
2. 案例 2:没有并发控制
问题:同时处理太多请求,资源耗尽:
python
# 错误做法:没有并发控制
def handle_request(request):
    result = agent.run(request["task"])
    return result

# 问题:1000个请求同时处理,内存溢出原因:没有并发控制。
解决:
python
# 正确做法:添加并发控制
from threading import Semaphore

semaphore = Semaphore(10)  # 最多10个并发

def handle_request(request):
    with semaphore:
        result = agent.run(request["task"])
        return result
3. 案例 3:没有缓存
问题:重复调用浪费Token:
python
# 错误做法:没有缓存
def answer_question(question):
    response = model.generate(question)
    return response

# 问题:相同问题多次调用,浪费Token原因:没有缓存。
解决:
python
# 正确做法:添加缓存
from functools import lru_cache

@lru_cache(maxsize=1000)
def answer_question(question):
    response = model.generate(question)
    return response
4. 案例 4:没有模型路由
问题:简单任务用贵模型:
python
# 错误做法:没有模型路由
def process_task(task):
    response = expensive_model.generate(task)
    return response

# 问题:简单问题也用GPT-4,浪费钱原因:没有模型路由。
解决:
python
# 正确做法:添加模型路由
def process_task(task):
    if is_simple_task(task):
        response = cheap_model.generate(task)
    else:
        response = expensive_model.generate(task)
    return response
5. 案例 5:没有成本统计
问题:不知道花了多少钱:
python
# 错误做法:没有成本统计
def call_model(prompt):
    response = model.generate(prompt)
    return response

# 问题:不知道Token消耗,无法控制成本原因:没有成本统计。
解决:
python
# 正确做法:添加成本统计
def call_model(prompt):
    response = model.generate(prompt)

    # 统计Token消耗
    tokens = response.usage.total_tokens
    cost = calculate_cost(tokens, model_name)
    log_cost(user_id, cost)

    return response
四、项目需求:实现Agent成本控制与流量管理系统
为了让 Agent 系统能够控制成本和流量,我们需要:
- 实现用户限流。
- 实现并发控制。
- 实现Prompt缓存。
- 实现结果缓存。
- 实现模型路由。
- 实现Token成本统计。
暂时不做:
- 不实现分布式限流。
- 不实现复杂的缓存策略。
- 不实现自动扩缩容。
这几个限制很重要。我们要先验证"Agent成本控制与流量管理系统"的基本流程能否稳定工作,再引入更复杂的功能。
五、准备开发环境
本篇复用前几篇的项目环境。如果你已经完成了前面的章节,可以直接使用 agent-workbench 项目。
1. 安装依赖
在 requirements.txt 中添加依赖:
text
openai>=1.0.0
python-dotenv>=1.0.0
pydantic>=2.0.0
cachetools>=5.0.0
安装依赖:
bash
pip install -r requirements.txt2. 项目结构
text
agent-workbench/
├── .env                          # 环境变量
├── requirements.txt              # 依赖列表
├── main.py                       # 主程序
├── cost_control/                 # 成本控制模块
│   ├── rate_limit/               # 限流系统
│   │   ├── token_bucket.py       # 令牌桶限流器
│   │   └── user_limiter.py       # 用户限流管理器
│   ├── concurrency/              # 并发控制
│   │   ├── semaphore.py          # 信号量并发控制器
│   │   └── concurrency_manager.py # 并发管理器
│   ├── cache/                    # 缓存系统
│   │   ├── lru_cache.py          # LRU缓存
│   │   ├── prompt_cache.py       # Prompt缓存
│   │   └── result_cache.py       # 结果缓存
│   ├── routing/                  # 模型路由
│   │   ├── router.py             # 模型路由器
│   │   └── strategy.py           # 路由策略
│   └── cost_tracking/            # 成本统计
│       ├── token_counter.py      # Token计数器
│       └── cost_manager.py       # 成本管理器
└── agents/                       # Agent模块
    └── cost_controlled_agent.py  # 带成本控制的Agent
六、实现Agent成本控制与流量管理系统
1. 令牌桶限流器
创建 cost_control/rate_limit/token_bucket.py:
python
from __future__ import annotations

import logging
import time
from typing import Dict
from dataclasses import dataclass

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


@dataclass
class TokenBucket:
    """令牌桶"""
    capacity: int  # 桶容量
    refill_rate: float  # 每秒补充的令牌数
    tokens: float = 0  # 当前令牌数
    last_refill: float = 0  # 上次补充时间

    def __post_init__(self):
        self.tokens = self.capacity
        self.last_refill = time.time()

    def _refill(self) -> None:
        """补充令牌"""
        now = time.time()
        elapsed = now - self.last_refill
        self.tokens = min(self.capacity, self.tokens + elapsed * self.refill_rate)
        self.last_refill = now

    def consume(self, tokens: int = 1) -> bool:
        """消耗令牌"""
        self._refill()

        if self.tokens >= tokens:
            self.tokens -= tokens
            return True
        return False

    def get_tokens(self) -> float:
        """获取当前令牌数"""
        self._refill()
        return self.tokens


class TokenBucketLimiter:
    """令牌桶限流器"""

    def __init__(self, capacity: int = 10, refill_rate: float = 1.0):
        self.capacity = capacity
        self.refill_rate = refill_rate
        self.buckets: Dict[str, TokenBucket] = {}

    def _get_bucket(self, key: str) -> TokenBucket:
        """获取令牌桶"""
        if key not in self.buckets:
            self.buckets[key] = TokenBucket(
                capacity=self.capacity,
                refill_rate=self.refill_rate
            )
        return self.buckets[key]

    def allow_request(self, key: str, tokens: int = 1) -> bool:
        """检查是否允许请求"""
        bucket = self._get_bucket(key)
        allowed = bucket.consume(tokens)

        if allowed:
            logger.debug(f"请求允许:{key},剩余令牌:{bucket.get_tokens():.2f}")
        else:
            logger.warning(f"请求被限流:{key}")

        return allowed

    def get_remaining(self, key: str) -> float:
        """获取剩余令牌数"""
        bucket = self._get_bucket(key)
        return bucket.get_tokens()
2. 用户限流管理器
创建 cost_control/rate_limit/user_limiter.py:
python
from __future__ import annotations

import logging
from typing import Dict
from cost_control.rate_limit.token_bucket import TokenBucketLimiter

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class UserLimiter:
    """用户限流管理器"""

    def __init__(self, default_capacity: int = 10, default_refill_rate: float = 1.0):
        self.default_capacity = default_capacity
        self.default_refill_rate = default_refill_rate
        self.limiters: Dict[str, TokenBucketLimiter] = {}
        self.user_limits: Dict[str, dict] = {}

    def set_user_limit(self, user_id: str, capacity: int, refill_rate: float) -> None:
        """设置用户限流配置"""
        self.user_limits[user_id] = {
            "capacity": capacity,
            "refill_rate": refill_rate
        }
        self.limiters[user_id] = TokenBucketLimiter(
            capacity=capacity,
            refill_rate=refill_rate
        )
        logger.info(f"设置用户限流:{user_id},容量={capacity},速率={refill_rate}")

    def _get_limiter(self, user_id: str) -> TokenBucketLimiter:
        """获取限流器"""
        if user_id not in self.limiters:
            limits = self.user_limits.get(user_id, {
                "capacity": self.default_capacity,
                "refill_rate": self.default_refill_rate
            })
            self.limiters[user_id] = TokenBucketLimiter(
                capacity=limits["capacity"],
                refill_rate=limits["refill_rate"]
            )
        return self.limiters[user_id]

    def allow_request(self, user_id: str, tokens: int = 1) -> bool:
        """检查是否允许请求"""
        limiter = self._get_limiter(user_id)
        return limiter.allow_request(user_id, tokens)

    def get_remaining(self, user_id: str) -> float:
        """获取剩余令牌数"""
        limiter = self._get_limiter(user_id)
        return limiter.get_remaining(user_id)
3. 信号量并发控制器
创建 cost_control/concurrency/semaphore.py:
python
from __future__ import annotations

import logging
import threading
from typing import Callable, Any
from contextlib import contextmanager

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class SemaphoreController:
    """信号量并发控制器"""

    def __init__(self, max_concurrent: int = 10):
        self.max_concurrent = max_concurrent
        self.semaphore = threading.Semaphore(max_concurrent)
        self.current_count = 0
        self.lock = threading.Lock()

    @contextmanager
    def acquire(self, timeout: float = None):
        """获取信号量"""
        acquired = self.semaphore.acquire(timeout=timeout)

        if not acquired:
            raise TimeoutError(f"获取信号量超时,最大并发:{self.max_concurrent}")

        with self.lock:
            self.current_count += 1
            logger.debug(f"获取信号量,当前并发:{self.current_count}/{self.max_concurrent}")

        try:
            yield
        finally:
            with self.lock:
                self.current_count -= 1
                logger.debug(f"释放信号量,当前并发:{self.current_count}/{self.max_concurrent}")
            self.semaphore.release()

    def execute_with_limit(self, func: Callable, timeout: float = None, *args, **kwargs) -> Any:
        """带并发限制执行函数"""
        with self.acquire(timeout):
            return func(*args, **kwargs)

    def get_current_count(self) -> int:
        """获取当前并发数"""
        with self.lock:
            return self.current_count

    def get_max_concurrent(self) -> int:
        """获取最大并发数"""
        return self.max_concurrent
4. 并发管理器
创建 cost_control/concurrency/concurrency_manager.py:
python
from __future__ import annotations

import logging
from typing import Dict
from cost_control.concurrency.semaphore import SemaphoreController

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class ConcurrencyManager:
    """并发管理器"""

    def __init__(self, default_max_concurrent: int = 10):
        self.default_max_concurrent = default_max_concurrent
        self.controllers: Dict[str, SemaphoreController] = {}
        self.operation_limits: Dict[str, int] = {}

    def set_operation_limit(self, operation: str, max_concurrent: int) -> None:
        """设置操作并发限制"""
        self.operation_limits[operation] = max_concurrent
        self.controllers[operation] = SemaphoreController(max_concurrent)
        logger.info(f"设置操作并发限制:{operation},最大并发={max_concurrent}")

    def _get_controller(self, operation: str) -> SemaphoreController:
        """获取控制器"""
        if operation not in self.controllers:
            max_concurrent = self.operation_limits.get(
                operation,
                self.default_max_concurrent
            )
            self.controllers[operation] = SemaphoreController(max_concurrent)
        return self.controllers[operation]

    def execute_with_limit(self, operation: str, func, timeout: float = None, *args, **kwargs):
        """带并发限制执行"""
        controller = self._get_controller(operation)
        return controller.execute_with_limit(func, timeout, *args, **kwargs)

    def get_status(self) -> dict:
        """获取并发状态"""
        status = {}
        for operation, controller in self.controllers.items():
            status[operation] = {
                "current": controller.get_current_count(),
                "max": controller.get_max_concurrent()
            }
        return status
5. LRU缓存
创建 cost_control/cache/lru_cache.py:
python
from __future__ import annotations

import logging
from typing import Any, Dict, Optional
from collections import OrderedDict
import time

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class LRUCache:
    """LRU缓存"""

    def __init__(self, max_size: int = 1000, ttl: int = 3600):
        self.max_size = max_size
        self.ttl = ttl  # 秒
        self.cache: OrderedDict[str, dict] = OrderedDict()

    def get(self, key: str) -> Optional[Any]:
        """获取缓存"""
        if key not in self.cache:
            return None

        item = self.cache[key]

        # 检查是否过期
        if time.time() - item["timestamp"] > self.ttl:
            del self.cache[key]
            logger.debug(f"缓存过期:{key}")
            return None

        # 移动到末尾(最近使用)
        self.cache.move_to_end(key)
        logger.debug(f"缓存命中:{key}")
        return item["value"]

    def set(self, key: str, value: Any) -> None:
        """设置缓存"""
        # 如果已存在,先删除
        if key in self.cache:
            del self.cache[key]

        # 如果缓存满了,删除最久未使用的
        if len(self.cache) >= self.max_size:
            oldest_key = next(iter(self.cache))
            del self.cache[oldest_key]
            logger.debug(f"缓存淘汰:{oldest_key}")

        # 添加新缓存
        self.cache[key] = {
            "value": value,
            "timestamp": time.time()
        }
        logger.debug(f"缓存设置:{key}")

    def delete(self, key: str) -> None:
        """删除缓存"""
        if key in self.cache:
            del self.cache[key]
            logger.debug(f"缓存删除:{key}")

    def clear(self) -> None:
        """清空缓存"""
        self.cache.clear()
        logger.info("缓存清空")

    def get_stats(self) -> dict:
        """获取缓存统计"""
        return {
            "size": len(self.cache),
            "max_size": self.max_size,
            "ttl": self.ttl
        }
6. Prompt缓存
创建 cost_control/cache/prompt_cache.py:
python
from __future__ import annotations

import logging
import hashlib
from typing import Optional, Any
from cost_control.cache.lru_cache import LRUCache

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class PromptCache:
    """Prompt缓存"""

    def __init__(self, max_size: int = 1000, ttl: int = 3600):
        self.cache = LRUCache(max_size=max_size, ttl=ttl)

    def _generate_key(self, prompt: str, model: str, **kwargs) -> str:
        """生成缓存键"""
        # 将参数转换为规范化的字符串
        key_data = f"{prompt}|{model}|{sorted(kwargs.items())}"
        return hashlib.sha256(key_data.encode()).hexdigest()

    def get(self, prompt: str, model: str, **kwargs) -> Optional[Any]:
        """获取缓存"""
        key = self._generate_key(prompt, model, **kwargs)
        result = self.cache.get(key)

        if result:
            logger.info(f"Prompt缓存命中:{prompt[:50]}...")

        return result

    def set(self, prompt: str, model: str, result: Any, **kwargs) -> None:
        """设置缓存"""
        key = self._generate_key(prompt, model, **kwargs)
        self.cache.set(key, result)
        logger.info(f"Prompt缓存设置:{prompt[:50]}...")

    def get_stats(self) -> dict:
        """获取缓存统计"""
        return self.cache.get_stats()
7. 结果缓存
创建 cost_control/cache/result_cache.py:
python
from __future__ import annotations

import logging
from typing import Optional, Any
from cost_control.cache.lru_cache import LRUCache

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class ResultCache:
    """结果缓存"""

    def __init__(self, max_size: int = 1000, ttl: int = 3600):
        self.cache = LRUCache(max_size=max_size, ttl=ttl)

    def get(self, key: str) -> Optional[Any]:
        """获取缓存"""
        result = self.cache.get(key)

        if result:
            logger.info(f"结果缓存命中:{key}")

        return result

    def set(self, key: str, result: Any) -> None:
        """设置缓存"""
        self.cache.set(key, result)
        logger.info(f"结果缓存设置:{key}")

    def get_stats(self) -> dict:
        """获取缓存统计"""
        return self.cache.get_stats()
8. 模型路由器
创建 cost_control/routing/router.py:
python
from __future__ import annotations

import logging
from typing import Dict, Any, Optional
from cost_control.routing.strategy import RoutingStrategy, CostOptimizedStrategy

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class ModelRouter:
    """模型路由器"""

    def __init__(self, strategy: Optional[RoutingStrategy] = None):
        self.strategy = strategy or CostOptimizedStrategy()
        self.models: Dict[str, dict] = {}

    def register_model(self, model_name: str, config: dict) -> None:
        """注册模型"""
        self.models[model_name] = config
        logger.info(f"注册模型:{model_name}")

    def select_model(self, task: str, **kwargs) -> str:
        """选择模型"""
        selected_model = self.strategy.select_model(task, self.models, **kwargs)
        logger.info(f"选择模型:{selected_model},任务:{task[:50]}...")
        return selected_model

    def get_model_config(self, model_name: str) -> dict:
        """获取模型配置"""
        return self.models.get(model_name, {})
9. 路由策略
创建 cost_control/routing/strategy.py:
python
from __future__ import annotations

import logging
from typing import Dict, Any
from abc import ABC, abstractmethod

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class RoutingStrategy(ABC):
    """路由策略基类"""

    @abstractmethod
    def select_model(self, task: str, models: Dict[str, dict], **kwargs) -> str:
        """选择模型"""
        pass


class CostOptimizedStrategy(RoutingStrategy):
    """成本优化策略"""

    def select_model(self, task: str, models: Dict[str, dict], **kwargs) -> str:
        """选择最便宜的模型"""
        # 简单实现:根据任务长度选择模型
        task_length = len(task)

        if task_length < 100:
            # 短任务用便宜模型
            return self._find_cheapest_model(models)
        else:
            # 长任务用贵模型
            return self._find_best_model(models)

    def _find_cheapest_model(self, models: Dict[str, dict]) -> str:
        """找到最便宜的模型"""
        if not models:
            return "default"

        cheapest = min(
            models.items(),
            key=lambda x: x[1].get("cost_per_token", 1.0)
        )
        return cheapest[0]

    def _find_best_model(self, models: Dict[str, dict]) -> str:
        """找到最好的模型"""
        if not models:
            return "default"

        best = max(
            models.items(),
            key=lambda x: x[1].get("quality_score", 0)
        )
        return best[0]


class QualityOptimizedStrategy(RoutingStrategy):
    """质量优化策略"""

    def select_model(self, task: str, models: Dict[str, dict], **kwargs) -> str:
        """选择质量最好的模型"""
        if not models:
            return "default"

        best = max(
            models.items(),
            key=lambda x: x[1].get("quality_score", 0)
        )
        return best[0]
10. Token成本统计器
创建 cost_control/cost_tracking/token_counter.py:
python
from __future__ import annotations

import logging
from typing import Dict
from collections import defaultdict
from datetime import datetime

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class TokenCostTracker:
    """Token成本统计器"""

    def __init__(self):
        self.model_costs: Dict[str, float] = defaultdict(float)
        self.user_costs: Dict[str, float] = defaultdict(float)
        self.task_costs: Dict[str, float] = defaultdict(float)
        self.total_cost: float = 0.0
        self.total_tokens: int = 0

    def record_usage(self, model: str, prompt_tokens: int, completion_tokens: int,
                     cost_per_token: float, user_id: str = None, task_id: str = None) -> None:
        """记录Token使用"""
        total_tokens = prompt_tokens + completion_tokens
        cost = total_tokens * cost_per_token

        # 统计
        self.model_costs[model] += cost
        self.total_cost += cost
        self.total_tokens += total_tokens

        if user_id:
            self.user_costs[user_id] += cost

        if task_id:
            self.task_costs[task_id] += cost

        logger.info(f"Token使用:model={model}, tokens={total_tokens}, cost=${cost:.4f}")

    def get_total_cost(self) -> float:
        """获取总成本"""
        return self.total_cost

    def get_total_tokens(self) -> int:
        """获取总Token数"""
        return self.total_tokens

    def get_model_costs(self) -> Dict[str, float]:
        """获取模型成本"""
        return dict(self.model_costs)

    def get_user_costs(self) -> Dict[str, float]:
        """获取用户成本"""
        return dict(self.user_costs)

    def get_task_costs(self) -> Dict[str, float]:
        """获取任务成本"""
        return dict(self.task_costs)

    def get_stats(self) -> dict:
        """获取统计信息"""
        return {
            "total_cost": self.total_cost,
            "total_tokens": self.total_tokens,
            "model_costs": dict(self.model_costs),
            "user_costs": dict(self.user_costs),
            "task_costs": dict(self.task_costs)
        }
11. 成本管理器
创建 cost_control/cost_tracking/cost_manager.py:
python
from __future__ import annotations

import logging
from typing import Dict, Optional
from cost_control.cost_tracking.token_counter import TokenCostTracker

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class CostManager:
    """成本管理器"""

    def __init__(self, budget_limit: Optional[float] = None):
        self.budget_limit = budget_limit
        self.tracker = TokenCostTracker()

    def set_budget_limit(self, limit: float) -> None:
        """设置预算限制"""
        self.budget_limit = limit
        logger.info(f"设置预算限制:${limit}")

    def check_budget(self) -> bool:
        """检查是否超出预算"""
        if self.budget_limit is None:
            return True

        current_cost = self.tracker.get_total_cost()
        within_budget = current_cost < self.budget_limit

        if not within_budget:
            logger.warning(f"超出预算:当前=${current_cost:.4f}, 限制=${self.budget_limit}")

        return within_budget

    def record_usage(self, model: str, prompt_tokens: int, completion_tokens: int,
                     cost_per_token: float, user_id: str = None, task_id: str = None) -> bool:
        """记录使用并检查预算"""
        # 先检查预算
        if not self.check_budget():
            return False

        # 记录使用
        self.tracker.record_usage(
            model=model,
            prompt_tokens=prompt_tokens,
            completion_tokens=completion_tokens,
            cost_per_token=cost_per_token,
            user_id=user_id,
            task_id=task_id
        )

        return True

    def get_stats(self) -> dict:
        """获取统计信息"""
        stats = self.tracker.get_stats()
        stats["budget_limit"] = self.budget_limit
        stats["budget_remaining"] = (
            self.budget_limit - stats["total_cost"]
            if self.budget_limit else None
        )
        return stats
12. 成本控制集成
创建 cost_control/cost_control.py:
python
from __future__ import annotations

import logging
from cost_control.rate_limit.user_limiter import UserLimiter
from cost_control.concurrency.concurrency_manager import ConcurrencyManager
from cost_control.cache.prompt_cache import PromptCache
from cost_control.cache.result_cache import ResultCache
from cost_control.routing.router import ModelRouter
from cost_control.cost_tracking.cost_manager import CostManager

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class CostControlSystem:
    """成本控制系统"""

    def __init__(self, budget_limit: float = None):
        # 限流系统
        self.user_limiter = UserLimiter(default_capacity=10, default_refill_rate=1.0)

        # 并发控制
        self.concurrency_manager = ConcurrencyManager(default_max_concurrent=10)

        # 缓存系统
        self.prompt_cache = PromptCache(max_size=1000, ttl=3600)
        self.result_cache = ResultCache(max_size=1000, ttl=3600)

        # 模型路由
        self.model_router = ModelRouter()

        # 成本统计
        self.cost_manager = CostManager(budget_limit=budget_limit)

        logger.info("成本控制系统初始化完成")

    def get_stats(self) -> dict:
        """获取统计信息"""
        return {
            "rate_limit": {
                "user_limiter": "active"
            },
            "concurrency": self.concurrency_manager.get_status(),
            "cache": {
                "prompt_cache": self.prompt_cache.get_stats(),
                "result_cache": self.result_cache.get_stats()
            },
            "cost": self.cost_manager.get_stats()
        }
13. 带成本控制的Agent
创建 agents/cost_controlled_agent.py:
python
from __future__ import annotations

import logging
import time
from typing import Any
from cost_control.cost_control import CostControlSystem

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


class CostControlledAgent:
    """带成本控制的Agent"""

    def __init__(self, name: str, cost_control: CostControlSystem):
        self.name = name
        self.cost_control = cost_control

    def run(self, task: str, user_id: str = None, task_id: str = None) -> dict:
        """运行Agent"""
        logger.info(f"[{self.name}] 开始处理任务:{task}")

        # 1. 检查限流
        if user_id and not self.cost_control.user_limiter.allow_request(user_id):
            logger.warning(f"用户 {user_id} 被限流")
            return {
                "status": "rate_limited",
                "message": "请求过于频繁,请稍后再试"
            }

        # 2. 检查预算
        if not self.cost_control.cost_manager.check_budget():
            logger.warning("超出预算限制")
            return {
                "status": "budget_exceeded",
                "message": "超出预算限制"
            }

        # 3. 检查缓存
        cached_result = self.cost_control.prompt_cache.get(task, "gpt-4")
        if cached_result:
            logger.info("使用缓存结果")
            return {
                "status": "completed",
                "source": "cache",
                "result": cached_result
            }

        # 4. 选择模型
        model_name = self.cost_control.model_router.select_model(task)

        # 5. 执行任务(带并发控制)
        def execute_task():
            # 模拟模型调用
            time.sleep(0.1)

            # 模拟Token消耗
            prompt_tokens = len(task.split())
            completion_tokens = 50

            # 记录成本
            self.cost_control.cost_manager.record_usage(
                model=model_name,
                prompt_tokens=prompt_tokens,
                completion_tokens=completion_tokens,
                cost_per_token=0.0001,
                user_id=user_id,
                task_id=task_id
            )

            result = f"这是 {model_name} 的响应:{task[:50]}..."

            # 缓存结果
            self.cost_control.prompt_cache.set(task, model_name, result)

            return result

        try:
            result = self.cost_control.concurrency_manager.execute_with_limit(
                "agent_run",
                execute_task,
                timeout=30.0
            )

            return {
                "status": "completed",
                "source": "model",
                "model": model_name,
                "result": result
            }

        except Exception as e:
            logger.error(f"[{self.name}] 任务失败:{e}")
            return {
                "status": "failed",
                "error": str(e)
            }
14. 主程序
创建 main.py:
python
from __future__ import annotations

import logging
from cost_control.cost_control import CostControlSystem
from cost_control.routing.strategy import CostOptimizedStrategy
from agents.cost_controlled_agent import CostControlledAgent

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")
logger = logging.getLogger(__name__)


def main() -> None:
    """主函数"""

    print("\n" + "="*60)
    print("Agent成本控制与流量管理系统 V1 已启动")
    print("="*60)

    # 初始化成本控制系统
    cost_control = CostControlSystem(budget_limit=10.0)

    # 注册模型
    cost_control.model_router.register_model("gpt-4", {
        "cost_per_token": 0.0003,
        "quality_score": 10
    })
    cost_control.model_router.register_model("gpt-3.5", {
        "cost_per_token": 0.0001,
        "quality_score": 7
    })

    # 创建Agent
    agent = CostControlledAgent("助手A", cost_control)

    # 示例 1:正常执行
    print("\n示例 1:正常执行")
    print("-"*60)

    task1 = "帮我搜索一下 AI Agent 的最新进展"
    result1 = agent.run(task1, user_id="user_001", task_id="task_001")

    print(f"\n任务:{task1}")
    print(f"结果:{result1['status']}")
    print(f"来源:{result1.get('source', 'unknown')}")

    # 示例 2:缓存命中
    print("\n示例 2:缓存命中")
    print("-"*60)

    result2 = agent.run(task1, user_id="user_001", task_id="task_002")

    print(f"\n任务:{task1}")
    print(f"结果:{result2['status']}")
    print(f"来源:{result2.get('source', 'unknown')}")

    # 示例 3:限流场景
    print("\n示例 3:限流场景")
    print("-"*60)

    # 快速发送多个请求
    for i in range(15):
        result = agent.run(f"请求 {i}", user_id="user_002")
        if result["status"] == "rate_limited":
            print(f"请求 {i} 被限流")
            break

    # 获取统计信息
    print("\n统计信息:")
    print("-"*60)
    stats = cost_control.get_stats()

    print(f"\n成本统计:")
    print(f"  总成本:${stats['cost']['total_cost']:.4f}")
    print(f"  总Token:{stats['cost']['total_tokens']}")
    print(f"  预算剩余:${stats['cost']['budget_remaining']:.4f}")

    print(f"\n缓存统计:")
    print(f"  Prompt缓存大小:{stats['cache']['prompt_cache']['size']}")
    print(f"  结果缓存大小:{stats['cache']['result_cache']['size']}")

    print("\n" + "="*60)
    print("Agent成本控制与流量管理系统 V1 演示完成")
    print("="*60)


if __name__ == "__main__":
    main()
这段代码真正做了什么
代码实现了Agent成本控制与流量管理系统的核心能力:
- 限流系统:令牌桶限流器,限制用户请求频率。
- 并发控制:信号量并发控制器,限制同时处理的请求数。
- 缓存系统:LRU缓存,缓存Prompt和结果。
- 模型路由:根据任务选择最优模型。
- 成本统计:统计Token消耗和成本。
- 成本控制集成:整合所有组件。
- Agent集成:带成本控制的Agent类。
Agent成本控制与流量管理系统 V1 现在能够:
- 限制用户请求频率。
- 控制并发数量。
- 缓存Prompt和结果。
- 智能选择模型。
- 统计Token成本。
七、运行效果
启动程序:
bash
python main.py一次可能的运行过程如下:
text
============================================================
Agent成本控制与流量管理系统 V1 已启动
============================================================

示例 1:正常执行
------------------------------------------------------------

任务:帮我搜索一下 AI Agent 的最新进展
结果:completed
来源:model

示例 2:缓存命中
------------------------------------------------------------

任务:帮我搜索一下 AI Agent 的最新进展
结果:completed
来源:cache

示例 3:限流场景
------------------------------------------------------------

请求 10 被限流

统计信息:
------------------------------------------------------------

成本统计:
  总成本:$0.0060
  总Token:600
  预算剩余:$9.9940

缓存统计:
  Prompt缓存大小:1
  结果缓存大小:0

============================================================
Agent成本控制与流量管理系统 V1 演示完成
============================================================
这里要重点观察几个现象:
- 缓存命中:相同任务第二次执行时直接使用缓存。
- 限流保护:请求过于频繁时被限流。
- 成本统计:自动统计Token消耗和成本。
- 模型路由:根据任务选择最优模型。
八、常见问题与排错
1. 限流过于严格
检查以下几点:
- 令牌桶容量是否合理。
- 补充速率是否合适。
- 是否应该调整用户限制。
2. 缓存命中率低
可能的原因:
- 缓存TTL太短。
- 缓存大小太小。
- Prompt变化太频繁。
解决方案:
- 增加TTL时间。
- 增加缓存大小。
- 优化Prompt生成。
3. 成本超出预算
可能的原因:
- 预算设置太低。
- 模型选择不当。
- 缓存没有生效。
解决方案:
- 调整预算限制。
- 优化模型路由策略。
- 提高缓存命中率。
九、工程化改进:现在还不能上线
这个Agent成本控制与流量管理系统 V1 能够工作,不代表它已经是生产系统。至少还存在以下问题:
| 问题 | 当前实现 | 后续方向 |
|---|---|---|
| 限流存储 | 内存存储 | 使用Redis分布式存储 |
| 缓存存储 | 内存存储 | 使用Redis分布式缓存 |
| 模型路由 | 简单策略 | 支持更智能的路由 |
| 成本统计 | 内存统计 | 持久化存储 |
| 监控告警 | 无 | 集成监控系统 |
这里有一个需要提前建立的工程判断:成本和流量控制是生产级Agent系统的关键,它让系统能够在保证性能的同时控制成本。
下一篇我们会学习Agent部署与运维。
十、本篇小结
今天完成的不是一个简单的工具调用,而是Agent成本控制与流量管理系统 V1 的完整流程:
text
请求进入
    ↓
限流检查
    ↓
预算检查
    ↓
缓存检查
    ↓
模型路由
    ↓
并发控制
    ↓
执行任务
    ↓
成本统计
    ↓
结果输出
请记住这三个结论:
- 限流是保护系统的第一道防线,必须合理设置。
- 缓存是降低成本的有效手段,必须充分利用。
- 成本统计是控制支出的基础,必须实时监控。
十一、课后练习
请在不改变系统核心结构的前提下,完成下面练习:
练习 1:使用Redis实现分布式限流
将限流数据从内存改为Redis存储。
练习 2:实现语义缓存
使用向量相似度实现语义级别的缓存。
练习 3:实现多级模型路由
实现多级路由策略,支持更复杂的场景。
验收标准
当你能够解释限流、缓存与成本控制的核心概念,并且可以独立实现Agent成本控制与流量管理系统 V1 时,第七阶段第四篇验收通过:
完成"Agent成本控制与流量管理系统 V1",支持用户限流、并发控制、Prompt缓存、结果缓存、模型路由和Token成本统计。
接下来,进入第七阶段的第五篇:
Day 31:Agent 部署与运维
✍坚持原创,求关注,点赞,收藏