同一份长文问两次,SGLang 怎样少算一遍
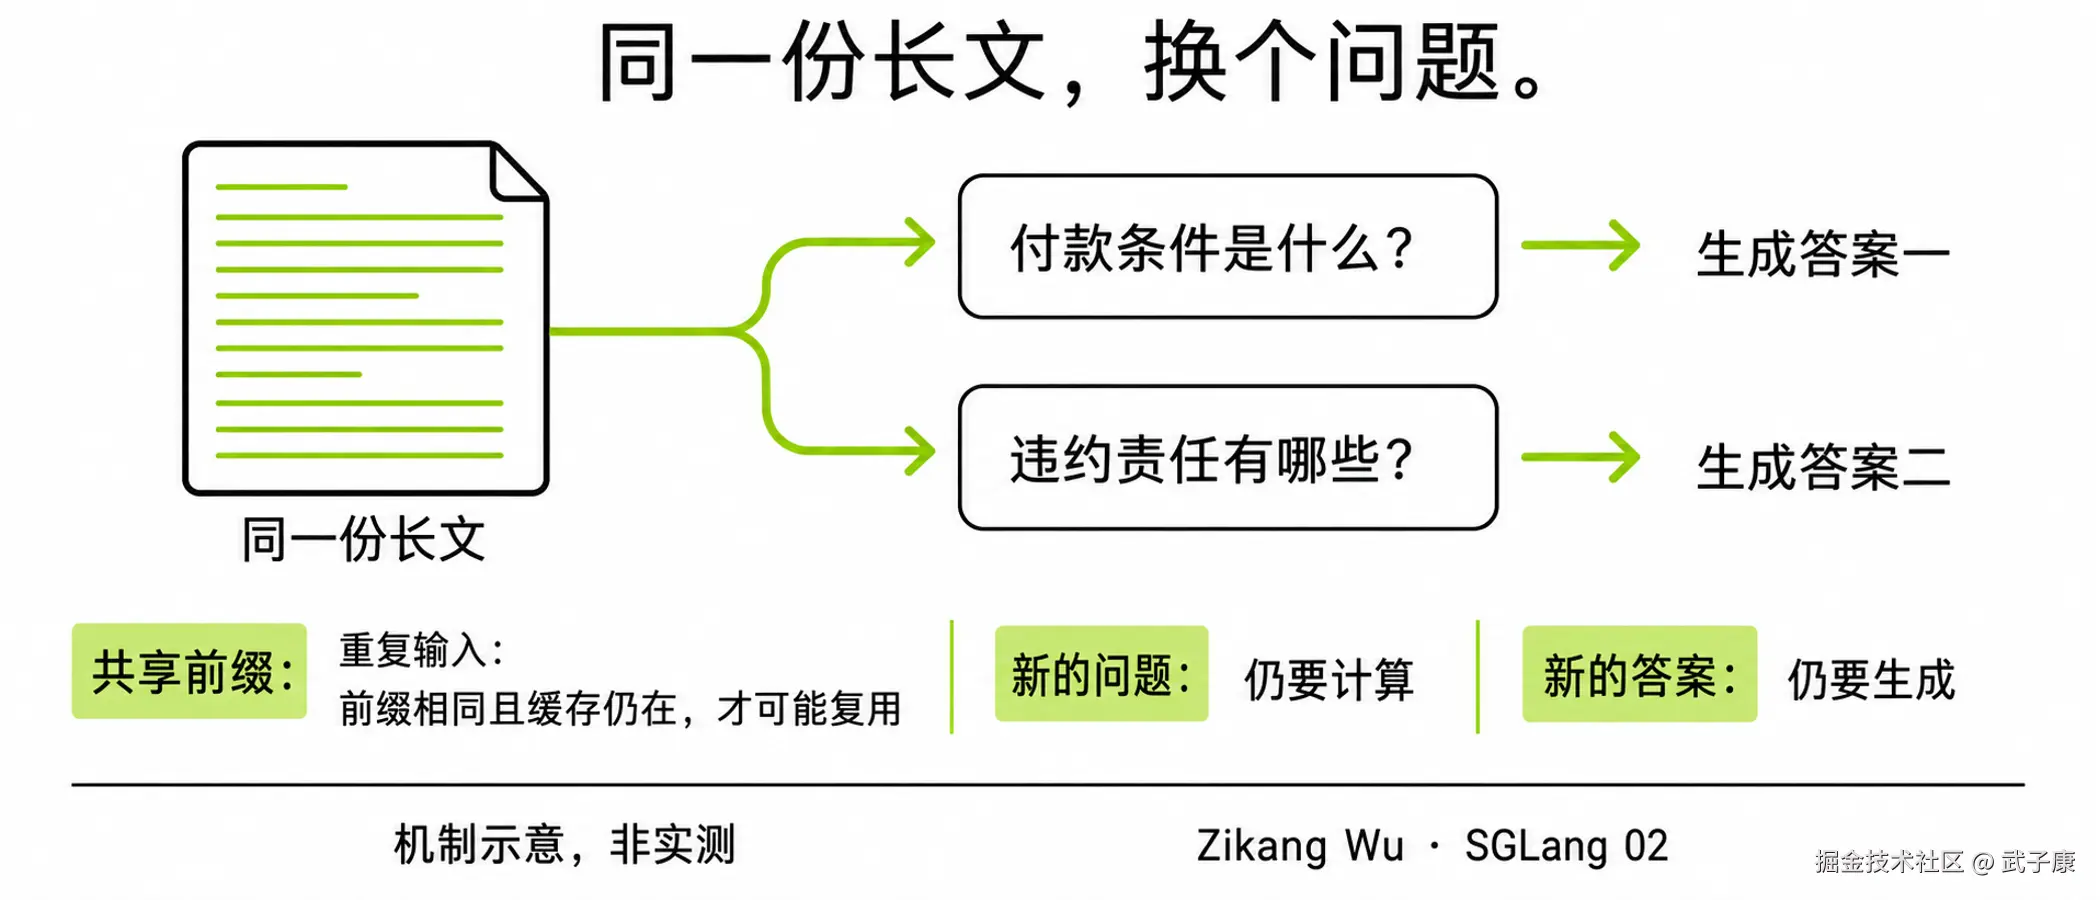
给模型一份长文,先问"付款条件是什么",再问"违约责任有哪些"。第二次的问题变了,文档没有变。模型还要把整份文档从头处理一遍吗?
如果两次请求在模型输入端共享相同的开头,且对应缓存仍在,SGLang 可以复用已经算过的中间结果。它不会直接拿第一次的答案回答第二个问题;省下的是重复处理输入的计算。
RadixAttention 这个名字说的就是这类复用。要看懂它,可以先把"缓存了什么"与"保存了答案"分开。
留下来的,是处理前文时算出的中间结果
在常见的自回归 Transformer 中,模型生成后面的 token 时,要用到前面位置的注意力 Key 和 Value。把这些中间结果留在内存里,就得到 KV Cache。它占用存储空间,却能减少后续计算。
处理输入的阶段叫 prefill,之后逐步生成新内容的阶段叫 decode。跨请求复用前缀,主要省的是共享输入段的 prefill。第二次提问的新问题,以及接下来生成的新答案,仍然要算。
LMSYS 最初介绍 RadixAttention 的文章给出了一个关键设计:请求完成后,不立即丢掉所有可复用 KV,而是用一棵树保留 token 序列与 KV 的对应关系,供后续请求查找。那篇文章里的模型和性能数据属于当年的实验,本文只借它解释机制,不把旧倍数当今天的收益。
两条输入在哪里分开,复用就在哪里停下
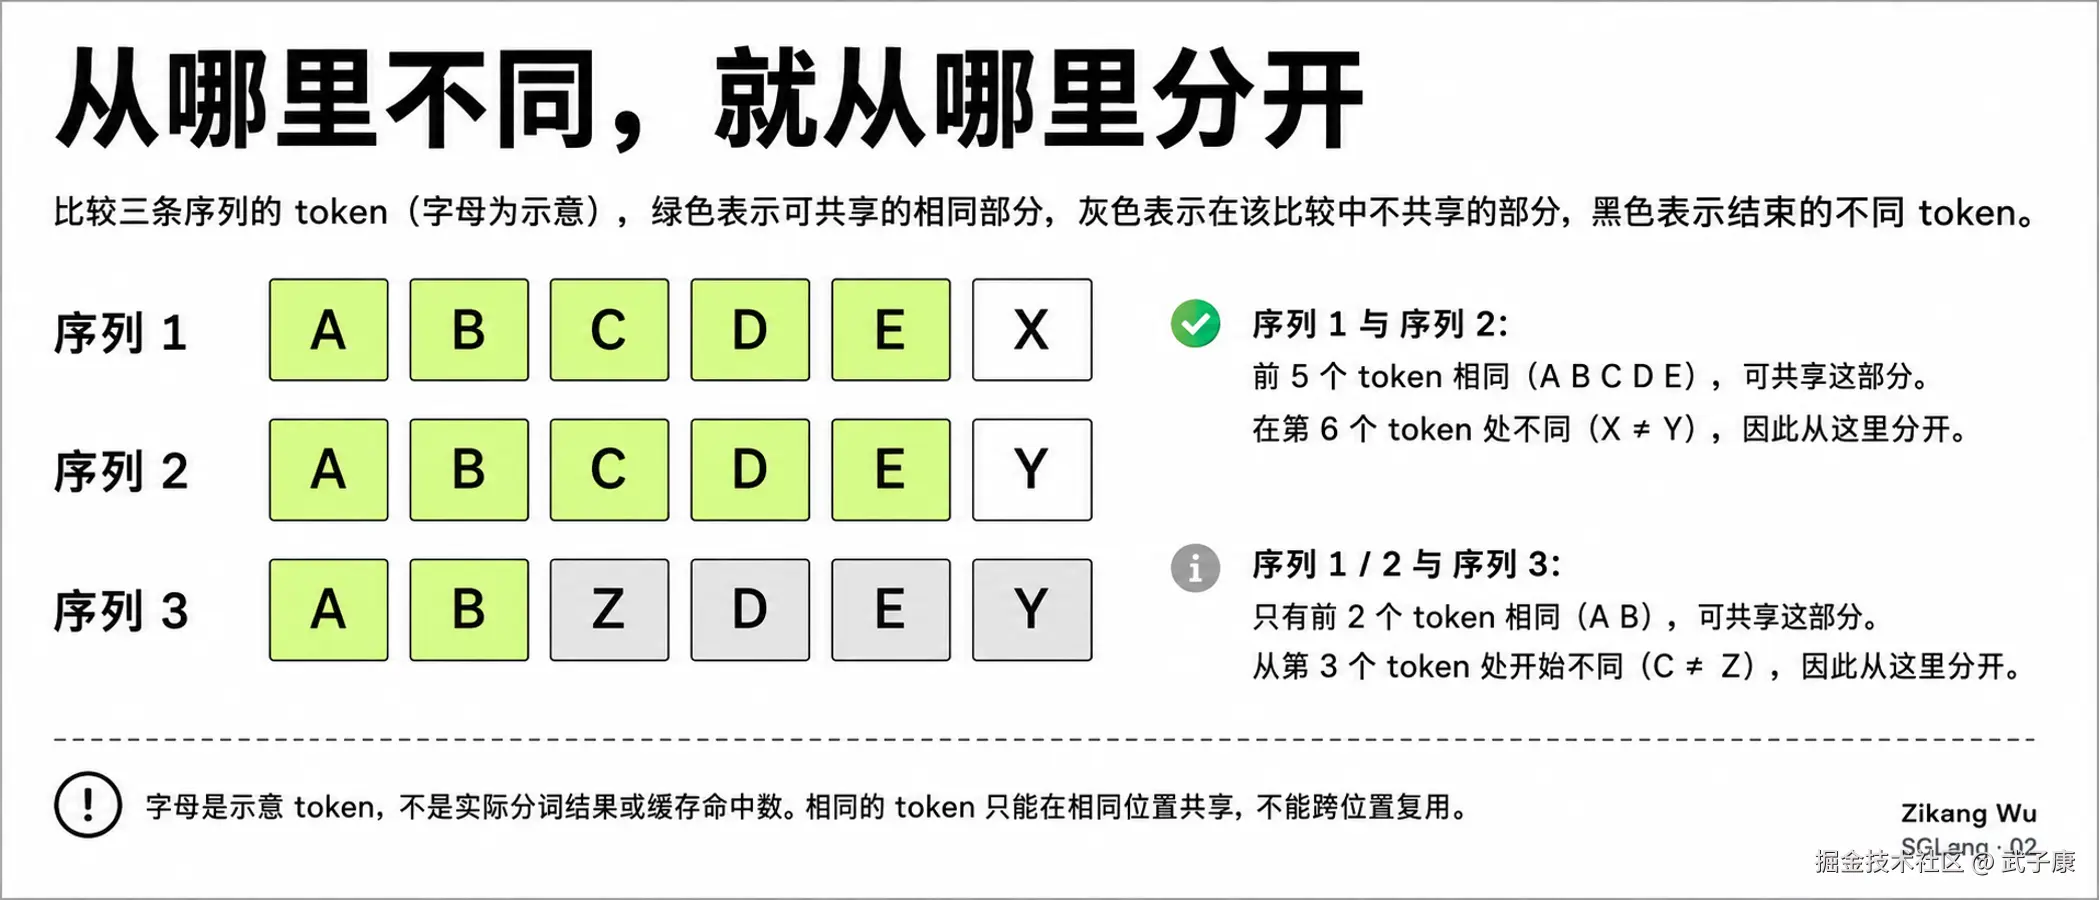
看一个简化示例。下面的 A、B 等代表示意 token,不对应某个真实分词器:
text
第一次输入:A B C D E X
第二次输入:A B C D E Y
第三次输入:A B Z D E Y
前两次开头的 A B C D E 相同,可以查找这一段对应的 KV。第三次从 Z 开始就不同,后面的 D、E 即使字面上再次出现,也不能直接当成第一次的同一段前缀。
原因在于,某个位置的中间结果与它前面看过的内容有关。把"前文不同、字面相同"的片段随意接起来,会改变模型计算的含义。
这也是为什么"同一个意思"没有用。请用中文回答 和 回答请使用中文 对人几乎一样,对分词后的序列却可能不同。实际复用还受模型、缓存实现、页对齐等条件限制,不能把示意序列中相同的 token 数直接当成服务报告的命中数。
树里保存公共部分,分开的部分各走一条路
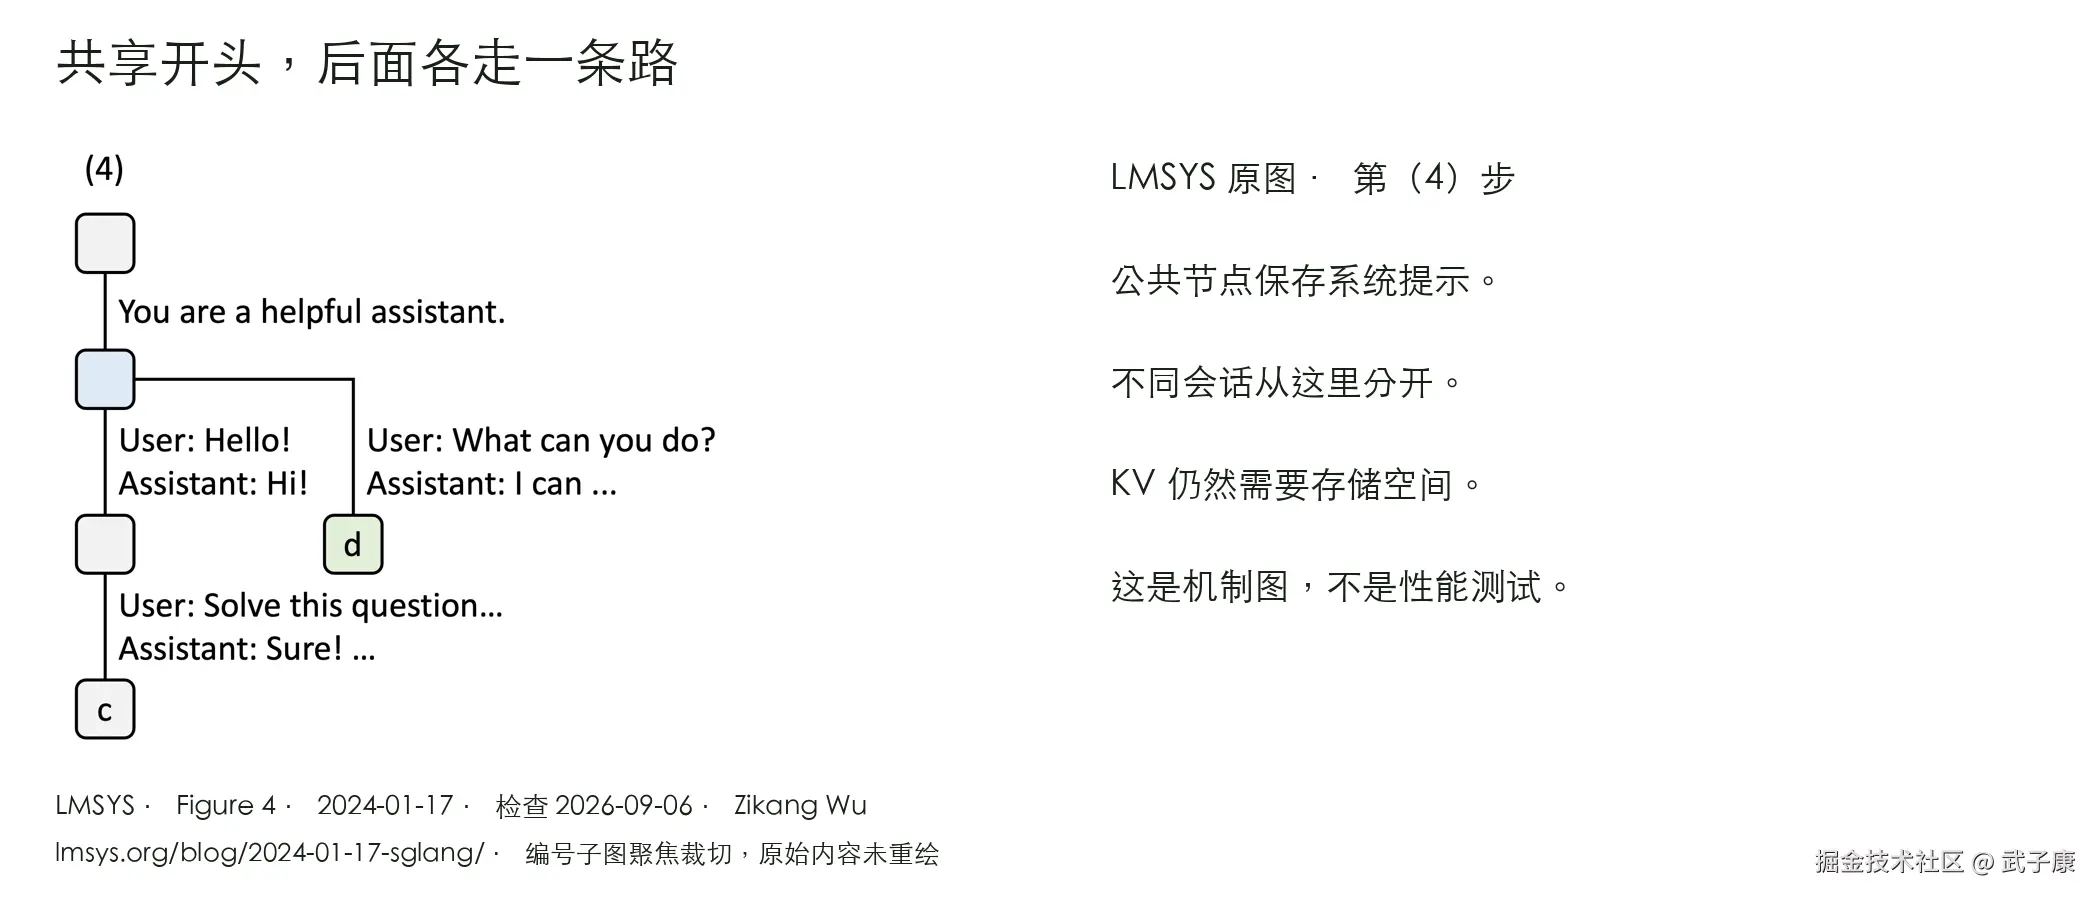
上图保留 LMSYS 2024-01-17 文章 Figure 4 的第(4)步原始像素:两个会话沿同一段系统提示走到公共节点,再沿不同分支继续。这里展示机制,不引用该文当年的速度比较。
假设已有 A B C D,又来了 A B X Y。Radix tree 可以把共同的 A B 留在一条路径上,后面分成 C D 与 X Y。它的边可以保存一段序列,不必每个 token 都单独建一个节点。
这棵树用于找到"这个请求已经算到哪里"。KV 数据本身仍需要占用缓存存储;画在纸上的一条线并不意味着没有显存成本。
因此,长文第二问是否更快,取决于连续的一串条件:第二问确实带了相同的输入开头;服务找到对应缓存;这部分缓存没有被回收;省下的计算在总等待中占了足够比例。任何一环不成立,都不能从"支持 RadixAttention"直接推出体感更快。
为什么隔了一会儿再问,缓存又没了
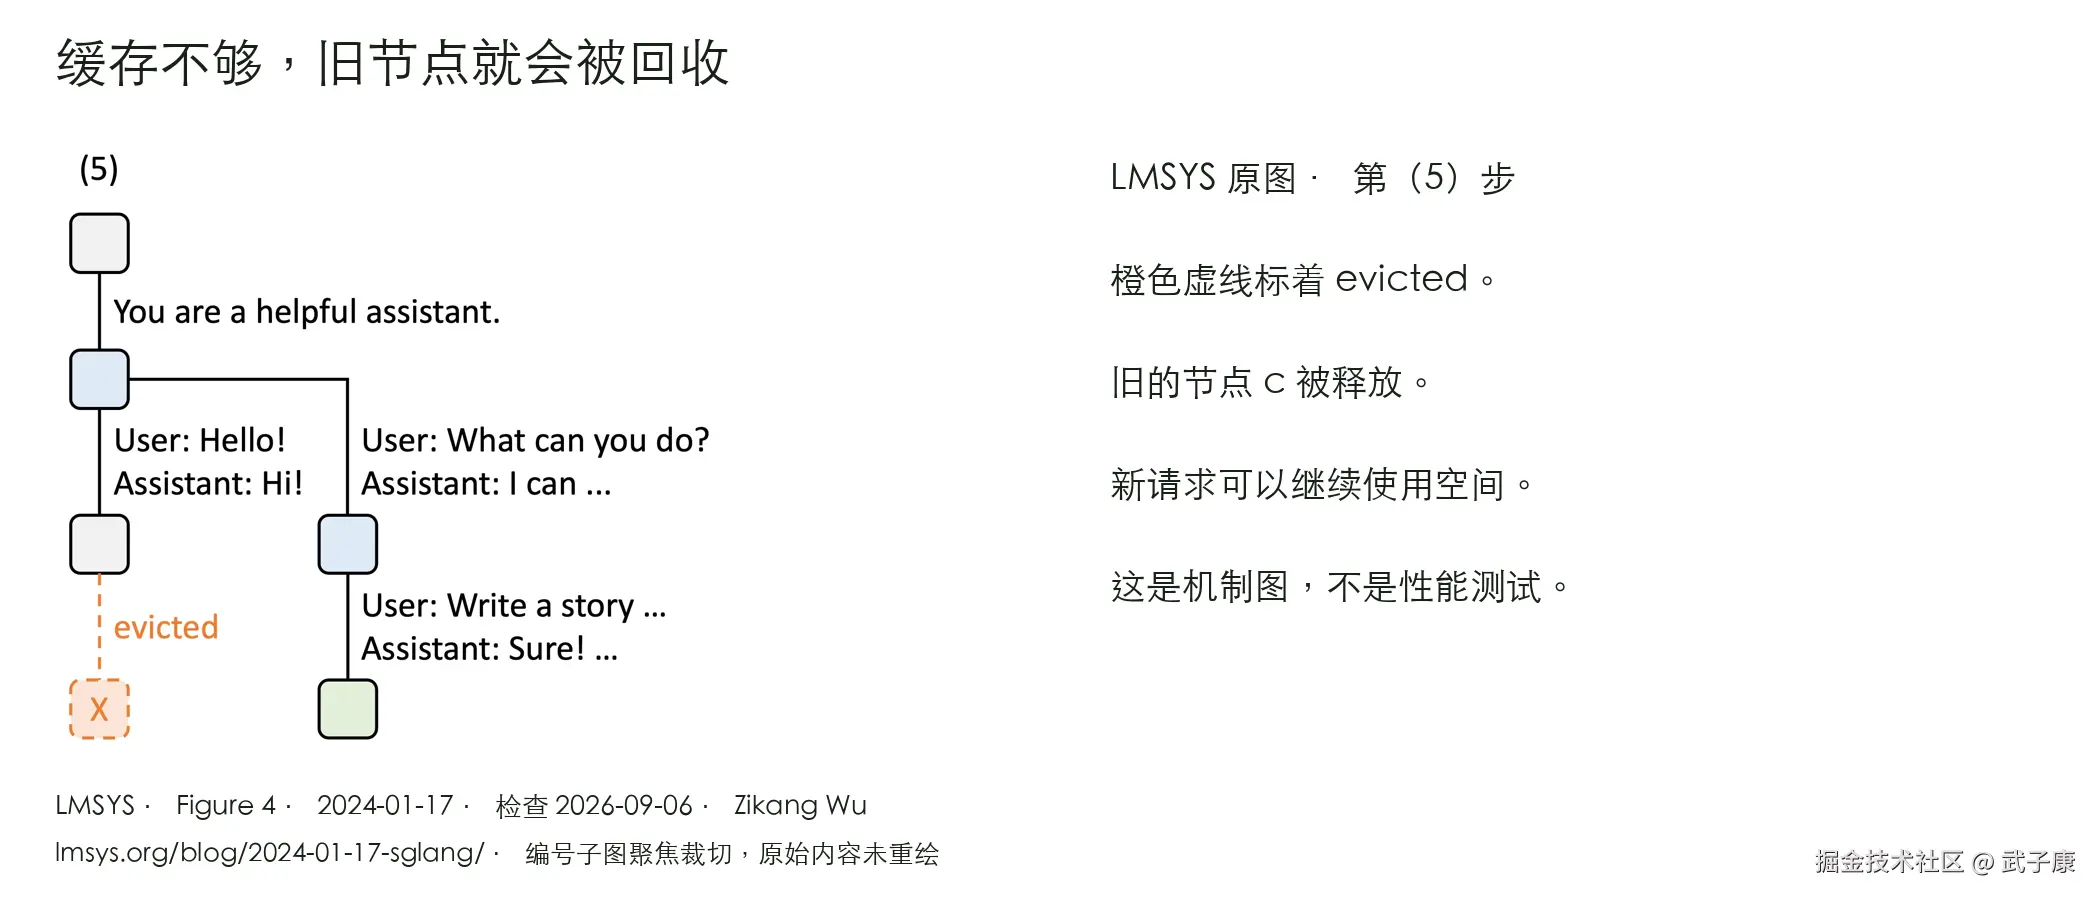
同一张官方图的下一步(5)画出了被回收的节点 c,橙色虚线标着 evicted。新请求需要空间时,旧结果可能不再保留。
缓存空间有限。新的活跃请求需要空间,旧前缀不可能永久保留。
当前淘汰策略文档区分了可淘汰节点和被运行中请求占用的节点,并说明 LRU 等策略只决定先淘汰谁,不能保证某段数据永远留在内存里。LRU 可以理解为优先考虑较久没被用过的缓存。
于是,连续两次问同一份文档,可能容易命中;中间穿插许多互不相关的长请求后再问,就需要重新检查。复用效果不仅取决于某一条 prompt,还取决于它周围的流量。
开启会话相关缓存也不等于把缓存钉死。Session-Aware Radix Cache 文档明确说,会话引用是软保护,内存压力足够大时仍可回收。它也不代替应用传入完整的目标上下文。
怎样判断这次到底省没省
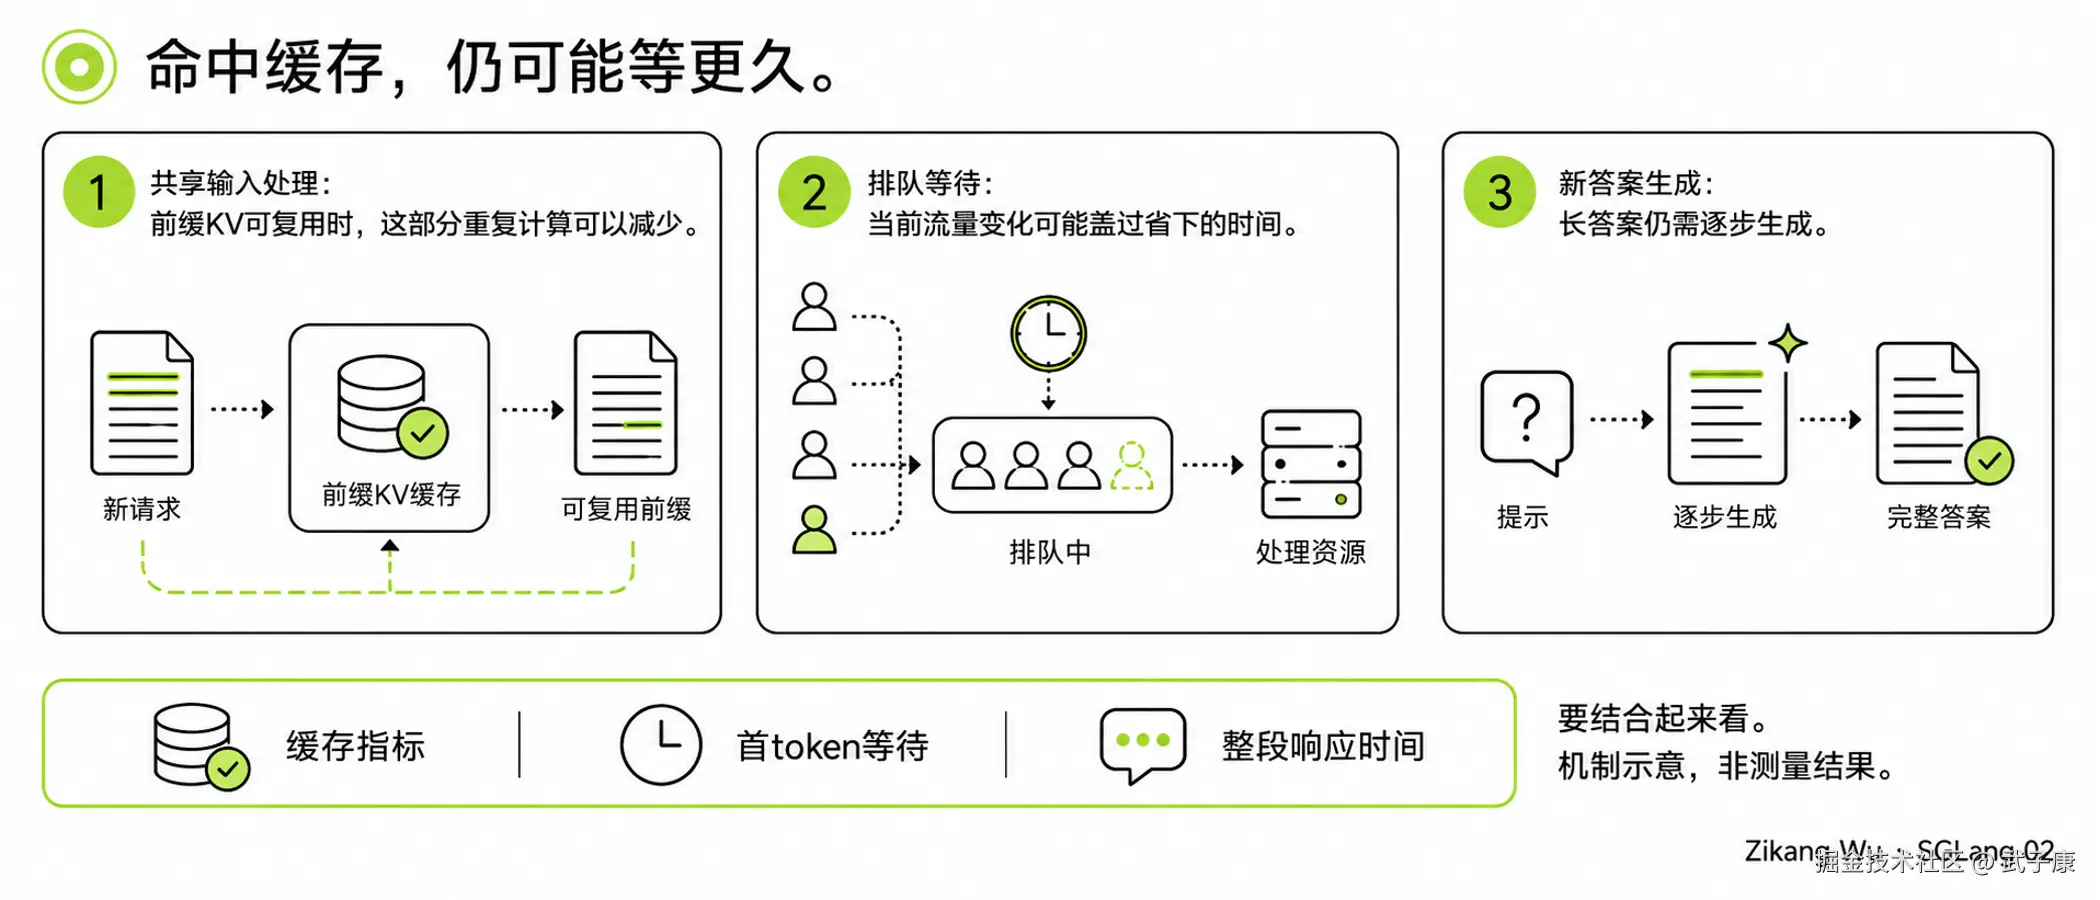
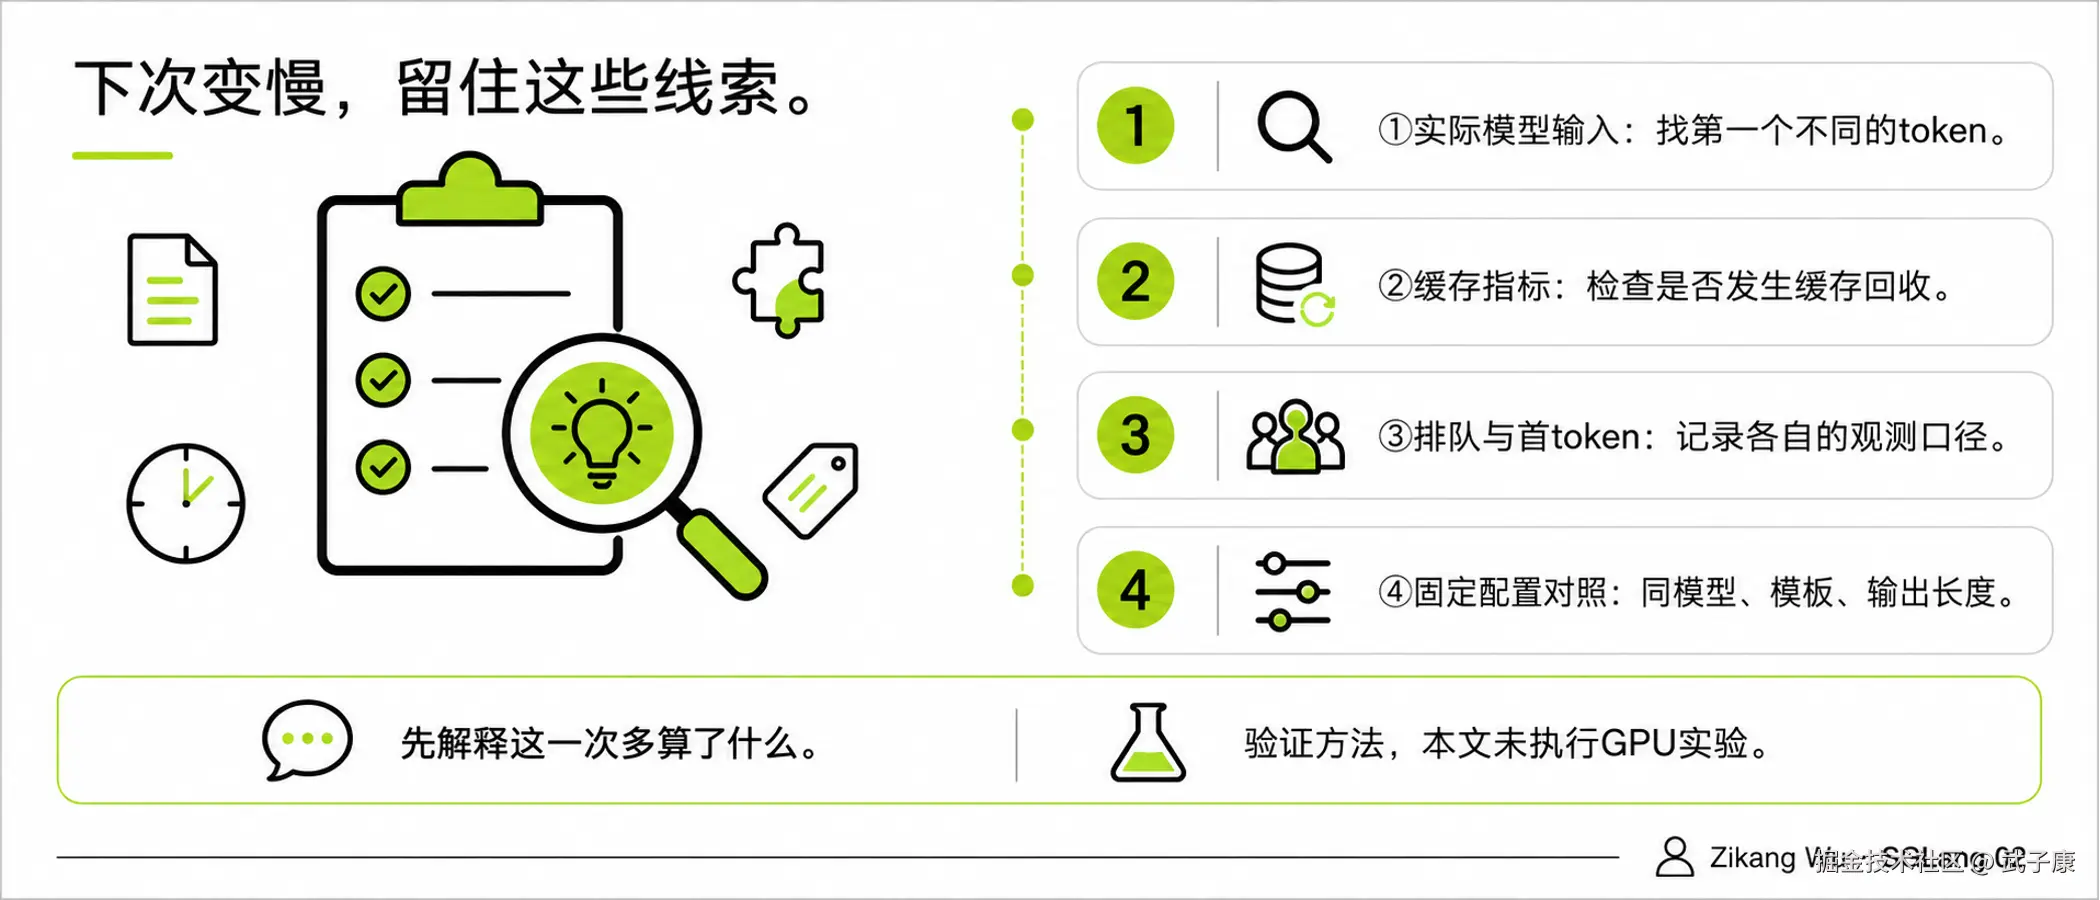
可以在隔离测试服务里固定模型、分词器、模板和生成长度,连续提交"同一长前缀+两个不同问题",再提交一组改变前缀的对照。保留请求顺序,记录缓存指标、首 token 等待和整段响应时间。这里提供的是验证方法,本文没有执行这组模型实验。
首 token 等待还包含排队、输入处理和传输。假如缓存命中了,但请求在队列里多等了一会儿,总等待照样可能增加。反过来,第二次更快也可能来自系统预热或队列变短,不能仅凭两次秒表读数证明缓存有效。
当输出很长时,decode 的耗时仍会占很大比例。缓存省掉前文处理,不会替你生成剩下的答案。
遇到"同一份文档为什么又慢了",先保存两次实际模型输入,找它们从哪个 token 开始不同,再查中间是否发生缓存回收和排队变化。这样排查,才能把一个听起来很复杂的优化名词,落回这一次请求究竟多算了什么。
来源图:LMSYS,Fast and Expressive LLM Inference with RadixAttention and SGLang,Figure 4 局部。原图发表于 2024-01-17,本文检查于 2026-09-06。