直接答案:Funes 的价值不是给 Claude Code 或 Codex 再塞一段更长的系统提示词,而是把它们已经产生的 session trace 变成一个可搜索、可追溯、默认本地运行的长期记忆层。一个 Agent 上周为什么放弃某个 parser、哪次迁移踩过什么坑、哪个测试结论后来被推翻,都可以通过 recall 找回原始片段,而不是依赖人重新翻聊天记录。
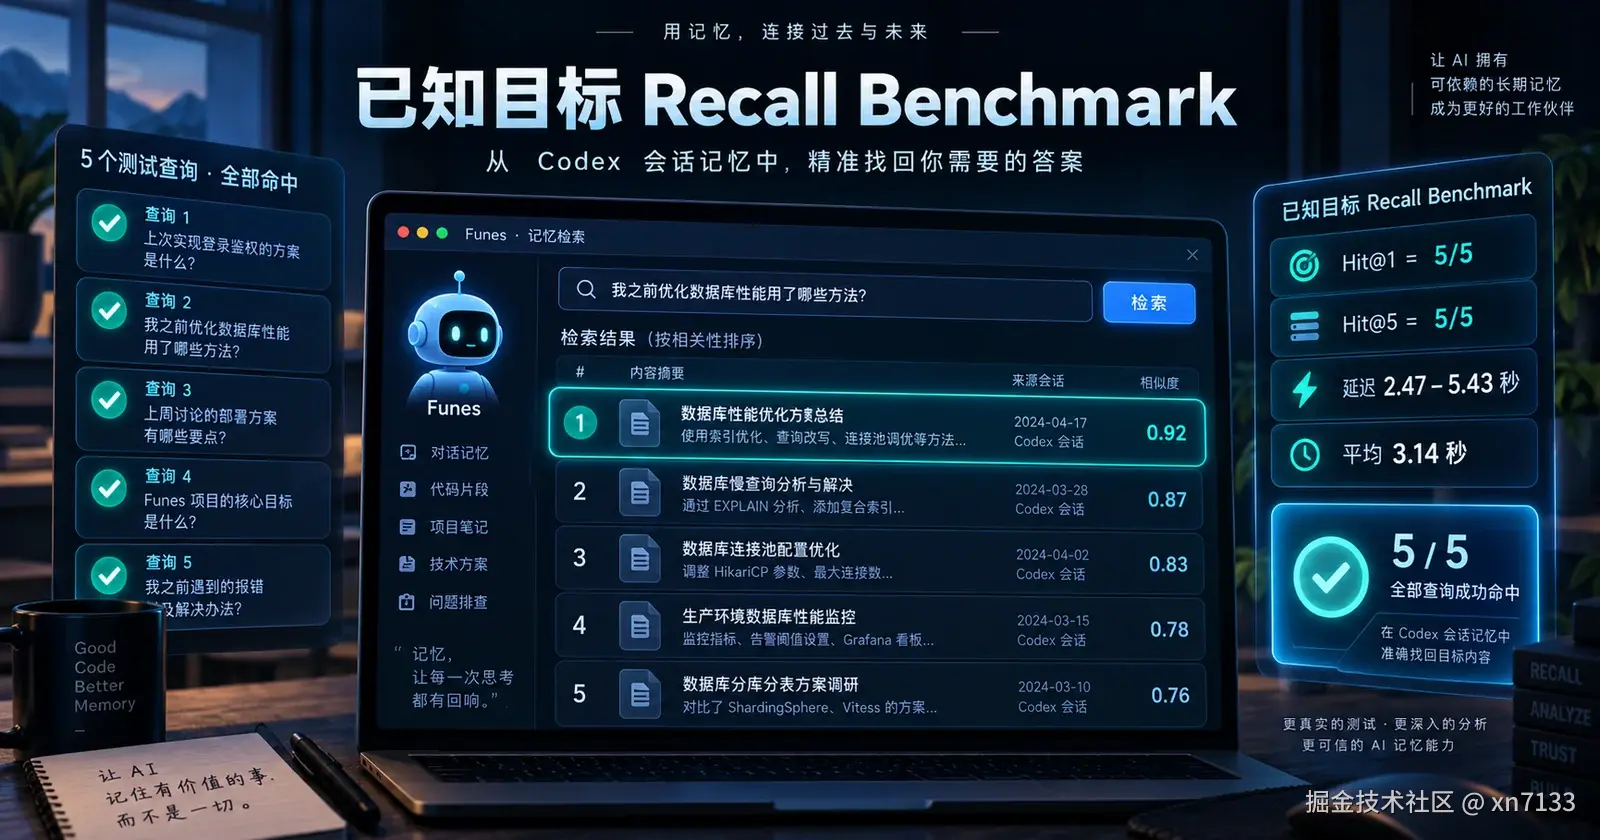
这篇现在已经有完整的本地 recall 证据。9 月 9 日,XBSTACK 在这台 Mac 上完成 Funes 1.3.0+dev 的本地 benchmark:5 个已知目标查询全部把正确 session 排到第 1,Hit@1=5/5、Hit@5=5/5;综合查询延迟约 2.47--5.43 秒,平均 3.14 秒。网络侧仍无法稳定直连 huggingface.co,因此模型通过镜像下载到本地缓存,这只是环境 workaround,不代表 Funes 本身依赖镜像。
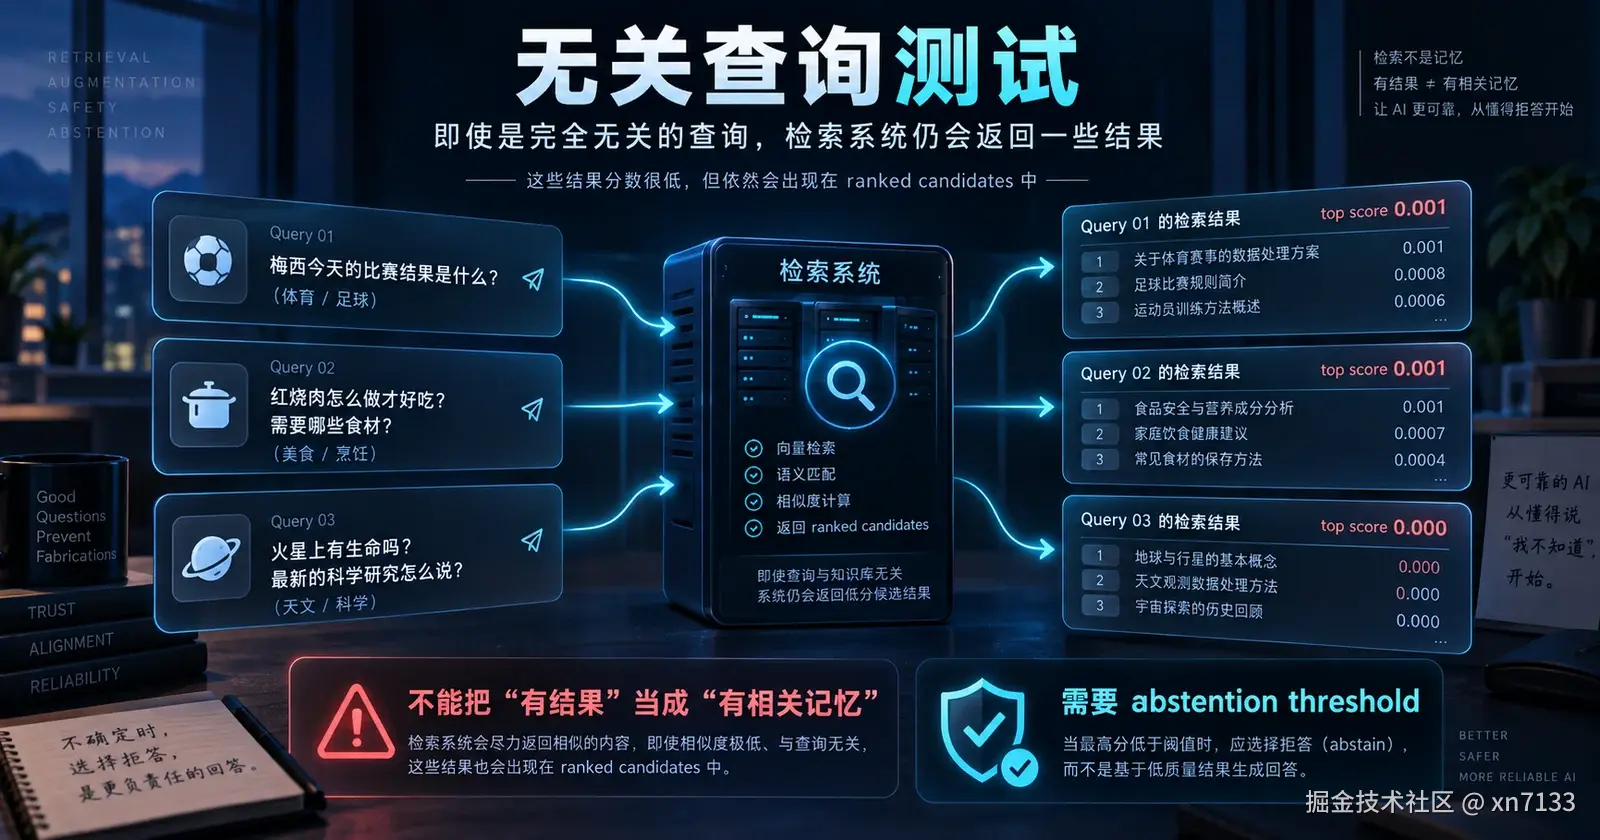
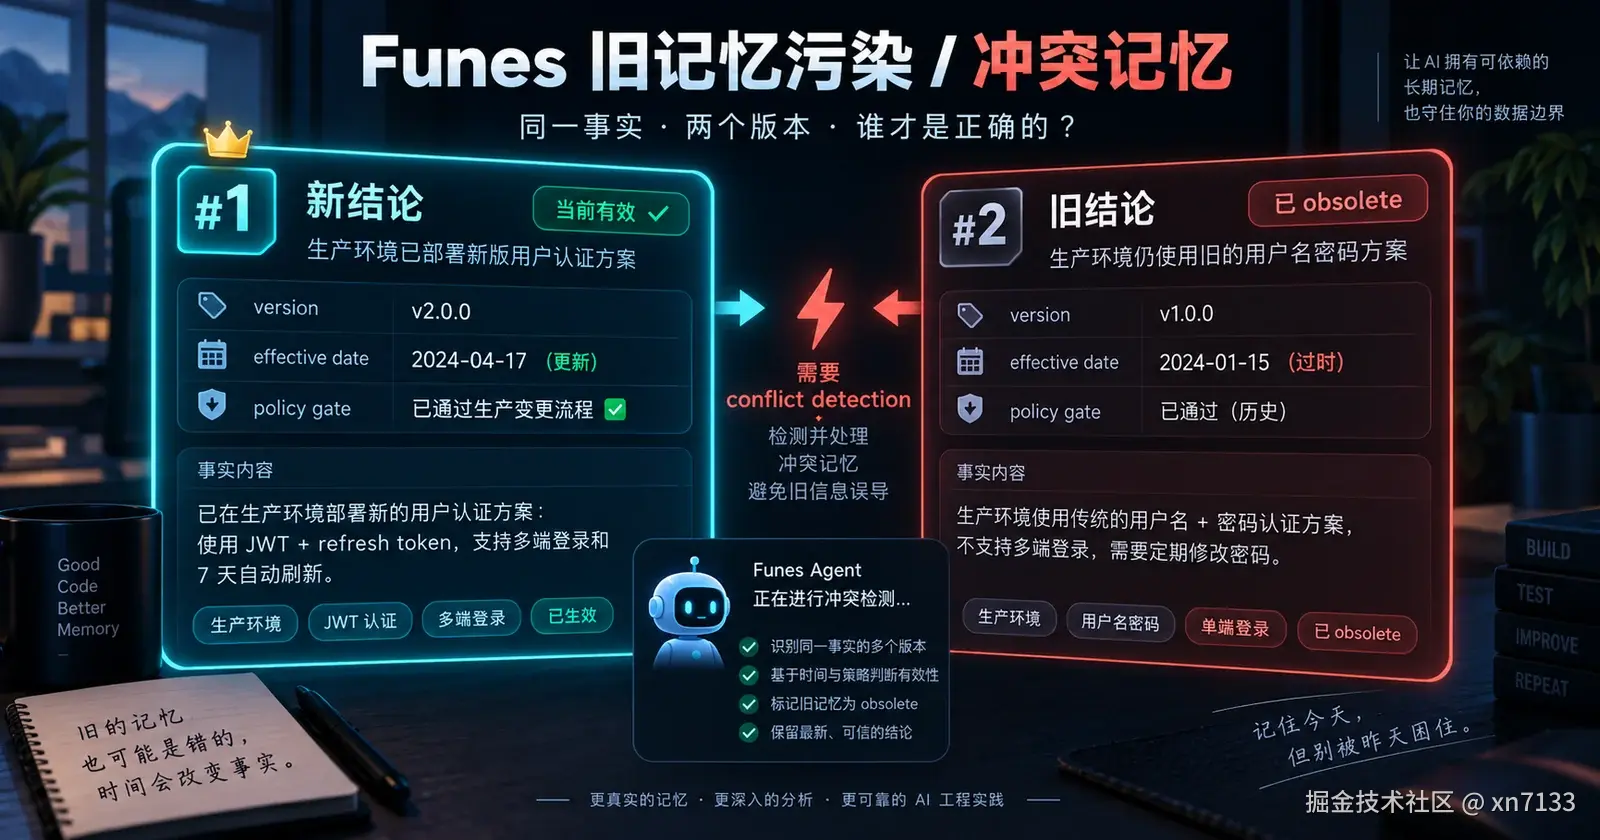
更重要的是两个反例。第一,3 个与 memory 完全无关的查询仍然会返回候选,只是最高分降到 0.001、0.001、0.000;第二,在"Project Apollo 部署区域"这一组 stale/conflict 对照里,9 月 8 日的新结论排第 1,但 9 月 1 日已明确标记 obsolete 的旧结论仍然排第 2。也就是说,Funes 能把相关历史找回来,不等于它会自动替应用判断"这条记忆现在是否还有效"。生产层仍需要 no-answer 阈值、冲突检测、版本/生效时间与 provenance policy。本机仍没有 Claude Code session,因此 Claude Code→Codex 跨 Agent recall 继续只按官方能力描述,不冒充 XBSTACK 已实测。
Funes 解决的到底是什么问题?
Coding Agent 的一个长期矛盾是:模型越来越会做事,但每个新 session 仍然很容易像第一次进入项目。
一个真实开发任务里,Agent 不只产生最终代码。它还会留下大量"为什么":为什么没选方案 A、哪个 API 在当前版本会报错、哪个 workaround 只是临时的、某个测试为什么必须这样写。这些信息往往不在 Git diff 里,也不会全部进入 README 或 Issue。
传统解决方法通常有三类:
- 把重要结论人工写进
CLAUDE.md、AGENTS.md或项目文档; - 让长会话不断 compaction;
- 结束时生成 handoff,让下一个 Agent 继续。
它们都有效,但都有成本。人工文档需要维护;compaction 会做信息压缩;handoff 只保留"当时认为重要"的内容。Funes 的思路是换一个角度:session trace 本身就是工作历史,不必先把它变成摘要,先把它做成可检索数据。
Hugging Face 官方博客把这个问题描述得很直接:不同机器、不同 Coding Agent 各自面对项目时都像陌生人,而 trace 里已经存在大量推理过程、失败路径和决策理由。Funes 做的就是索引、检索、排序和 provenance。
官方说明:huggingface.co/blog/funes
Funes 怎么接入 Claude Code、Codex、pi 和 Hermes?
官方当前给出的安装方式是单二进制:
bash
curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | sh然后把它加到对应 Agent:
bash
funes add claude
funes add codex
funes add pi
funes add hermes根据官方说明,add 会做三件事:建立第一次索引、给 Agent 增加 recall / get 工具、安装增量索引自动化。之后每次完成 turn,只追加新的内容,不需要反复重建全部历史。
这里要注意一个边界:官方 install.sh 在本机并没有跑通。 9 月 7 日从 huggingface.co 获取安装脚本继续发生 443 连接超时;XBSTACK 改为从 GitHub 克隆源码,并用官方 rustup 安装 Rust 1.98.1、临时隔离的 protobuf 工具链完成 cargo build --release,最终编译得到 funes 1.3.0+dev。这证明"源码可以在当前 Mac 构建并运行 CLI",但不等于官方安装器在此网络环境可用。
为了让下面的数字有明确口径,这次最终 benchmark 的环境固定为:macOS arm64、Funes 1.3.0+dev、Rust 1.98.1、protoc 28.3、BAAI/bge-small-en-v1.5 作为 embedder、BAAI/bge-reranker-base 作为 reranker,secret scanner 使用 trufflehog 3.97.4。最终测试集包含 5 个真实 Codex session + 2 个 synthetic stale/conflict session,其中真实 session 共索引 1,044 个 chunk,stale/conflict 对照共 4 个 chunk。
由于当前网络到 huggingface.co 仍然超时,两个模型文件通过 hf-mirror.com 下载后放入本地 Hugging Face cache。这个只属于当前测试环境的网络 workaround,不是 Funes 的运行要求。
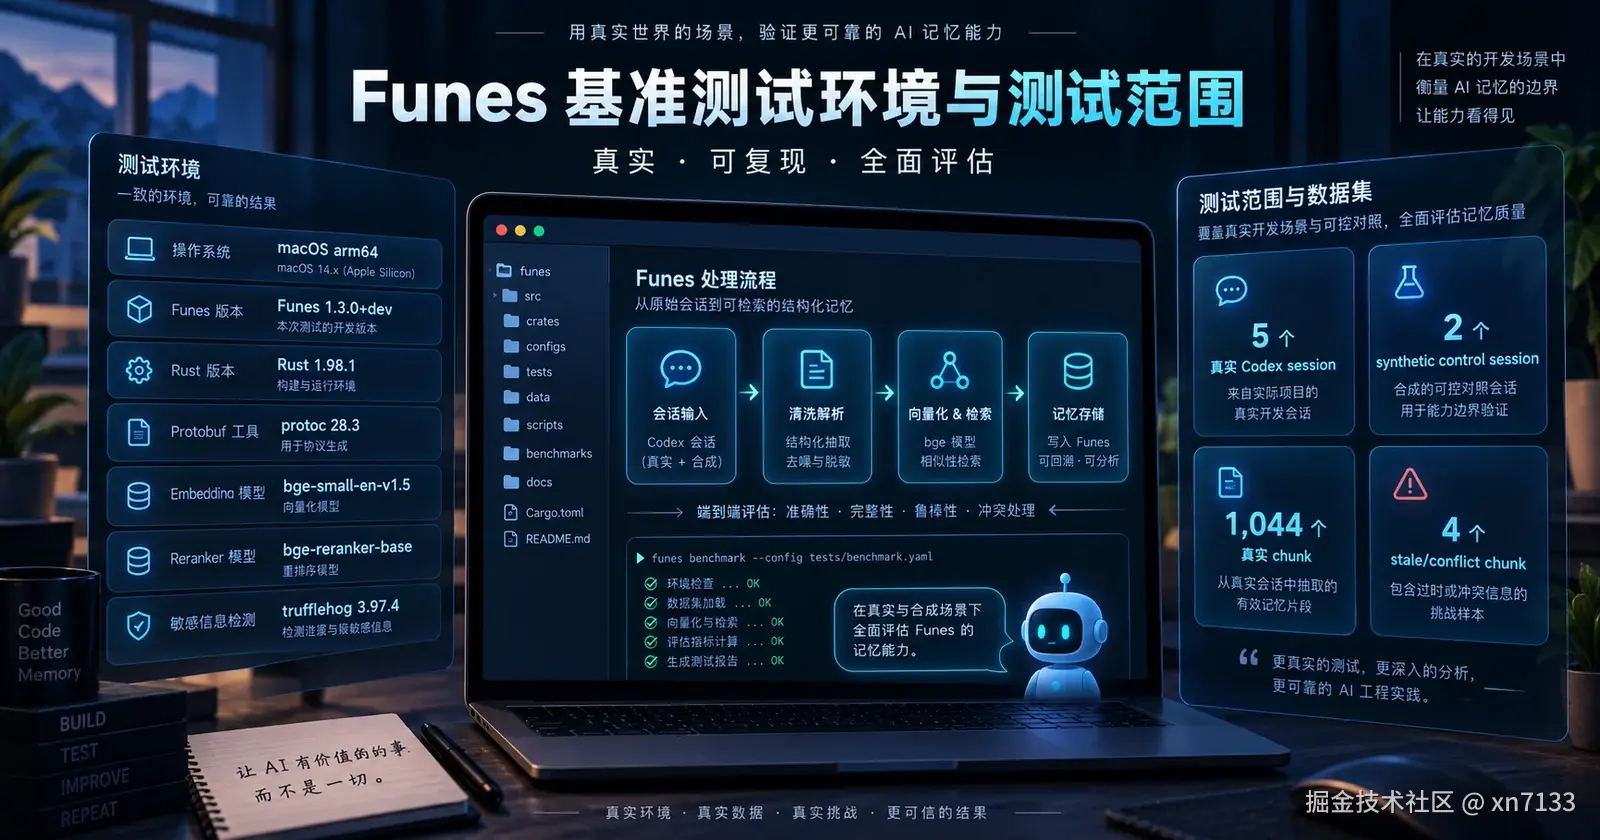
这轮得到的真实结果如下:
| 本地验证 | 结果 |
|---|---|
funes index --harness codex |
成功建立本地 Lance memory;早期验证先索引 3 个 session,最终 benchmark 扩展为 5 个真实 Codex session + 2 个 synthetic control session |
funes sessions |
能列出真实 Codex session、日期、turn 数和 session id |
funes scan "模型" <session> |
在一个真实 Codex session 中返回 52 个字面量命中,并给出 get 范围 |
funes get ... --from 1828 --to 1832 |
能回到原始 turn,准确取回"Manifest → 下载 → 校验 → 安装 → Runtime Ready"等历史决策 |
funes sketch <session> |
成功返回 8 个具有区分度的 session 片段,并保留 provenance |
funes scrub + trufflehog 3.97.4 |
扫描 5148 个 block;重写 8473 行;0 个可直接替换 secret;4 个 block 的 13 行因无法安全脱敏被丢弃 |
funes recall |
完成:5 个已知目标查询 Hit@1=5/5、Hit@5=5/5;综合查询延迟约 2.47--5.43 秒,平均 3.14 秒 |
| 无关查询 negative control | 3 个无关查询仍返回候选,但 top score 仅 0.001 / 0.001 / 0.000;该测试中 CLI 没有自动 no-answer |
| stale/conflict control | 新结论排名 #1;已明确 obsolete 的旧结论仍排名 #2,说明应用层仍需冲突/时效治理 |
| Claude Code → Codex 跨 Agent | 未完成:本机当前没有 Claude Code session 可供索引 |
因此后面的检索架构说明仍然会把"官方设计"和"XBSTACK 已验证行为"分开写。
它为什么不是"再做一个向量数据库"?
Funes 官方描述的查询链路比单纯 embedding nearest-neighbor 多几层:
text
Agent traces
  ↓ parse / normalize
turn + block
  ↓ chunk
local embeddings
  ↓
vector search + BM25
  ↓ rank fusion
cross-encoder rerank
  ↓ recency reweight
neighboring chunks
  ↓
recall result + provenance
这个组合很合理,因为 Coding Agent Memory 不是只有"语义相似"一种查询。比如"为什么我们从 streaming parser 切走",里面既有 streaming parser 这样的明确关键词,也有"上次性能问题为什么发生"这种语义问题。BM25 对精确词有价值,向量检索覆盖语义近义,reranker 再做二次筛选。
更值得注意的是 provenance。官方说明 recall 返回的是原始文本,而不是写入时生成的摘要事实 ,并且附 Agent、timestamp、session、turn;get 可以进一步打开完整 turn 和上下文。对工程判断来说,这一点比"模型记住了一条事实"更容易审计。
这也与 XBSTACK 现有的 AI Agent Memory System 有明确区别:Memory 架构文章关注生产系统怎么分层,而 Funes 是一个具体 Coding Agent trace-memory 实现,搜索意图并不重复。
本地 Memory 和 Hugging Face Dataset 怎么分工?
Funes 默认把本地记忆存为 Lance dataset。官方强调 embedding 与 reranking 在本机完成,recall 默认也不要求 Hugging Face 账号或远程 memory service。
如果需要跨机器共享,可以把记忆绑定到自己的 Hugging Face Dataset:
bash
funes add codex acme/funes-memory官方说明这种 shared memory 默认是 private dataset。完成 session 后,Funes 会把更新同步过去;另一台机器绑定同一个 memory 后可以继续 recall。远端数据会被本地缓存,因此热查询仍可回到本地读取路径。
这个设计有一个很实际的优点:Memory 资产的所有权仍在用户的数据集里,而不是必须租用某个专用 Memory SaaS。 但"默认私有"不等于"可以无脑上传所有 session"。代码会话里可能出现客户名、未公开产品、内部 URL、Token 片段、日志和路径,正式使用前仍要先做数据分类和安全评估。
Secret redaction 能解决隐私问题吗?
不能把它理解成完整保证。
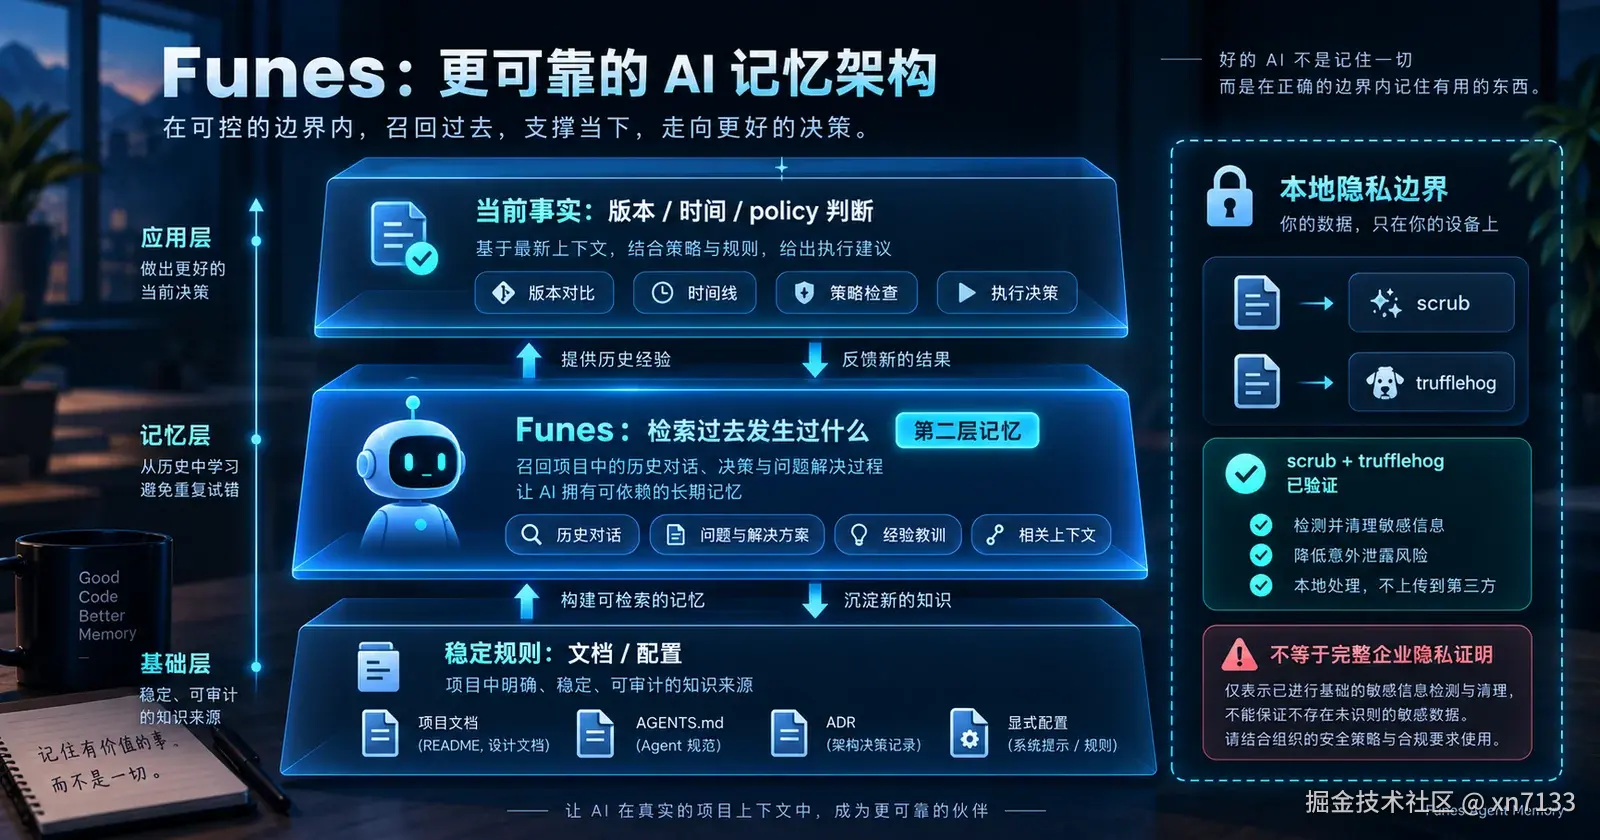
Hugging Face 官方说明,在内容进入 Hub 前,凭据会在 indexing 期间做 redaction,publish 前还会再次扫描每个 chunk,把仍然像 secret 的内容拦下来;同时官方明确把扫描器能力和边界放在 SECURITY.md 里。
这类机制应该理解成降低误上传风险的防线,不是"任何敏感信息都能自动识别"的承诺。真实项目里还有很多不长得像 API Key 的敏感信息,例如:
- 未发布项目代号;
- 客户/员工姓名;
- 内网路径和业务结构;
- 调试日志中的业务数据;
- 数据库表名与字段;
- 商业决策和安全边界。
这篇文章已经验证了 scrub 和 trufflehog 扫描链路确实会工作,但它没有覆盖完整的企业隐私评估。要判断"能不能安全同步公司会话",仍然需要额外准备一组 synthetic privacy corpus:假 Token、假邮箱、内部路径、项目代号和普通敏感文本,再分别检查本地索引、redaction 与远端 publish 后还剩什么。也就是说,这里的结论只能到"secret scanning 有效运行",不能扩大成"所有敏感数据都能自动处理"。
recall、get、ask 分别适合什么?
从官方设计看,可以把三个入口理解成:
recall:Agent 在工作中检索过去相关 trace;get:从 recall 结果跳回完整 turn 和周边上下文;ask:人在命令行对某个 memory 提一个只读问题,不安装持久集成。
例如官方给出的 ask 形式是:
bash
funes ask claude "what did we decide about the streaming parser"也可以指向共享 memory:
bash
funes ask claude "why is funes append-only" --memory huggingface/funes-memory这让 Funes 不只是"Agent 自动记忆",还可以作为可审计的工程历史查询层。对于维护多年项目,最有价值的可能不是"记住用户偏好",而是"找到某次决定背后的原始证据"。
Funes 和 compaction、handoff、项目文档怎么选?
它们不是完全替代关系。
| 方法 | 优点 | 主要风险/成本 | 更适合 |
|---|---|---|---|
| 项目文档 | 明确、可审阅、版本化 | 人工维护,容易过时 | 稳定规则、架构契约 |
| Compaction | 自动保持长 session 连续 | 摘要可能压掉细节 | 同一长任务继续跑 |
| Handoff | 明确交接当前状态 | 只保留当时选中的信息 | Agent/人切换任务 |
| Funes recall | 保留原始 trace,可跨 session/Agent 检索 | 检索质量、隐私和噪声需要验证 | 长期工程历史与原因追溯 |
Hugging Face 在官方博客里给出了 handoff-vs-recall benchmark,并报告 recall 在两项任务上比 written handoff 的成本更低。但这仍然是项目自己的 benchmark,不是 XBSTACK 的结果。这篇文章不把官方成本数字改写成个人实测;本轮 XBSTACK 只对本地 recall 命中、延迟、无关查询和 stale/conflict 行为负责。
我这次具体怎么测?
这轮没有堆十几个 Demo,而是把测试拆成三组,分别回答"能不能找到""会不会乱答""旧记忆会不会污染当前判断"。
任务一:已知目标的 Codex recall
测试集由 5 个真实 Codex session 构成,共索引 1,044 个真实 chunk。每个查询都预先知道应该命中哪个 session,覆盖重定向行为、WebView 图片预览、埋点标识、工程签名配置和 provisioning 配置等不同意图。具体项目名不影响检索结论,因此不在公开文章里展开。
最终 5 个查询全部把目标 session 排在第 1:Hit@1=5/5,Hit@5=5/5。这里的 100% 只能说明这个小型、人工标注的本地集合,不代表任意项目都能得到同样结果。
任务二:无关查询与 no-answer 边界
我额外输入 3 个与现有 memory 完全无关的问题。Funes 仍然返回了 ranked candidates,但 top score 分别只有 0.001、0.001、0.000。
这说明在这条 CLI 路径里,"返回了结果"不能直接理解成"系统认为这条记忆相关"。真正接入 Agent 时,应用层应该根据分数分布设计 abstention/no-answer 规则,否则低相关候选仍可能被模型继续消费。
任务三:stale/conflict memory
我构造了两条互相冲突的 Project Apollo 部署区域记录:9 月 1 日旧记录写 us-east-1,9 月 8 日新记录改为 ap-southeast-1,并明确注明旧值 obsolete。
查询"当前生产部署区域"时,新记录排名 #1,但旧记录仍然排名 #2。recency weighting 确实把新事实顶上来了,却没有自动消灭旧证据。这也是我认为 Funes 最重要的生产边界:长期记忆真正危险的不是忘记,而是把曾经正确、现在已经失效的信息继续召回。
Secret 方面,本地 scrub 已配合 trufflehog 3.97.4 跑过一轮:扫描 5,148 个 block、重写 8,473 行,4 个 block 中 13 行因无法安全脱敏被直接丢弃。这个结果证明扫描链路工作,但不能证明所有业务敏感信息都能自动识别。
我现在最关注的三个边界
第一,检索噪声。Agent trace 比人工文档更丰富,也更杂。大量失败尝试、临时日志和重复回答可能提高召回噪声。
第二,时效性。原始证据可追溯是优点,但旧证据不等于当前真相。版本升级后,过去的 workaround 可能已经失效。
第三,权限和数据边界。个人开源项目和企业私有仓库对"能不能同步到私有 Dataset"的风险容忍度完全不同。
所以 Funes 真正需要的不是一句"memory works",而是状态:这个 memory 来自哪个 Agent、哪个时间、哪个版本、是否仍然有效、能否回到原始 trace。官方已经提供部分 provenance,生产使用还要看团队如何治理过期知识。
最终判断:现在值得怎么用?
基于这次本地结果,我会把 Funes 定位成非常有潜力的 Coding Agent 历史检索层,而不是可以直接当作"当前事实数据库"的权威 Memory。
它已经证明两件事:第一,本地 Codex trace 可以被有效索引并通过 hybrid retrieval 找回来;第二,provenance 能让人回到原始 session/turn,而不是只拿到一条被压缩过的"记忆结论"。对长期维护项目,这比每次重新翻历史聊天记录要实用得多。
但它同样暴露了两个必须由应用层解决的问题:低相关 query 仍可能得到候选;旧结论即使已经 obsolete,也可能继续出现在召回列表里。所以真正生产化时,至少还需要 score threshold/abstention、冲突检测、有效期/version metadata,以及"历史证据"和"当前事实"分层。
官方明确支持 Claude Code、Codex、pi、Hermes 等多 Agent trace,但这台机器没有 Claude Code session,所以 Claude Code→Codex 跨 Agent 共享记忆仍属于官方能力,不属于这次 XBSTACK 实测结论。后续如果要验证跨 Agent,我会单独做一轮,不把它混进这次已经完成的 Codex benchmark。
什么情况下值得用 Funes?
如果你的项目会持续几个月甚至几年,而且 Claude Code、Codex 或其他 Coding Agent 经常交替进入同一个仓库,Funes 的价值会比较明显:历史排障、失败方案、迁移原因和某次技术决策不需要全部被人工整理进文档,后续 Agent 仍有机会回到原始 trace。
如果项目规模很小、session 很少,或者所有关键规则本来就已经稳定写在 CLAUDE.md / AGENTS.md / ADR 里,那么额外维护一层 trace memory 的收益可能并不高。尤其是涉及高敏感代码和客户数据时,如果没有自己的数据分类、过期治理和同步策略,不建议直接把"默认 private"理解成"可以放心同步"。
从工程架构上看,我更倾向于把它放在第二层记忆:稳定规则继续放项目文档和显式配置;Funes 负责检索过去发生过什么、为什么这么做;真正影响当前执行的事实,再通过版本、时间和人工/程序化 policy 判断是否仍然有效。这样比让 Agent 直接把所有 recall 结果当成当前事实更稳妥。
FAQ
Funes 是什么?
Funes 是 Hugging Face 发布的开源 Coding Agent Memory 工具,读取 Claude Code、Codex、pi、Hermes 等 Agent 的 session trace,建立本地可检索记忆,并通过 recall / get 让后续 session 找回原始工作历史。
Funes 默认会把代码会话上传 Hugging Face 吗?
官方说明默认 local-first,本地 memory 不需要 Hub 账号。只有用户主动绑定 Hugging Face Dataset 时才同步共享记忆,Dataset 默认 private。正式使用仍应自行评估敏感数据和 secret scanning 边界。
Funes 是向量数据库吗?
底层使用 Lance dataset,但查询并不是纯向量近邻。官方描述包含 vector search、BM25、rank fusion、cross-encoder rerank、recency reweight 和 neighboring chunks。
Funes 可以让 Claude Code 和 Codex 共享记忆吗?
官方明确支持多个 Agent 写入同一种记忆结构并跨 Agent recall;这次 XBSTACK 已验证 Codex 本地 recall、无关 query、stale/conflict 与 scrub,但没有本机 Claude Code session,因此跨 Agent 能力仍只按官方文档描述,不写成个人实测。
Funes 和 CLAUDE.md / AGENTS.md 冲突吗?
不冲突。项目文档更适合稳定规则和显式契约;Funes 更像历史 trace 的检索层。正式架构里可以让规则留在文档,过去的调查、失败路径和决策理由通过 memory recall 找回。
官方资料
- Hugging Face:Give Your Coding Agents a Memory You Own
- GitHub:huggingface/funes
- Funes handoff-vs-recall benchmark dataset
- Hugging Face public Funes memory dataset
继续阅读
- AI Agent Memory System:长期记忆应该怎么分层
- AI Agent Memory Architecture
- LangGraph Memory 与 Checkpoint 生产化
- AI Agent 生产化治理
原文与完整实验:www.xbstack.com/ai/funes-co...
继续阅读: