作者:来自 Elastic Elastic jina.ai/
一款 0.6B 参数的列表式重排序模型,在 BEIR 上超越 Qwen3-Reranker-4B ,重排序速度最高比 v3 快 1.56 倍,并且在半结构化检索上的 nDCG@10 提升了 9.6。
今天,我们发布 jina-reranker-v3.5,这是一款 0.6B 参数的列表式重排序模型。它保留了 jina-reranker-v3 的 last but not late 交互方式,同时让它在企业实际搜索的数据上运行得更快、能力也强大得多。它在 BEIR 上达到 63.20 nDCG@10 ,以大约少 7 倍的参数量领先于 Qwen3-Reranker-4B;在长文档上,其重排序速度最高比 v3 快 1.56 倍 。它最大的提升出现在半结构化检索上:在字段约束的记录上,相比 v3,nDCG@10 提升了 9.6。
我们通过三项改动实现了这些提升。第一,采用混合注意力调度,用滑动窗口替代大多数全局层,同时将最后一层固定为全局注意力。第二,根据法律、医疗、金融、多语言和结构化检索中的失败模式,精心构建训练数据混合。第三,采用三阶段自 蒸馏 方案,其中教师模型和学生模型大小相同,唯一的区别在于注意力模式。
下面展示了四种基准测试场景中,模型质量与参数量之间的关系。jina-reranker-v3.5 在全部四种场景中都处于 Pareto 前沿:在我们评估的模型中,没有任何模型能够同时做到参数更少且效果更好。
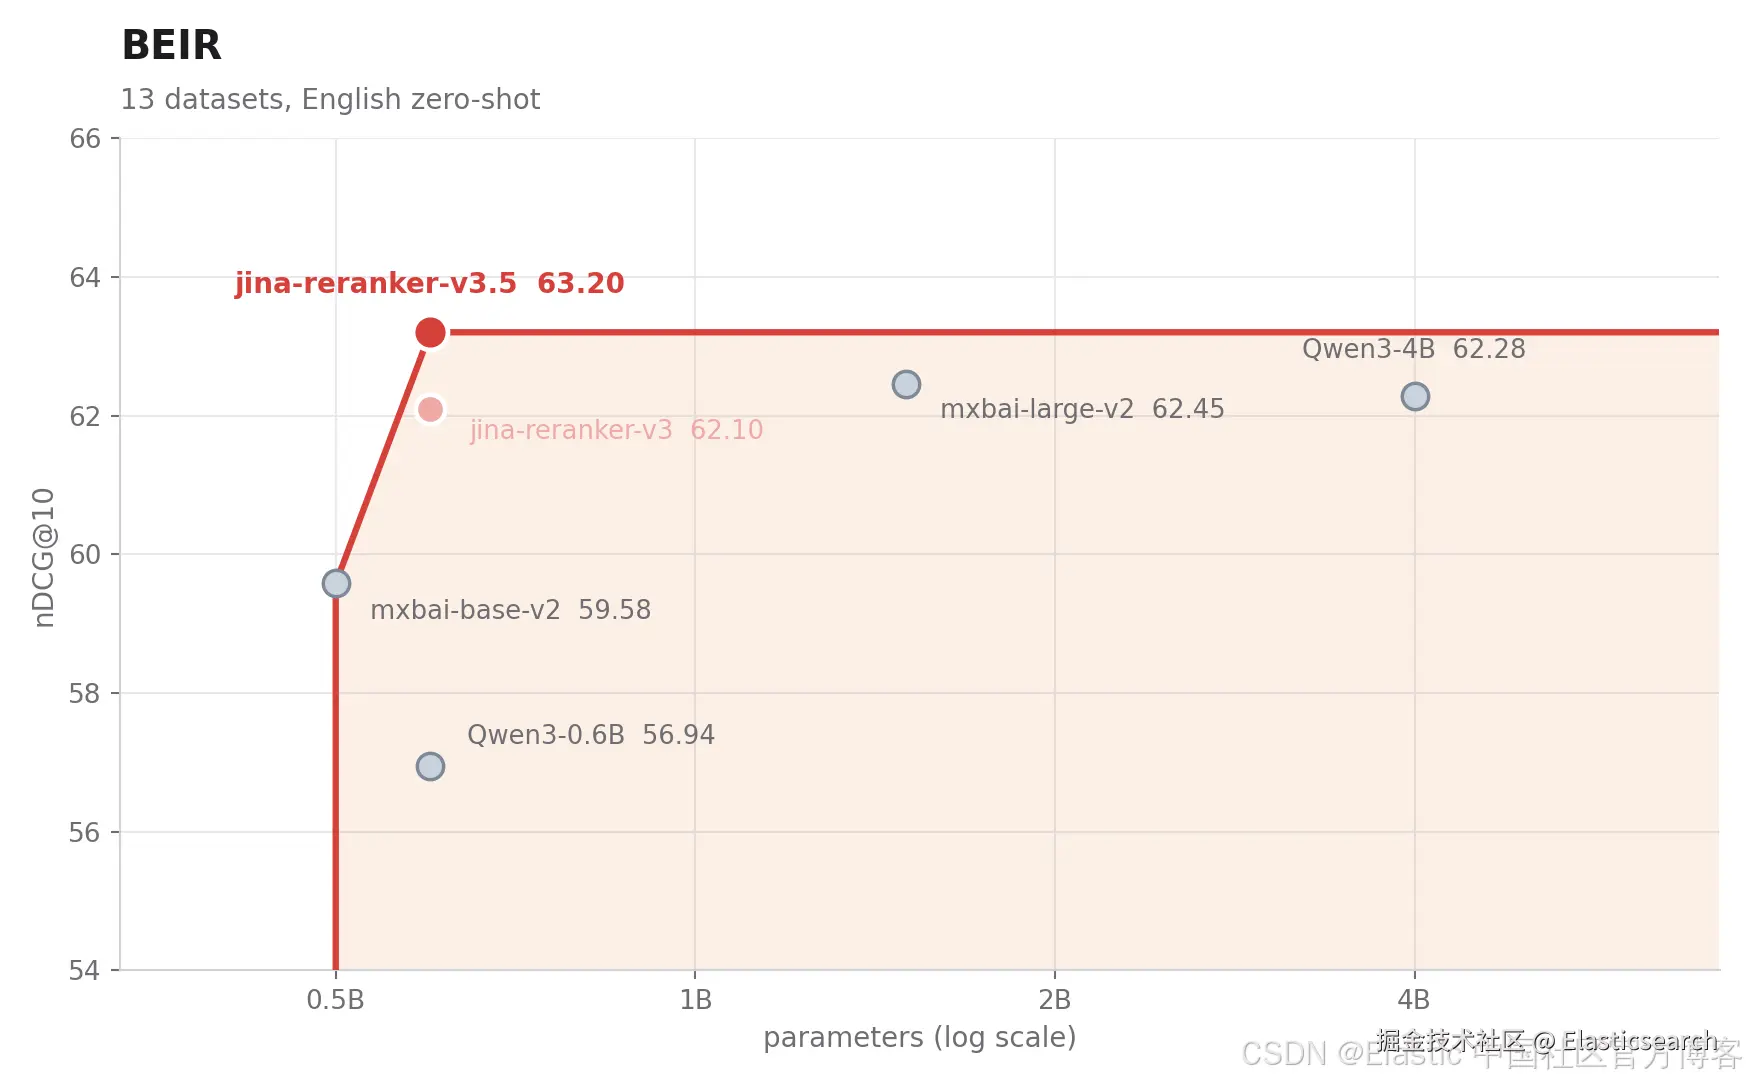 在 BEIR 的 13 个数据集上进行英文零样本检索,并以对 jina-embeddings-v5-text-small 返回的前 100 个候选结果进行重排序后的 nDCG@10 作为衡量指标。红线表示 Pareto 前沿,阴影区域表示被支配区域:对于其中的每一个模型,都存在其他模型在参数量更少、效果更好或两者兼具。
jina-reranker-v3.5 以 63.20 的成绩直接定义了这条前沿,高于参数量为 1.5B 的 mxbai-rerank-large-v2(62.45)以及参数量为 4B 的 Qwen3-Reranker-4B(62.28)。在我们评估的模型中,没有任何参数量更大的模型能够在 BEIR 上获得比它更好的检索效果。
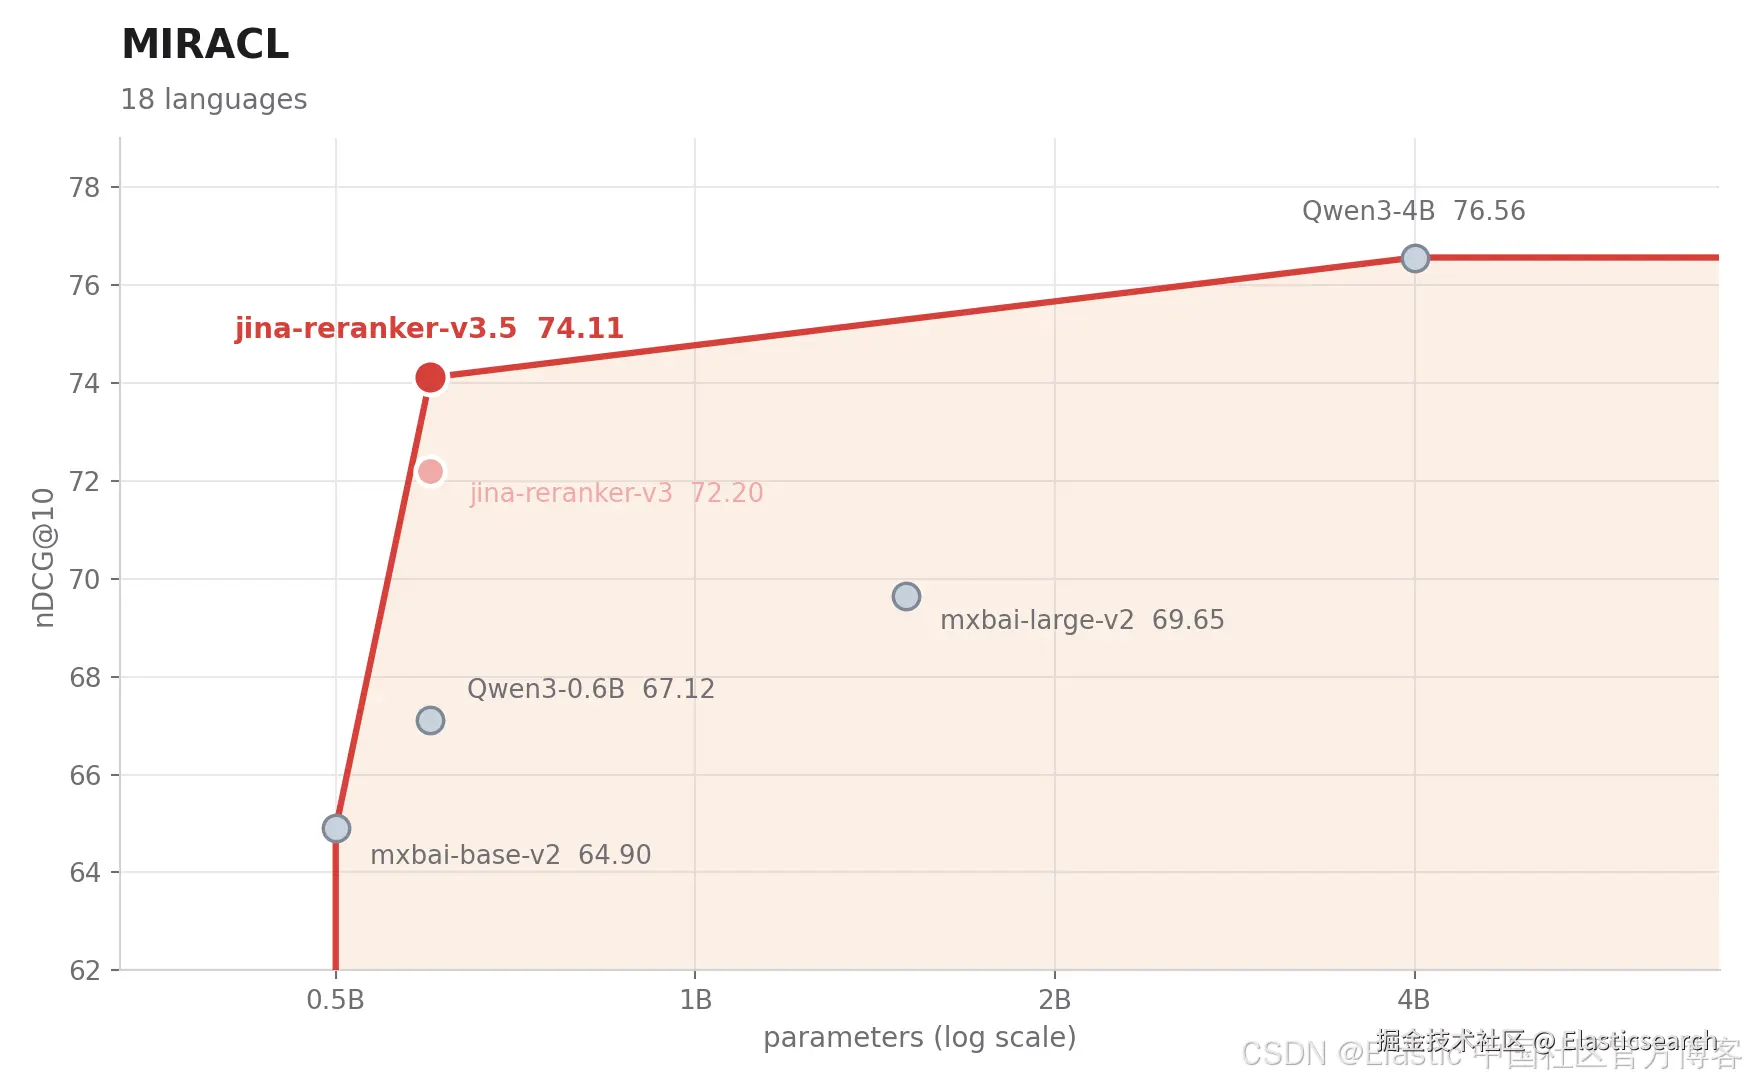 在 MIRACL 的 18 种语言上进行多语言检索,采用相同的前 100 个候选结果重排序方案。 jina-reranker-v3.5 以 74.11 的成绩占据 Pareto 前沿中 0.6B 参数量这一位置,是所有紧凑型模型中的最佳成绩;而 Qwen3-Reranker-4B 则以 76.56 的成绩占据 4B 参数量这一位置。与 jina-reranker-v3 相比,单语言提升最大的是约鲁巴语(+4.4)、波斯语(+3.1)和法语(+3.0)。
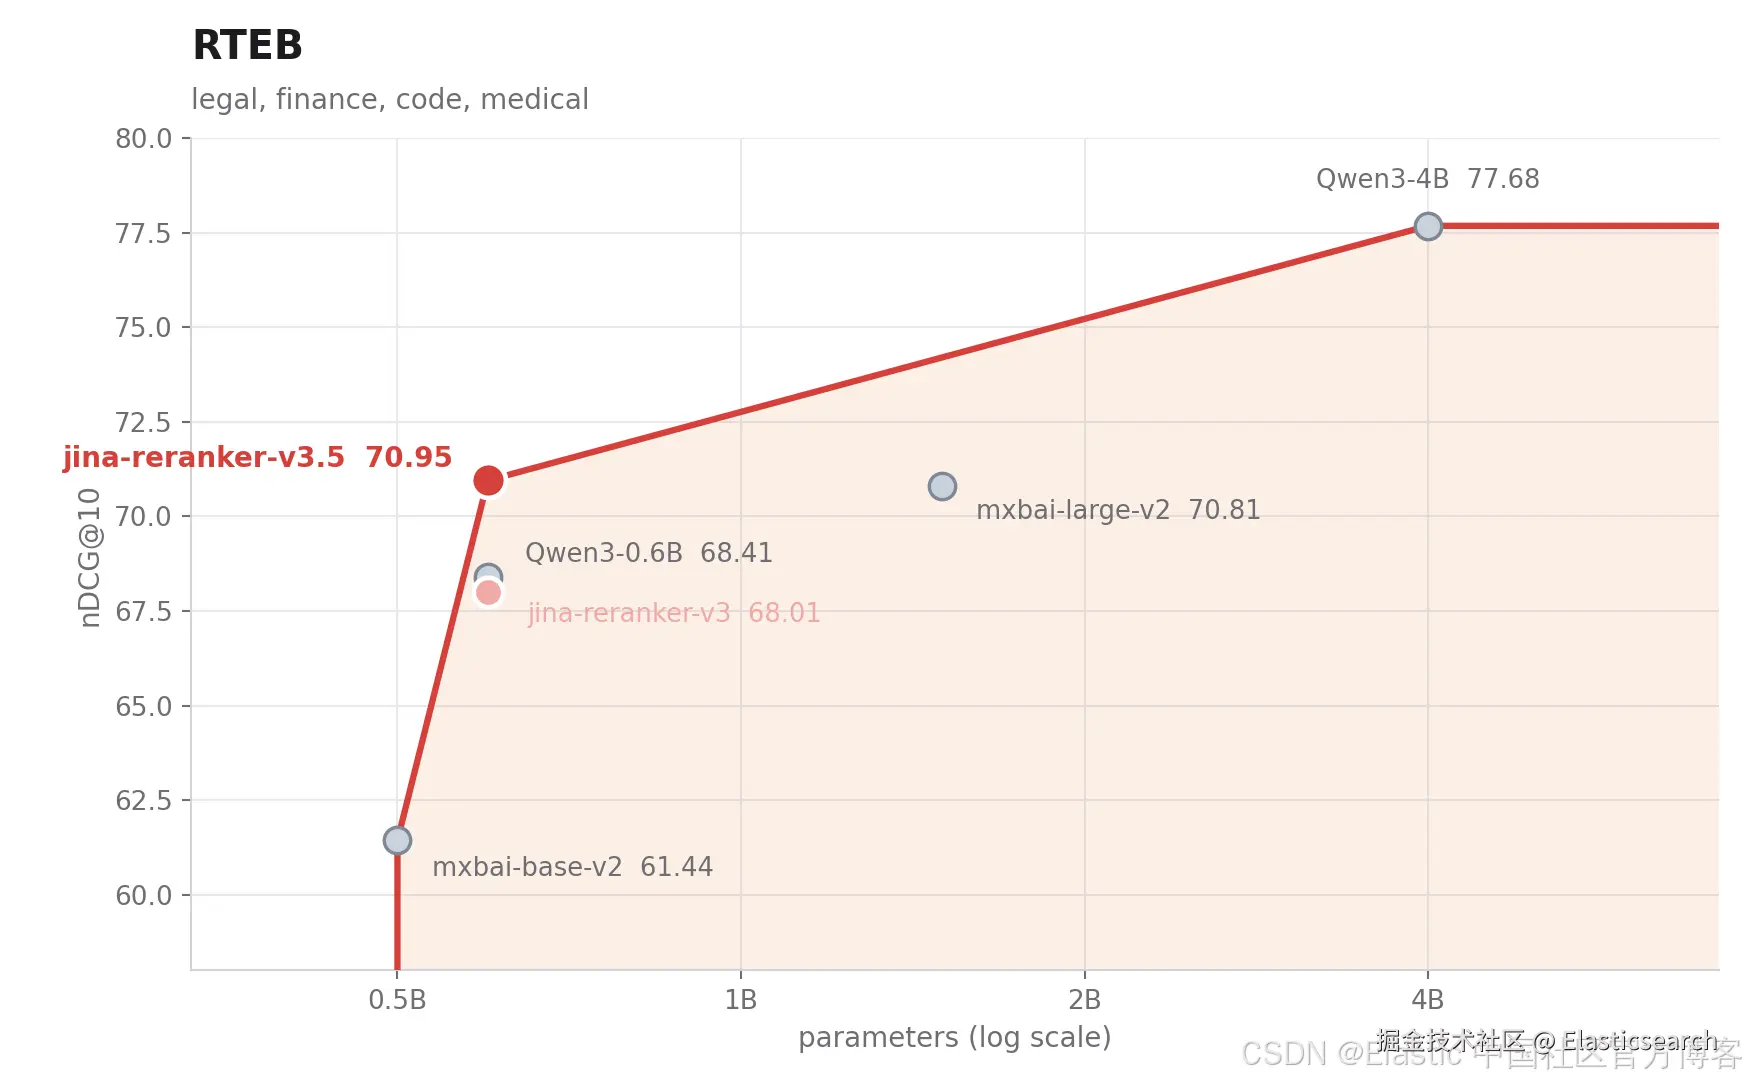 在 RTEB 上进行专业领域检索,涵盖法律、金融、编程和医疗语料库。 jina-reranker-v3.5 达到 70.95,超过了相同参数规模的 Qwen3-Reranker-0.6B(68.41)以及参数量为 1.5B 的 mxbai-rerank-large-v2(70.81),而自身仅有 0.6B 参数。在与 Qwen3-Reranker-4B 的 77.68 之间剩余的差距,主要集中在少数法律和医疗任务上。
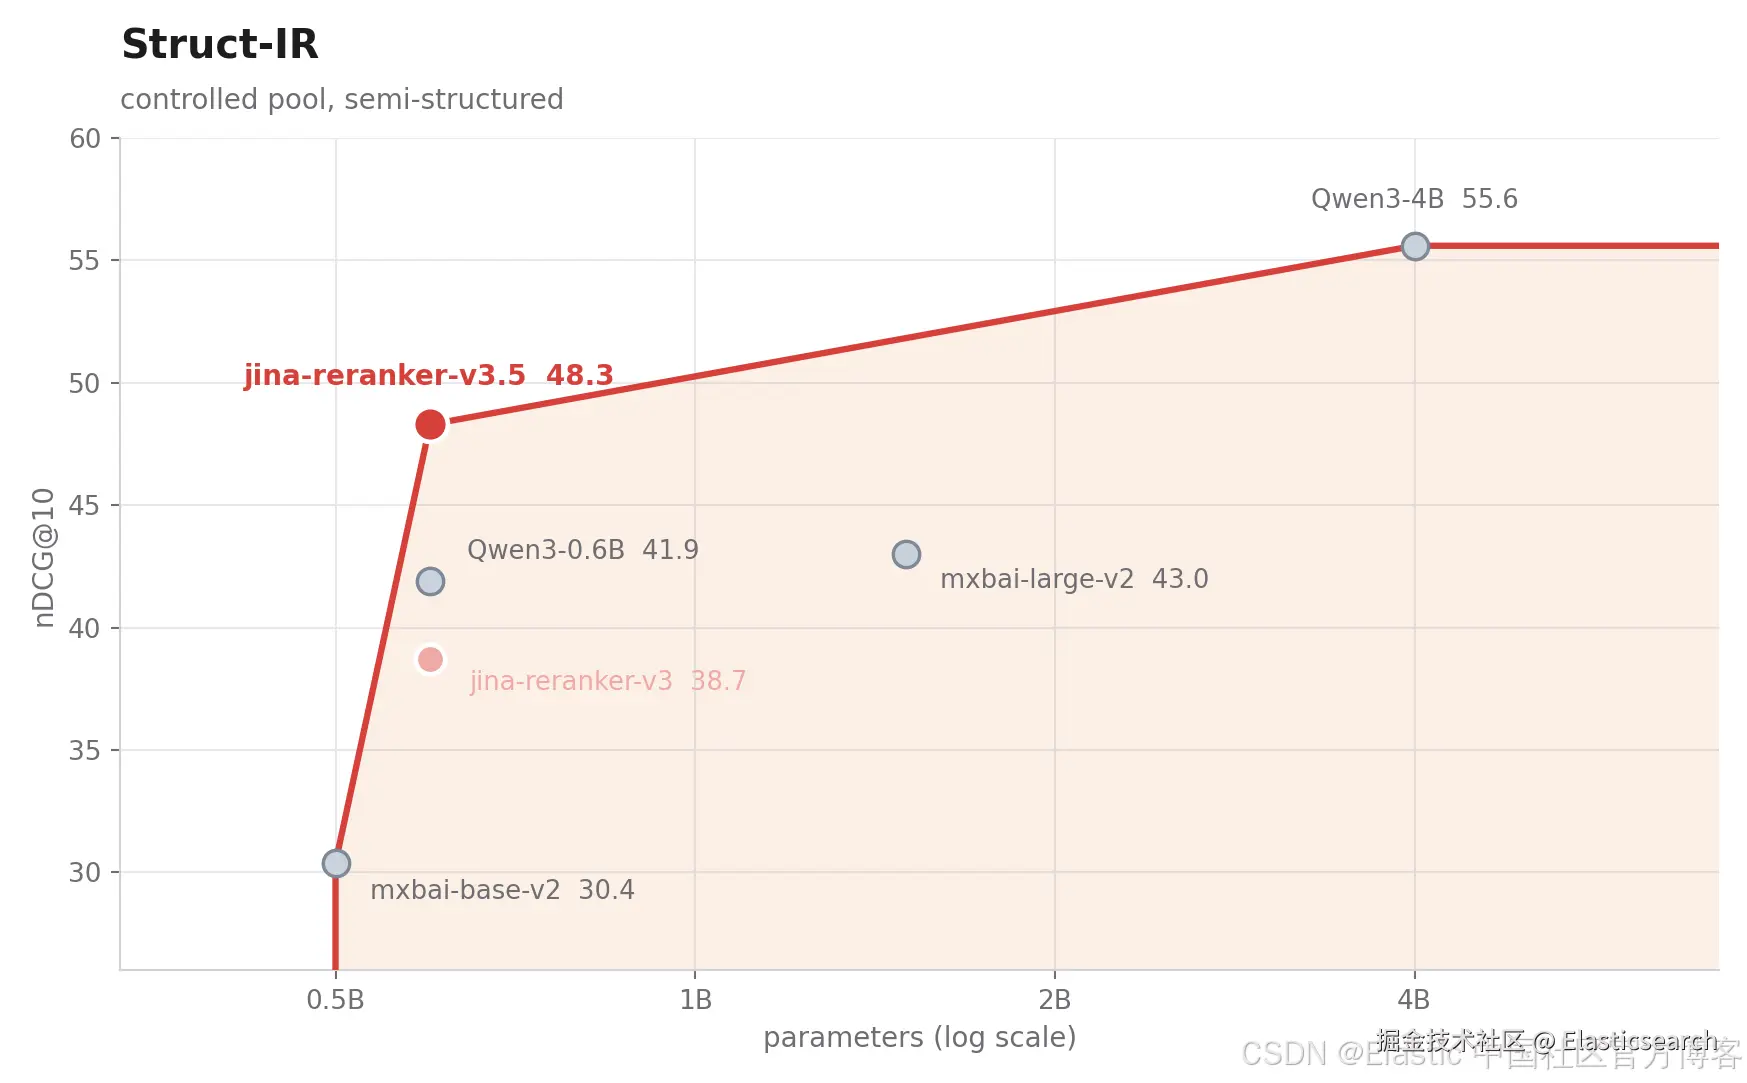 在 Struct-IR 上进行半结构化检索,采用受控的候选文档池:将所有真实文档与第一阶段检索中最难区分的 30 个干扰文档一起注入候选池,从而使该评测能够独立衡量字段约束下的区分能力,而不受检索覆盖率的影响。 jina-reranker-v3.5 达到 48.3,相比 jina-reranker-v3 提升 9.6 个百分点,是此次发布中单项最大提升。
请注意,这一评测方案与 SSRB 检索排行榜不可直接比较。
架构
列表式重排序会在一次前向传递中为每个候选文档进行评分,因此,对包含 100 个文档的列表进行完整的 自注意力 计算会呈二次增长,并使 KV 缓存膨胀。显而易见的解决方案是滑动窗口注意力。但在 LBNL 交互机制下,这个显而易见的解决方案反而会破坏模型。
在 LBNL 中,查询和所有候选文档构成一个因果序列,而查询嵌入 token 位于序列的最末端。为了构建能够感知跨文档信息的表示,它必须一路向前关注到第一个候选文档。有限的窗口会切断这种依赖关系。因此,我们始终将最后一层固定为全局注意力,这样查询和文档嵌入 token 在提取时都能看到完整的候选上下文。将这一层替换为滑动窗口会严重降低列表式排序效果;而仅保留这一层为全局注意力,则可以在不使用完全全局注意力堆栈的情况下保留联合编码能力。
对于剩余的 27 层,我们测试了 1L1G、1L2G、3L2G 和 5L1G 四种调度方案。3L2G 表现最佳:连续使用三层滑动窗口注意力,然后使用两层全局注意力,并不断重复这一模式,最终在窗口大小为 1,024 个 token 的情况下得到 17 个局部层和 11 个全局层。局部层将注意力计算成本从 O(L²) 降低到 O(L·w),而每三步出现的全局层则会在每个深度刷新长期的跨候选文档信号。更密集的调度方案并没有带来更高的吞吐量;而更加激进的 5L1G 在复杂的多文档任务上表现出变差的趋势。
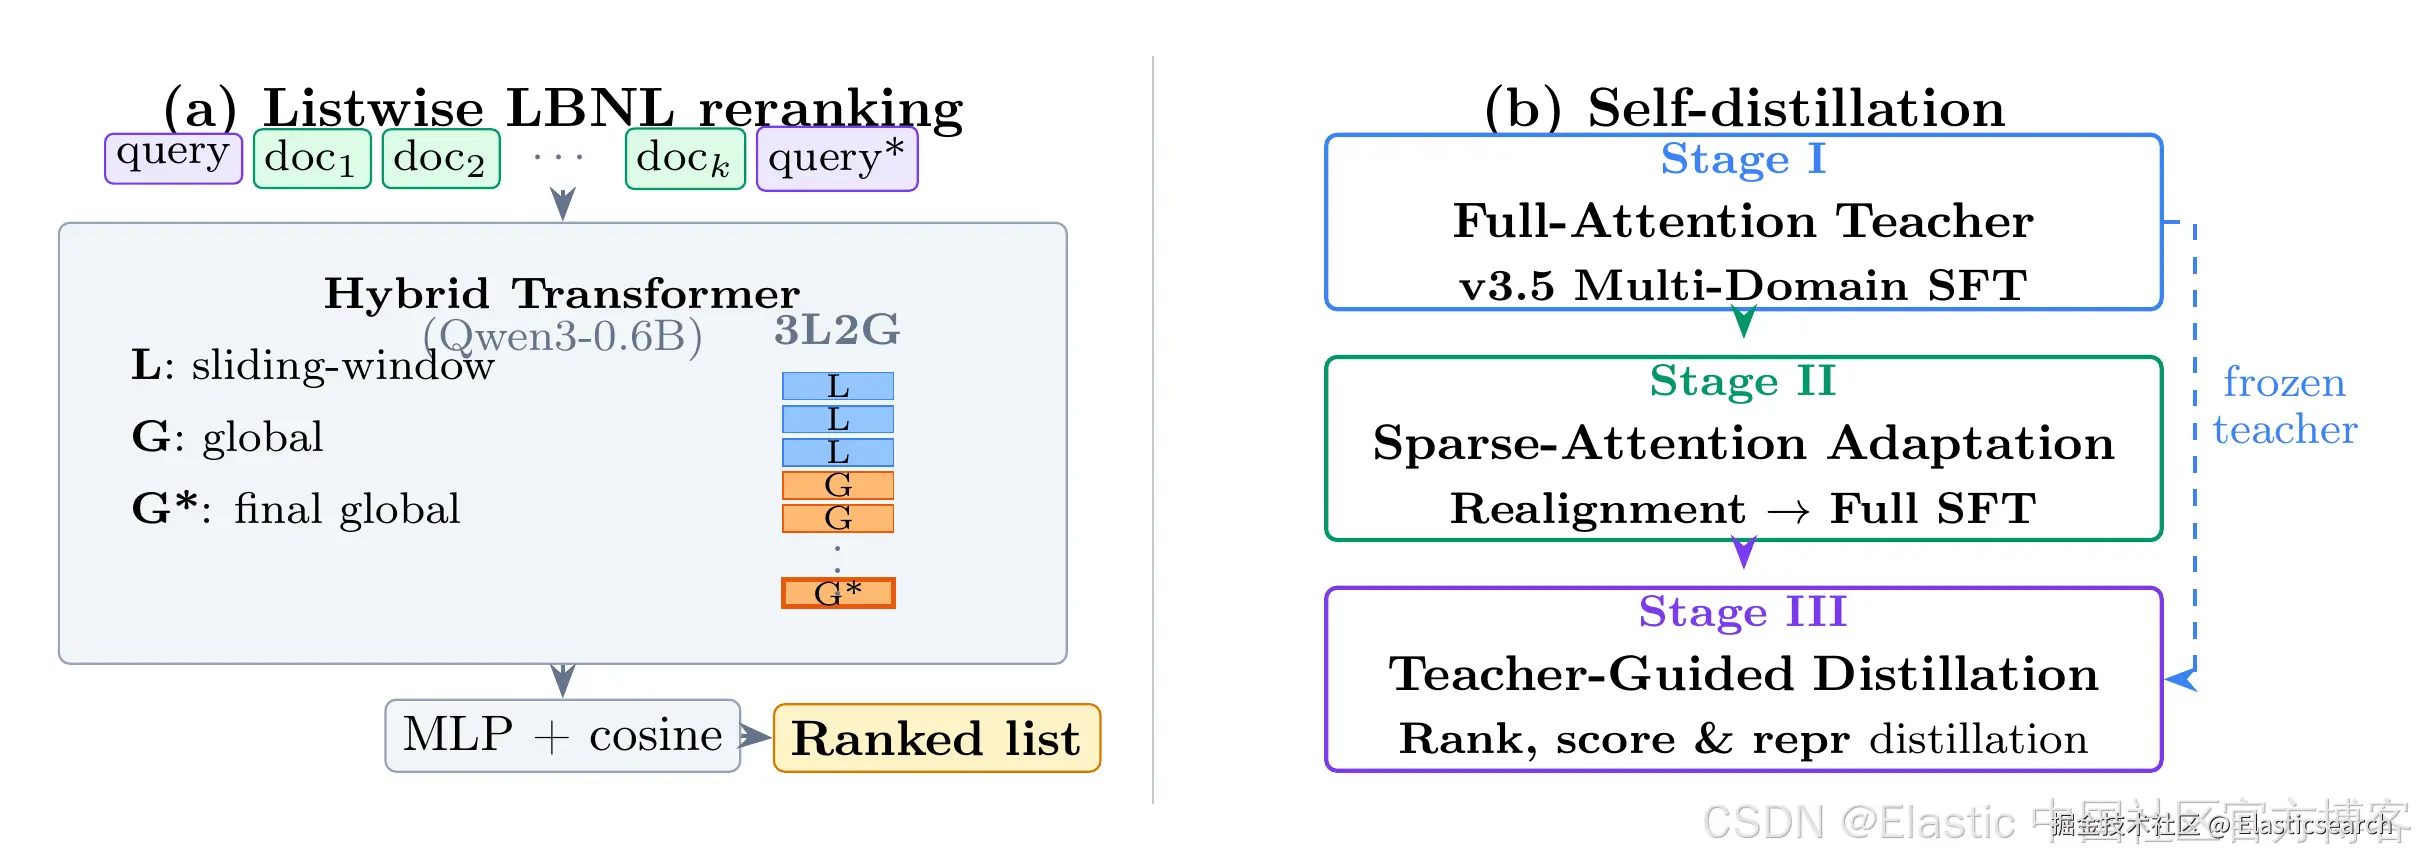 左:基于 3L2G 混合 Qwen3-0.6B 主干网络的 LBNL 列表式编码。查询和所有候选文档共享一个因果上下文;L 层使用 1,024 个 token 的滑动窗口,G 层使用全局注意力,而末端层 G* 始终固定为全局注意力,因此位于序列末尾的查询嵌入可以看到整个列表。MLP 将表示投影到共享空间,然后通过余弦相似度生成排序结果。
右:三阶段训练方案,其中第一阶段的全注意力教师模型保持冻结,并在第三阶段对学生模型进行指导。
跨注意力差异的自蒸馏
这里的蒸馏方式比较特殊。我们并不是将一个大型模型压缩成小型模型。教师模型和学生模型都是 0.6B 参数,唯一的区别在于注意力模式。教师模型使用完整注意力,计算成本呈二次增长;学生模型则使用 3L2G。
如果同时强迫学生模型切换注意力掩码并匹配教师模型的输出,模型会在这两方面都表现不佳,因此该训练方案将这两种压力解耦:
-
阶段 I------全注意力教师模型。 从公开的 jina-reranker-v3 checkpoint 开始,在完整的 v3.5 数据混合上对教师模型进行全面微调,不施加滑动窗口限制。它建立了这一参数规模下的质量上限。
-
阶段 II------稀疏注意力适配。 学生模型从阶段 I 的权重初始化,并启用 3L2G。首先,我们只训练注意力投影层,同时冻结其他所有参数,让稀疏掩码学习如何路由信息,而不会破坏在全注意力下学习到的表示。然后解冻所有参数,使学生模型重新适应新的注意力几何结构。在这一阶段,学生模型已经可以部署并且速度更快,但在 BEIR、RTEB-legal 和 MIRACL 上仍然与教师模型存在稳定的差距。
-
阶段 III------教师指导的蒸馏。 冻结教师模型,同时从四个层面让学生模型与教师模型对齐:对经过 softmax 归一化的分数分布进行列表式 KL 散度计算、对绝对分数进行 MSE 计算、对最后一层隐藏状态进行 MSE 计算,以及对投影后的嵌入进行余弦损失计算;此外,还加入上下文内相似度和离散度正则化项。
训练顺序很重要。仅进行阶段 II 会留下明显的差距,因为学生模型必须先在较弱的掩码下改变信息路由方式,然后才能安全地模仿教师模型的分数和状态。阶段 III 随后弥合了大部分差距,这说明一旦几何结构完成适配,全注意力的能力就可以迁移到稀疏注意力学生模型中。该方案是针对 3L2G 编写的,但这一思路同样可以推广到其他注意力调度不匹配的情况。
训练数据
v3 的数据混合在通用检索方面表现良好,但在专业领域上的表现较差。我们没有简单地增加更多数据,而是在 RTEB 和 STARK 开发集上进行错误分析,并构建每个新的数据分片,使其精准覆盖通用模型容易失败的检索模式。困难负例同时来自多个检索器(BM25、Jina、 BGE 、GTE、E5、ColBERT),因此模型无法学习某一个检索器的特定捷径。
法律数据分片结合了 EUR-Lex 多语言数据、CLERC、AILA、加拿大案例法、瑞士案例摘要和 EuroVoc,并对其进行过采样,因为法律文本通常包含大量引用且篇幅较长。医疗数据分片针对临床措辞和实体密集型段落。金融数据分片重点关注数值陈述、监管语言以及能够感知表格结构的段落。多语言覆盖范围也超出了 MIRACL 和 mMARCO,通过 WebFAQ 覆盖 50 多种语言,并加入 SWIM-IR 跨语言负例和 Ruri-v3 日语对。
结构化数据获得了最高的采样权重,因为它处于标准基准测试所假设的自由文本分布之外。对记录和表格的相关性判断依赖于相等性、数值和日期范围、列表成员关系以及跨字段的逻辑组合,而不是词汇重叠。早期实验在这一领域的表现最差,因此我们直接合成了包含大量约束条件的数据对。
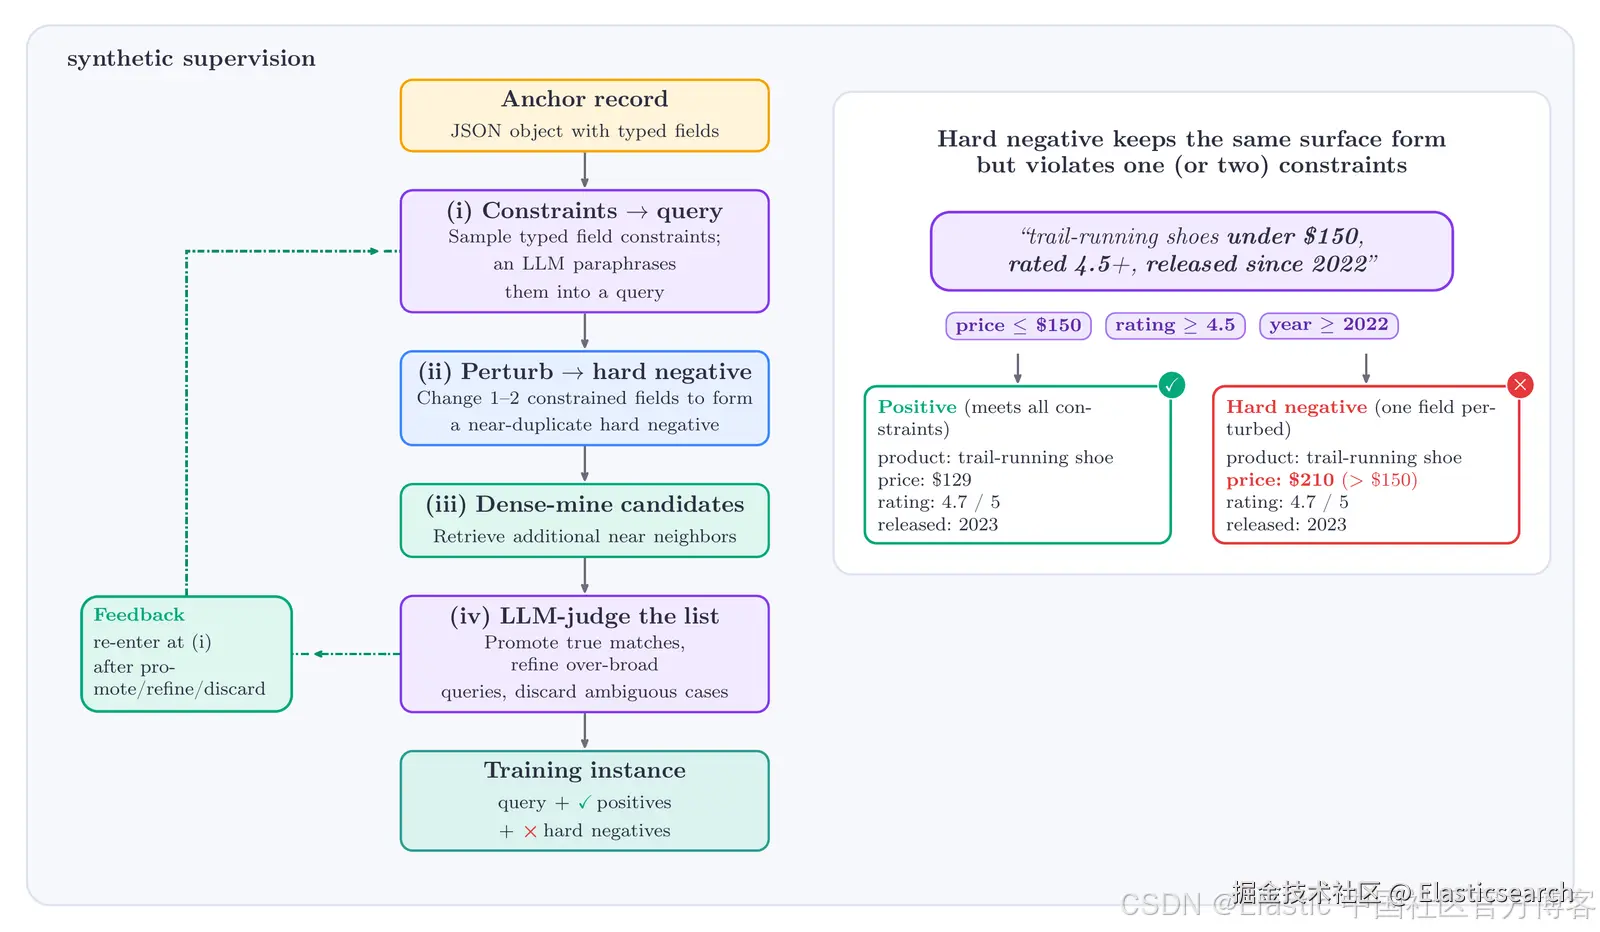 用于字段约束检索的合成监督数据。我们从一个锚点记录中采样带类型的约束条件,然后让 LLM 将这些约束改写成查询;随后对一个或两个受约束字段进行扰动,构建一个近重复的困难负例,使其保持相同的表面形式,但违反某个约束条件。密集检索会进一步添加候选结果,而 LLM 评审器则筛选出真正匹配的结果、优化过于宽泛的查询并丢弃存在歧义的案例,然后将这些结果反馈到查询生成过程中。右侧的示例展示了为什么词汇重叠在这里毫无用处:正例和困难负例除了一个字段不同之外,完全是相同的字符串。
实验结果
所有数据均采用统一的 MTEB v2 流程,对 jina-embeddings-v5-text-small 返回的前 100 个候选结果进行重排序,因此这些数据可能与厂商报告的结果存在轻微差异。论文中提供了完整的按数据集和按语言划分的结果表。
| Model | Params | BEIR | MIRACL | RTEB | Struct-IR |
|---|---|---|---|---|---|
| jina-embeddings-v5-text-small (1st stage) | 0.5B | 56.26 | 65.15 | 64.60 | -- |
| mxbai-rerank-base-v2 | 0.5B | 59.58 | 64.90 | 61.44 | 30.4 |
| Qwen3-Reranker-0.6B | 0.6B | 56.94 | 67.12 | 68.41 | 41.9 |
| mxbai-rerank-large-v2 | 1.5B | 62.45 | 69.65 | 70.81 | 43.0 |
| Qwen3-Reranker-4B | 4.0B | 62.28 | 76.56 | 77.68 | 55.6 |
| jina-reranker-v3 | 0.6B | 62.10 | 72.20 | 68.01 | 38.7 |
| jina-reranker-v3.5 | 0.6B | 63.20 | 74.11 | 70.95 | 48.3 |
v3.5 在相同参数规模下,在所有基准测试类别中都优于 v3,其中半结构化检索的提升最大。
RTEB 的提升主要集中在训练数据混合所针对的领域:与 v3 相比,AILA-Statute 提升了 14.0 个百分点,AILA-Case 提升了 11.7 个百分点;FinQA 达到 86.91,是所有测试模型中的最佳成绩。在 STARK 上,v3.5 在全部三个官方指标上都优于 v3,并取得了整体最佳的 Hit@5。
关于 Struct-IR,需要说明一个评测方案上的问题。该基准测试会针对每个 schema 索引数百万个对象,而第一阶段检索在 schema 内的 Recall@5 约为 0.04,因此端到端的"检索后重排序"几乎完全受召回率限制,也就很难有效区分不同的重排序模型。我们改为将所有真实文档与第一阶段检索中最难区分的 30 个干扰文档一起注入候选池,从而独立衡量字段约束下的区分能力,而不受检索覆盖率的影响。基于这一候选池得到的数据不能与 SSRB 检索排行榜进行比较。
效率
在单张 NVIDIA A100 上进行测量,batch size 为 1,使用前 100 个候选文档的列表式输入,并启用 FlashAttention-2。
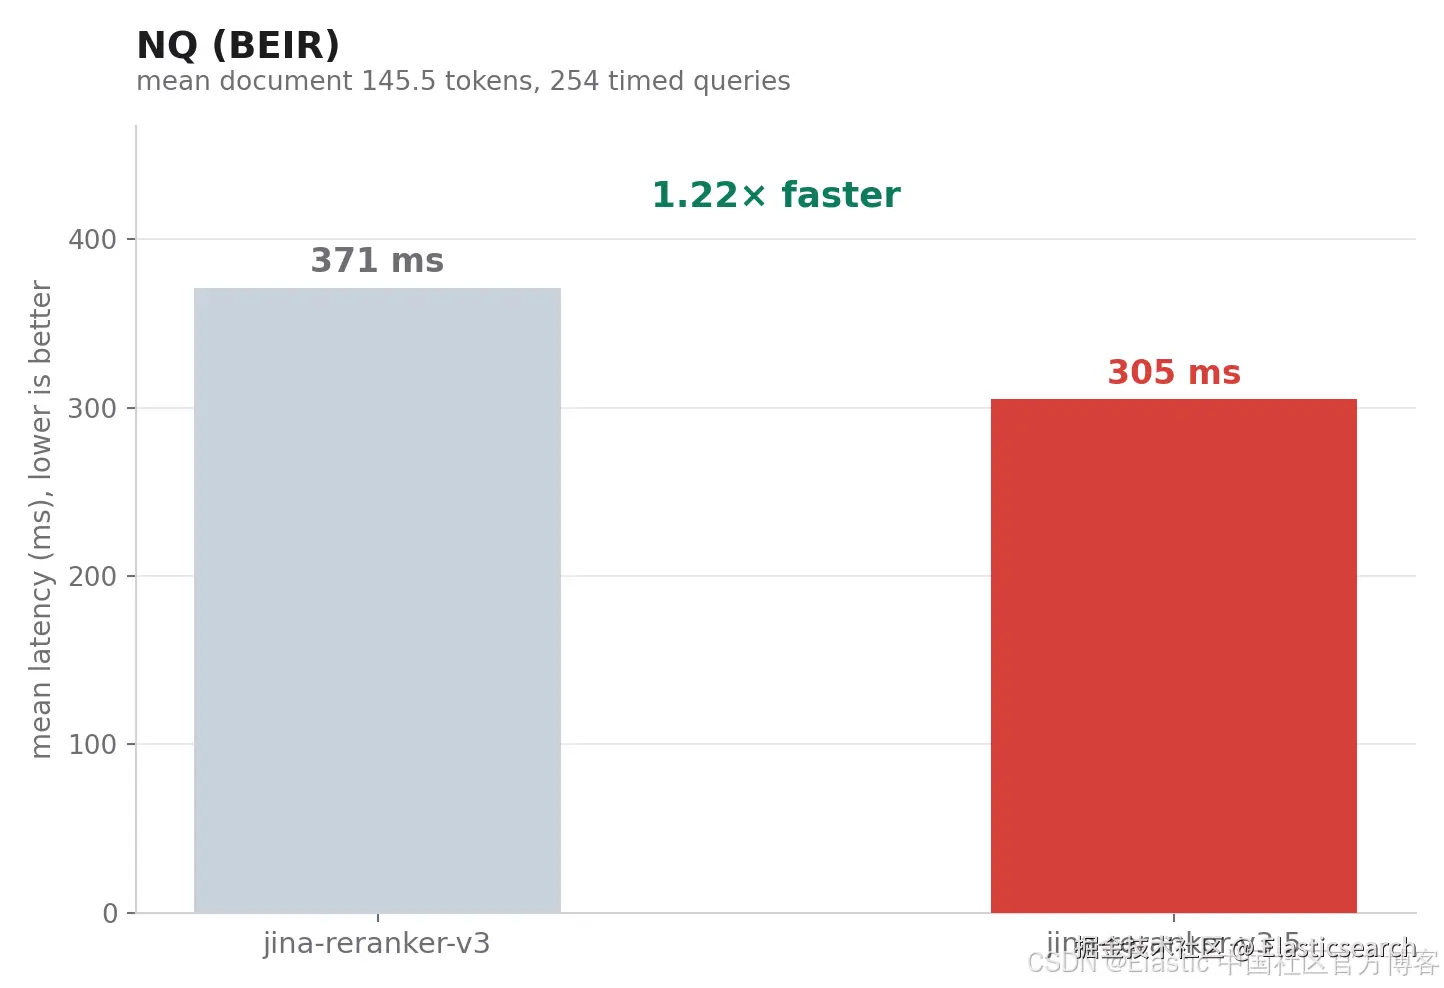 短上下文场景下,在 BEIR Natural Questions 中,基于 254 个计时查询,查询和文档的平均长度分别为 10.3 和 145.5 个 token。前 100 个候选文档的列表式重排序平均延迟从 371 ms 降至 305 ms,速度提升了 1.22 倍,同时文档吞吐量从 270 docs/s 提升至 328 docs/s。
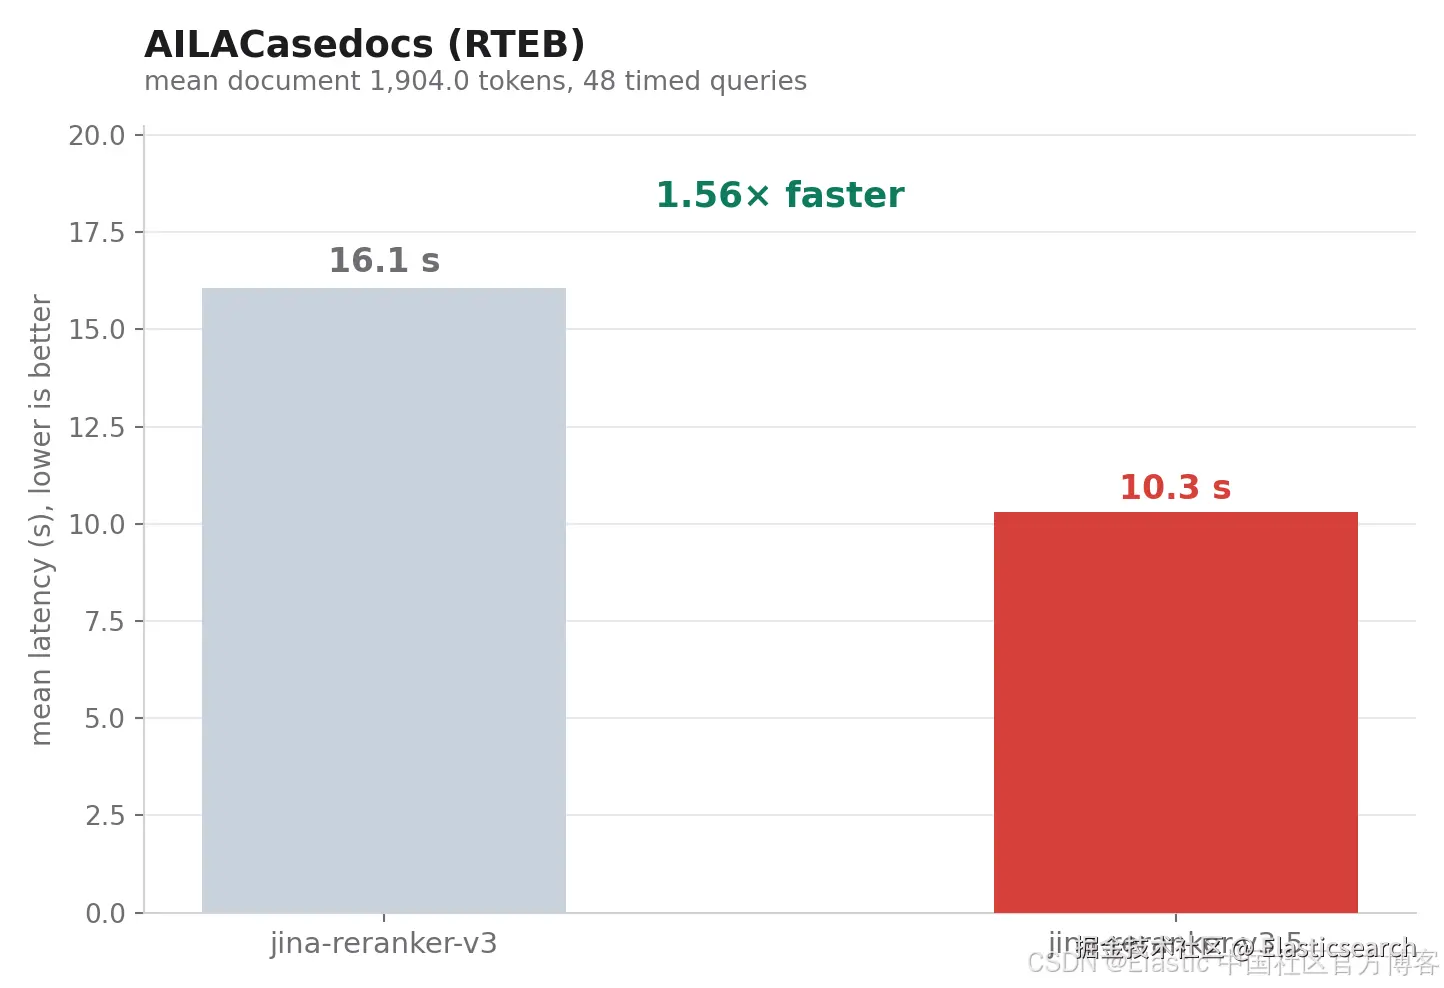 长上下文场景下,在 RTEB AILACasedocs 中,基于 48 个计时查询,查询和文档的平均长度分别为 689.8 和 1,904.0 个 token。平均延迟从 16.1 s 降至 10.3 s,速度提升了 1.56 倍,同时预填充吞吐量从 11.9k 提升至 18.6k tokens/s。当候选文本较长时,混合注意力带来的收益最大。
由于生产环境中的列表式重排序主要由针对一组全新候选文档执行的一次预填充过程所主导,因此,在固定的服务预算下,这些延迟降低可以直接转化为更长的候选列表以及更大的文档。
开始使用
通过 Jina Search Foundation API
arduino
`
1. curl -X POST \
2. https://api.jina.ai/v1/rerank \
3. -H "Content-Type: application/json" \
4. -H "Authorization: Bearer ***" \
5. -d '{
6. "model": "jina-reranker-v3.5",
7. "query": "trail-running shoes under $150, rated 4.5+, released since 2022",
8. "documents": [
9. "...",
10. "..."
11. ],
12. "return_documents": false
13. }'
`Lobster AI通过 Elastic Inference Service
jina-reranker-v3.5 从 Stack 9.3 开始即可在 Elastic Inference Service(EIS)上使用,因此你可以在托管 GPU 上执行重排序,而无需自行托管该模型。创建一个引用该模型的 inference endpoint,然后像调用其他 rerank 任务一样调用它。
bash
`

1.  PUT _inference/rerank/eis-jina-reranker-v3-5
2.  {
3.    "service": "elastic",
4.    "service_settings": {
5.      "model_id": "jina-reranker-v3.5"
6.    }
7.  }

`Lobster AI
bash
`

1.  POST _inference/rerank/eis-jina-reranker-v3-5
2.  {
3.    "query": "trail-running shoes under $150, rated 4.5+, released since 2022",
4.    "input": [
5.      "...",
6.      "..."
7.    ]
8.  }

`Lobster AI
响应会返回一个按相关性排序的 rerank 数组,其中每个条目都包含候选文档的原始索引及其分数。由于它是一个标准的 inference endpoint,因此可以直接在搜索查询的 text_similarity_reranker retriever 中引用 inference_id。
通过 transformers
ini
`
1. from transformers import AutoModel
3. model = AutoModel.from_pretrained(
4. 'jinaai/jina-reranker-v3.5',
5. dtype="auto",
6. trust_remote_code=True,
7. )
8. model.eval()
10. query = "What are the health benefits of green tea?"
11. documents = [
12. "Green tea contains catechins that may help reduce inflammation.",
13. "El precio del cafe ha aumentado un 20% este ano.",
14. "绿茶富含儿茶素等抗氧化剂,可以降低心脏病风险。",
15. "Le the vert est riche en antioxydants.",
16. ]
18. for r in model.rerank(query, documents):
19. print(f"{r['relevance_score']:.4f} {r['document'][:70]}")
`Lobster AI结论
jina-reranker-v3.5 的实际主张是明确且可验证的:在 0.6B 参数规模下,有针对性的训练能够缩小与 4B 通用型重排序模型之间的大部分差距;在 BEIR 上则完全弥合了这一差距,同时运行速度还快于它所替代的模型。对于企业级检索而言,这意味着,与默认选择可用的最 大模型 相比,更值得在紧凑型骨干模型上投入针对性的监督训练。
有两个局限性值得明确说明。列表式重排序模型仍然存在点式模型和后期交互模型可以避免的输入限制,尤其是候选文档数量和候选文档总长度存在固定的上限。此外,在 RTEB 的法律和医疗任务、受控候选池的 Struct-IR,以及 MIRACL 的低资源语言上,与 4B Qwen 之间仍然存在重要差距。这些都是困难案例,我们选择明确指出它们,而不是用平均值将它们掩盖。