结构介绍:
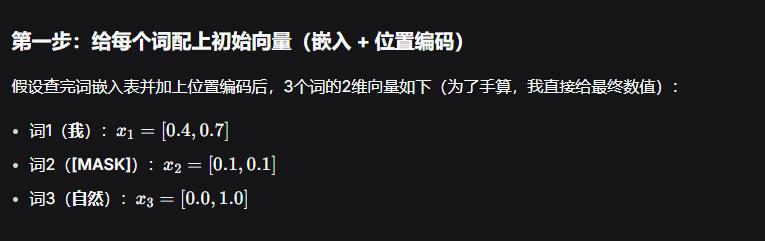
简介:设置场景(词汇表大小=5,维度=2,句子"我 MASK 自然")。
步骤1:嵌入 + 位置编码(具体数字)。
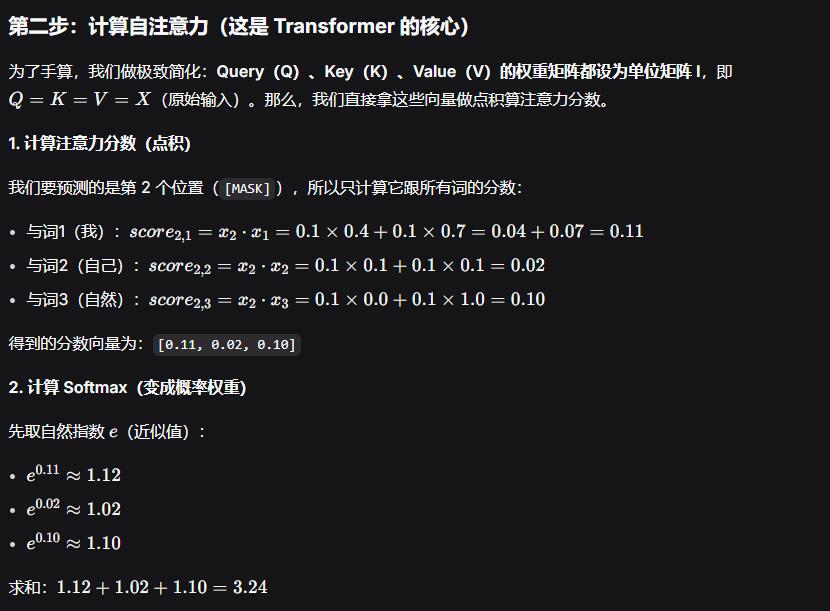
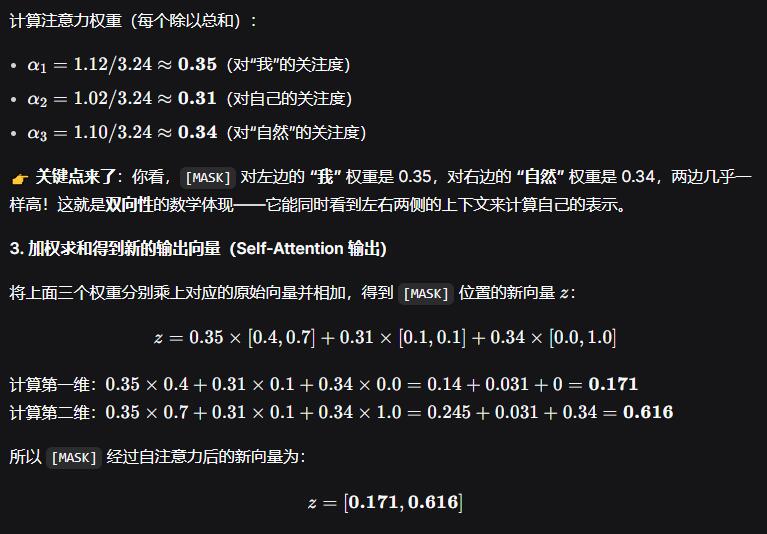
步骤2:自注意力(计算分数,softmax,加权求和)------展示双侧上下文。
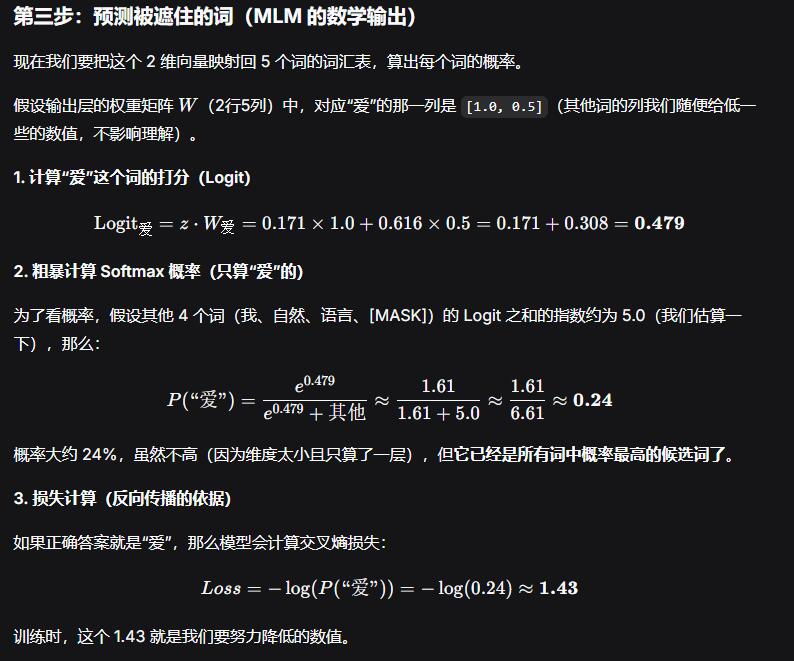
步骤3:输出预测(线性层,softmax,损失)。
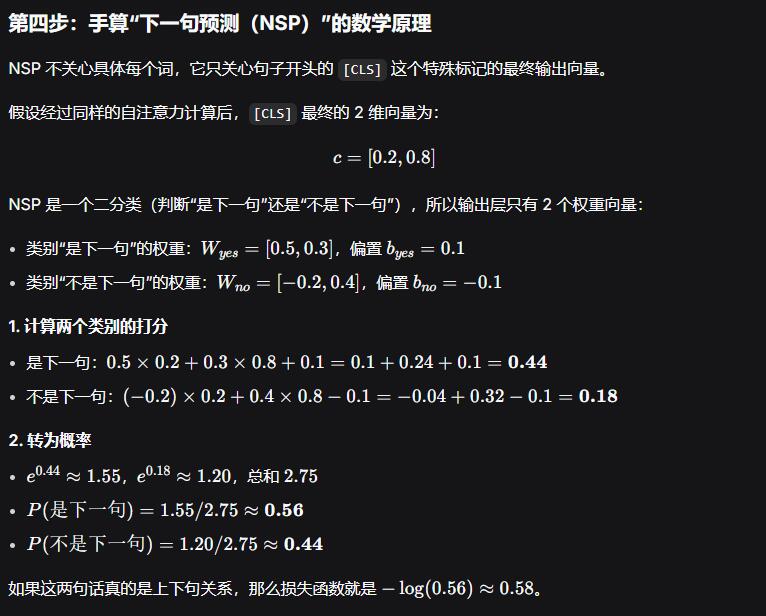
步骤4:NSP示例(CLS向量,分类层,softmax,损失)。
结论:强调每个步骤的数学本质(矩阵乘法、点积、softmax)以及双向性是如何在注意力分数的计算中自然体现的。
词汇表 :只有 5 个词:
[我, 爱, 自然, 语言, [MASK]](索引 0~4)。词向量维度 :从真实的 768 维压缩到 2 维(这样点积和加法咱们心算就能搞定)。
模型:只有 1 层 Transformer 编码器,且忽略多头,只算单头自注意力。
我们的输入句子是:我 [MASK] 自然(让模型根据"我"和"自然"这两个上下文,猜出中间被遮住的是"爱")。
bert的数学本质:
双向性 :在算
[MASK]的注意力分数时,我们同时用到了左边的向量([我])和右边的向量([自然])做点积,这决定了它在数学上就是"从左到右 + 从右到左"同时进行的。全是矩阵乘法 :无论是 MLM 还是 NSP,底层全是点积(求相似度)→ Softmax(加权)→ 加权求和 → 线性映射(全连接层)→ 再 Softmax(得概率)。
损失驱动:最后算出的 1.43 或 0.58 这些数值,就是反向传播时用来更新所有权重矩阵(我们手算时省略的那些巨大矩阵)的原始依据。
bert模型在这三个应用上很好!
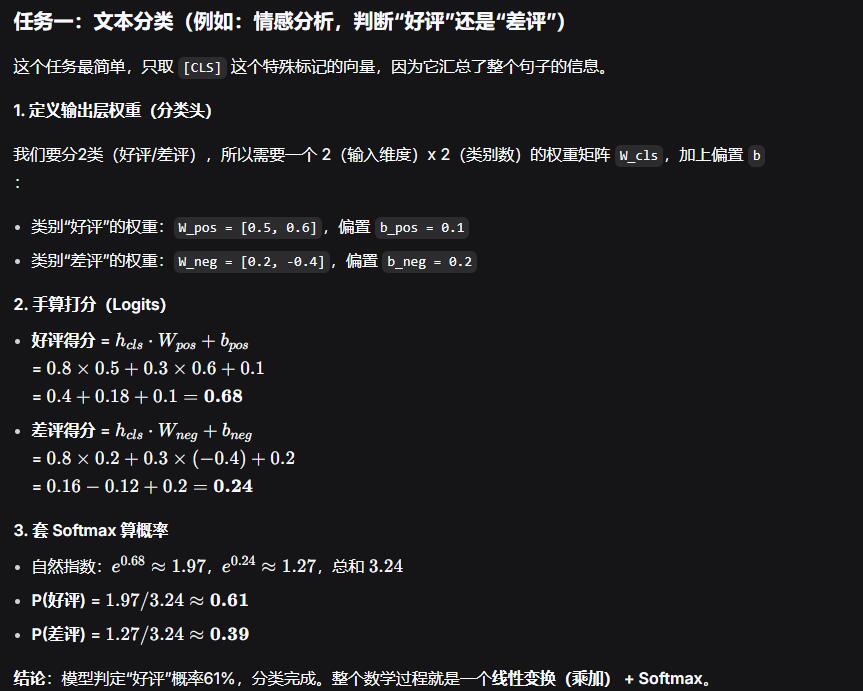
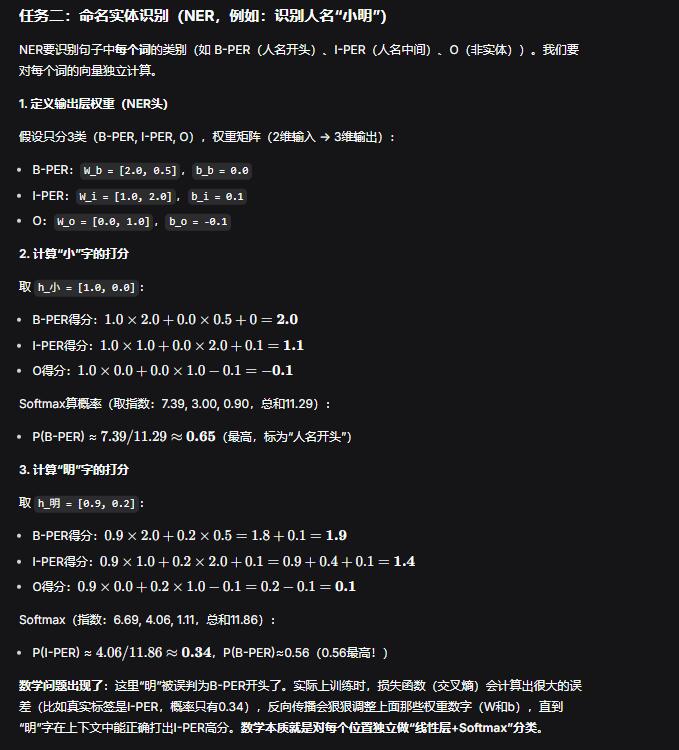
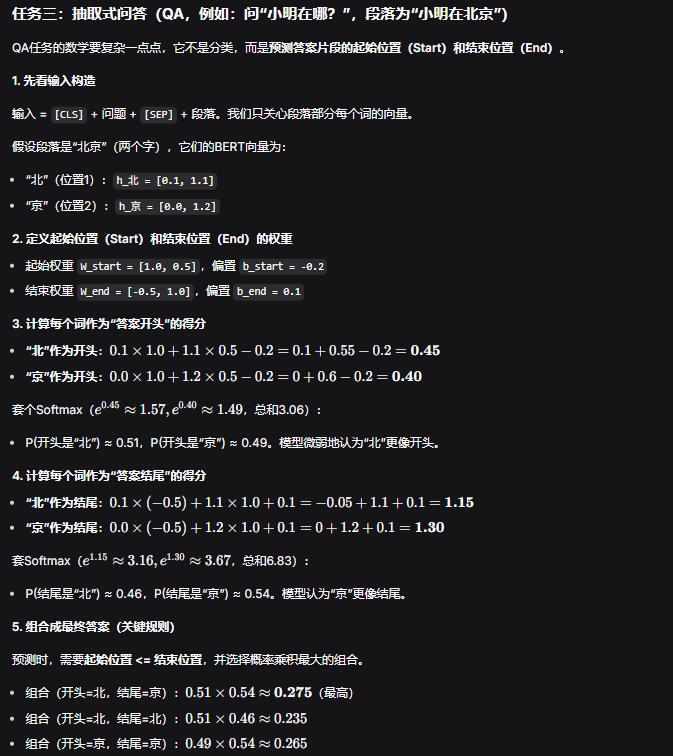
把BERT的底层输出(即经过12层编码器后得到的最终向量)当作"已知条件"。对于下游任务,数学原理其实就三步:拿向量 → 乘权重矩阵 → 套Softmax算概率。
文本分类、命名实体识别(NER)和抽取式问答(QA)。
设定共享前提(BERT的输出)
假设我们输入一个句子,BERT针对每个词输出了一个2维的特征向量(真实是768维,这里简化)。
[CLS]标记的向量:h_cls = [0.8, 0.3](用于分类)"小明"的"小"字向量:
h_小 = [1.0, 0.0]"小明"的"明"字向量:
h_明 = [0.9, 0.2]"北京"的"北"字向量:
h_北 = [0.1, 1.1]"京"字向量:
h_京 = [0.0, 1.2]
总结一下三者的数学本质
| 任务 | 输入用的向量 | 数学操作 | 输出形式 |
|---|---|---|---|
| 文本分类 | 取 [CLS] 的 2维向量 |
一次线性变换 + Softmax | 每个类别的概率(如好评61%) |
| 命名实体识别 | 每个词的 2维向量(独立算) | 每个位置独立做线性变换 + Softmax | 每个词对应各类别的概率 |
| 抽取式问答 | 段落中每个词的 2维向量 | 两组线性变换(起点/终点) + Softmax,再组合 | 最优起止位置组成的答案片段 |
微调bert,微调就是在预训练好的顶部,接几层我们上面手算的这种"乘加(矩阵乘法)"运算。所有的"理解"能力,早就被预训练(MLM和NSP)固化在底层的向量数值里了。我们做下游任务,只是把这些现成的向量拿出来,算个加权和而已。
注意:
文本分类 :把一整段话 或一整篇文章,归入你提前设定好的几个类别(如:正面/负面、体育/财经/娱乐、垃圾邮件/正常邮件)。
实体命名 :把文章里的人名、地名、机构名、日期、专有名词 等,像荧光笔一样一个一个标记出来,并告诉你是属于哪一类。
抽取式问答(QA) :给它一段背景材料 和一个问题 ,它不自己编答案,而是从背景材料中掐头去尾 ,把最匹配的那一段原话原封不动地摘出来作为答案。