摘要
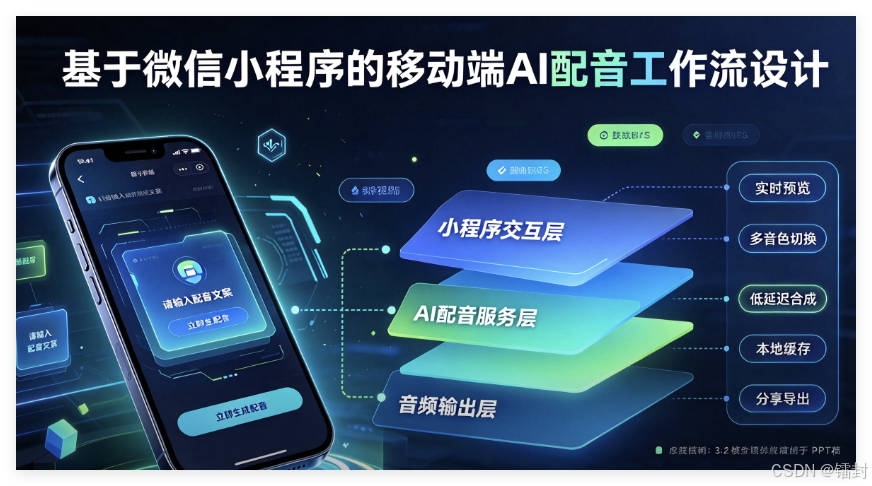
移动端AI配音正成为短视频创作者的主流选择。本文从工程角度,分析基于微信小程序的AI配音工作流设计,探讨如何将文案处理、语音合成、音频导出整合为一条高效的移动端流水线。
背景
短视频创作场景对配音工具提出了特殊要求:
- 碎片化:创作者往往不在电脑前
- 低门槛:不需要安装额外软件
- 一站式:从文案到成片尽量在一个环境内完成
微信小程序天然具备免安装、触达便捷的特点,是承载这类工作流的理想载体。
工作流整体架构
一条完整的移动端配音工作流包含以下环节:
plaintext
素材获取 → 文案处理 → 语音合成 → 音频导出 → 剪辑合成
每个环节都可以独立工具承载,也可以整合到一个小程序内。
环节一:素材获取
文案提取:利用ASR(语音识别)技术,从参考视频中提取语音转文字。工程上,这一环节需要:
- 视频URL解析(微信视频号、抖音、B站等平台)
- 音频提取与降噪
- ASR引擎调用(云端如讯飞/腾讯、本地如Whisper)
部分小程序已内建这一能力,例如叮叮配音提供的"文案提取"功能,简化了创作者的素材准备流程。
环节二:文案处理
智能润色:使用NLP技术将书面文案改写为适合朗读的口语稿。
- 句式拆分:长句 → 短句
- 连接词简化:删除"因此""所以"等书面连接词
- 语感优化:增加"你""我们"等对话化词汇
这一步的技术门槛相对较高,涉及生成式NLP模型的能力。
环节三:语音合成
核心环节。当前主流方案:
表格
| 方案 | 特点 |
|---|---|
| 云端神经网络TTS | 音色多、自然度高、依赖网络 |
| 本地模型合成 | 隐私性好、无网络限制、音色有限 |
| 混合调用 | 优先本地,失败回退云端 |
音色库的规模直接影响创作自由度,叮叮配音提供的1000+音色在小程序方案中属于较大规模,而且还是免费配音小程序。
环节四:音频导出
标准输出为MP3格式,部分场景需要WAV无损格式。工程上要注意:
- 采样率与比特率选择
- 音频元数据(时长、采样率)一致性
- 多平台兼容(Android/iOS文件系统差异)
环节五:剪辑合成
音频导入剪映/CapCut等工具,按脚本时间轴对齐画面,添加字幕和背景音乐。
性能与体验优化
合成速度
TTS合成延迟直接影响用户体验。优化方向:
- 分段合成:长文本切块并行合成
- 缓存策略:相同文本缓存音频,避免重复合成
- 渐进加载:先播放前几段,后台继续合成
音色切换
多角色场景需要频繁切换音色。工程上建议:
- 建立音色配置模板(音色情、语速、语调等)
- 按内容类型分组,减少选择成本
- 支持一键应用历史配置
移动端AI配音工作流的核心在于减少环节间的切换成本。小程序形态天然适合承载这条流水线,但需要权衡的是:小程序的能力边界(无法调用底层API、无法自动化脚本)限制了其在批量生产场景中的能力。后续文章将探讨如何通过自动化手段突破这些边界。