函数表达世界,function describe the world
1.概览
大模型分为训练和推理的两个阶段,训练就是大模型进行学习,推理就是大模型进行输出。
简单的图:
大模型系统 / AI Infra
│
┌───────────┴───────────┐
│ │
训练 Infra 推理 Infra
│ │
Distributed Training LLM Serving
Data Parallel vLLM / SGLang
Tensor Parallel KV Cache
Pipeline Parallel Scheduler
NCCL CUDA / Triton
ZeRO / FSDP Quantization
Megatron TensorRT-LLM
大模型的推理阶段。
大模型推理目的,高吞吐,低延迟
学习推理,要学习Transformer推理,PyTorch推理执行,GPU 架构和 CUDA,学 Triton,vllm
其中,transformer 会同时在训练和推理阶段都用到。transformer本身是一个模型计算过程,姑且先这么理解吧。
模型训练完整的生命周期如下:
数据
↓
预训练 Pre-training
↓
后训练 Post-training
(SFT / RL 等)
↓
得到最终模型参数
↓
部署到推理系统
↓
用户请求
↓
Transformer 前向计算
↓
输出 Token
在我看来,每一步都很重要,数据是一切的开始,但是网络上的数据很多,很杂,据我所知,就有一些岗位是专门来处理数据,为模型训练提供一个基石,可能是脚本,可能是流水线,都有可能。
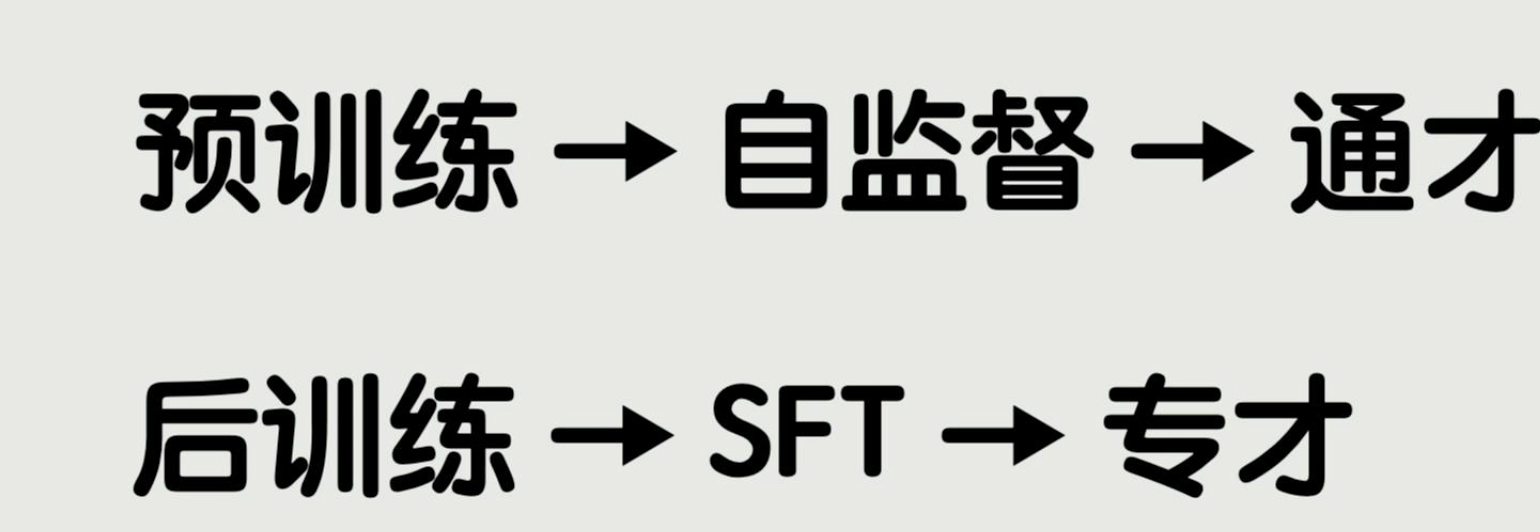
预训练,以我现在认识,预训练就是在调参,一般的来说,数学是固定的,确定的,比如f=ma,G=mg,这些公式,固定的输入输出,得到一定准确的结果,但是如果是什么是猫,什么是狗,这种抽象的输入,程序就比较难以回答是true和false了。y=kx+b,是一个函数,一条线,对吧,但是模型训练就是给定一大堆固定的参数,通过训练,得到一个函数,这个函数可以有许多参数,不一定是直线,也可能弯曲。预训练就是在调参数,让结果尽量接近正确,但不保证正确。
后训练,也是在调残,不过数据是一些人类希望的回答。
最终得到一个模型。我理解最终的模型就是一个有着巨大参数的函数。输入是任何东西,输出也是。函数表达世界
最后训练好的模型部署在推理,用户开始输入,比如,你是谁,推理系统需要把输入给到训练好的模型,模型内部的计算是通过transformer进行的。所以最终得到一个输出。
之所以需要专门需要推理是因为一个模型部署起来,可能同时有很多请求打过来,需要同时处理1w条请求,这个就比较头疼呀,所以需要有推理。
再给一个图,模型训练时的图,这个图我理解就是调参的图:
输入数据
↓
Transformer Forward
↓
得到 Loss
↓
Backward
↓
计算 Gradient
↓
Optimizer 更新参数
↓
重复很多次
模型通过大量的训练,得到了一个训练好的模型。
到了推理阶段,这个阶段就是需要模型输出答案了:
用户输入
↓
加载训练好的参数
↓
Transformer Forward
↓
算出下一个 token 的概率
↓
选择 token
↓
再执行 Transformer Forward
↓
再生成一个 token
↓
...
所以模型训练的整个流程我们讲清楚之后, 需要知道就是模型有训练和推理两个部分。从而衍生出对应的需求。
训练关注:
如何把模型参数学好?
推理关注:
参数已经学好了,
如何让大量请求
更快、更便宜、更稳定地跑完 Transformer?
所以有vllm这个推理架构,帮助我们来处理大量的请求。和数据库是类似的,磁盘IO是缓慢的,一方面是需要从用户到内核的开销,一方面是磁盘本身寻址就是慢的,所以我们尽可能堆batch,然后统一的去请求,这样可以加快速度。
用户请求
↓
┌────────────────────┐
│ vLLM │
│ │
│ Scheduler │
│ Continuous Batch │
│ KV Cache Manager │
│ PagedAttention │
│ Prefix Cache │
│ Model Runner │
└─────────┬──────────┘
↓
┌────────────────────┐
│ Transformer │
│ │
│ Attention │
│ RMSNorm │
│ MLP │
│ RoPE │
└─────────┬──────────┘
↓
CUDA
↓
GPU
简单的理解,
Transformer 告诉你"一个请求怎么算";vLLM 告诉你"一万个请求怎么高效地一起算"。
一生一,二胜二,三生万物。
2.学习路线
Transformer 推理 + PyTorch + KV Cache

CUDA + GPU 架构 + Nsight

Triton + Attention Kernel + Benchmark

vLLM 源码 + Scheduler + KV Cache Manager

Mini Inference Engine
3.transfomer理解
B站的讲解视频
如果说f=ma可以表达成确定的函数,牛二也可以,G=mg也可以,传统编程几乎就是让计算机器执行重复的事情,但是如果问题转变,我们想要让机器识别一只猫,这种输入不固定,就变得异常困难,那怎么办呢,猜,找不到一组数据的规律就利用大量的计算来接近真实的数据。
神经网络就是非常复杂的一个非线性函数