📑课程信息
- 领域:IT运维 / AIOps 安全运营实战
📖 知识精讲
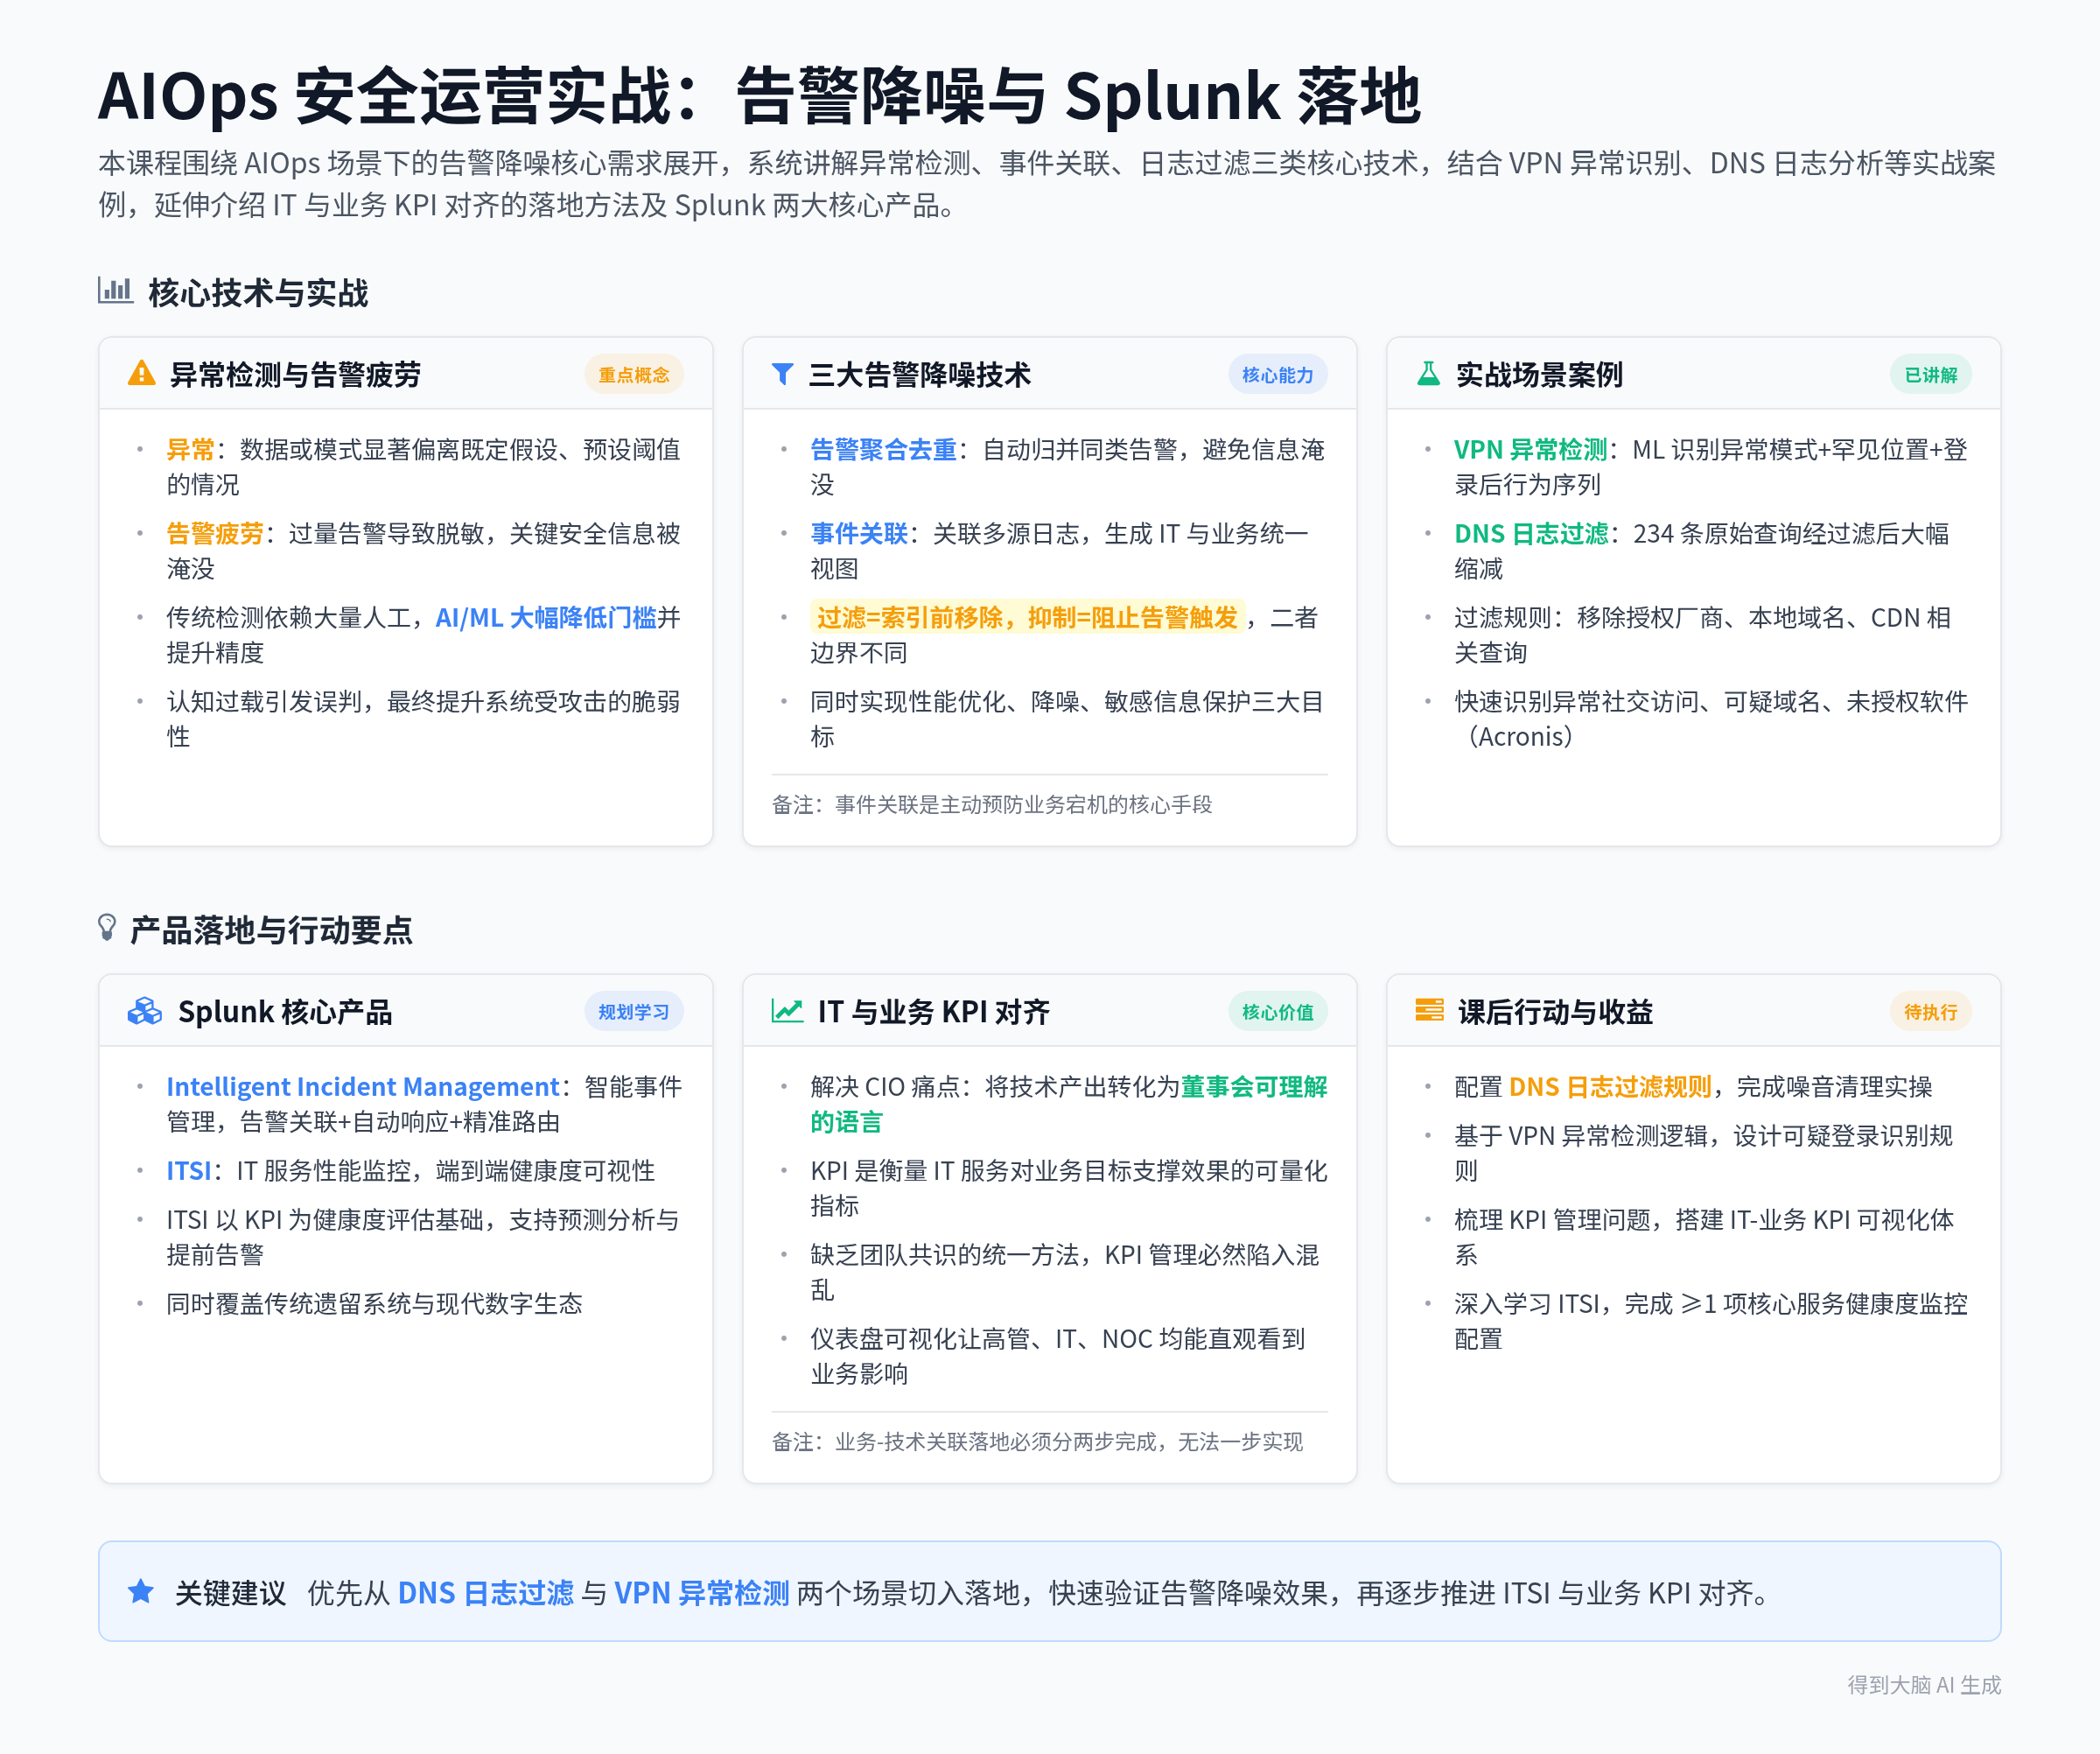
本课程围绕AIOps场景下的告警降噪核心需求展开,系统讲解异常检测、事件关联、日志过滤三类核心技术,结合Splunk平台的VPN异常识别、DNS日志分析实战案例,延伸介绍IT与业务KPI对齐的落地方法,覆盖Splunk Intelligent Incident Management、ITSI两大核心产品的功能与价值。
异常与异常检测基础定义
-
异常的核心定义:指数据或模式显著偏离既定假设、预设阈值的情况。
-
异常检测的定义:所有用于识别偏离正常预期行为的数据点或事件的技术统称。
- 🚩重点:传统异常检测依赖大量人工操作,机器学习与AI技术的发展大幅降低了操作门槛,提升了各类环境下的检测精度与复杂度适配能力。
告警疲劳的危害与影响
-
告警疲劳的定义:用户因接收过量告警而对告警信息脱敏,进而忽略或无法正确响应重要预警的现象。
-
告警疲劳的核心危害:关键安全信息被海量无效告警淹没,引发认知过载,导致运维人员难以区分高低风险告警,甚至将真实告警误判为误报,最终大幅提升系统受真实安全威胁攻击的脆弱性,削弱整体安全防御能力。
Splunk告警降噪核心能力
-
告警聚合与去重:自动归并同类告警、移除重复告警,避免同一问题的多条通知淹没运维团队。
-
自动化响应配置:针对常规安全事件实现自动化分类与优先级判定,无需人工介入。
-
预置工作流机制:为常见安全事件配置标准化处理流程,无需人工决策即可快速、一致地完成已知问题的处置。
-
值班轮询管理:支持运维团队轮值机制,避免人员长期过载,防止 burnout 问题出现。
VPN异常检测实战场景
-
场景背景:企业部署VPN服务支持员工远程接入,日志中存在大量合法员工连接记录,同时需要识别潜在的黑客异常接入行为。
-
Splunk检测逻辑:通过机器学习模型识别登录活动中的异常模式、罕见登录位置,同时分析VPN登录后的后续操作序列,精准发现易被遗漏的可疑行为。
事件关联技术原理
-
核心定义:针对多个独立日志条目各自无异常、但组合后存在风险的场景,通过AI与机器学习技术关联多监控源数据,生成IT与业务服务的统一视图。
- 🚩重点:该技术可大幅削减告警噪音,帮助运维团队主动预判并避免业务宕机事件。
日志过滤与抑制技术
-
过滤操作:在数据被索引前移除不需要的无效数据。
-
抑制操作:阻止特定事件触发告警,或禁止其出现在搜索结果中。
- 🚩重点:两类技术可同时实现性能优化、告警降噪、敏感信息保护三大核心目标。
DNS日志过滤实战案例
-
原始场景:未经过滤的DNS日志共包含234条独立查询,无明显可疑恶意活动。
-
过滤规则:移除授权厂商产品、本地域名、CDN相关的查询结果。
-
实战效果:大幅缩减结果数量,快速识别异常社交媒体访问、可疑域名、未授权软件(如案例中的Acronis)等风险行为。
IT与业务KPI对齐的价值
-
核心痛点:CIO普遍面临的难题是将技术产出转化为董事会可理解的语言,清晰展示IT投入带来的实际业务价值。
-
KPI的定义:用于衡量IT服务对业务目标支撑效果的可量化指标。
- 🚩重点:缺乏团队共识的统一管理方法,KPI管理极易陷入混乱、失效的状态。
Splunk KPI可视化落地方法
-
仪表盘能力:通过直观的可视化呈现,让组织内所有角色都能轻松理解复杂数据,实时追踪目标达成进度。
-
核心价值:打通IT性能与业务结果的关联,让高管、IT团队、网络运营中心(NOC)都能直观看到IT服务的实际业务影响。
Splunk Intelligent Incident Management 产品介绍
-
产品定位:基于AIOps理念的智能事件管理系统。
-
核心能力:依托机器学习与自动化技术,通过告警关联、自动响应、问题精准路由至对应值班团队,全面提升事件响应的速度与效率。
-
落地收益:减少业务宕机时长,提升服务可靠性,强化整体安全防护体系。
Splunk ITSI 产品详解
-
产品定位:面向IT服务性能监控与优化的AIOps解决方案。
-
核心能力:提供端到端的关键服务健康度与性能可视性,依托机器学习与预测分析技术,在问题影响业务前提前识别潜在风险。
-
健康度评估机制:以KPI作为服务健康度评估的基础,支持一键查看任意服务的运行状态,可配置KPI变动、服务健康分下降的触发告警,让运维团队提前处置潜在风险。
-
跨生态适配能力:同时覆盖传统遗留系统与现代数字生态,保障全场景下的服务性能最优。
- 🚩重点:ITSI的业务-技术关联落地分为两步完成,最终实现业务指标(电商运营数据)、客服等待时长、用户反馈量、应用性能数据的联动分析。
AIOps方案最终收益总结
-
告警降噪直接带来告警疲劳度降低、响应速度提升、IT运维效率增长、问题处置模式从被动转为主动的多重收益。
-
IT与业务KPI对齐后,可实现决策提速、资源优化配置、高管支持度提升,最终驱动整体业务价值增长。
🖍️ 重点速览
🚩 考点重点
-
异常检测技术演进:传统异常检测依赖大量人工,AI与机器学习技术大幅提升了其易用性与场景适配能力。
-
事件关联技术价值:关联多源日志生成统一视图,是主动预防业务宕机的核心手段。
-
过滤与抑制的区别:过滤是索引前移除无效数据,抑制是阻止特定事件触发告警,二者功能边界不能混淆。
-
KPI管理核心前提:缺乏团队共识的统一方法,KPI管理必然陷入混乱失效。
-
ITSI落地要求:业务与技术性能的关联落地必须分为两步完成,无法一步实现。
💡 核心概念
-
异常:数据或模式显著偏离既定假设、预设阈值的情况。
-
告警疲劳:用户因接收过量告警而脱敏,进而无法正确响应重要预警的现象。
-
事件关联:识别多条独立日志条目之间潜在关联关系的AIOps核心技术。
-
Splunk ITSI:面向IT服务性能监控与优化的AIOps解决方案,依托机器学习实现服务健康度评估与风险预判。
✨ 课堂金句
-
"Without a focused strategy, alert fatigue can weaken even the strongest security defenses."
-
"Reducing alert noise results in less alert fatigue, faster response times, greater IT efficiency and a more proactive approach to problem solving."
-
"Linking IT metrics to business KPIs makes it easy for executives, IT teams and NOC to see the real impact."
📝 实验事项
-
技术实践:在Splunk环境中配置DNS日志过滤规则,完成无效噪音数据的清理实操。
-
方案设计:结合企业现有VPN服务,基于课程讲解的异常检测逻辑,设计一套VPN可疑登录识别规则。
-
落地规划:梳理当前团队KPI管理的现存问题,对齐团队共识,搭建基于Splunk仪表盘的IT-业务KPI可视化体系。
-
产品学习:深入学习Splunk ITSI的服务健康度配置方法,完成至少1项核心业务服务的健康度监控配置。
🎯 课程总结
🔍 AIOps与机器学习概述
-
AIOps定义:基于机器学习的智能运维,核心是将传统被动式IT运维转变为主动式洞察("The Intelligent Engine: Transforming Reactive IT with Machine Learning")。
-
核心价值:解决传统IT运维的"数据噪音淹没信号"问题,通过ML技术从海量告警和日志中提取关键信息,实现故障的自动检测、关联分析与根因定位。
-
典型场景:IT团队面临告警风暴("I'm drowning in noise!")、跨系统数据孤岛、静态阈值误报等挑战,AIOps通过统一视图和动态基线解决这些问题。
📊 传统运维 vs AIOps对比
| 挑战类型 | 传统运维痛点 | AIOps解决方案 |
|---|---|---|
| 告警处理 | 告警过载(数百条无关告警),无法区分重要性 | ML自动关联事件、过滤噪音、优先级排序 |
| 数据整合 | 工具分散,数据孤岛,人工关联效率低 | 多源数据同时分析,发现隐藏模式和关联性 |
| 异常检测 | 静态阈值无法捕捉细微或间歇性问题 | 动态基线学习,识别正常行为偏差,即使低于静态阈值 |
| 根因分析 | 人工连接跨工具事件耗时,难以定位根本原因 | 聚类和关联算法自动分组相关事件,推荐潜在根因 |
🧠 机器学习核心概念
-
定义:通过示例进行泛化的过程,生成模型用于预测、分类、模式识别和异常检测等任务。
-
三大学习范式:
-
监督学习:基于标记数据训练模型,预测已知类别。AIOps应用包括服务器故障预测(标记"故障"/"正常")、告警分类(" critical"/"warning")、资源利用率预测。示例:用历史CPU数据训练模型预测服务器宕机。
-
无监督学习:无标记数据,自动发现数据结构。AIOps应用包括错误日志聚类(识别共同根因)、无先验异常的系统行为检测。示例:分析网络流量识别异常活动集群。
-
强化学习:通过与环境交互学习最优策略,AIOps中用于实时决策和技能获取。
-
⚙️ AIOps中的机器学习技术
| 技术类型 | 原理 | AIOps应用场景 | 核心算法 |
|---|---|---|---|
| 分类(Classification) | 将数据归入预定义类别 | 事件类型分类(安全/性能/可用性),自动路由至对应团队 | 逻辑回归、决策树、SVM、K-NN、随机森林 |
| 回归(Regression) | 预测连续值,建模变量间关系 | 服务器CPU利用率预测、支持工单量 forecasting | 线性回归、多项式回归、SVM、K-NN、随机森林 |
| 聚类(Clustering) | 相似数据点分组,发现隐藏关系 | 错误日志聚类识别根因,网络流量模式分组 | K-Means |
| 异常检测(Anomaly Detection) | 识别偏离正常模式的数据点 | 异常网络流量、登录尝试、性能退化检测 | Isolation Forest、One-Class SVM |
📈 ML在AIOps全生命周期中的应用
-
数据摄入(Ingestion):训练模型自动标记数据源类型和解析日志。
-
检测(Detection):学习正常模式以早期发现异常。
-
关联(Correlation):聚类事件减少噪音,凸显根因问题。
-
预测(Prediction):在用户受影响前预测问题。
-
自动化(Automation):基于历史结果推荐或触发响应动作。
🛠️ Splunk机器学习工具链
-
Splunk MLTK(Machine Learning Toolkit):
-
功能:提供30+标准算法(回归/分类/聚类/异常检测)、SPL命令(
fit,apply,score)、模型生命周期管理。 -
优势:用户友好的引导式工作流,支持Python科学计算库(pandas, NumPy, scikit-learn)进行自定义开发。
-
-
Splunk DSDL(Data Science and Deep Learning App):
-
定位:面向高级用户,集成深度学习框架(PyTorch, TensorFlow)和数据科学工具(Jupyter Lab, TensorBoard)。
-
特点:支持GPU加速、容器化部署,适合复杂自定义模型开发。
-
⚖️ 机器学习在AIOps中的优缺点
-
优势:
-
动态基线:适应系统变化,减少误报。
-
主动洞察:问题发生前预测,支持早期干预。
-
自动化运维:简化分诊、修复等常规任务。
-
噪音 reduction:关联事件,突出关键问题。
-
模式识别:发现人类分析遗漏的复杂模式。
-
可扩展性:处理超人类能力的海量数据。
-
-
局限性:
-
数据质量依赖:"垃圾进,垃圾出",低质量数据导致模型失效。
-
可解释性挑战:复杂模型可能成为"黑箱",决策难以理解。
-
持续监控需求:模型会"漂移",需定期重新训练。
-
计算资源密集:训练和运行模型消耗大量资源。
-
误报/漏报:需调优平衡,没有完美模型。
-
领域专家仍需:ML增强而非替代人类IT专业知识。
-
🌐 高级ML能力与负责任AI
-
高级ML技术:包括深度学习、集成方法等,处理大规模复杂IT数据。
-
负责任AI原则:确保模型公平性、透明度、鲁棒性和安全性,包括偏差检测、模型可解释性、伦理部署和持续监控。
-
模型可靠性:通过验证、监控、再训练和漂移检测维持生产环境中AI系统的性能和可信度。
📌 关键实践要点
-
SPL(Search Processing Language):用于探索结构化数据中的趋势和关系。
-
特征工程:可视化特征随时间的行为,识别影响建模的缺口、峰值或异常模式。
-
真实案例:某全球SaaS公司通过监督学习模型(6个月历史数据)预测CPU高使用率与服务工单峰值的关联,实现资源提前扩容。