大家好,欢迎来到 huangjin007_ 的博客
⭐ 个人主页:huangjin007_
🔥 文章收录专栏:Linux 内功修炼手册(系统篇)
总会有一些坚持
能从冰封的土地里
培育出十万朵怒放的蔷薇
Linux 系统篇(二十) ------ 进程创建、进程退出
文章目录
- [Linux 系统篇(二十) ------ 进程创建、进程退出](#Linux 系统篇(二十) —— 进程创建、进程退出)
- 一、进程创建
-
- [1.1 fork 函数初识](#1.1 fork 函数初识)
-
- [1.1.1 为什么 fork 这么重要?](#1.1.1 为什么 fork 这么重要?)
- [1.1.2 fork 之后内核做了什么?](#1.1.2 fork 之后内核做了什么?)
- [1.1.3 三个经典问题](#1.1.3 三个经典问题)
-
- [问题 1:为什么要给子进程返回 0,父进程返回子进程 pid?](#问题 1:为什么要给子进程返回 0,父进程返回子进程 pid?)
- [问题 2:为什么一个函数 fork 会有两个返回值?](#问题 2:为什么一个函数 fork 会有两个返回值?)
- [问题 3:为什么一个 id 既等于 0,又大于 0?](#问题 3:为什么一个 id 既等于 0,又大于 0?)
- [1.2 fork 函数返回值总结](#1.2 fork 函数返回值总结)
- [1.3 写时拷贝](#1.3 写时拷贝)
-
- [1.3.1 写时拷贝是如何实现的?](#1.3.1 写时拷贝是如何实现的?)
- [1.3.2 为什么操作系统会发生写时拷贝?](#1.3.2 为什么操作系统会发生写时拷贝?)
- [1.3.3 为什么操作系统能够分辨出谁是数据段?](#1.3.3 为什么操作系统能够分辨出谁是数据段?)
- [1.3.4 查询页表的几种情况](#1.3.4 查询页表的几种情况)
- [1.3.5 为什么要写时拷贝?](#1.3.5 为什么要写时拷贝?)
- [1.3.6 读写权限的恢复注意事项](#1.3.6 读写权限的恢复注意事项)
- [1.4 fork 常规用法](#1.4 fork 常规用法)
- [1.5 fork 调用失败的原因](#1.5 fork 调用失败的原因)
- 二、进程终止
-
- [2.1 进程退出场景](#2.1 进程退出场景)
- [2.2 进程常见退出方法](#2.2 进程常见退出方法)
- [2.3 退出码](#2.3 退出码)
-
- [2.3.1 什么是退出码?](#2.3.1 什么是退出码?)
- [2.3.2 Linux Shell 常见退出码](#2.3.2 Linux Shell 常见退出码)
- [2.4 return 机制与返回值编码原理](#2.4 return 机制与返回值编码原理)
- [2.5 _exit 函数](#2.5 _exit 函数)
- [2.6 exit 函数](#2.6 exit 函数)
- [2.7 exit 与 _exit 的经典对比](#2.7 exit 与 _exit 的经典对比)
-
- [使用 exit](#使用 exit)
- [使用 _exit](#使用 _exit)
- [2.8 return 退出](#2.8 return 退出)
- [2.9 深度解剖:我们谈论的缓冲区](#2.9 深度解剖:我们谈论的缓冲区)
- [2.10 退出码的回收与访问](#2.10 退出码的回收与访问)
-
- [2.10.1 子进程退出码获取](#2.10.1 子进程退出码获取)
- [2.10.2 父进程如何查看?](#2.10.2 父进程如何查看?)
- [2.10.3 status 只有低 8 位有效](#2.10.3 status 只有低 8 位有效)
- [2.10.4 errno 与 strerror](#2.10.4 errno 与 strerror)
- 结语:
一、进程创建
1.1 fork 函数初识
在 Linux 中,fork 是非常重要的系统调用。它的作用是:从已经存在的进程中创建一个新进程。
- 原来的进程叫父进程。
- 新产生的进程叫子进程。
函数原型:
c
#include <unistd.h>

pid_t fork(void);
返回值:
- 子进程中返回
0- 父进程中返回子进程的 pid
- 出错返回
-1
也就是说,fork 这个函数"看起来"有三个返回值范围:
text
子进程:0
父进程:> 0,具体是子进程 pid
出错:-1
1.1.1 为什么 fork 这么重要?
因为 Linux 中很多进程都不是凭空出现的,而是从已有进程"分叉"出来的。
比如你在终端里执行一个命令:
bash
ls bash 通常会先 fork 出一个子进程,然后子进程调用 exec 去执行 ls。
再比如服务器程序:
- 父进程一直等待客户端请求。
- 每来一个请求,父进程
fork一个子进程去处理。- 父进程继续等待下一个请求。
所以 fork 是并发服务器、Shell 执行命令、守护进程等机制的基础。
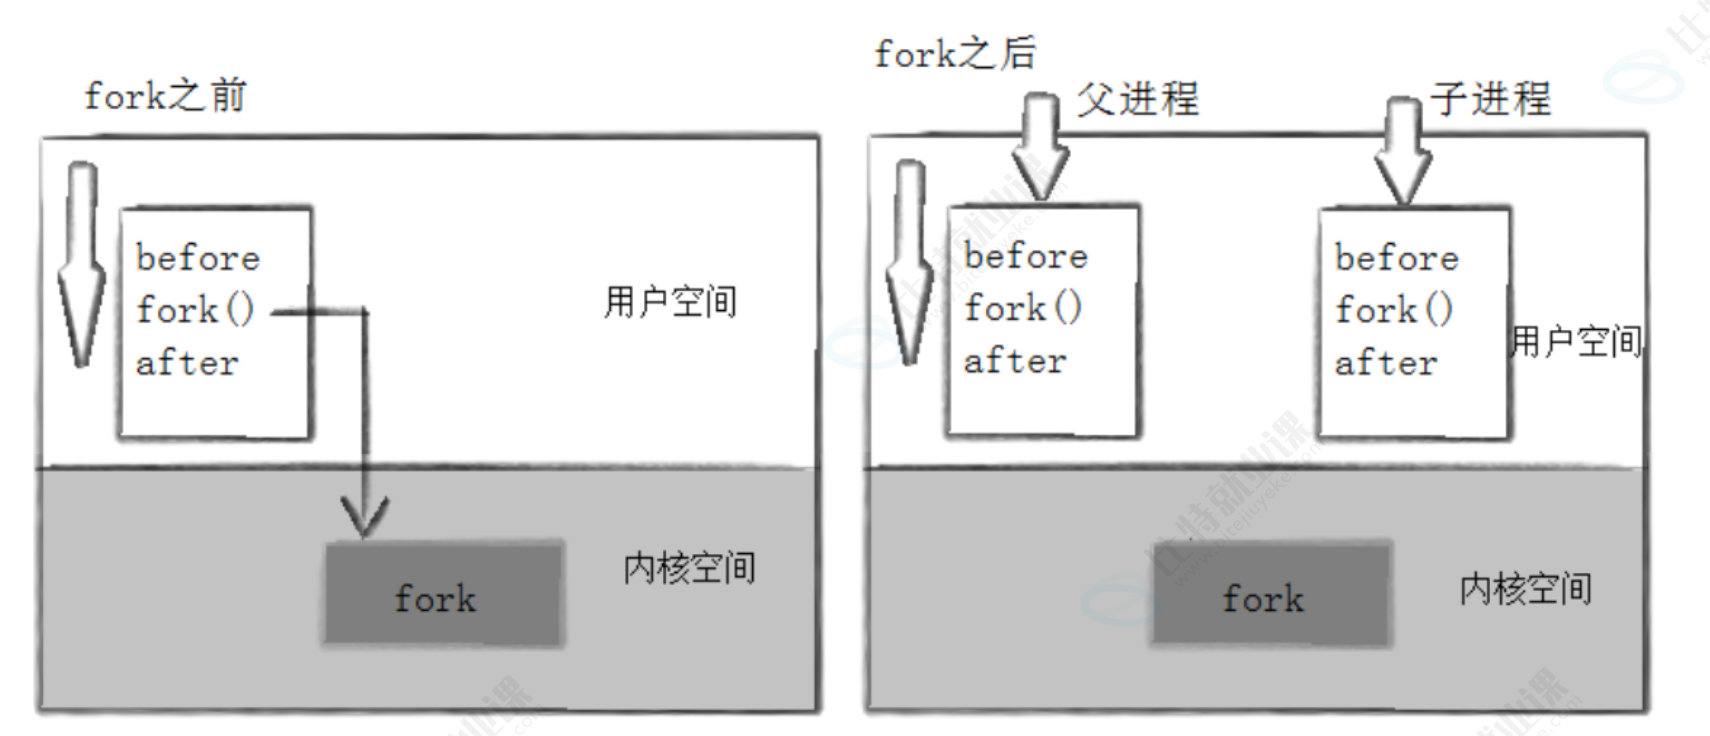
1.1.2 fork 之后内核做了什么?
当用户程序调用 fork 后,控制权会从用户态进入内核态。内核大致做这些事情:
-
分配新的内存块和内核数据结构给子进程
- 例如创建子进程的
task_struct,也就是进程控制块 PCB。 - 分配一些内核管理进程所需的结构。
- 例如创建子进程的
-
将父进程部分数据结构内容拷贝至子进程
- 注意是"部分",不是所有东西都无脑复制。
- 比如文件描述符表、信号处理相关信息等会继承或部分共享。
-
添加子进程到系统进程列表当中
- 这样调度器才能看到这个新进程。
-
fork 返回,开始调度器调度
- 此时父子两个进程都从
fork调用处返回。 - 谁先执行,由调度器决定,不确定。
- 此时父子两个进程都从
1.1.3 三个经典问题
问题 1:为什么要给子进程返回 0,父进程返回子进程 pid?
因为父子进程需要不同的信息来完成不同的事情。
- 父进程需要知道子进程的 pid,才能管理子进程,比如
waitpid等待它、给它发信号等。- 子进程不需要通过
fork返回值知道自己的 pid,因为子进程可以调用getpid()获取自己的 pid,也可以调用getppid()获取父进程 pid。- 所以给子进程返回
0,是把它作为"我是子进程"的标志。0不是有效的进程 pid,因此可以和父进程返回值区分开。
问题 2:为什么一个函数 fork 会有两个返回值?
并不是 C 语言函数真的能返回两次。
而是 fork 进入内核后,内核复制出了一个新的进程。等内核返回用户态时:
- 父进程从
fork返回一次。- 子进程也从
fork返回一次。
所以从用户角度看,好像 fork 有两个返回值。实际上是两个执行流各自从 fork 返回。
问题 3:为什么一个 id 既等于 0,又大于 0?
因为 pid 这个变量在父子进程里是各自独立的。
c
pid_t pid = fork();
- 在父进程中,
pid被赋值为子进程 pid,所以pid > 0。- 在子进程中,
pid被赋值为0,所以pid == 0。
虽然变量名一样,但父子进程有各自的地址空间和栈,变量是两份,互不影响。
1.2 fork 函数返回值总结
| 进程 | fork 返回值 | 含义 |
|---|---|---|
| 子进程 | 0 |
表示这是子进程 |
| 父进程 | > 0 |
返回子进程 pid |
| 出错 | -1 |
创建失败,设置 errno |
代码里常见写法:
c
pid_t pid = fork();

if (pid < 0) {
    perror("fork");
    exit(1);
} else if (pid == 0) {
    // 子进程代码
} else {
    // 父进程代码
}
1.3 写时拷贝
fork 刚创建子进程时,如果直接把父进程所有物理内存都复制一遍,会非常慢,也非常浪费内存。
所以 Linux 使用了写时拷贝技术。
一句话理解:
父子进程先共享同一份物理内存,谁要写,谁就复制一份自己的副本。
类比两个人共`用一本笔记:
- 只读的时候,一起看同一本。
- 一旦有人要修改,就自己复印一本,之后改自己的复印件。
1.3.1 写时拷贝是如何实现的?
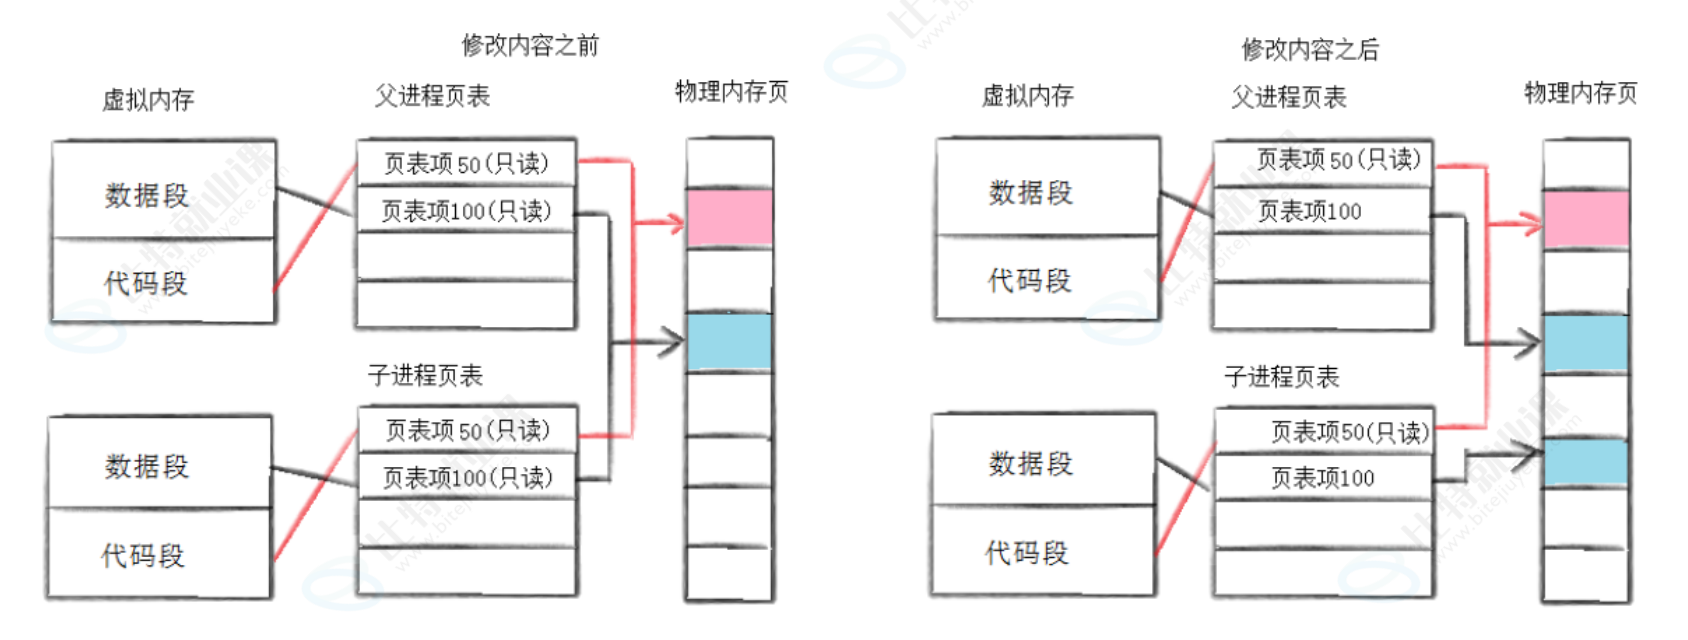
初始时:
- 子进程被创建后,父子进程的页表指向相同的物理内存页。
- 操作系统会把父子进程的数据段页表项设置为只读。
- 代码段本来通常就是只读的。
- 父进程的数据段页表项也会被同步设置为只读。
当任意一方尝试写入这些共享数据时:
-
触发保护异常
- 因为页表项是只读的,硬件 MMU 发现你居然要写,于是拦截。
- 这个"报错"不是程序真的非法越界,而是操作系统故意设置的陷阱。
-
进入缺页中断处理
- 操作系统捕获这个异常。
- 它会检查这个地址是否合法,是否属于写时拷贝。
-
识别并触发写时拷贝
- 内核发现:这是合法的写操作,只是当前页面被共享了。
- 于是分配一个新的物理页。
- 把旧页内容拷贝到新页。
- 修改当前进程的页表,让它指向新物理页。
- 把该页表项权限恢复为可读写。
-
继续执行写操作
- 当前进程这次写操作就能成功了。
- 另一个进程仍然指向原来的物理页,不受影响。
这样父子进程就实现了逻辑上的完全独立。
1.3.2 为什么操作系统会发生写时拷贝?
因为操作系统对进程的虚拟内存区域有特殊控制机制。
进程的虚拟内存不是一整块,而是被划分成很多区域,比如:
- 代码段
- 数据段
- 堆
- 栈
- 共享库映射区
这些区域在内核里由 vm_area_struct 描述。
当发生写保护异常时,内核会查看对应的 vm_area_struct,判断这个区域原本是否允许读写。如果发现它本来是可写的,只是被临时设置成只读用于写时拷贝,那么内核就知道:这不是非法访问,而是写时拷贝。
1.3.3 为什么操作系统能够分辨出谁是数据段?
答案是:vm_area_struct。
vm_area_struct 是 Linux 内核中描述虚拟内存区域的结构体。它记录了:
- 这个区域的起始地址和结束地址
- 这个区域的权限,比如读、写、执行
- 这个区域对应的文件信息等
所以内核通过检查 vm_area_struct,可以知道:
- 这个地址属于哪个区域?
- 这个区域原本是否可写?
- 当前异常是写时拷贝引起的,还是非法内存越界?
因此,写时拷贝不会把非法访问误判成合法访问。
1.3.4 查询页表的几种情况
进程访问虚拟地址时,CPU 会查页表。常见情况有三种:
- 正常查询
- 页表项存在。
- 权限匹配。
- 直接完成虚拟地址到物理地址的转换。
- 查不到 / 报错
- 页表项不存在。
- 或者权限不匹配。
- 比如用户态访问内核地址,或者写只读页面。
- 缺页中断
- 页表项不存在,但地址合法。
- 或者权限不匹配,但属于写时拷贝。
- 此时触发缺页中断,由内核处理:
申请物理内存
拷贝物理页
重映射页表
恢复权限
重新执行触发异常的指令
写时拷贝就是典型的"权限不匹配但合法"的缺页中断。
1.3.5 为什么要写时拷贝?
主要有两个原因:
1. 加速子进程创建速度
如果 fork 时直接复制父进程全部物理内存,那么创建子进程会非常慢。写时拷贝把复制推迟到真正写入时,避免了创建初期盲目拷贝大量物理内存。
2. 减少内存中的冗余代码与数据
很多子进程创建后可能只读父进程数据,如果一开始就全量复制,很多复制都是浪费。写时拷贝只有在需要修改时才分配新内存,极大地节省物理内存。
1.3.6 读写权限的恢复注意事项
写时拷贝发生后:
- 子进程:如果子进程写了某一页,子进程会得到新物理页,它的该页表项权限立即恢复为读写。
- 父进程:父进程原有的数据段并不会马上变回读写。它可能仍然指向原来的物理页,并且页表项仍然是只读的。只有当父进程自己也写这一页时,才会触发父进程的写时拷贝,然后父进程的页表项才恢复读写。
- 从引用计数角度看,当所有子进程都发生了写时拷贝,彻底脱离共享物理页后,原来的物理页可能只剩父进程使用,内核可以根据情况恢复其写权限。但无论如何,父子进程在物理层面上已经充分隔离,完成了进程独立性的保证。
1.4 fork 常规用法
1. 父进程复制自己,父子执行不同代码段
例如服务器:
- 父进程等待客户端请求。
- 请求到来后,父进程
fork子进程。- 子进程处理请求。
- 父进程继续等待下一个请求。
伪代码:
c
while (1) {
    int connfd = accept(...);
    pid_t pid = fork();
    if (pid == 0) {
        // 子进程处理请求
        handle_request(connfd);
        exit(0);
    }
    // 父进程继续循环
    close(connfd);
}
2. 子进程执行一个完全不同的程序
子进程从 fork 返回后,可以调用 exec 族函数(之后的文章中会讲),加载并替换当前进程空间。
例如 Shell 执行命令:
c
pid_t pid = fork();
if (pid == 0) {
    execlp("ls", "ls", "-l", NULL);
    exit(1);
} else {
    wait(NULL);
}
1.5 fork 调用失败的原因
fork 不是一定成功。失败原因主要有:
- 系统中有太多进程
- 超过了系统允许的进程最大上限。
- 实际用户的进程数超过了限制
- 每个用户可能有进程数配额。
- 内存空间不够
- 直接导致:
进程 PCB,也就是task_struct创建失败。
无法成功加载代码与数据。
失败时 fork 返回 -1,并设置 errno。
二、进程终止
2.1 进程退出场景
进程退出通常分三大类:
-
代码运行完毕,结果正确
- 正常退出。
- 通常退出码为
0。
-
代码运行完毕,结果不正确
- 程序没有崩溃,安全运行到结束。
- 但结果不符合预期。
- 通常返回非 0 退出码,比如
1, 2, 3...。 - 不同的值可以表示不同的出错原因。
-
代码异常终止
- 程序运行过程中触发致命错误,比如野指针、除以 0。
- 或者收到信号被强制杀死。
- 这种情况下,代码根本没有执行完,退出码已经没有意义。
main 函数的返回值和程序执行情况挂钩,它就是进程退出时的退出码。
返回值返回给谁?
- 子进程的退出码返回给父进程。
main函数的返回值返回给调用main的运行时函数,最终也会变成进程退出码。
2.2 进程常见退出方法
正常终止:
- 从
main返回,也就是return。- 调用
exit。- 调用
_exit。
异常退出:
ctrl + c,发送SIGINT信号。kill -9 进程pid,发送SIGKILL信号。- 其他信号终止。
2.3 退出码
2.3.1 什么是退出码?
退出码也叫退出状态。它告诉我们最后一次执行的命令是成功还是失败。
基本规则:
0:成功。- 非
0:失败,或者被信号终止。
在 Shell 中可以用:
bash
echo $?查看上一个前台进程的退出码。
2.3.2 Linux Shell 常见退出码
| 退出码 | 解释 |
|---|---|
| 0 | 命令成功执行 |
| 1 | 通用错误代码 |
| 2 | 命令或参数使用不当 |
| 126 | 权限被拒绝,或无法执行 |
| 127 | 未找到命令,或 PATH 错误 |
| 128+n | 命令被信号从外部终止,或遇到致命错误 |
| 130 | 通过 Ctrl+C 或 SIGINT 终止,128+2 |
| 143 | 通过 SIGTERM 终止,128+15 |
| 255 | 退出码超过 0-255 范围,重新计算,通常是对 256 取模 |
说明:
130是128 + 2,因为SIGINT信号编号是 2。143是128 + 15,因为SIGTERM信号编号是 15。255常见于_exit(-1),因为-1的低 8 位是255。
可以使用 strerror 函数获取错误码对应的描述。
2.4 return 机制与返回值编码原理
在语言层面,main 函数的返回值通常表明程序执行情况。
但返回值是怎么从函数传给父进程的?
从汇编角度看,函数调用和返回值传递大致有三步:
func1调用func2
- 执行
call func2。
func2把返回值放到寄存器
- 比如
mov eax, 1- 然后
ret返回。
func1从寄存器接收返回值
- 比如把
eax中的值移动到自己的变量中。
所以函数的返回值本质上是放在寄存器里的。
补充:关于默认返回值。
如果函数声明为 int func(),但没有写 return,有些编译器会警告。由于底层没有显式写 eax,eax 可能保留之前的值。但在很多情况下,默认会表现为返回 0。main 函数也遵循类似机制。
C 语言里默认函数返回值类型是 int,所以以 int 为返回值的函数,实际上不写返回值有时也能编译,但不建议这样做。
main 的返回值会被启动例程,比如 __libc_start_main,当作 exit 的参数,最终变成进程退出码。
2.5 _exit 函数
c
#include <unistd.h>

void _exit(int status);
参数:
status定义了进程的终止状态。- 父进程通过
wait来获取这个值。
说明:
- 虽然
status是int,但只有低 8 位可以被父进程使用。- 所以
_exit(-1)时,在终端执行echo $?,会发现返回值是255。
_exit 是系统调用,它会直接终止进程,不会做 C 标准库的清理工作。
2.6 exit 函数
c
#include <stdlib.h>

void exit(int status);
exit 最后也会调用 _exit,但在调用 _exit 之前,它还做了其他工作:
- 执行用户通过
atexit或on_exit定义的清理函数。- 关闭所有打开的流,所有的缓存数据均被写入。
- 调用
_exit。
所以:
text
exit = 库清理 + 刷新缓冲区 + _exit2.7 exit 与 _exit 的经典对比
看两个程序。
使用 exit
c
#include <stdio.h>
#include <stdlib.h>

int main()
{
    printf("hello");
    exit(0);
}
运行结果:
text
[root@localhost linux]# ./a.out
hello[root@localhost linux]#
输出了 hello。
使用 _exit
c
#include <stdio.h>
#include <unistd.h>

int main()
{
    printf("hello");
    _exit(0);
}
运行结果:
text
[root@localhost linux]# ./a.out
[root@localhost linux]#
没有输出 hello。
为什么?
因为 printf("hello") 没有换行,数据先放在 C 标准库的缓冲区里。exit 会刷新缓冲区 ,把 hello 写到终端;_exit 不会刷新缓冲区 ,所以数据丢失。
2.8 return 退出
return 是一种更常见的退出进程方法,执行 return n 等同于执行 exit(n)。因为调用 main 的运行时函数会把 main 的返回值当作 exit 的参数。
所以:
c
int main()
{
    return 0;
}
等价于:
c
int main()
{
    exit(0);
}
2.9 深度解剖:我们谈论的缓冲区
从 exit 和 _exit 的区别,可以得出一个非常重要的结论:
这个缓冲区一定不是操作系统内部的缓冲区!
为什么?
如果这个缓冲区是操作系统内核内部的,那么无论是 exit 还是 _exit,只要进程退出,操作系统都应该统一刷新内核缓冲区。
但事实是:_exit 作为系统调用,根本不理会这个缓冲区。
这说明:
exit是 C 库函数。exit内部封装了_exit。- 在调用
_exit之前,exit额外做了刷新库缓冲区的动作。- 那个缓冲区是 C 标准库提供的缓冲区 ,通常和
FILE结构相关。
2.10 退出码的回收与访问
2.10.1 子进程退出码获取
当进程退出后,退出码会被写入子进程的 task_struct 内部。内核进程控制块中有专门的变量保存退出码。
子进程退出后会进入僵尸状态,直到父进程回收它,并获取这个退出码。
2.10.2 父进程如何查看?
日常开发中,父进程通常是 bash。
当我们运行:
bash
./proc 它作为 bash 的子进程运行。
如果想查看它最后的执行结果:
bash
echo $? $? 是 Shell 的特殊变量,专门存储上一个前台进程退出时的状态码。
例如:
bash
[whb@bite-alicloud lesson16]$ ./proc
[whb@bite-alicloud lesson16]$ echo $?
1
说明 ./proc 返回了 1,表示失败。
2.10.3 status 只有低 8 位有效
虽然 status 是 int,但父进程实际能拿到的通常只有低 8 位。
所以:
c
_exit(-1); 在终端执行 echo $? 会看到 255。
因为 -1 的二进制低 8 位是 11111111,也就是 255。
2.10.4 errno 与 strerror
errno 是 C 标准库提供的一个全局变量,定义在 <errno.h> 中。你可以把它当成错误码。
例如:
c
#include <errno.h>

int Func02()
{
    FILE* fp = fopen("log.txt", "r");
    if (fp == NULL)
        return errno;
    fclose(fp);
    return 0;
}
strerror 可以把错误码转化为描述信息:
c
#include <string.h>

char *strerror(int errnum);
示例:
c
#include <cstdio>
#include <string.h>

void Func01()
{
    for (int i = 0; i < 133; i++)
        printf("%d -> %s\n", i, strerror(i));
}

int main()
{
    Func01();
    return 0;
}
这样可以看到各种错误码对应的错误描述。
注意:errno 不是进程退出码,它只是库层面的错误码。退出码是给父进程看的,errno 是给当前程序判断错误原因用的。
结语:
今天的内容到这里就结束了,希望你能有所收获~
干货整理到手抖,觉得有用的话,赏个三连回回血?__(:ᗤ」ㄥ)_ _