【数据结构】队列
概览
- 队列的定义与先进先出
- 循环队列与下标取模
- 队空和队满的三种区分办法
- 有效长度公式的推导
- 队列在系统里的四处应用
- 实测数据与边界值
核心知识
一、队列是什么
队列也是线性表,和栈一样,它对操作的位置做了限制,只是限制的方向相反。栈把操作都收在一端,队列把两端分开:插入只在队尾进行,删除只在队头进行。先进入队列的元素先离开,这条规则叫先进先出(First In First Out,FIFO)。
拿食堂排队打饭来理解最直接:新来的人站在队尾,打饭的窗口在队头,打完一个走一个。没有人从中间插进去,也没有人从队尾离开。队列里的元素只沿着一个方向移动,从队尾进来,往队头挪,最后从队头出去。
这个限制看起来让队列的能力变弱了:不能随机访问,不能从中间插队,连看一眼中间的元素都不行。换来的是顺序上的确定性。一批任务的提交顺序就是执行顺序,谁都插不进来,也就不需要额外的规则去决定先做哪一个。栈的确定性体现在最近的那个,队列的确定性体现在最早的那个,两者都是把选择权从使用方手里拿走,交给一条固定规则。
术语概览:
| 术语 | 含义 |
|---|---|
| 入队 | 在队尾放一个元素,元素个数加一 |
| 出队 | 把队头元素拿走,元素个数减一 |
| 队头 | 只能出元素的那一端 |
| 队尾 | 只能入元素的那一端 |
| 队空 | 队列里一个元素都没有,这时不能出队,也不能取队头 |
| 队满 | 只在容量固定的队列里才有这个概念 |
把栈和队列摆在一起看,能发现它们的接口条数完全一样:初始化、销毁、插入、删除、取端点、判空、取个数。区别只在于插入和删除分别发生在哪一端,而这个区别决定了它们各自适合处理什么问题。一批数据需要按进入的顺序处理,用队列;需要把最近的先处理,用栈。
两种底层的代价对照。 队列的实现方式决定了它的能力边界,链表实现和数组实现各有短板:
| 对比项 | 链表实现 | 数组实现(循环队列) |
|---|---|---|
| 入队 | O(1),每次要申请一个结点 | O(1),容量满了只能报错 |
| 出队 | O(1),每次要释放一个结点 | O(1),下标加一取模 |
| 取队头、取队尾 | O(1) | O(1) |
| 取元素个数 | O(1),靠 size 成员 | O(1),靠 size 或长度公式 |
| 内存形态 | 每个元素一块独立内存,另有指针开销 | 一块连续内存,容量固定 |
| 容量上限 | 没有上限,受限于可用内存 | 初始化时定死,之后不能改 |
| 缓存友好度 | 差,结点分散在堆上 | 好,元素挨在一起 |
| 适合的场景 | 长度事先不知道,或者波动很大 | 长度可控,追求速度和内存利用率 |
这张表里没有一处是绝对的优劣。链表把容量的问题交给分配器,代价是每个元素都要单独申请和释放,缓存也不友好;数组把容量在初始化时就定下来,换来的是连续内存和零分配开销。选哪一种,取决于队列的长度能不能提前预估。
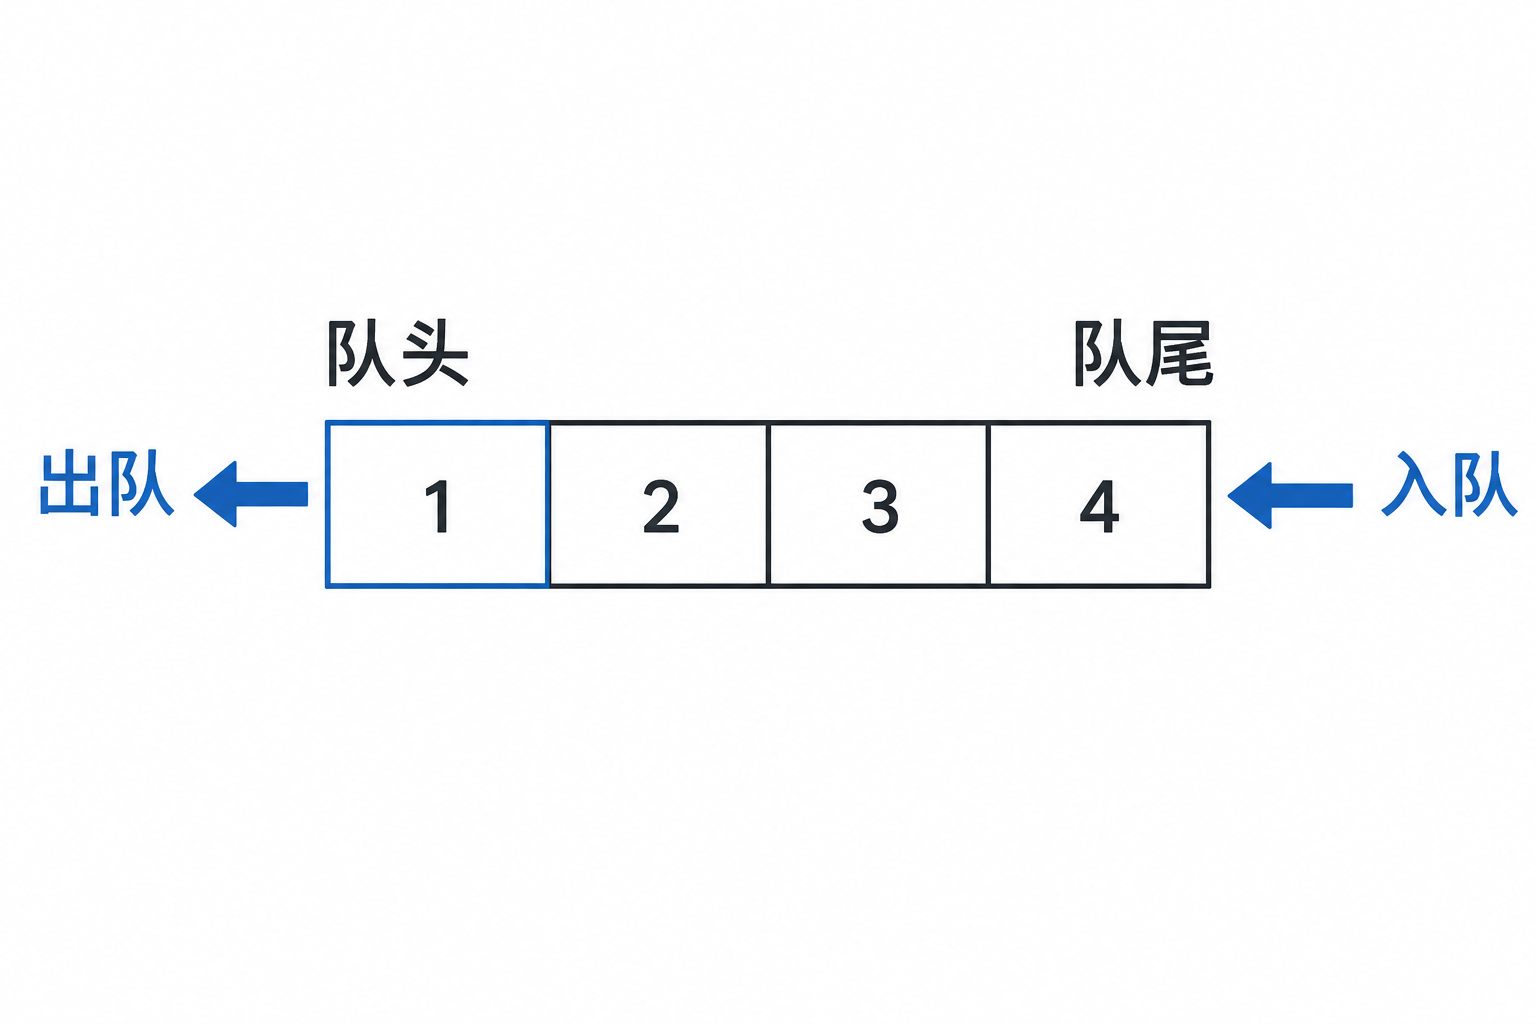
图 1 队列的两端分工
二、链表实现
队列的底层可以用数组,也可以用链表。链表实现更常见,原因在于队列的两端都要动,而单链表恰好能在这两个位置都做到 O(1),前提是多存一个尾指针。
只存头指针的单链做不到这一点。尾插要走到最后一个结点,那是 O(n),队列最常用的操作变成最慢的一个。多存一个尾指针之后,尾插是改两个指针的动作,头删本来也只是一个指针的动作,两端都落在常数时间上。
队列的结点和队列本体分开定义:
c
# 文件:/home/cocatrice/ds08/queue.h
typedef struct QNode
{
	QDataType data;
	struct QNode* next;
} QNode;

typedef struct Queue
{
	QNode* front;
	QNode* rear;
	int size;
} Queue;
三个成员各有分工。front 指向队头结点,出队从它下手;rear 指向队尾结点,入队挂在它后面;size 记录元素个数,让取个数的接口变成 O(1)。
size 这个成员可以有也可以没有。不记它,取个数就要从头到尾数一遍,是 O(n)。元素个数是使用方问得最多的一个值,用一个 int 把它记下来,代价是多四个字节,换来的是每次查询都是常数时间。
空队列要两个指针一起改。 队列为空时 front 和 rear 都是 NULL。出队把最后一个结点删掉之后,front 自然变成 NULL,rear 却还指着那块刚释放的内存,必须手动把它也置空。这一处漏掉,后面任何一次入队都会写到已经还给分配器的地址上。
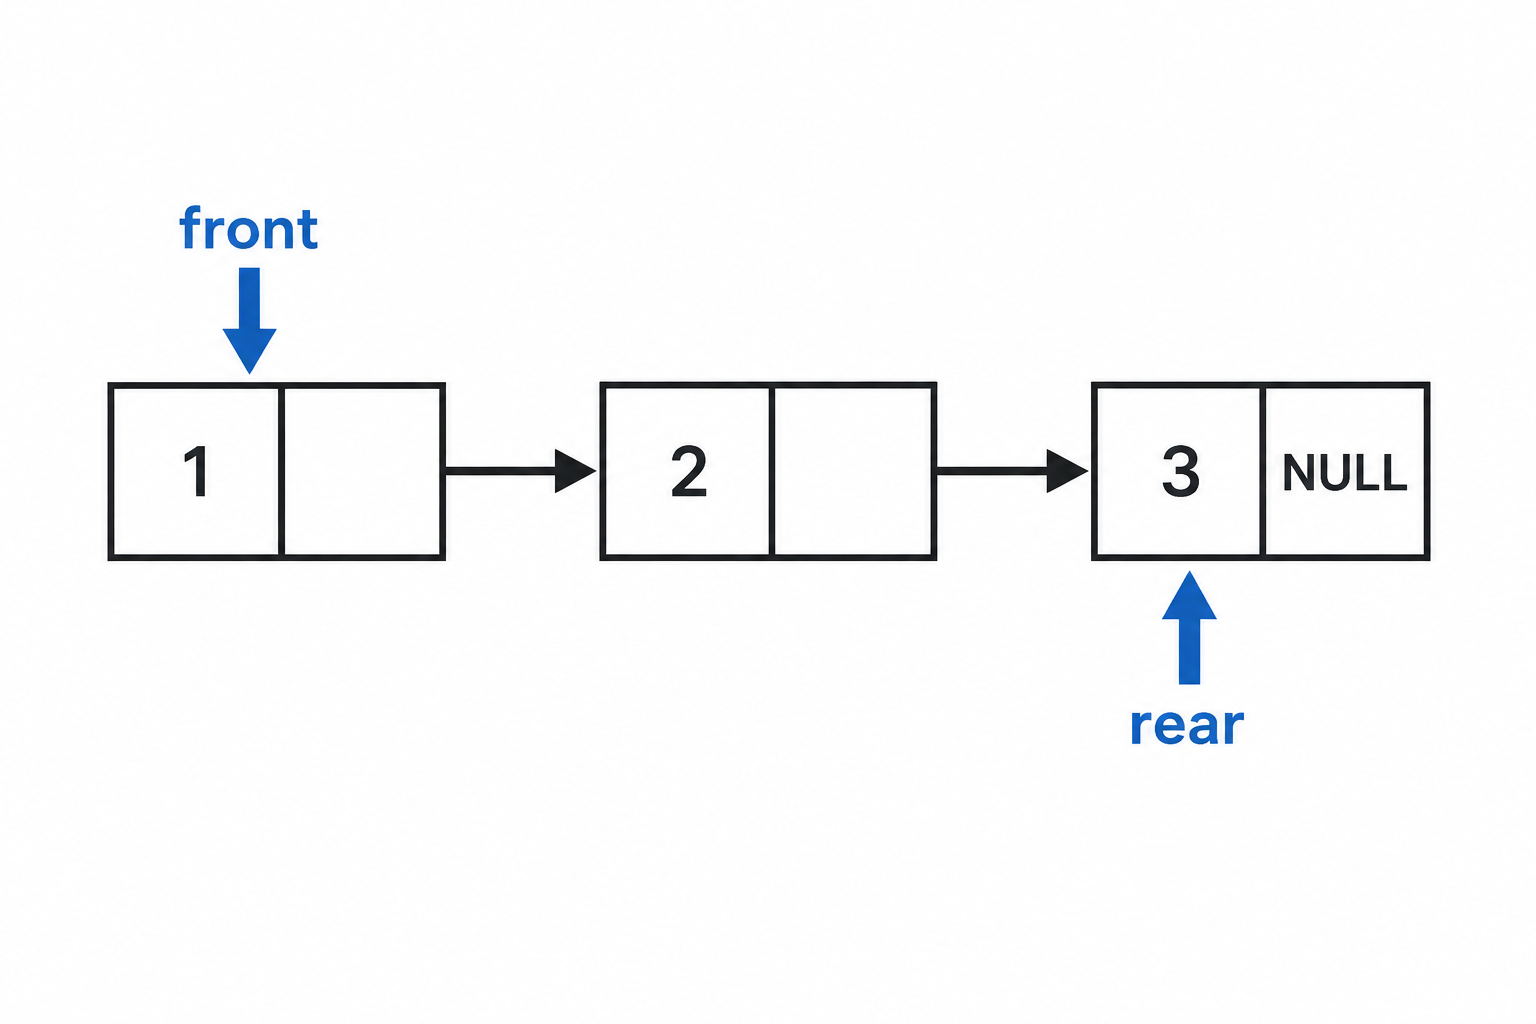
图 2 链式队列的两个指针
另一种写法是加一个头结点。 在链表最前面放一个不存数据的结点,让 front 和 rear 一开始都指向它,空队列的判断就变成 front == rear,入队出队的代码里不再需要单独处理空队列的分支。代价是多申请一个结点,并且取队头元素要写成 front->next->data。两种写法都对,选一种并保持全篇一致即可。
接口一共八个:
c
# 文件:/home/cocatrice/ds08/queue.h
void QueueInit(Queue* pq);
void QueueDestroy(Queue* pq);
void QueuePush(Queue* pq, QDataType x);
void QueuePop(Queue* pq);
QDataType QueueFront(Queue* pq);
QDataType QueueBack(Queue* pq);
int QueueSize(Queue* pq);
bool QueueEmpty(Queue* pq);
初始化和销毁负责生命周期,入队和出队是仅有的两个修改操作,取队头和取队尾只看不改,取个数和判空是查询。八个接口逐个过一遍,每一处都有需要拿捏的地方。
初始化和销毁管生命周期。 初始化把两个指针置空、计数清零。这一步不能省,声明在栈上的队列结构体里是一堆随机值,直接入队等于沿着野指针走。销毁沿着 next 一路释放,每一轮先把下一个结点的地址存进局部变量,再释放当前结点,顺序颠倒就取不到下一个地址了。
入队和出队是仅有的两个修改动作。 入队要处理两种情形:队列为空时新结点既是队头也是队尾,两个指针都要指向它;队列非空时新结点挂在 rear 后面,再把 rear 推到新结点上。出队只需要动队头,取走队头的数据、记住下一个结点、释放当前结点、让 front 前进一步,最后判断队列是否已经空了,空了要把 rear 一起置空。
取队头和取队尾只读不改。 两个函数都先做空队列的断言,再把值返回。队头取的是 front 的数据,队尾取的是 rear 的数据,因为 rear 指向的就是队尾结点本身,这里不需要任何偏移计算。
取个数和判空是查询接口。 判空看 front 是不是空指针,取个数直接返回 size。这两个接口在循环里被调用的次数最多,所以让它们都保持 O(1)。如果当初没有记 size,取个数就得遍历整条链表,每次循环都遍历一遍的话,整个程序的复杂度会被这一处拖垮。
还有一个位置容易被忽略:入队时申请结点失败。malloc 返回 NULL 时,如果直接给 node->data 赋值,立刻就是空指针解引用。这里用打印加 exit 结束程序,属于最省事的处理;库函数一般会把失败往外抛,让调用者决定是重试还是放弃。
入队为什么要判断 rear 是不是空。 队列为空时 front 和 rear 都是 NULL,第一个结点既是队头也是队尾,两个指针都要指向它。队列非空时,新结点挂在 rear 后面,再把 rear 推到新结点上。这两段代码合并不了,空队列时没有 rear->next 可以挂。判断条件写成 rear == NULL 和写成 front == NULL 都对,两者在正确的实现里始终同时为空或同时非空。
为什么不用双向链表。 队列只在两端动,入队在尾、出队在头,每个方向各走一步,前驱指针一次都用不上。双向链表每个结点多一个指针域,多出来的八个字节换不到任何能力。同理,带环的链表、加头结点的链表都不是必需品,头结点只是为了省掉空队列的判断,属于可选项。
带头结点的版本在代码上省了什么,对比一下就能看清。不带头的写法里,入队要分空队列和非空两条路,出队删掉最后一个结点后还要手动把 rear 置空;带头结点之后,队头永远是头结点的下一个,空队列时 front 和 rear 都指向头结点,入队永远挂在 rear 后面,出队永远从 front->next 下手,两条分支合成一条。代价是多一个结点,以及每次取队头要写成 front->next->data。
三、数组实现的麻烦
数组实现的第一版最自然:队头固定在下标 0,元素紧挨着排在最前面,再记一个元素个数。入队就是写在 size 的位置上,再把 size 加一,一步到位。
出队就没有这么轻松。队头元素在下标 0,拿走它之后,剩下的每一个元素都要往前挪一格,否则队头就不在 0 上了。这一步交给 memmove:
c
# 文件:/home/cocatrice/ds08/seqqueue.c
void SeqQueuePop(SeqQueue* pq)
{
	assert(pq);
	assert(!SeqQueueEmpty(pq));
	memmove(pq->a, pq->a + 1, sizeof(QDataType) * (size_t)(pq->size - 1));
	pq->size--;
}
memmove 是整块内存的搬运,一行代码就完成了,语言层面看不出代价。代价在数据量上:出队一次要搬动剩下所有元素,复杂度是 O(n)。入队 O(1)、出队 O(n) 的队列,元素一多就没法用了。实测里五万个元素反复入队出队,数组版比链表版慢了一百六十倍,差异全部来自这一行。
第二条路是不搬数据,让队头和队尾都往后走。队头不再固定在 0,改用一个下标 front 指向队头元素;出队只是把 front 加一,元素本身留在原地;入队把数据写在 rear 的位置上,再把 rear 加一。两个操作都是 O(1),出队的代价降下来了。
代价转移到了空间上。front 前面的位置永远空着,虽然那些位置上的元素早就出队了。数组是定长的,rear 一直往后走,很快就会撞到末尾,这时候 front 前面明明还空着一大片,新元素却无处安放。容量 4 的数组里,连续入队四个元素再出队三个,此时队列里只剩一个元素,rear 却已经到头,第五个元素放不进来。这种现象叫假满,位置是空的,下标却不认。
把假满的具体数字摊开看:容量 4 的数组,下标是 0 到 3。连续入队四个元素之后,四个位置全满,rear 停在 4。接着出队三次,front 走到 3,队列里只剩一个元素,它待在下标 3 上。此时还有三个位置是空的,却被 front 抛在了身后,再想入队已经无处可写,因为 rear 已经等于容量。元素住在一个 4 格的房子里,实际只占了一格,另外三格被判定为不可用,这就是它必须被解决的原因。
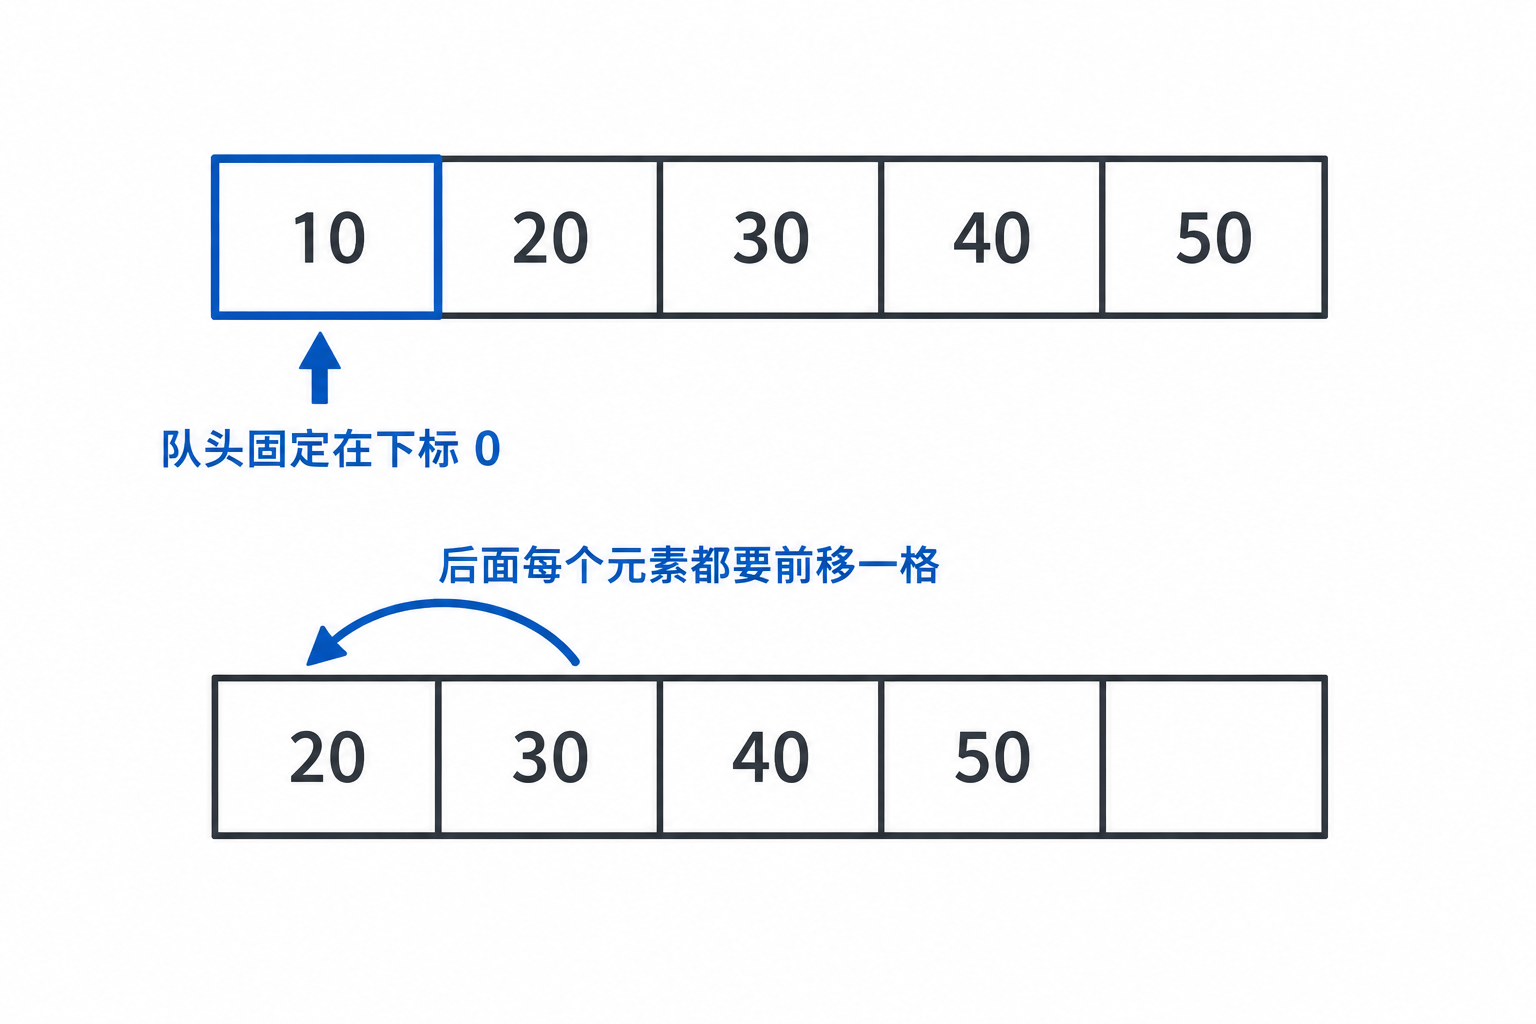
图 3 数组队列出队要搬数据
两条路各亏一点:一条在时间上亏,一条在空间上亏。改法只有一个,让 rear 走到末尾之后回到下标 0,把数组当作首尾相接的环来用。
要把搬数据这一步的代价说透,可以算一笔账。队列里放 n 个元素再全部出队,出队第 k 个元素时要搬动 n - k 个元素,把 n 次出队加起来是 n × (n - 1) / 2 次元素移动。元素个数翻倍,移动次数翻四倍,这就是实测里数据量涨五倍、耗时涨二十多倍的原因。
数组队列也不是一无是处。队列的长度很小并且固定时,一次性申请一块数组反而更省事,比如固定几个任务的轮转。判断的依据有两条:队列的长度能不能提前确定,元素的大小是不是远大于一个指针。两条都成立时,数组的连续内存和零分配开销就压过了搬数据的代价。
接口上的差异。 数组队列对外提供的接口和链表队列完全一样,调用方从一种实现换到另一种,函数名改一改就能用。真正不同的是失败的语义:链表队列的入队只在申请内存失败时出问题,那是异常;数组队列的入队随时可能因为容量满而失败,那是常态。前者的失败可以直接中止程序,后者的失败必须交回给调用者处理,否则数据会无声无息地丢掉。
四、循环队列
循环队列把数组看成一个环:下标走到 capacity - 1 之后,下一个位置是 0。实现上只多一步取模:
c
rear = (rear + 1) % capacity;
front = (front + 1) % capacity;
加一之后取模,下标自然绕回来,不需要任何额外判断。这一步也是循环队列里唯一和普通数组队列不同的地方,其余代码几乎照抄。
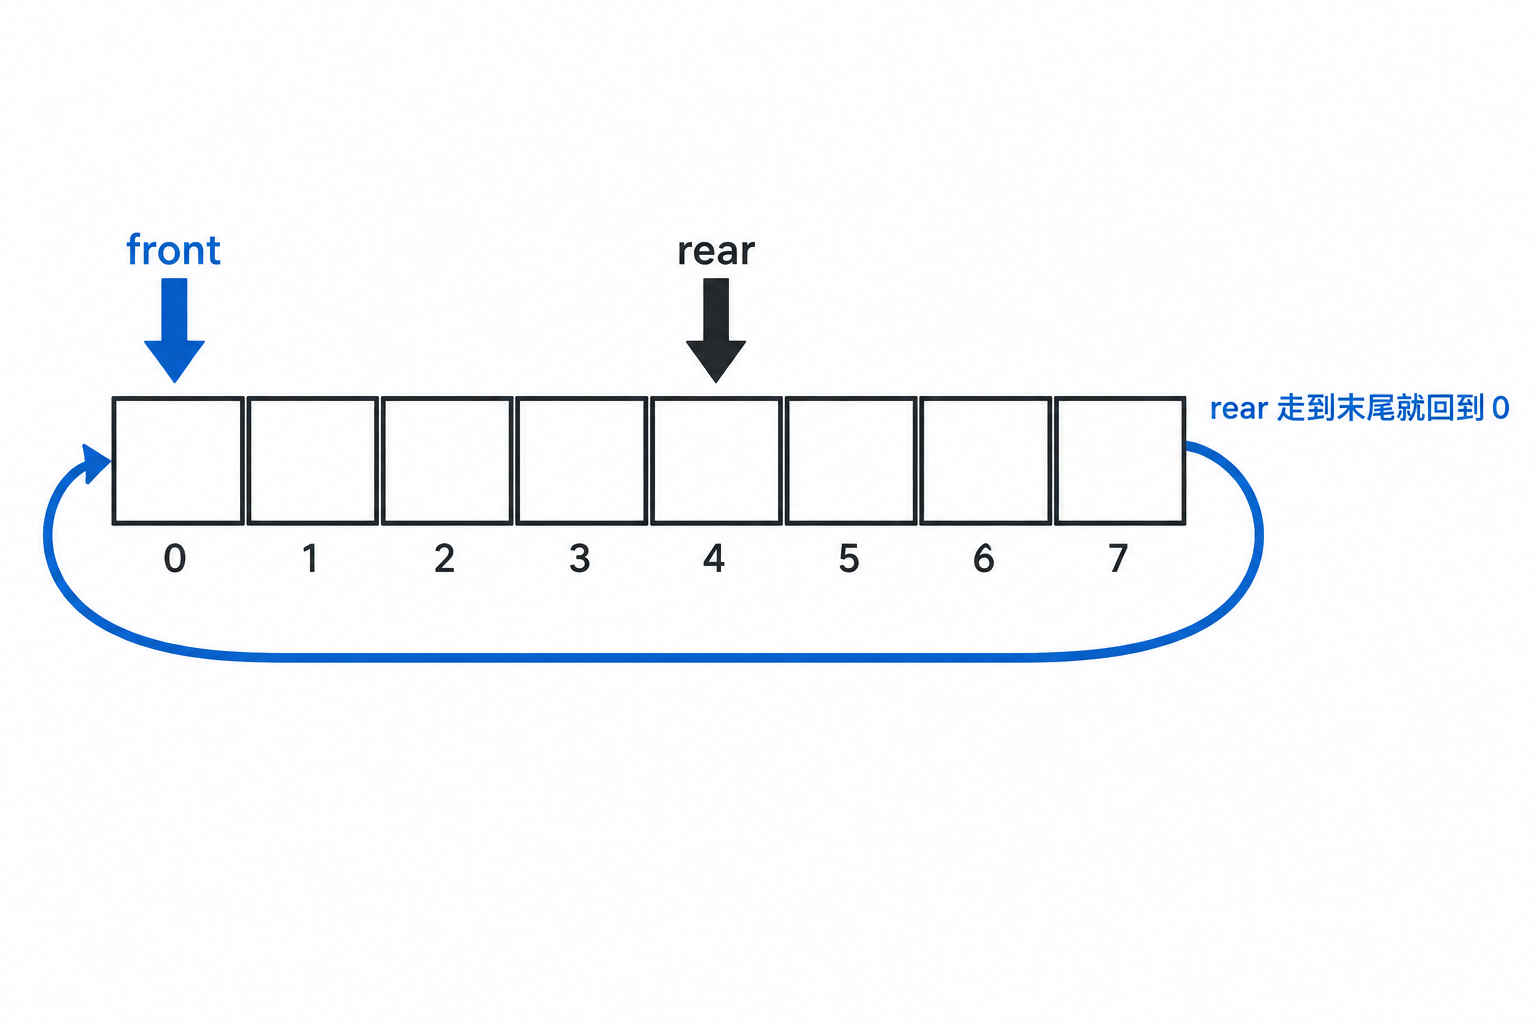
图 4 循环队列首尾相接
两个下标的语义要先写清楚,后面所有公式都建立在它上面:
- front 指向队头元素所在的位置,出队时先取走 afront,再让 front 往前挪一格
- rear 指向队尾元素的下一个位置,也就是下一次入队要写入的位置
rear 指向下一个空位而不是队尾元素本身,这个约定看起来绕,却让入队少一次判断:写入的位置就是 rear,写完再挪。取队尾元素的时候写成 a(rear - 1 + capacity) % capacity,减一之后可能变成负数,所以要先把 capacity 加上再取模。
c
# 文件:/home/cocatrice/ds08/circqueue.h
typedef struct CircQueue2
{
	QDataType* a;
	int capacity;
	int front;
	int rear;
	int size;
} CircQueue2;
入队和出队两个操作都只有三行:
c
# 文件:/home/cocatrice/ds08/circqueue.c
bool CircQueue2Push(CircQueue2* pq, QDataType x)
{
	assert(pq);
	if (CircQueue2Full(pq))
	{
		return false;
	}
	pq->a[pq->rear] = x;
	pq->rear = (pq->rear + 1) % pq->capacity;
	pq->size++;
	return true;
}

bool CircQueue2Pop(CircQueue2* pq, QDataType* out)
{
	assert(pq);
	if (CircQueue2Empty(pq))
	{
		return false;
	}
	if (out)
	{
		*out = pq->a[pq->front];
	}
	pq->front = (pq->front + 1) % pq->capacity;
	pq->size--;
	return true;
}
入队和出队失败时返回 false,而不是用断言中止程序,这一点和前面几个容器不一样。队列在系统里常常扮演缓冲区,满了、空了都是正常运行中会遇到的情况,让调用者拿到一个布尔值去做取舍,比直接崩掉合适。
容量是固定的时候,循环队列比链表队列更省:一块连续内存,没有每个元素的分配和释放,缓存也友好。它的代价是容量在初始化时就定死了,装不下只能报错或者丢数据。链表队列没有这个上限,代价是每次入队都要 malloc 一次。
rear 的两种约定。 循环队列里 rear 可以指向队尾元素本身,也可以指向队尾的下一个位置,两种写法都有人用:
| rear 的约定 | 空队列怎么表示 | 入队怎么写 | 取队尾怎么写 |
|---|---|---|---|
| 指向队尾元素 | 要把两个下标绕一圈比较 | 先把 rear 推进一步,再往 arear 写 | arear |
| 指向队尾的下一个位置 | 两个下标相等 | 先往 arear 写,再推进 rear | a(rear - 1 + capacity) % capacity |
差别在于谁先动。指向队尾元素的写法,入队要先挪下标再写数据;指向下一个空位的写法,入队先写数据再挪下标。后者的判空条件正好是两个下标相等,读起来更直接,本文采用这一种。选定之后全篇要一致,中途换约定,前面推出来的长度公式全部作废。
数组是 malloc 出来的,初始化时要断言 capacity 大于 0。取模运算在除数为 0 时直接崩溃,而容量为负时下标会跑到数组外面去,这两个值都不该出现,入口处用断言挡掉最省事。
容量为什么常取 2 的幂。 队列容量取成 2 的幂,取模运算可以换成按位与。容量是 8 时,下标 & 7 和下标 % 8 结果完全相同,前者在机器码里是一条与指令,比除法快得多。这不是必须的写法,但库和内核里的环形缓冲区几乎都这么做,看到容量是 2 的幂时,多半就是为这一步准备的。
取模的代价。 取模在处理器上是一条除法指令,比加法慢不少。队列的容量常常取成 2 的幂,这时可以把 % capacity 换成 & (capacity - 1),两者对 2 的幂是等价的,机器码里省掉了除法。实测里五万次出队一共用了 0.720 毫秒,折算下来一次十几纳秒,取模的影响在这个量级上还看不出来,只有在每秒百万次的热路径上才值得动这种心思。
五、队空和队满的区分
循环队列里 front 和 rear 会反复撞在一起。队列空的时候它们相等,队列满的时候它们也相等,单看这两个下标分不出是哪种情况。三种办法都能解决,各有取舍。
办法一:留一个空位。 数组开 capacity 个位置,约定最多只放 capacity - 1 个元素,始终空着一个位置不用:
c
# 文件:/home/cocatrice/ds08/circqueue.c
bool CircQueue1Empty(CircQueue1* pq)
{
	return pq->rear == pq->front;
}

bool CircQueue1Full(CircQueue1* pq)
{
	return (pq->rear + 1) % pq->capacity == pq->front;
}
空的时候两个下标相等,满的时候队尾再走一步就撞上队头。这个办法不需要多记任何成员,判空判满各一行。代价是永远有一个位置闲置,并且这个代价在容量小的时候格外刺眼:容量为 1 的循环队列一个元素也放不下,实测里容量 1 的方案一收下 0 个,容量 2 收下 1 个,容量 3 收下 2 个。
办法二:加一个 size 计数。 多记一个元素个数,空和满看它一个数就够了,数组位置全部能用满:
c
# 文件:/home/cocatrice/ds08/circqueue.c
bool CircQueue2Empty(CircQueue2* pq)
{
	return pq->size == 0;
}

bool CircQueue2Full(CircQueue2* pq)
{
	return pq->size == pq->capacity;
}
代码最好懂,容量也不浪费。代价是多一个成员,并且每次入队出队都要记得维护它,漏改一处,判空判满立刻失真。
办法三:加一个 tag 标记位。 记下最后一次操作是入队还是出队,两个下标相等时,靠它区分:
c
# 文件:/home/cocatrice/ds08/circqueue.c
bool CircQueue3Empty(CircQueue3* pq)
{
	return pq->front == pq->rear && pq->tag == 0;
}

bool CircQueue3Full(CircQueue3* pq)
{
	return pq->front == pq->rear && pq->tag == 1;
}
位置同样能用满。它和 size 的区别在于记的东西不同:size 记的是数量,tag 记的是上一次动作的方向,两者都能唯一确定当前状态。tag 方案有一个容易忽略的坑,取长度的公式在满的时候会算出 0,这一处单独处理,实测里方案三满的时候裸公式算出 0,Size 接口给出的是容量。
三种办法汇总:
| 办法 | 判空 | 判满 | 最多放几个 | 多出的成员 | 要当心的地方 |
|---|---|---|---|---|---|
| 留一个空位 | 两下标相等 | 队尾再走一步撞上队头 | capacity - 1 | 无 | 容量 1 时什么都放不下 |
| 加 size | size 等于 0 | size 等于 capacity | capacity | 一个 int | 每次入队出队都要维护它 |
| 加 tag | 两下标相等且 tag 为 0 | 两下标相等且 tag 为 1 | capacity | 一个 int | 取长度的公式在满时要单独判 |
实际写代码时选哪一种,看容量紧不紧张。容量固定且不差那一个位置,第一种最省事;容量是 1 或者 2 这种极端值,第一种直接不能用;需要频繁问元素个数,第二种顺手就把答案存好了;状态只有空和满两种、又不想多维护计数的场合,第三种合适。
这三种办法之间没有性能上的差别,判空判满都是一次比较,取长度都是一次加减加取模。选择依据只在两处:容量能不能少一个位置,以及多一个成员会不会带来维护负担。
三种办法对使用方是完全透明的。同一个队列,不管内部是留空位、记 size 还是记 tag,外部的入队、出队、取队头、判空接口签名完全一样,返回值的含义也一样。差别只在两处:容量为 1 时第一种不可用,以及内部能不能承受多一个成员的开销。既然使用方感受不到区别,选择就纯粹是实现者的取舍。
真实的实现里也能看到这三种影子。 Java 的 ArrayBlockingQueue 用的是第二种,内部有 count、takeIndex、putIndex 三个成员,count 就是 size;Linux 内核里的 kfifo 走得更远,它让入队出队两个下标一直往上加、永不取模,靠无符号整数的自然回绕和一次按位与取出低若干位,把取模也省掉了;不少嵌入式代码里的环形缓冲区用的是第一种,因为省一个变量在资源紧张时也是收益。
六、有效长度的公式是怎么来的
除了 size 方案,另外两种都要现算长度。公式是:
c
(rear - front + capacity) % capacity推导分两种情况。rear 没有绕过数组末尾时,rear 在 front 后面,长度就是 rear - front,比如 front 是 1、rear 是 3,队列里有两个元素。rear 绕回去了的时候,rear 反而在 front 前面,长度是 rear + capacity - front,比如容量 4、front 是 3、rear 是 1,队列里是下标 3 和下标 0 两个位置。
把两种情况写成一个式子,办法是先补上一个 capacity 再取模。rear - front 在第二种情况下是负数,加 capacity 之后变成正数,取模又把第一种情况下多出来的 capacity 去掉。代进去验证:front 是 3、rear 是 1、容量 4,得到 (1 - 3 + 4) % 4 = 2,和下标的实际分布一致。
拿几组下标代进去验证,容量取 8:
| front | rear | 计算式 | 长度 | 说明 |
|---|---|---|---|---|
| 0 | 3 | (3 - 0 + 8) % 8 | 3 | 没有绕圈 |
| 3 | 1 | (1 - 3 + 8) % 8 | 6 | 绕过末尾,占了下标 3 到 7 和 0 |
| 7 | 0 | (0 - 7 + 8) % 8 | 1 | 只剩最后一个位置上的元素 |
| 5 | 5 | (5 - 5 + 8) % 8 | 0 | 空;如果用 tag 方案,也可能是满 |
这个公式还有一处要注意:它在满的时候可能算出 0,因为满的时候 rear 又和 front 相等了。留一个空位的方案不会满到两个下标相等,所以直接套公式没问题;tag 方案会满到相等,必须先判满再决定用不用公式,这就是前面那张表里最后一列的由来。
最后说一个特别常见的算错方式:直接写 rear - front 当长度。没有绕圈时它是对的,一旦 rear 跑到 front 前面,结果就是负数。取长度的公式里那个加 capacity 不是为了好看,缺了它就会出现负数长度的队列。还有一种相关的心算错误,是看到两个下标相等就断定队列为空,这在留空位的方案里成立,在 tag 方案里不成立,因为满的时候两个下标同样相等。
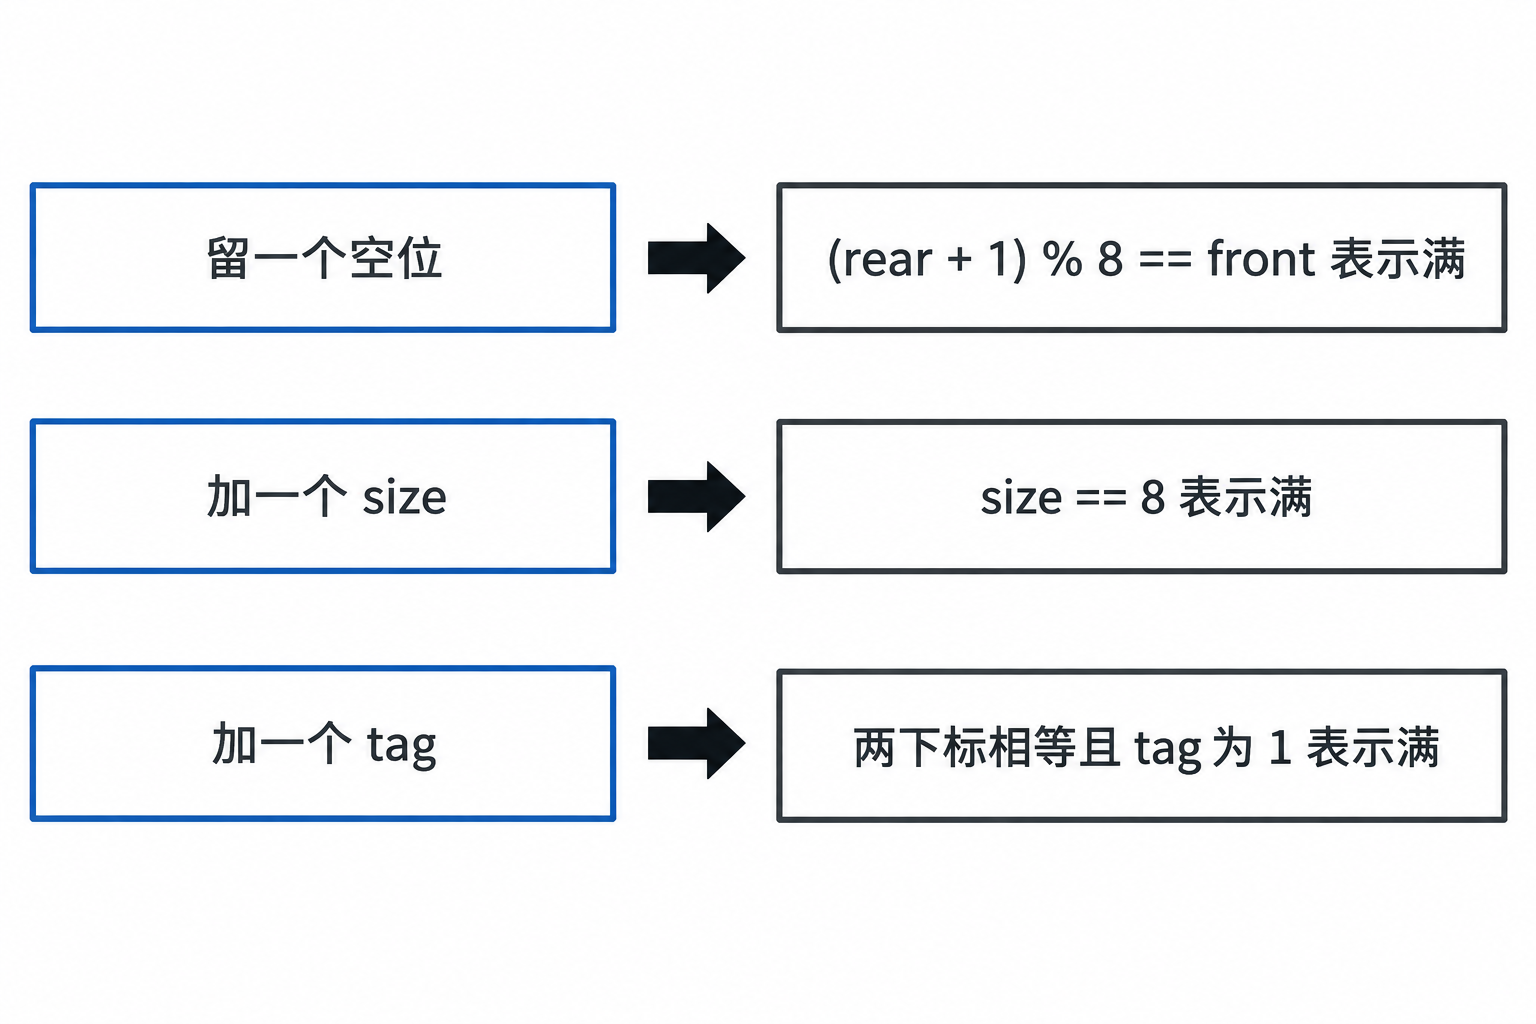
图 5 三种判满办法的对照
七、队列在系统里的应用
生产者消费者。 一边产生数据,一边处理数据,两边的速度不可能一直相等,队列放在中间当缓冲区:来得快了先存着,处理得慢了就排队,上游不至于被拖住。实测里用容量 8 的循环队列模拟了一遍,每轮生产者想放两个、消费者取一个,队列长度一路涨到 7 就稳住了:满了之后生产者放不进,只能放一个,取走一个又腾出一个,水位就停在那个位置。
缓冲区的长度是可以算出来的。生产速度记作 p,消费速度记作 c,队列的平均长度约等于两者之差乘上波动持续的时间。这套估算在压测的时候很有用:队列一直往上涨,说明消费端跟不上,只把队列开大只是把问题往后推,最终要解决的还是消费速度。
任务调度。 操作系统把等待执行的进程排成就绪队列,调度器每次从队头取一个运行,新就绪的进程挂在队尾。先来先服务(FCFS)这个名字说的就是队列的规则。纯粹的先进先出有一个毛病:一个长任务排在前面,后面所有短任务都得等,平均等待时间被它一个人拖长。改进的办法是把一个就绪队列拆成多条,短任务和高优先级任务放在靠前的队列里,调度器先扫前面的队列,扫空了才往下走,这就是多级反馈队列,底子仍然是队列。
层序遍历与最短路。 树和图的按层访问靠队列实现:把起点入队,每次取出队头,把它的邻居入队,天然的访问顺序就是从近到远。实测里用队列在迷宫里跑了一遍,从左上角到右下角的最少步数一次就算出来了,每一格的最短步数也一并得到。
用队列做层序遍历还有一个前提:图的边不带权,也就是每一跳的代价相同。一旦边带上了不同的权重,先入队的不再是先到的,就得换成优先队列,那是后面堆那一篇的内容。
缓冲与消息传递。 打印机的任务队列、消息中间件里的消息队列、管道里的数据,形态都是队列:谁先提交谁先处理。几条数据连在一起的管道里,写入端不停往里塞,读出端按同样的顺序往外取,中间靠一段内核缓冲区兜住速度差,这就是队列在进程之间最直接的用法。
为什么这些场合都选队列。 它们的共同点是两边解耦:产生数据的一方和消费数据的一方互不认识,也不需要同时在线,唯一的约定是先来后到。队列正好提供了这个约定,同时把速度差吸收在缓冲区里。用栈处理同一类问题会出麻烦,最新的任务先被处理,早提交的任务可能永远排不上,这就是所谓的饿死。
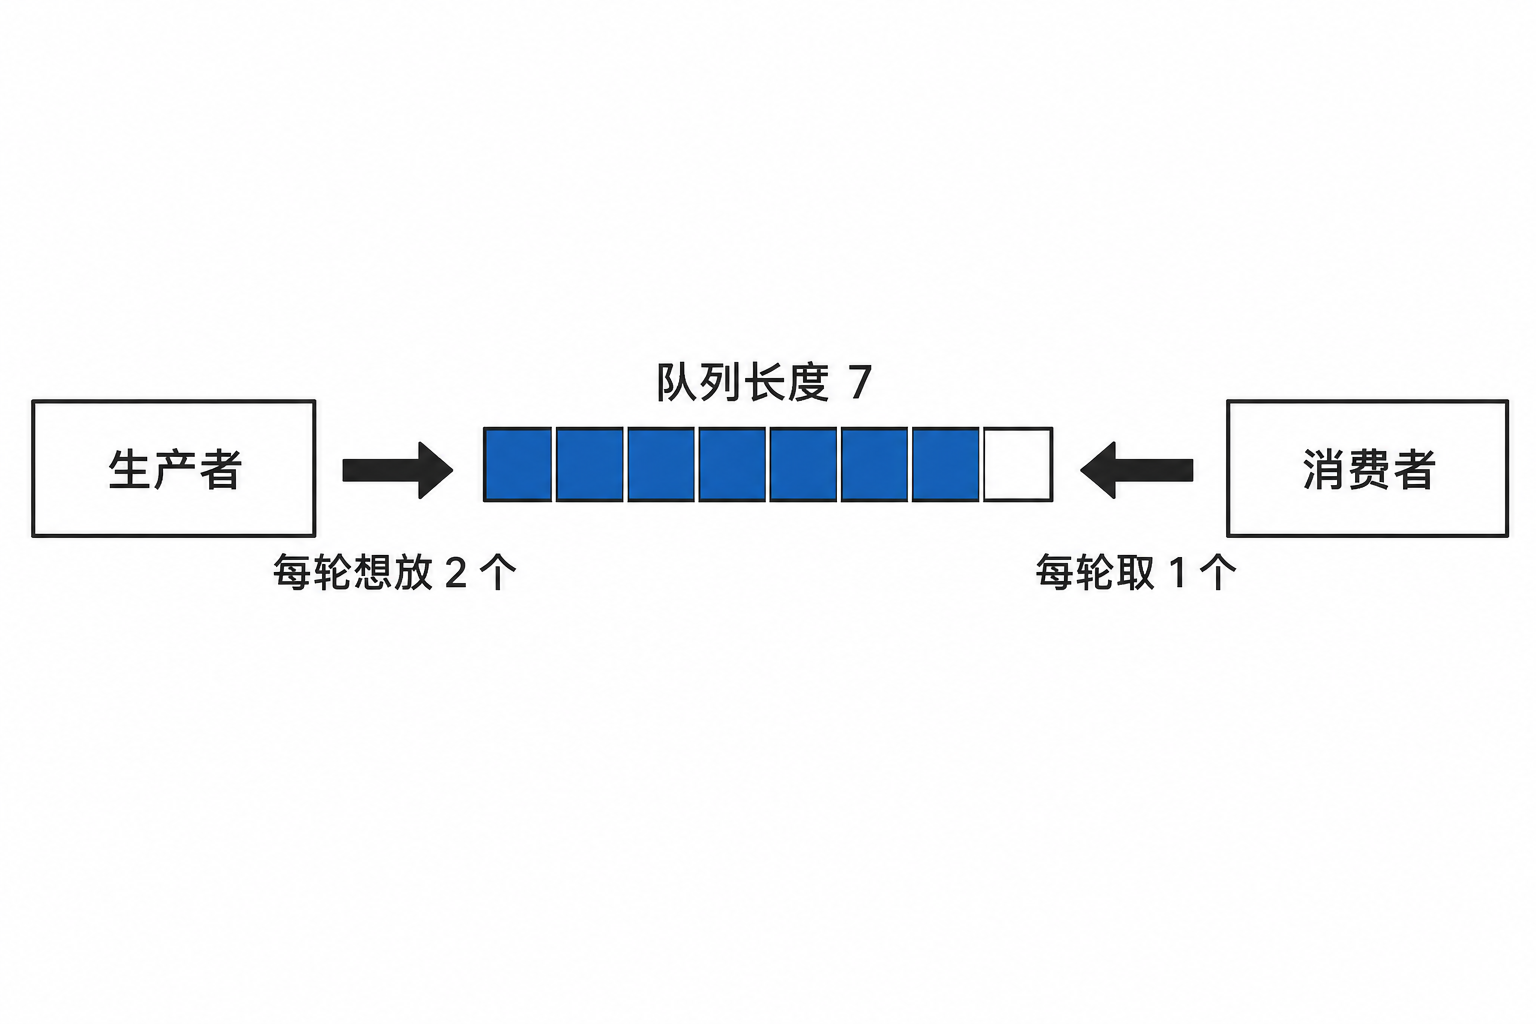
图 6 生产者消费者的水位变化
八、双端队列
队列限制两端分工,插入只在一头、删除只在另一头。把这个限制松开,让两端都能进能出,得到的是双端队列(double-ended queue,deque)。它的接口在队列的基础上翻倍:两端各有一个入队和一个出队,取队头和取队尾则和普通队列一样。
用循环数组实现双端队列最自然,和前面的循环队列是同一套结构:front 往前挪一格就是前端的入队,rear 往前挪一格就是后端的出队,两端的操作都落在 O(1)。两端都要能绕圈,取模的写法一模一样,区别只在于四个方向的下标怎么动。
| 操作 | 下标怎么动 |
|---|---|
| 后端入队 | 写在 arear,rear 加一取模 |
| 后端出队 | rear 减一,取 arear |
| 前端入队 | front 减一取模,写在 afront |
| 前端出队 | 取 afront,front 加一取模 |
双端队列的用处是既能当队列又能当栈:只用后端进、后端出,它就是栈;后端进、前端出,它就是队列。它也是滑动窗口这一类问题的常用工具,后面讲单调队列时还会遇到。
一个典型的用途是滑动窗口:窗口向右移动一格,左边出队一个元素、右边入队一个新元素,两端各一次操作,中间的元素保持不动。如果只用普通队列,左边出队之后剩下的元素要整体前移,窗口每动一格就是一次 O(n) 的搬运,整体又退化成了平方级。
标准库里就有现成的。C++ 的 std::deque 是双端队列,std::queue 则是套在它外面的适配器,只暴露队列该有的那几个接口。适配器这层壳的作用是限制用法,让使用方没法从中间伸手进去,也就没法破坏队列的规则。
九、队列各操作的时间复杂度
三种实现对比:
| 操作 | 链表队列 | 数组队列(队头固定) | 循环队列 |
|---|---|---|---|
| 入队 | O(1) | O(1),扩容时均摊 O(1) | O(1) |
| 出队 | O(1) | O(n),要搬数据 | O(1) |
| 取队头 | O(1) | O(1) | O(1) |
| 取队尾 | O(1) | O(1) | O(1) |
| 取个数 | O(1) | O(1) | O(1) |
| 判空 | O(1) | O(1) | O(1) |
| 空间 | 每元素一个结点 | 一块数组 | 一块数组 |
整张表里唯一一个不是常数的是数组队列的出队。把这一格降下来,就是循环队列存在的全部理由。
实例代码
工程结构
text
ds08/
├── queue.h        链式队列的结构体与接口声明
├── queue.c        链式队列的实现
├── seqqueue.h     数组队列(队头固定在 0,出队搬数据)
├── seqqueue.c     数组队列的实现
├── circqueue.h    循环队列的三种写法
├── circqueue.c    循环队列的三种实现
├── test.c         功能测试,三种队列各过一遍
└── exp/
    ├── speed.c        出队耗时:链表队列与数组队列对照
    ├── boundary.c     容量 1、2、3 的边界与绕圈实验
    ├── prodcons.c     生产者消费者的水位模拟
    └── bfs.c          用队列跑迷宫的最短路
编译命令统一是 gcc -std=gnu99 -Wall -Wextra -g,出队耗时那一个另外带 -O2。-std=gnu99 是为了用上 C99 的写法,变量可以随用随声明;-Wall -Wextra 把常用的告警都打开,这类指针代码里漏写一个 return、比较有符号和无符号,都会在这里被点出来;-g 保留调试信息,valgrind 报错时能直接给出文件名和行号。
完整代码
链式队列的头文件与实现:
c
# 文件:/home/cocatrice/ds08/queue.h
#pragma once

#include <stdio.h>
#include <stdlib.h>
#include <assert.h>
#include <stdbool.h>

typedef int QDataType;

// 链表结点:一个数据域加一个指针域
typedef struct QNode
{
	QDataType data;
	struct QNode* next;
} QNode;

// 队列本体:队头指针、队尾指针,再记一个元素个数
// 不记 size 也能写,代价是 QueueSize 要遍历一遍链表
typedef struct Queue
{
	QNode* front;
	QNode* rear;
	int size;
} Queue;

void QueueInit(Queue* pq);
void QueueDestroy(Queue* pq);
void QueuePush(Queue* pq, QDataType x);
void QueuePop(Queue* pq);
QDataType QueueFront(Queue* pq);
QDataType QueueBack(Queue* pq);
int QueueSize(Queue* pq);
bool QueueEmpty(Queue* pq);
c
# 文件:/home/cocatrice/ds08/queue.c
#include "queue.h"

void QueueInit(Queue* pq)
{
	assert(pq);
	pq->front = NULL;
	pq->rear = NULL;
	pq->size = 0;
}

void QueueDestroy(Queue* pq)
{
	assert(pq);
	QNode* cur = pq->front;
	while (cur)
	{
		QNode* next = cur->next;
		free(cur);
		cur = next;
	}
	pq->front = NULL;
	pq->rear = NULL;
	pq->size = 0;
}

void QueuePush(Queue* pq, QDataType x)
{
	assert(pq);
	QNode* node = (QNode*)malloc(sizeof(QNode));
	if (node == NULL)
	{
		printf("malloc 失败\n");
		exit(1);
	}
	node->data = x;
	node->next = NULL;

	if (pq->rear == NULL)
	{
		pq->front = node;
		pq->rear = node;
	}
	else
	{
		pq->rear->next = node;
		pq->rear = node;
	}
	pq->size++;
}

void QueuePop(Queue* pq)
{
	assert(pq);
	assert(!QueueEmpty(pq));

	QNode* next = pq->front->next;
	free(pq->front);
	pq->front = next;
	if (pq->front == NULL)
	{
		pq->rear = NULL;
	}
	pq->size--;
}

QDataType QueueFront(Queue* pq)
{
	assert(pq);
	assert(!QueueEmpty(pq));
	return pq->front->data;
}

QDataType QueueBack(Queue* pq)
{
	assert(pq);
	assert(!QueueEmpty(pq));
	return pq->rear->data;
}

int QueueSize(Queue* pq)
{
	assert(pq);
	return pq->size;
}

bool QueueEmpty(Queue* pq)
{
	assert(pq);
	return pq->front == NULL;
}
数组队列,队头固定在下标 0,出队用 memmove 把后面的元素整体前移:
c
# 文件:/home/cocatrice/ds08/seqqueue.h
#pragma once

#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <assert.h>
#include <stdbool.h>

typedef int QDataType;

// 数组队列:队头永远在下标 0
// 出队要把后面所有元素往前搬一格,这一步是 O(n)
typedef struct SeqQueue
{
	QDataType* a;
	int capacity;
	int size;
} SeqQueue;

void SeqQueueInit(SeqQueue* pq);
void SeqQueueDestroy(SeqQueue* pq);
void SeqQueuePush(SeqQueue* pq, QDataType x);
void SeqQueuePop(SeqQueue* pq);
QDataType SeqQueueFront(SeqQueue* pq);
QDataType SeqQueueBack(SeqQueue* pq);
int SeqQueueSize(SeqQueue* pq);
bool SeqQueueEmpty(SeqQueue* pq);
c
# 文件:/home/cocatrice/ds08/seqqueue.c
#include "seqqueue.h"

static void SeqQueueGrow(SeqQueue* pq)
{
	int newCapacity = pq->capacity == 0 ? 4 : pq->capacity * 2;
	QDataType* tmp = (QDataType*)realloc(pq->a, sizeof(QDataType) * (size_t)newCapacity);
	if (tmp == NULL)
	{
		printf("realloc 失败\n");
		exit(1);
	}
	pq->a = tmp;
	pq->capacity = newCapacity;
}

void SeqQueueInit(SeqQueue* pq)
{
	assert(pq);
	pq->a = NULL;
	pq->capacity = 0;
	pq->size = 0;
}

void SeqQueueDestroy(SeqQueue* pq)
{
	assert(pq);
	free(pq->a);
	pq->a = NULL;
	pq->capacity = 0;
	pq->size = 0;
}

void SeqQueuePush(SeqQueue* pq, QDataType x)
{
	assert(pq);
	if (pq->size == pq->capacity)
	{
		SeqQueueGrow(pq);
	}
	pq->a[pq->size] = x;
	pq->size++;
}

void SeqQueuePop(SeqQueue* pq)
{
	assert(pq);
	assert(!SeqQueueEmpty(pq));
	// 队头在 0,出队之后后面每一个元素都要往前挪一格
	memmove(pq->a, pq->a + 1, sizeof(QDataType) * (size_t)(pq->size - 1));
	pq->size--;
}

QDataType SeqQueueFront(SeqQueue* pq)
{
	assert(pq);
	assert(!SeqQueueEmpty(pq));
	return pq->a[0];
}

QDataType SeqQueueBack(SeqQueue* pq)
{
	assert(pq);
	assert(!SeqQueueEmpty(pq));
	return pq->a[pq->size - 1];
}

int SeqQueueSize(SeqQueue* pq)
{
	assert(pq);
	return pq->size;
}

bool SeqQueueEmpty(SeqQueue* pq)
{
	assert(pq);
	return pq->size == 0;
}
循环队列的三种写法放在同一对文件里,结构体各自不同,判空判满的方式也不同:
c
# 文件:/home/cocatrice/ds08/circqueue.h
#pragma once

#include <stdio.h>
#include <stdlib.h>
#include <assert.h>
#include <stdbool.h>

typedef int QDataType;

// 循环队列的三种判空判满写法,接口一样,内部的记账方式不同

// 方案一:空一个位置。数组开 capacity 个位置,最多只放 capacity - 1 个元素
typedef struct CircQueue1
{
	QDataType* a;
	int capacity;
	int front;
	int rear;
} CircQueue1;

// 方案二:多记一个 size,数组位置可以全部用满
typedef struct CircQueue2
{
	QDataType* a;
	int capacity;
	int front;
	int rear;
	int size;
} CircQueue2;

// 方案三:多记一个 tag,标记最后一次操作是入队还是出队
typedef struct CircQueue3
{
	QDataType* a;
	int capacity;
	int front;
	int rear;
	int tag;
} CircQueue3;

void CircQueue1Init(CircQueue1* pq, int capacity);
void CircQueue1Destroy(CircQueue1* pq);
bool CircQueue1Push(CircQueue1* pq, QDataType x);
bool CircQueue1Pop(CircQueue1* pq, QDataType* out);
QDataType CircQueue1Front(CircQueue1* pq);
int CircQueue1Size(CircQueue1* pq);
bool CircQueue1Empty(CircQueue1* pq);
bool CircQueue1Full(CircQueue1* pq);

void CircQueue2Init(CircQueue2* pq, int capacity);
void CircQueue2Destroy(CircQueue2* pq);
bool CircQueue2Push(CircQueue2* pq, QDataType x);
bool CircQueue2Pop(CircQueue2* pq, QDataType* out);
QDataType CircQueue2Front(CircQueue2* pq);
int CircQueue2Size(CircQueue2* pq);
bool CircQueue2Empty(CircQueue2* pq);
bool CircQueue2Full(CircQueue2* pq);

void CircQueue3Init(CircQueue3* pq, int capacity);
void CircQueue3Destroy(CircQueue3* pq);
bool CircQueue3Push(CircQueue3* pq, QDataType x);
bool CircQueue3Pop(CircQueue3* pq, QDataType* out);
QDataType CircQueue3Front(CircQueue3* pq);
int CircQueue3Size(CircQueue3* pq);
bool CircQueue3Empty(CircQueue3* pq);
bool CircQueue3Full(CircQueue3* pq);
c
# 文件:/home/cocatrice/ds08/circqueue.c
#include "circqueue.h"

// ---------------- 方案一:空一个位置 ----------------

void CircQueue1Init(CircQueue1* pq, int capacity)
{
	assert(pq);
	assert(capacity > 0);
	pq->a = (QDataType*)malloc(sizeof(QDataType) * (size_t)capacity);
	assert(pq->a);
	pq->capacity = capacity;
	pq->front = 0;
	pq->rear = 0;
}

void CircQueue1Destroy(CircQueue1* pq)
{
	assert(pq);
	free(pq->a);
	pq->a = NULL;
	pq->capacity = 0;
	pq->front = 0;
	pq->rear = 0;
}

bool CircQueue1Full(CircQueue1* pq)
{
	assert(pq);
	return (pq->rear + 1) % pq->capacity == pq->front;
}

bool CircQueue1Empty(CircQueue1* pq)
{
	assert(pq);
	return pq->rear == pq->front;
}

bool CircQueue1Push(CircQueue1* pq, QDataType x)
{
	assert(pq);
	if (CircQueue1Full(pq))
	{
		return false;
	}
	pq->a[pq->rear] = x;
	pq->rear = (pq->rear + 1) % pq->capacity;
	return true;
}

bool CircQueue1Pop(CircQueue1* pq, QDataType* out)
{
	assert(pq);
	if (CircQueue1Empty(pq))
	{
		return false;
	}
	if (out)
	{
		*out = pq->a[pq->front];
	}
	pq->front = (pq->front + 1) % pq->capacity;
	return true;
}

QDataType CircQueue1Front(CircQueue1* pq)
{
	assert(pq);
	assert(!CircQueue1Empty(pq));
	return pq->a[pq->front];
}

int CircQueue1Size(CircQueue1* pq)
{
	assert(pq);
	return (pq->rear - pq->front + pq->capacity) % pq->capacity;
}

// ---------------- 方案二:多记一个 size ----------------

void CircQueue2Init(CircQueue2* pq, int capacity)
{
	assert(pq);
	assert(capacity > 0);
	pq->a = (QDataType*)malloc(sizeof(QDataType) * (size_t)capacity);
	assert(pq->a);
	pq->capacity = capacity;
	pq->front = 0;
	pq->rear = 0;
	pq->size = 0;
}

void CircQueue2Destroy(CircQueue2* pq)
{
	assert(pq);
	free(pq->a);
	pq->a = NULL;
	pq->capacity = 0;
	pq->front = 0;
	pq->rear = 0;
	pq->size = 0;
}

bool CircQueue2Full(CircQueue2* pq)
{
	assert(pq);
	return pq->size == pq->capacity;
}

bool CircQueue2Empty(CircQueue2* pq)
{
	assert(pq);
	return pq->size == 0;
}

bool CircQueue2Push(CircQueue2* pq, QDataType x)
{
	assert(pq);
	if (CircQueue2Full(pq))
	{
		return false;
	}
	pq->a[pq->rear] = x;
	pq->rear = (pq->rear + 1) % pq->capacity;
	pq->size++;
	return true;
}

bool CircQueue2Pop(CircQueue2* pq, QDataType* out)
{
	assert(pq);
	if (CircQueue2Empty(pq))
	{
		return false;
	}
	if (out)
	{
		*out = pq->a[pq->front];
	}
	pq->front = (pq->front + 1) % pq->capacity;
	pq->size--;
	return true;
}

QDataType CircQueue2Front(CircQueue2* pq)
{
	assert(pq);
	assert(!CircQueue2Empty(pq));
	return pq->a[pq->front];
}

int CircQueue2Size(CircQueue2* pq)
{
	assert(pq);
	return pq->size;
}

// ---------------- 方案三:多记一个 tag ----------------

void CircQueue3Init(CircQueue3* pq, int capacity)
{
	assert(pq);
	assert(capacity > 0);
	pq->a = (QDataType*)malloc(sizeof(QDataType) * (size_t)capacity);
	assert(pq->a);
	pq->capacity = capacity;
	pq->front = 0;
	pq->rear = 0;
	pq->tag = 0;
}

void CircQueue3Destroy(CircQueue3* pq)
{
	assert(pq);
	free(pq->a);
	pq->a = NULL;
	pq->capacity = 0;
	pq->front = 0;
	pq->rear = 0;
	pq->tag = 0;
}

bool CircQueue3Empty(CircQueue3* pq)
{
	assert(pq);
	return pq->front == pq->rear && pq->tag == 0;
}

bool CircQueue3Full(CircQueue3* pq)
{
	assert(pq);
	return pq->front == pq->rear && pq->tag == 1;
}

bool CircQueue3Push(CircQueue3* pq, QDataType x)
{
	assert(pq);
	if (CircQueue3Full(pq))
	{
		return false;
	}
	pq->a[pq->rear] = x;
	pq->rear = (pq->rear + 1) % pq->capacity;
	pq->tag = 1;
	return true;
}

bool CircQueue3Pop(CircQueue3* pq, QDataType* out)
{
	assert(pq);
	if (CircQueue3Empty(pq))
	{
		return false;
	}
	if (out)
	{
		*out = pq->a[pq->front];
	}
	pq->front = (pq->front + 1) % pq->capacity;
	pq->tag = 0;
	return true;
}

QDataType CircQueue3Front(CircQueue3* pq)
{
	assert(pq);
	assert(!CircQueue3Empty(pq));
	return pq->a[pq->front];
}

int CircQueue3Size(CircQueue3* pq)
{
	assert(pq);
	// 满的时候 front 和 rear 又撞在一起了,裸公式会算出 0,得先判满
	if (CircQueue3Full(pq))
	{
		return pq->capacity;
	}
	return (pq->rear - pq->front + pq->capacity) % pq->capacity;
}
正常情况
先把整个目录编出来:
bash
# 所属目录:/home/cocatrice/ds08
gcc -std=gnu99 -Wall -Wextra -g queue.c seqqueue.c circqueue.c test.c -o test
./test
回显如下:
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./test
===== 链式队列 =====
入队 1 2 3 4 之后:队头 1,队尾 4,个数 4
出队两次之后:队头 3,队尾 4,个数 2
再入队 5 之后:队头 3,队尾 5,个数 3
出队 3
出队 4
出队 5
全部出完,空队列判断:是空

===== 数组队列 =====
数组队列:队头 1,队尾 3,个数 3
出队一次之后:队头 2,队尾 3,个数 2

===== 循环队列的三种写法 =====
容量 4 一直入队:方案一进去 3 个,方案二进去 4 个,方案三进去 4 个
各出队一次之后:队头分别是 2、2、2
方案一满了吗:没满,方案二:没满,方案三:没满
第一段验证链表队列的两端:入队四个之后队头是 1、队尾是 4,出队两次队头前进到 3,队尾留在 4,再入队 5 时队尾跟到 5。最后把剩下的三个依次出队,元素按 3、4、5 的顺序离开,这就是先进先出。
第二段是数组队列,行为一致,只是出队那一步在底层搬了一次数据,接口上看不出来。对照两边可以看出,数组队列的队头永远是下标 0 上的那个元素,出队之后剩下的元素整体往前挪一格,所以队列内容打印出来和链表队列一模一样。
接口一样、行为一样,这就是抽象的价值:使用方只关心入队出队的顺序,不关心底层是结点还是数组。要换实现时,函数名和参数都不用改,换一个头文件重新编译即可。
第三段把容量 4 的循环队列一直入队,方案一收下 3 个就满了,方案二和方案三各收下 4 个。差别来自方案一留了一个位置用来区分空和满,方案二靠 size、方案三靠 tag,位置都能用满。
这一组程序在 -Wall -Wextra 下编译零告警。这类代码最容易踩的两类告警,一类是比较有符号和无符号,比如把 size 定义成 int 却拿去和 sizeof 的结果比;另一类是函数声明了返回值却忘了写 return。加上这两个开关编译一遍,大部分笔误在编译期就被拦下来了,比等到运行时再查省事得多。
常见报错
第一组:空队列上出队。 出队之前没有判空,断言会当场拦下来。
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./exp/err_empty
出队一次之后,队列为空吗:是空
在空队列上再出队一次:
err_empty: queue.c:54: QueuePop: Assertion `!QueueEmpty(pq)' failed.
Aborted (core dumped)
[cocatrice@hcss-ecs-4cd1 ds08]$ echo $?
134
改法有两种。一种是像现在这样在函数里用断言,把错误挡在发生的当场;另一种是把 QueuePop 的返回值改成 bool,让调用者自己判断。前一种适合自己写自己用的场景,后一种适合接口要给别人用的场景。
两种改法背后的取舍是错误该在哪一层被处理。断言把责任放在调用者身上:你答应过不为空,现在为空了,程序立刻停下,问题现场完整保留。返回错误码把责任放在被调用者身上:函数不崩,如实报告,由上层决定是重试、是跳过还是记一条日志。库函数不能用断言,因为它控制不了使用方的输入;小程序里断言更好用,因为崩溃的位置就是错误的位置。
第二组:出队删掉最后一个结点时忘了把 rear 置空。 这个错误当场看不出来,程序照常跑完,只有 valgrind 能抓住。
text
[cocatrice@hcss-ecs-4cd1 ds08]$ valgrind ./exp/err_rear
==7234== Invalid write of size 8
==7234==    at 0x400621: Push (err_rear.c:31)
==7234==    by 0x4006EB: main (err_rear.c:55)
==7234==  Address 0x5205048 is 8 bytes inside a block of size 16 free'd
==7234==    at 0x4C2B06D: free (vg_replace_malloc.c:540)
==7234==    by 0x40065C: Pop (err_rear.c:39)
==7234==    by 0x40069E: main (err_rear.c:51)
==7234==  Block was alloc'd at
==7234==    at 0x4C29F73: malloc (vg_replace_malloc.c:309)
==7234==    by 0x4005D5: Push (err_rear.c:21)
==7234==    by 0x400692: main (err_rear.c:50)
==7234==
出队之后 front 是 空,rear 是 非空
再入队一个,新结点的数据是 2
==7234== LEAK SUMMARY:
==7234==    definitely lost: 16 bytes in 1 blocks
==7234== ERROR SUMMARY: 1 errors from 1 contexts
出队之后 front 已经是空,rear 却还指着那块刚释放的内存,再入队时新结点的地址被写进了一个已经归还的块里。程序打印出来的结果看着正常,写的却是别人的内存。改法就是出队之后补一句判断:
c
# 文件:/home/cocatrice/ds08/queue.c
	pq->front = next;
	if (pq->front == NULL)
	{
		pq->rear = NULL;
	}
	pq->size--;
第三组:判满漏了取模。 把 (pq->rear + 1) % pq->capacity == pq->front 写成 pq->rear + 1 == pq->front,在数组没绕圈的时候还能用,一旦 rear 走到末尾就失效。绕圈实验里容量 3、放满 1 2 3 时,front 是 0、rear 也是 0,此时判满应当成立;如果代码写的是 rear + 1 == front,就会得出没满的结论,下一次入队直接覆盖掉队头元素。
第四组:容量传成 0 或负数。 数组是 malloc 出来的,容量为 0 时一块内存都申请不到,后面每一次取模都会除以 0。
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./exp/err_cap
先试容量 0:
err_cap: circqueue.c:83: CircQueue2Init: Assertion `capacity > 0' failed.
Aborted (core dumped)
这类参数错误在入口处断言掉最合适,错误位置离原因只有一个函数的距离。如果放任它往下跑,崩溃会发生在第一次入队或者出队的时候,那时候栈已经绕了几层,定位反而更费劲。
边界情况
容量取 1、2、3 这三种极端值,三种方案的表现:
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./exp/boundary
容量 1 一路入队:方案一收下 0 个,方案二 1 个,方案三 1 个
  方案三满的时候:裸公式算出 0,Size 接口给的是 1
  各出队一次:方案一是空的,方案二拿到 1,方案三拿到 1
  出队之后长度 0、0、0,空判断 1、1、1,满判断 1、0、0

容量 2 一路入队:方案一收下 1 个,方案二 2 个,方案三 2 个
  方案三满的时候:裸公式算出 0,Size 接口给的是 2
  各出队一次:方案一拿到 1,方案二拿到 1,方案三拿到 1
  出队之后长度 0、1、1,空判断 1、0、0,满判断 0、0、0

容量 3 一路入队:方案一收下 2 个,方案二 3 个,方案三 3 个
  方案三满的时候:裸公式算出 0,Size 接口给的是 3
  各出队一次:方案一拿到 1,方案二拿到 1,方案三拿到 1
  出队之后长度 1、2、2,空判断 0、0、0,满判断 0、0、0

容量 3 的绕圈实验(方案二):
  放满 1 2 3:长度 3,front=0 rear=0
  出队两次(1、2):长度 1,front=2 rear=0
  再放 4 5:长度 3,front=2 rear=2
  依次出队:3 4 5
容量 1 那一组最能说明问题:留一个空位的方案连一个元素都放不下,因为区分空和满所必需的那一个位置,就是全部的空间。容量 1 的队列在实际中确实会用到,比如同步用的信号量、单元素的消息槽,写这类代码时不要选留空位这一种。
方案三那三行的对比也值得看:满的时候两个下标相等,裸公式算出 0,Size 接口因为先判了满,给出的是容量。同一个队列,两个数差了一整个容量。
绕圈实验回答了另一个问题:队列绕回来之后还能不能正确出队。容量 3 的表放满 1 2 3 时 front 和 rear 都是 0,出队两次之后 front 走到 2、rear 仍在 0,再放 4 和 5,第一次写入落在下标 0,第二次落在下标 1,rear 从 0 走到 1 再到 2,中途绕过了数组末尾,最后按 3、4、5 的顺序出队,顺序没有乱。
容量取多少合适,也是边界的一部分。容量定得太小,入队频繁失败;定得太大,一块内存长期闲置。判断依据是同一个时刻队列里最多会积压多少元素,这个值可以从压测里量出来:把水位最高的那一刻记下来,再留一点余量。前面对生产者消费者的估算给的就是这个水位,估出来是 7,容量取 8 刚好,取 100 就浪费了九成。
三种写法在空队列上的表现也要确认一遍。容量 1 的那一组里,方案一入队 0 个之后就直接进入空状态,出队接口返回失败,判空给出 1;方案二和方案三各放进去 1 个,出队拿到 1,判空同样给出 1。三种写法在空队列上的判空结果一致,区别只在能装多少。满队列上的表现也一致:方案一还有空位就用不上满的判断,方案二和方案三在放满之后入队返回失败,不覆盖已有数据。
实测数据
出队耗时:链表队列与数组队列对照。 两个队列都先放满 n 个元素,再依次全部出队,只给这一段计时,n 取 2000、10000、50000。
bash
# 所属目录:/home/cocatrice/ds08
gcc -std=gnu99 -Wall -Wextra -O2 exp/speed.c queue.c seqqueue.c -o exp/speed
./exp/speed
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./exp/speed
元素个数 链表队列出队 数组队列出队 倍数
2000       0.027            0.194            7.1
10000      0.131            3.938            30.0
50000      0.720            115.278          160.0
把耗时折算到每一次出队,差距更直观:
| 元素个数 | 链表队列单次出队 | 数组队列单次出队 |
|---|---|---|
| 2000 | 0.0135 微秒 | 0.097 微秒 |
| 10000 | 0.0131 微秒 | 0.394 微秒 |
| 50000 | 0.0144 微秒 | 2.306 微秒 |
链表队列的单次出队稳定在十几纳秒,和元素个数几乎无关;数组队列从 0.097 微秒一路涨到 2.306 微秒,涨了二十多倍,因为它每出队一次,要搬动的元素数量跟着队列长度一起长。
三行数据把两条曲线的差别摆得很清楚。链表队列的耗时基本跟着元素个数线性走,数据量翻五倍,耗时也从 0.027 毫秒涨到 0.131 毫秒,再涨到 0.720 毫秒。数组队列不一样:2000 个元素时 0.194 毫秒,10000 个时 3.938 毫秒,数据量翻五倍,耗时涨了二十倍;再到 50000 个,耗时 115.278 毫秒,又翻了二十九倍。这正是 O(n) 操作被调用 n 次的结果,整体是平方级的。
两者的倍数从 7.1 倍一路涨到 160 倍,而且这个差距只会随着数据量继续拉大。队列一出队就搬数据的写法,在小数据量下看不出问题,数据一多就露馅。
差距里还藏着一层缓存的因素。链表队列每出队一个元素都要 free 一次,结点分散在堆上的各个位置,处理器每次访问都要重新加载缓存行;数组队列的元素挨在一起,搬运本身是顺序读写,缓存命中的比例高得多。这一层在这组数据里没有单独量出来,但在元素更小、数量更大的场景下会更明显。计时只覆盖出队这一段,入队和申请内存的开销都在计时之外,所以这两列的对比说的是两种出队方式的差别,不是两种队列的整体优劣。
valgrind 检查。
bash
# 所属目录:/home/cocatrice/ds08
valgrind --leak-check=full ./test
text
==6692== HEAP SUMMARY:
==6692==     in use at exit: 0 bytes in 0 blocks
==6692==   total heap usage: 9 allocs, 9 frees, 144 bytes allocated
==6692==
==6692== All heap blocks were freed -- no leaks are possible
==6692==
==6692== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
九次申请对应九次释放:链表队列在整个测试里申请过七个结点,两段数组队列各申请了一块连续空间,销毁时全部归还,没有泄漏也没有越界。
实例:两个小程序
生产者消费者。 缓冲区用容量 8 的循环队列,每轮生产者尝试放两个,消费者取一个,跑十二轮,把每一轮的队列长度画出来。
bash
# 所属目录:/home/cocatrice/ds08
gcc -std=gnu99 -Wall -Wextra -g exp/prodcons.c circqueue.c -o exp/prodcons
./exp/prodcons
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./exp/prodcons
缓冲区容量 8,每轮生产者想放 2 个,消费者取 1 个

第  1 轮  放 2 取 1  长度 1  =
第  2 轮  放 2 取 1  长度 2  ==
第  3 轮  放 2 取 1  长度 3  ===
第  4 轮  放 2 取 1  长度 4  ====
第  5 轮  放 2 取 1  长度 5  =====
第  6 轮  放 2 取 1  长度 6  ======
第  7 轮  放 2 取 1  长度 7  =======
第  8 轮  放 1 取 1  长度 7  =======
第  9 轮  放 1 取 1  长度 7  =======
第 10 轮  放 1 取 1  长度 7  =======
第 11 轮  放 1 取 1  长度 7  =======
第 12 轮  放 1 取 1  长度 7  =======

一共放进去 19 个,取出来 12 个,缓冲区里还剩 7 个
前七轮生产比消费快,队列长度一轮涨一个,涨到 7 就停住了。第七轮结束时缓冲区里有 7 个元素,容量 8 的循环队列,方案二最多放 8 个,此时还能再放一个,但生产者的节奏是每轮两个,放第二个的时候已经满了,于是只能放进去一个。从第八轮开始,放一个、取一个,长度稳定在 7,这就是缓冲区的作用:上游快出来的部分被存住,没有丢,也没有把下游压垮。
真实系统里的这一步还有两种选择。一种是生产者发现队列满了就阻塞等待,等消费者取走一个再继续,这就是阻塞队列;另一种是直接丢弃新数据或者丢弃最旧的数据,比如日志缓冲区和视频的帧缓冲。选哪一种取决于数据能不能丢:订单不能丢,监控的采样点丢几个没关系。
这个模拟里只有一条执行流,生产者和消费者是轮流登场的,所以队列满、队列空都不会真的等待,接口返回失败就跳过去。换成两条线程之后,满和空就变成需要等待的条件,那时候要配一把锁和一个条件变量,队列本身的结构不会变,变的只是谁来唤醒谁。
迷宫最短路。 6 行 8 列的格子,0 是通路,1 是墙,用队列从左上角开始一层一层往外扩,每一格的最短步数一次算出来。
bash
# 所属目录:/home/cocatrice/ds08
gcc -std=gnu99 -Wall -Wextra -g exp/bfs.c queue.c -o exp/bfs
./exp/bfs
text
[cocatrice@hcss-ecs-4cd1 ds08]$ ./exp/bfs
迷宫:S 是起点,E 是终点,█ 是墙
S . . █ . . . .
. █ . █ . █ . .
. █ . . . █ █ .
. . . █ . . . .
█ █ . █ █ █ . .
. . . . . . . E

每一格的最短步数(-1 表示走不到):
  0  1  2 -1  8  9 10 11
  1 -1  3 -1  7 -1 11 12
  2 -1  4  5  6 -1 -1 11
  3  4  5 -1  7  8  9 10
 -1 -1  6 -1 -1 -1 10 11
  9  8  7  8  9 10 11 12

从左上角走到右下角,最少 12 步
起点入队时步数是 0,每取出一个位置,就把它的上下左右四个邻居里还没走过的入队,步数加一。队列保证了先入队的先被处理,所以访问顺序天然是从近到远,第一次走到某一格时的步数就是最短步数。表里右上角那一格是 11 步,它左边隔着墙,只能从下方绕过去;右下角是 12 步。有几格是 -1,被墙围住了,从起点到不了。
这段代码里有两个细节值得记下来。dist 数组既记步数又当访问标记用,初始化为 -1 表示还没走到,这样就不用再开一个 visited 数组;队列里放的是位置编码而不是行列两个数,一个 int 就能装下,取出来的时候除一次、取一次模就还原成行列。整个算法的复杂度是 O(行 × 列),每个格子最多入队一次,队列的容量上限也就是格子的总数。
踩坑点
- 出队删掉最后一个结点时,必须把 rear 一起置空,否则它指着已经释放的内存,下一次入队会写到别人的块里。
- 只存头指针的单链表做不了 O(1) 的尾插,队列至少要两个指针,一个管出、一个管进。
- front 指向队头元素、rear 指向队尾的下一个位置,这个约定全篇要统一,混用之后长度和判满都会算错。
- 判满条件里的取模不能省,写成 rear + 1 == front 在数组绕圈之后立刻失效。
- 有效长度用 (rear - front + capacity) % capacity,先补一个 capacity 是为了让 rear 小于 front 时不出负数。
- 满的时候这个公式可能算出 0,tag 方案必须先判满再决定用不用公式。
- 留一个空位的方案,容量 n 的表只能放 n - 1 个元素,容量是 1 时一个都放不下。
- 数组队列出队用 memmove 搬数据是 O(n),整体一跑就是平方级,五万个元素比链表队列慢一百六十倍。
- 数组队列让头尾都往后走、不做绕圈的写法会出现假满,前面空着也放不进新元素。
- 空队列上出队、取队头都要先判空,断言或者返回错误码都行,直接取值会把已释放的内存读出来。
- 循环队列的下标取模之前,capacity 必须大于 0,初始化时用断言把 0 和负数挡掉。
- 出队取元素建议用出参返回,函数返回值留给成功与否,调用者才有机会处理满和空这两种正常情况。
- 初始化时容量必须大于 0,容量为 0 会在第一次取模时除以 0,入口处断言挡掉最省事。
- 取长度不要直接写 rear - front,绕圈之后这一式会算出负数。
- 看到两个下标相等就判断队列为空,只在留空位的方案里成立,tag 方案里满也是相等。
- 队列用作出参的那个参数要判空指针,允许调用者只关心成功与否、不关心丢的是哪个元素。
本篇总结(模拟面试问题)
问:队列和栈的区别是什么?
核心要点:两者都是操作受限的线性表,接口条数一样,限制的位置反了。栈只允许在一端插入和删除,后进先出;队列在一端插入、另一端删除,先进先出。需要按到达顺序处理用队列,需要把最近的先处理用栈。
问:队列为什么常用链表实现,不常用数组?
核心要点:队列两端都要动,单链表加一个尾指针就能让头删尾插都是 O(1)。数组实现如果队头固定在下标 0,出队要把剩下的元素整体前移,是 O(n);如果不搬数据,让头尾都往后走,又会出现假满。要用数组就得绕成循环队列。
问:循环队列怎么区分队空和队满?
核心要点:三种办法。留一个空位,两个下标相等是空、队尾再走一步撞上队头是满,代价是浪费一个位置;多记一个 size,看它是 0 还是等于容量;多记一个 tag,记录上一次是入队还是出队,两个下标相等时靠它区分。后两种位置都能用满。
问:循环队列的有效长度怎么算,为什么先加一个 capacity?
核心要点:(rear - front + capacity) % capacity。rear 没绕圈时长度是 rear - front;绕圈之后 rear 反而比 front 小,差值是负数,先把 capacity 加回去变成正数,再取模把没绕圈时多加的那一份去掉。
问:留一个空位的写法,容量 n 的队列最多放几个元素?
核心要点:n - 1 个。至少要空出一个位置,才能把满和空这两种状态区分开。容量是 1 的时候一个元素都放不下,因为区分状态要用的那个位置就是全部空间。同步用的信号量和单元素消息槽经常会遇到容量 1,这种场合不要用留空位的写法。
问:为什么循环队列里 front 和 rear 相等时,既可能是空也可能是满?
核心要点:两个下标只记录了位置,没有记录数量。绕圈之后,元素个数是容量的整数倍时,两个下标都会撞在一起。空的时候相等、满的时候也相等,所以必须再引入一个信息,要么牺牲一个位置,要么记 size,要么记最后一次操作的方向。
问:出队之后为什么要把 rear 也置空?
核心要点:队列为空时两个指针都应该是 NULL。出队把最后一个结点释放掉之后,front 跟着变成 NULL,rear 还指着那块已释放的内存。这时再入队,会先访问 rear 所在的块,属于使用已释放的内存,valgrind 会直接报出来。
问:队列能不能用数组做,容量不够了怎么办?
核心要点:能用,做法是循环队列,容量在初始化时定死,满了就返回失败。要支持动态扩容得自己写:申请一块两倍大的新数组,把元素按顺序从 front 开始逐个搬到新数组的下标 0 开始的位置,再把 front 置 0、rear 置成元素个数。搬完之后旧数组释放,容量变成两倍。要注意的是扩容之后所有下标都变了,如果外部保存过下标,那些下标全部失效。
问:BFS 为什么用队列,不用栈?
核心要点:BFS 要按层访问,离起点近的先处理。队列先进先出,入队顺序就是层序;用栈会变成后进先出,访问顺序退化成了深度优先,第一次到达某一格的步数不再是最短的。
参考
- 队列这种结构的通用介绍:https://oi-wiki.org/ds/queue/
- 队列的数组实现与链表实现,带图解:https://www.geeksforgeeks.org/dsa/queue-data-structure/
- 循环队列的引入与数组实现:https://www.geeksforgeeks.org/dsa/introduction-to-circular-queue/
- 用队列做广度优先搜索:https://oi-wiki.org/graph/bfs/
- 顺序容器与适配器的对照,含队列的接口说明:https://en.cppreference.com/cpp/container/queue
- memmove 手册页,出队搬数据那一步的依据:https://man7.org/linux/man-pages/man3/memmove.3.html