Through Their Eyes:用简单对齐实现跨被试与跨数据集视觉脑解码
原论文:Through their eyes: Multi-subject brain decoding with simple alignment techniques
作者:Matteo Ferrante、Tommaso Boccato、Furkan Ozcelik、Rufin VanRullen、Nicola Toschi
期刊:Imaging Neuroscience, Volume 2, 2024
30 秒看懂这篇论文
视觉 fMRI 解码长期依赖"每个被试单独训练一个模型"。Ferrante 等人的核心问题是:如果已经有一个训练充分的单被试解码器,能否只用少量共同刺激学习一个跨被试对齐变换,然后直接解码新被试?
答案是可以,但关键不是把脑图像在解剖上配准到同一 MNI 空间,而是把新被试的功能活动映射到解码器所属被试的功能空间。论文比较了 anatomical alignment、hyperalignment 和基于 Ridge Regression 的 functional alignment,并把对齐后的活动输入已有的 Brain-Diffuser 解码器。
最重要的结果有三点:第一,Ridge Regression 在约 10% 的共同刺激数据(952 张图像)下,就能达到接近单被试解码的表现;第二,解剖对齐在细粒度图像解码上接近 chance,而功能对齐明显有效;第三,在 BOLD5000 和 THINGS 等不同数据集之间,只要存在共同或语义相近的图像,也能进行高于 chance 的跨数据集解码。
1. 研究缺口:为什么单被试解码难以扩展?
fMRI 的空间分辨率高,但个体间的解剖结构、功能分区和神经反应拓扑并不完全一致。一个在 Subj01 上学习到的 voxel-to-image 映射,不能直接套到 Subj02 的同名 voxel 上。传统做法是为每个新被试重新采集大量刺激并重新训练解码器,这在 Natural Scenes Dataset(NSD)这样的实验中可能意味着每人近 20 小时扫描。
论文把问题拆成两个部分:一是训练一个强大的参考解码器,二是学习一个低成本的被试间功能映射。这样,新被试不需要再完整重复训练集,只需观看一小部分与参考被试相同的刺激,用这些共同反应估计对齐变换。
这种设定和"训练一个从所有被试输入到共享表示的统一大模型"不同。作者的策略更像一个 plug-and-play 适配器:解码器保持不变,对齐模块只处理输入活动。
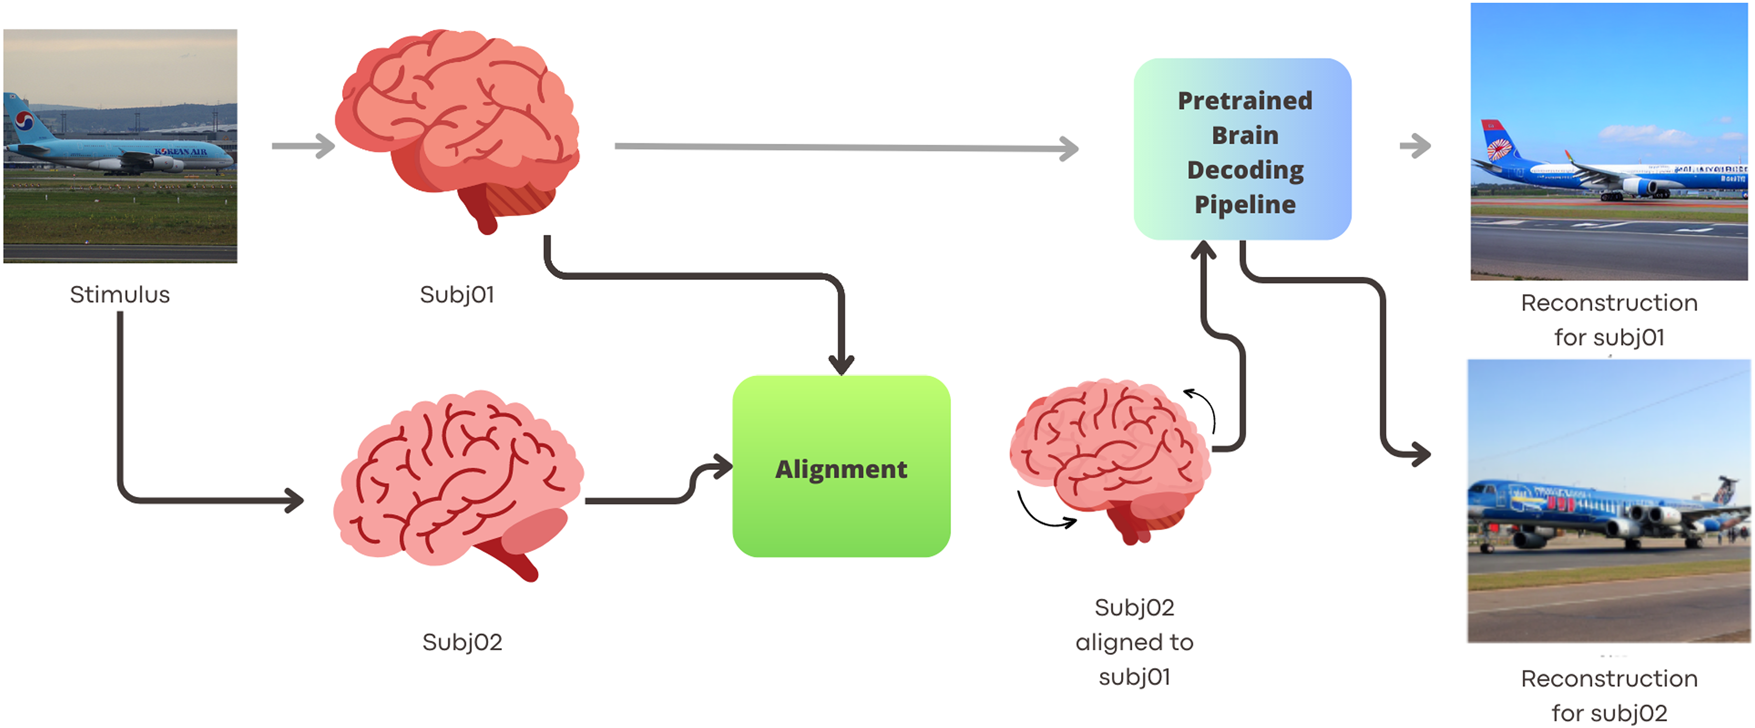
来源:原论文 Figure 1,PDF 第 3 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
Figure 1 的信息流很清楚:Subj01 的 8,859 张独有图像用于训练 Brain-Diffuser;Subj02 只需要对共同图像产生 fMRI 活动,通过 alignment 学到映射,再把完整活动送入 Subj01 的解码器。测试图像不参与解码器训练,也不参与对齐学习。
2. 研究设计:共同刺激是跨被试的"标尺"
2.1 NSD 数据与样本划分
作者从 NSD 的八名参与者中选取 Subj01、Subj02、Subj05 和 Subj07。每名被试有约 10k 张自然图像的 fMRI 反应;四名被试共同看过 982 张图像。为了给定量评估留出严格的不可见样本,作者从共同图像中保留 30 张用于可视化,剩余 952 张作为 alignment set 和量化测试集。
这里有一个容易混淆的点:952 张图像用于学习功能映射,同时论文在这些图像上评估解码性能;但它们没有用于 Subj01 解码器的训练,因此对"解码器是否看过这些刺激"而言是 held-out 的。另有 30 张图像既不用于解码器训练,也不用于对齐,用于 Figure 2、4 等定性展示。
预处理使用 NSDGeneral ROI,聚焦视觉皮层;原始体素分辨率约为 1.8 mm isotropic,随后把 MNI 空间的 beta 下采样到 2 mm。时间维度不直接使用完整 BOLD 序列,而是使用结合 HRF 和去噪后的 GLM beta 系数。这是当前自然图像 fMRI 解码常见的 trial-level 表示,但也意味着试次之间并非完全独立的原始时间点。
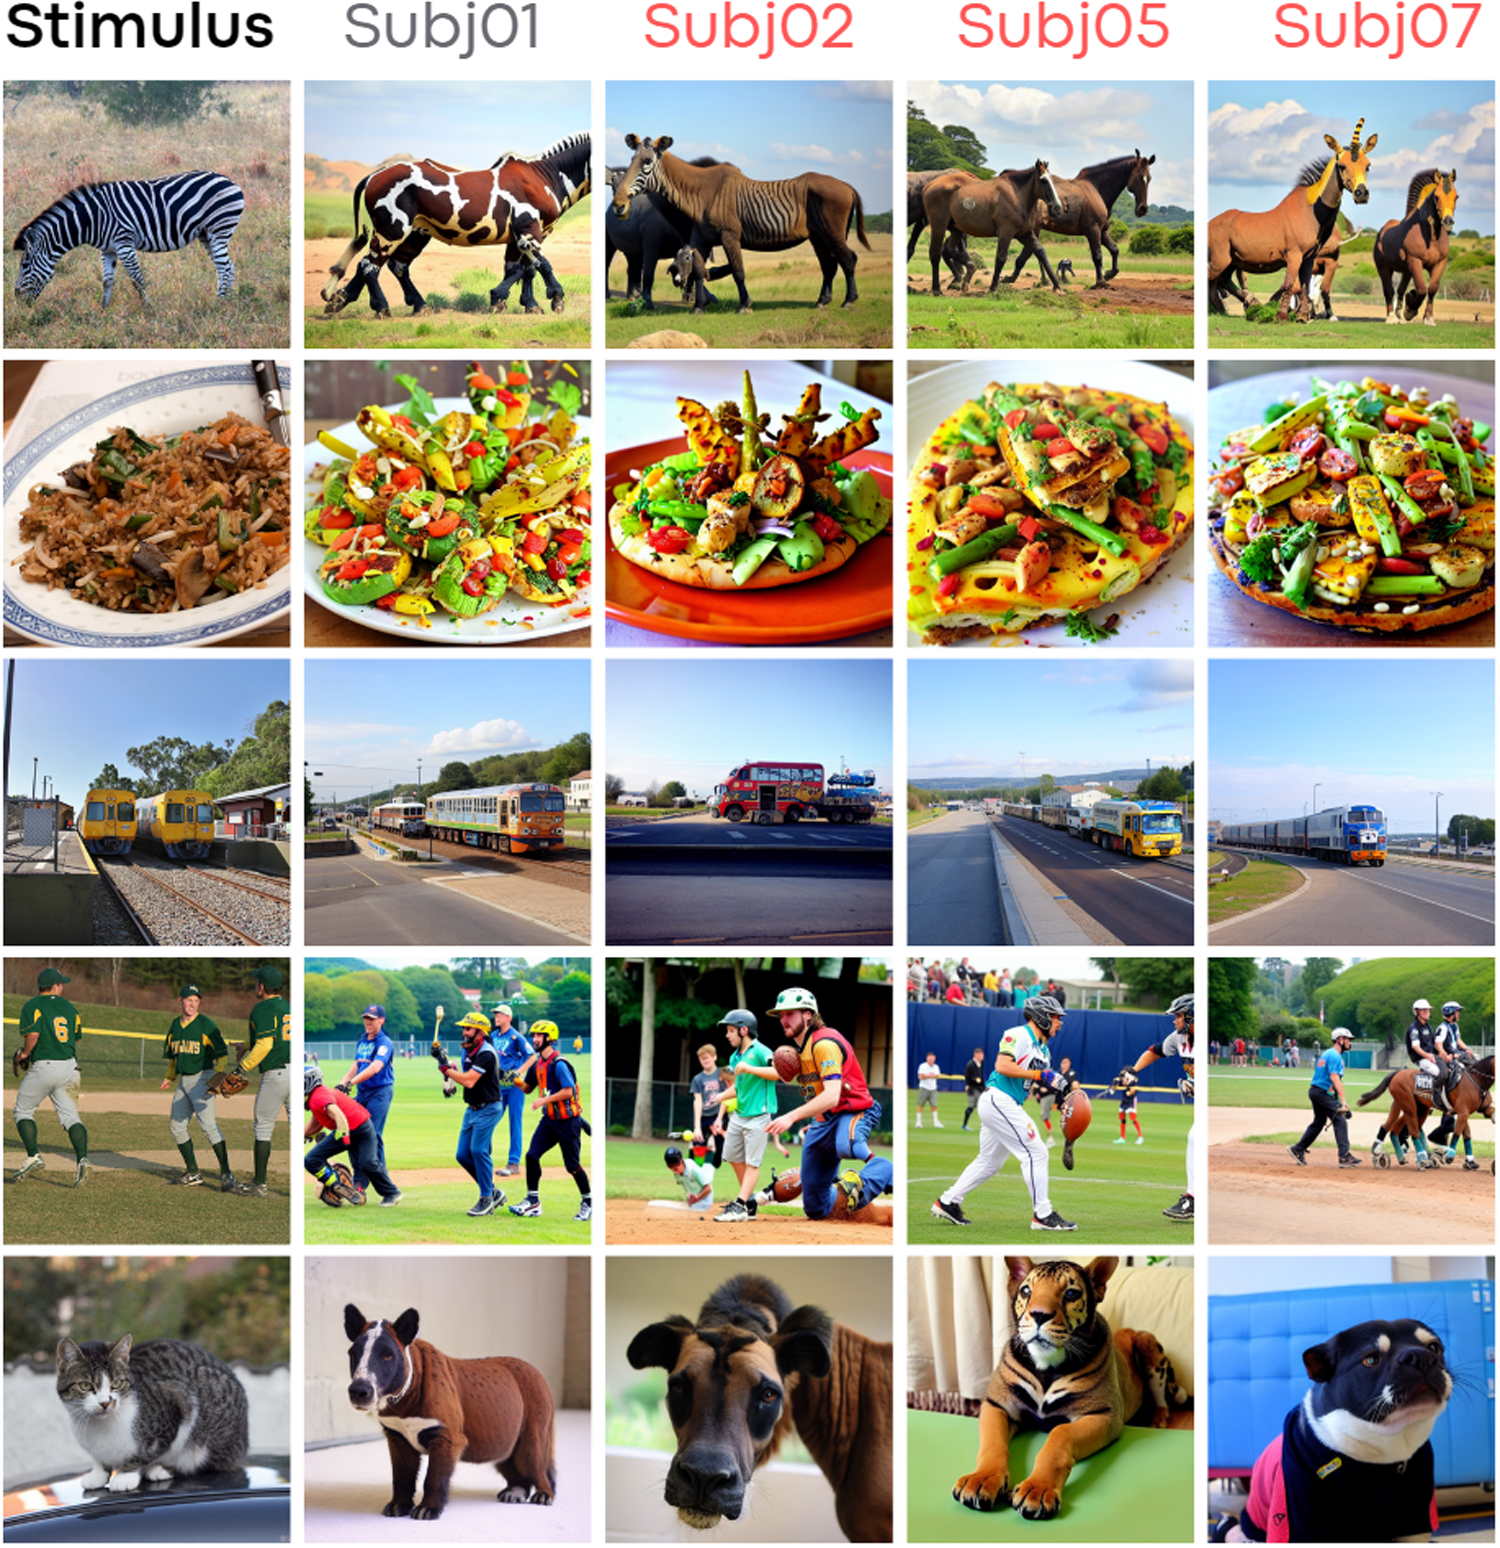
来源:原论文 Figure 2,PDF 第 4 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
Figure 2 中 Subj01 是单被试解码基线,其他列是不同被试经过 Ridge Regression 对齐后,用同一个 Subj01 解码器重建的结果。作者特别强调展示图像没有参与对齐学习,因此可以观察跨被试方法对未见刺激的视觉重建能力。
2.2 Brain-Diffuser:固定的下游解码器
Brain-Diffuser 是一个两阶段图像重建框架。第一阶段用 Very Deep Variational Autoencoder(VDVAE)估计图像的低层 latent,形成初始重建;同时用线性模型从 fMRI 预测 CLIP-Text 和 CLIP-Vision 表征。第二阶段把这些估计的 latent 和 CLIP 表征输入 Versatile Diffusion,生成最终图像。
本文并不把 Brain-Diffuser 本身作为主要创新,而是把它固定为跨被试实验的下游 decoder。这样比较的主要对象是输入活动是否被正确映射,而不是新解码器架构是否更强。
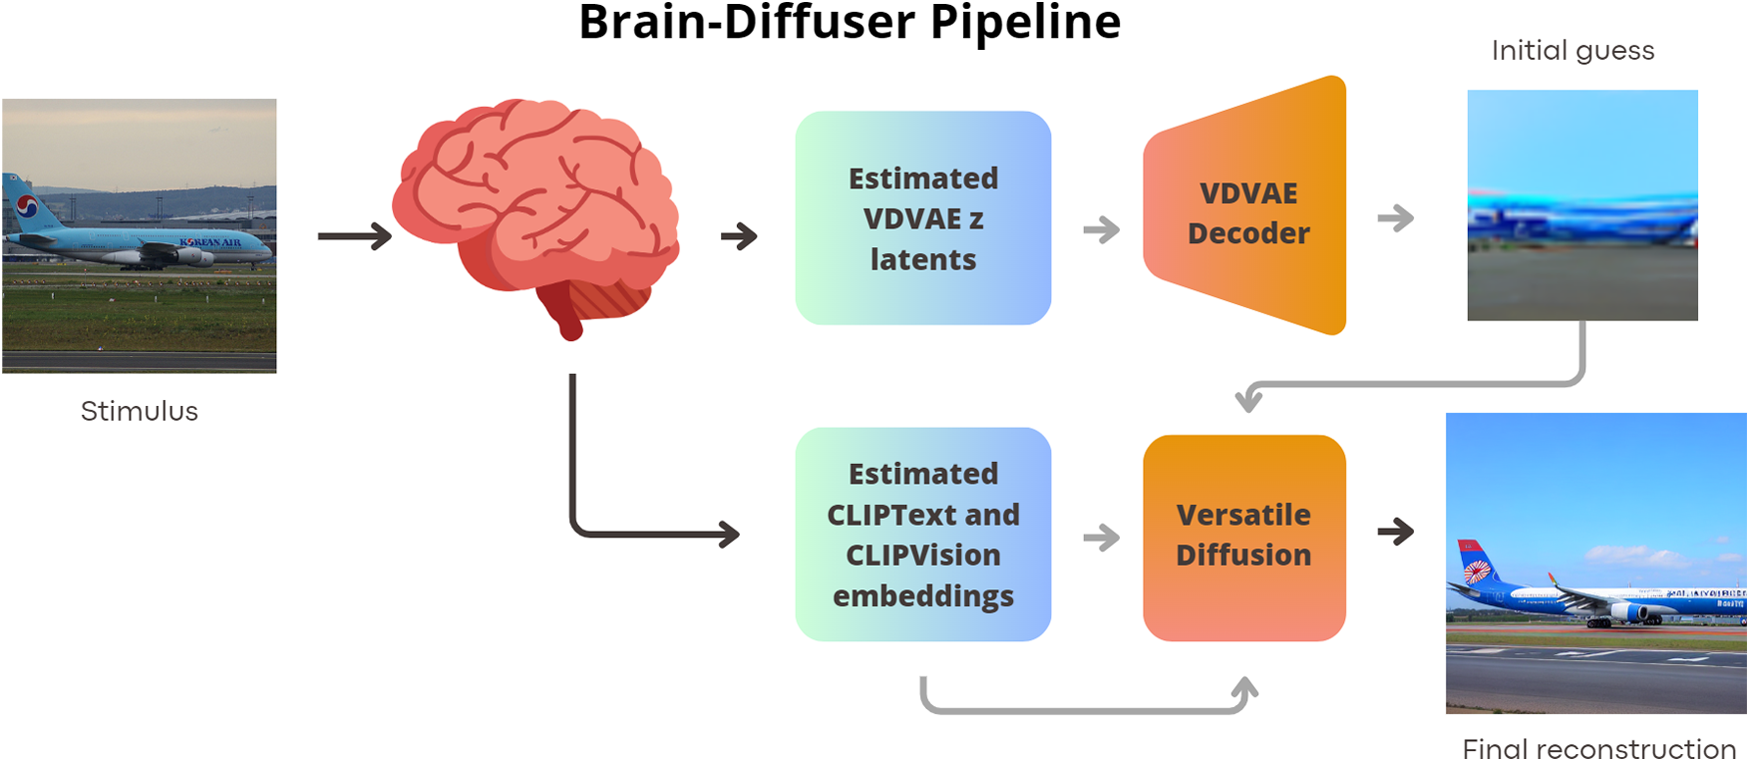
来源:原论文 Figure 3,PDF 第 6 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
3. 三种对齐方法
3.1 Anatomical alignment
Anatomical alignment 只依赖结构像配准,把不同被试的活动变换到 MNI common space。它是必要的空间标准化基线,但并不保证功能选择性区域在不同人脑中的位置和方向一致。对细粒度视觉表征而言,"同一个 MNI 坐标"不等于"同一个功能通道"。
3.2 Hyperalignment
Hyperalignment 用共同刺激下的高维反应模式,寻找 source 和 target 功能空间之间的旋转与尺度变换。设共同刺激下的活动矩阵为 S c o m m o n S_{\mathrm{common}} Scommon 和 T c o m m o n T_{\mathrm{common}} Tcommon,方法通过 Procrustes 分析寻找旋转矩阵 R R R,使得:
min R , c ∥ c S c o m m o n R − T c o m m o n ∥ 2 2 . \min_{R,c}\left\lVert cS_{\mathrm{common}}R-T_{\mathrm{common}}\right\rVert_2^2. R,cmin∥cScommonR−Tcommon∥22.
论文中先计算 P = S c o m m o n T T c o m m o n P=S_{\mathrm{common}}^{\mathsf T}T_{\mathrm{common}} P=ScommonTTcommon 的奇异值分解,再由左右奇异向量得到 R R R,并估计尺度 c c c。它显式利用了共同刺激的功能结构,但高维 Procrustes 对数据质量和计算资源更敏感。
3.3 Ridge Regression alignment
Ridge Regression 采用更直接的线性假设:目标被试每个 voxel 的共同刺激响应,可以表示为源被试所有 voxel 响应的线性组合。令 S S S 为 source 活动、 T T T 为 target 活动,寻找矩阵 W W W:
min W ∥ S W − T ∥ 2 2 + α ∥ W ∥ 2 2 . \min_W\left\lVert SW-T\right\rVert_2^2+\alpha\left\lVert W\right\rVert_2^2. Wmin∥SW−T∥22+α∥W∥22.
其中第一项要求映射后的活动接近 target,第二项抑制高维线性回归的过拟合。作者用 5-fold cross-validation 从 α ∈ { 0 , 1 , 10 , 10 2 , 10 3 , 10 4 } \alpha\in\{0,1,10,10^2,10^3,10^4\} α∈{0,1,10,102,103,104} 中选择正则化强度,最终采用 α = 1000 \alpha=1000 α=1000。
重要的是,W 只用共同刺激学习一次,然后应用于 source 被试的共同和非共同活动。它不是为每个下游指标单独调参,也没有修改 Brain-Diffuser 的权重。
4. 结果一:功能对齐比解剖对齐更关键
作者使用 PixCorr、SSIM、AlexNet 第 2/5 层、Inception、CLIP latent space 和 Direct CLIP 2-way accuracy 评估重建。前两类指标偏向像素和结构相似性,后几类指标更接近视觉语义或表征空间中的识别能力。Direct CLIP 直接评估解码线性层预测的 CLIP 分类 embedding,可减少最终扩散生成器带来的混杂。
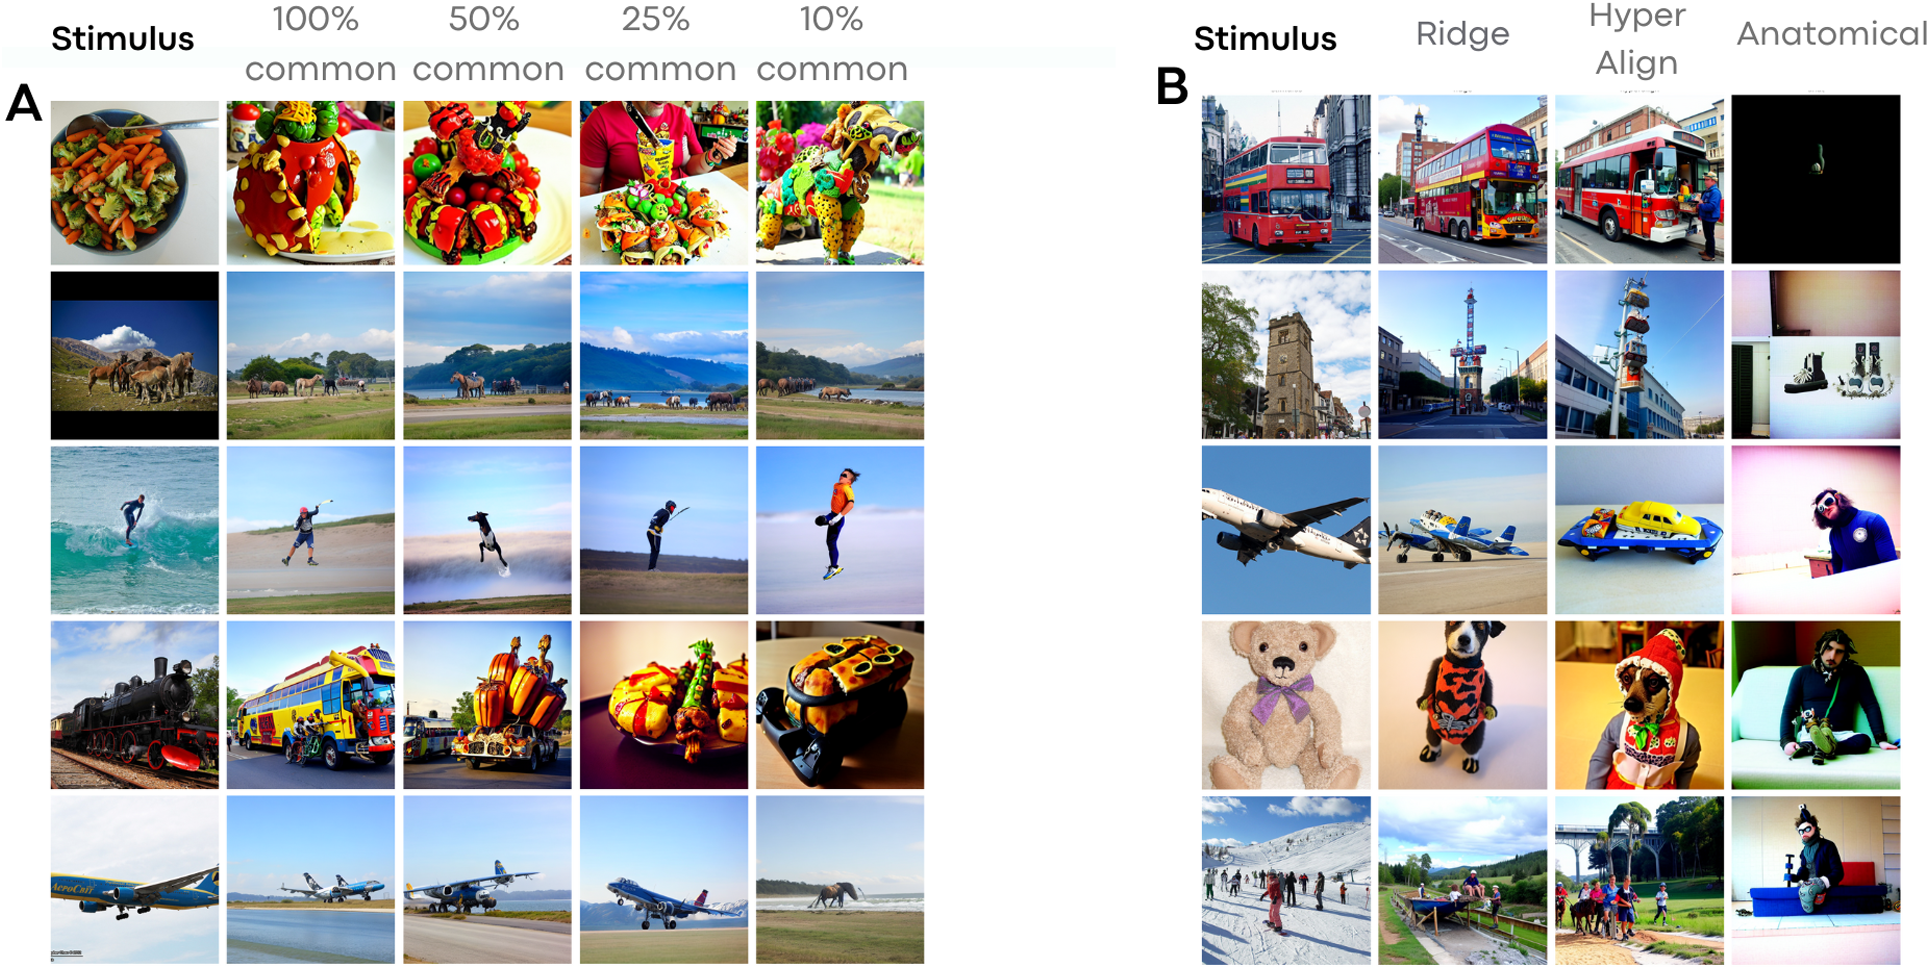
来源:原论文 Figure 5,PDF 第 9 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
Figure 5A 展示 Ridge Regression 在 100%、50%、25% 和 10% 共同数据下的结果。共同数据越多,重建通常越接近刺激;Figure 5B 则显示 anatomical alignment 的结果大多缺乏可靠的语义对应,而 Ridge 和 hyperalignment 能恢复物体类别、布局和颜色等高层信息。
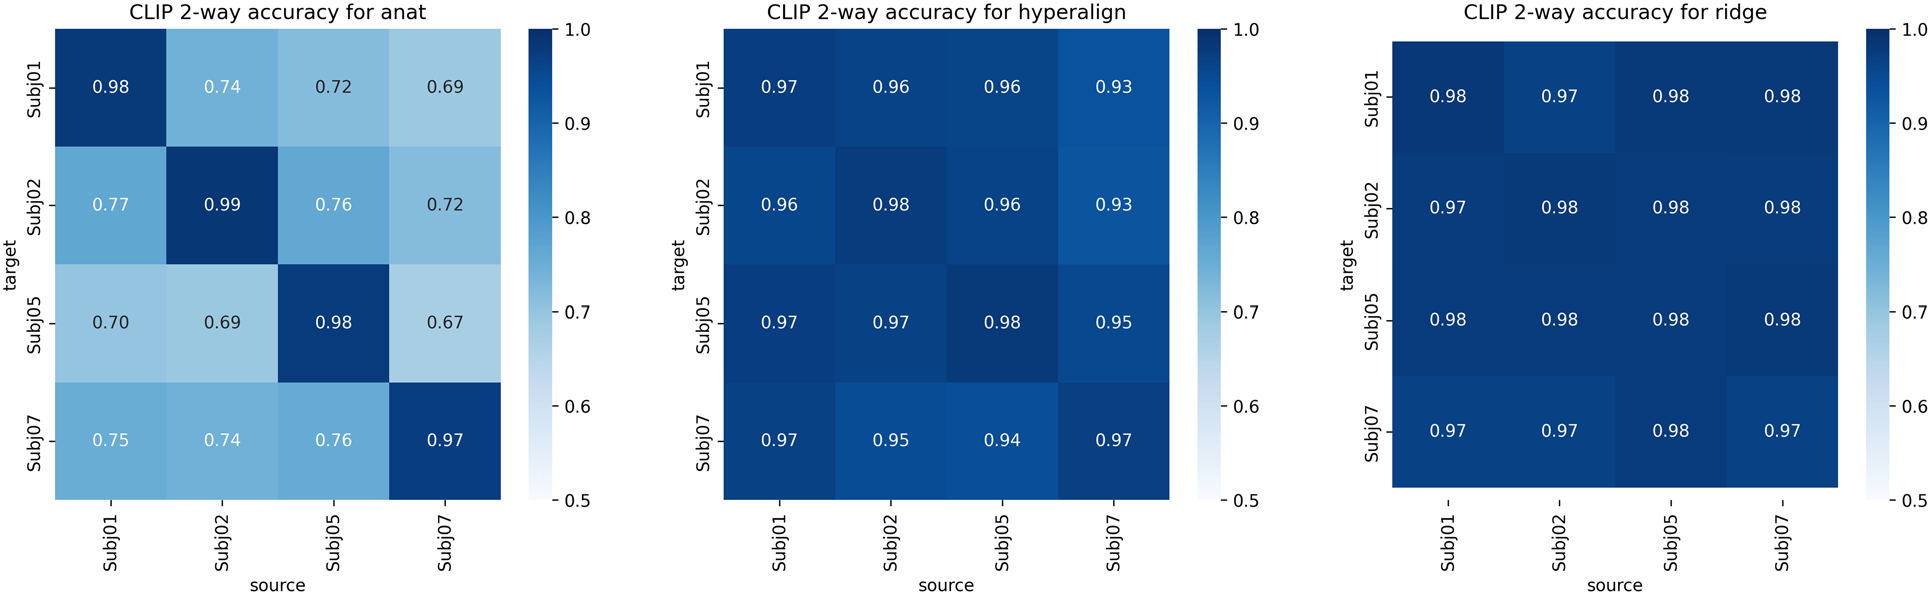
来源:原论文 Figure 6,PDF 第 10 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
Figure 6 的对角线是 within-subject decoding,非对角线是跨被试 decoding。解剖对齐时,只有对角线较高;使用 hyperalignment 或 Ridge 后,非对角线也接近对角线。这是一个比单组平均分更有说服力的结果:同一个解码器在被对齐的新被试上,能够获得接近参考被试的直接 CLIP 识别能力。
在完整 952 张对齐图像下,论文 Table 1 给出的 CLIP 2-way accuracy 例如为:Subj01 作为 target 时,Ridge cross-subject 为 0.7420,within-subject 为 0.8126;Subj02 target 时 Ridge cross 为 0.7299,within 为 0.6909;Subj05 target 时 Ridge cross 为 0.7323,within 为 0.7250;Subj07 target 时 Ridge cross 为 0.7323,within 为 0.7591。跨被试结果并非每次都低于 within-subject,可能反映对齐过程对共同视觉信息具有去噪效果。
5. 结果二:只用约 10% 数据就接近单被试表现
作者把共同数据量进一步缩小到 95、238、476 和 952 张,约占每名被试完整数据的 1%、2.5%、5% 和 10%。
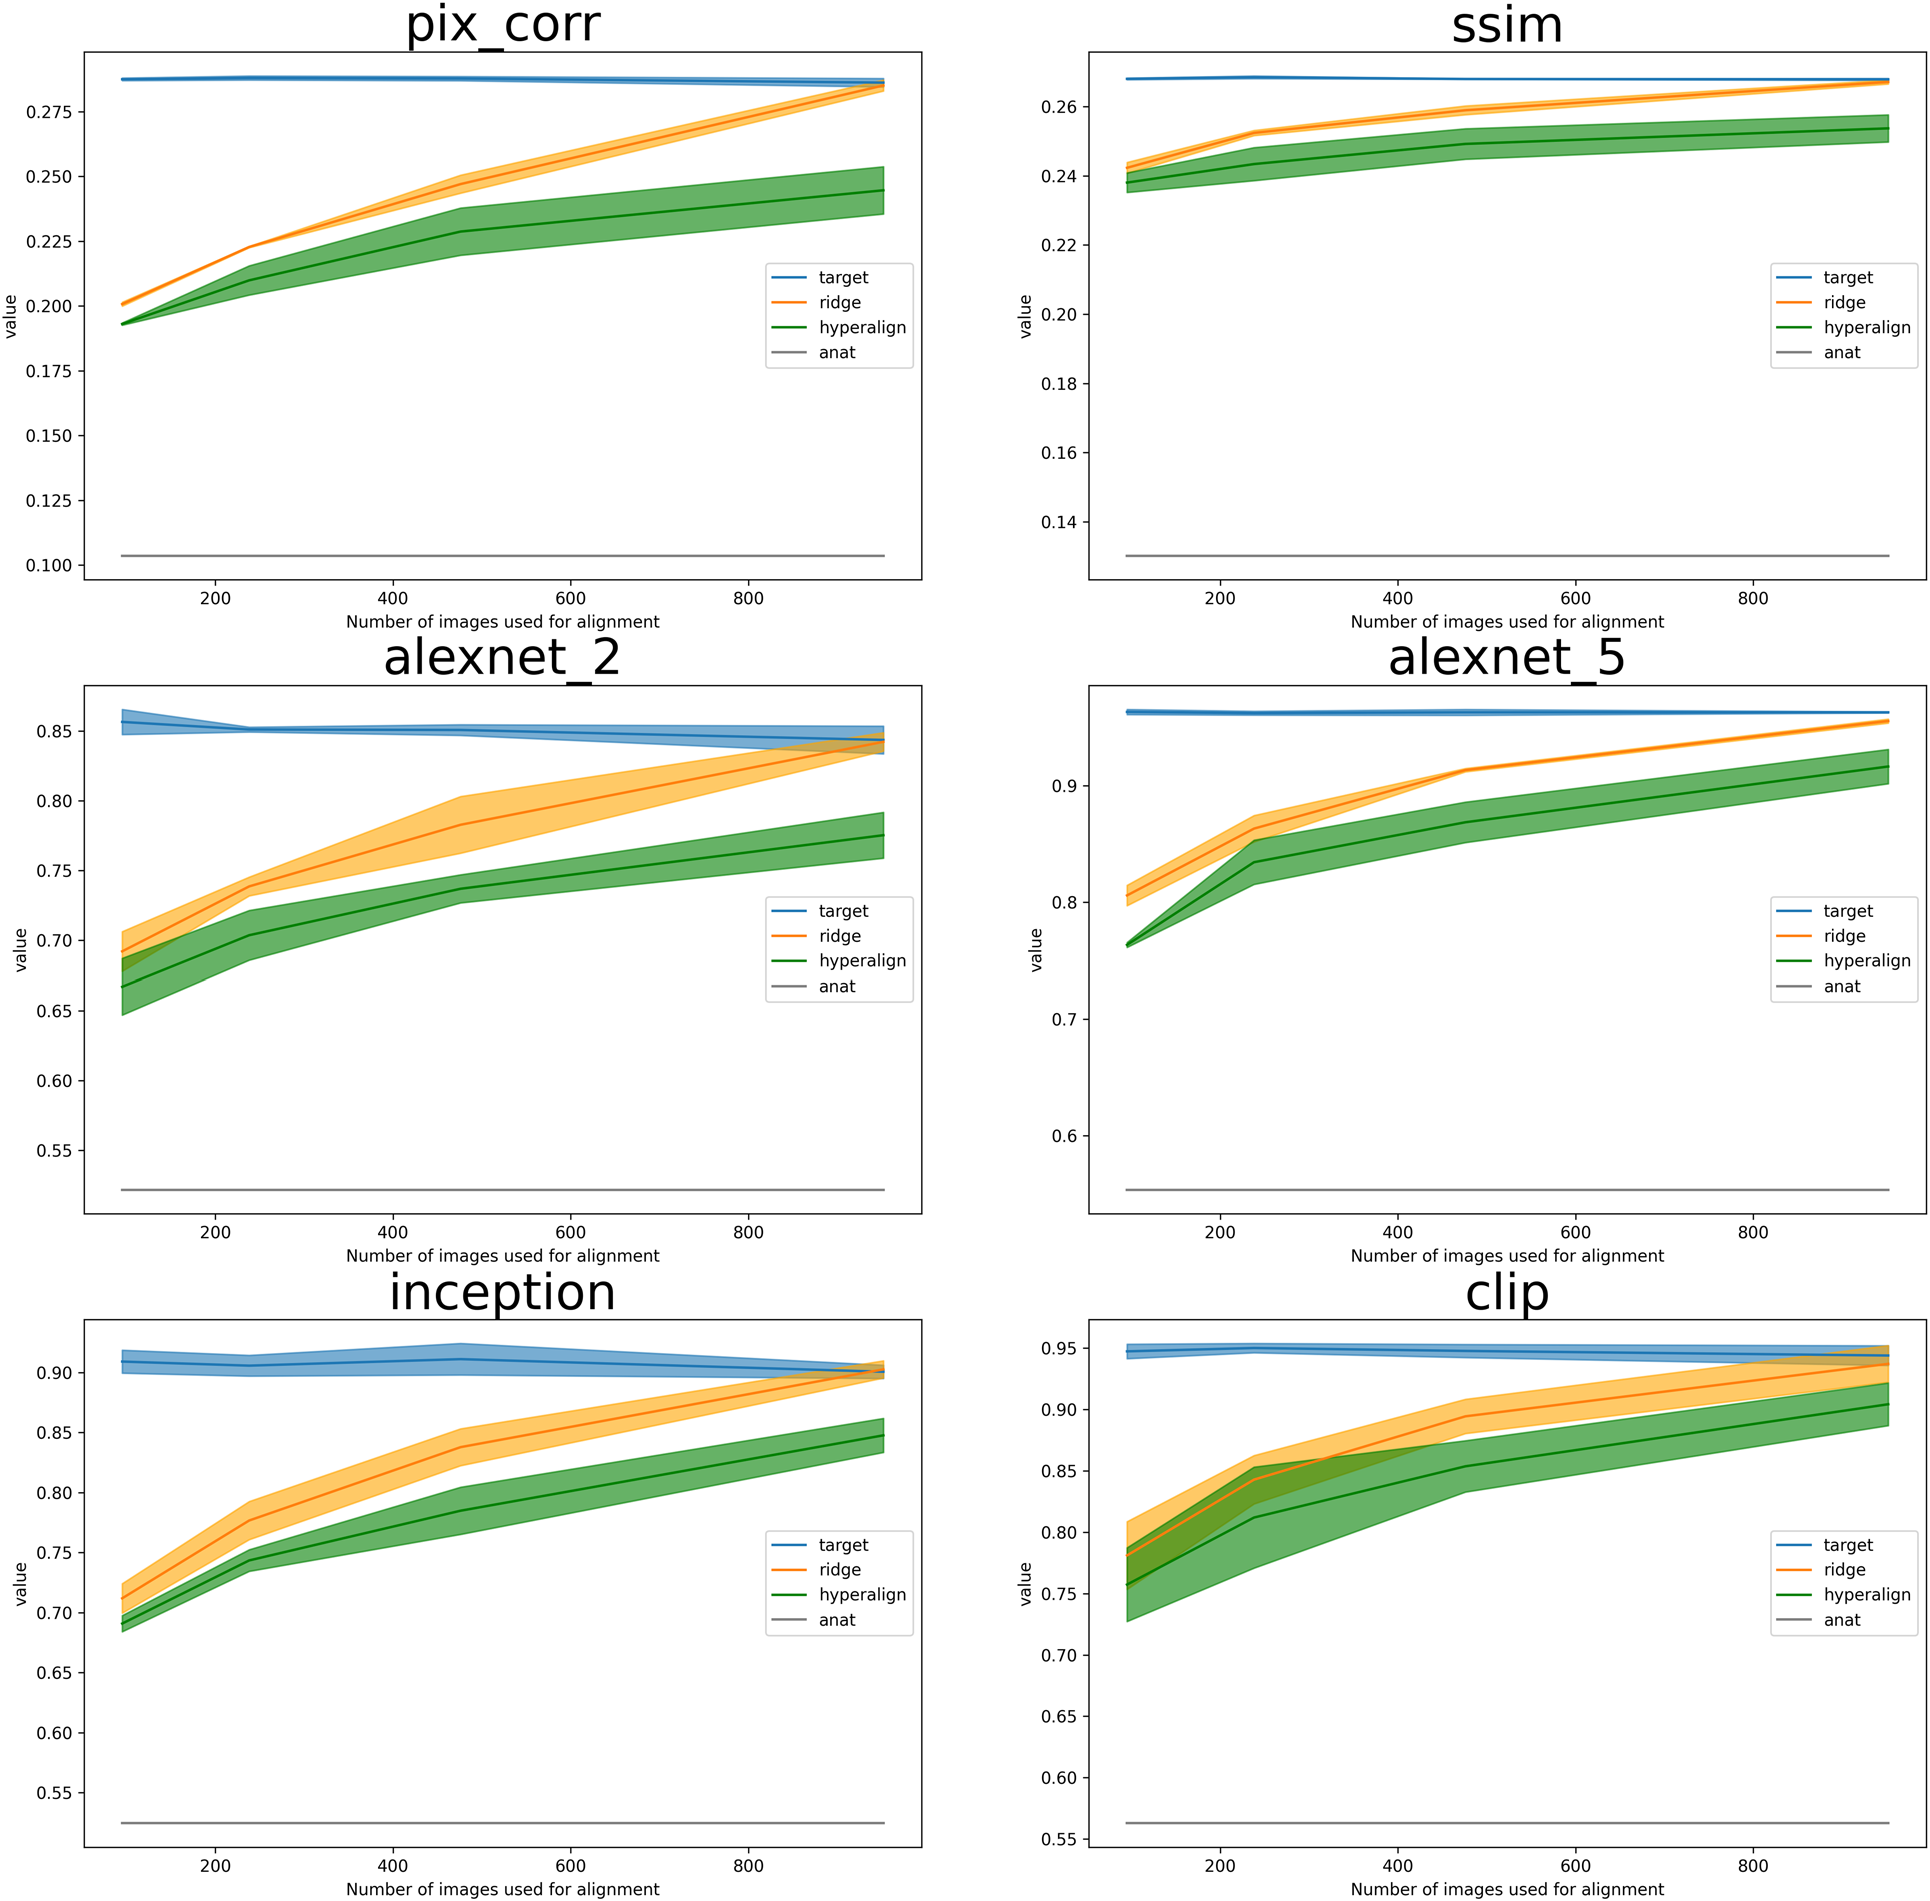
来源:原论文 Figure 8,PDF 第 12 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
Figure 8 的总体趋势是:Ridge Regression 随共同刺激增加而稳定提升,在约 1% 数据时已经高于 chance,在 952 张图像时接近参考被试的 within-subject baseline。Hyperalignment 也有效,但在小样本下通常不如 Ridge 稳定;anatomical alignment 基本停留在 chance 附近。
论文因此提出潜在的 90% scan-time reduction:对一个已经有高质量解码器的新被试,不必重新采集全部约 10k 张图像,只需采集约 952 张共同刺激来学习对齐。这个数字是相对于本文 NSD 设定和完整训练规模而言的工程估计,不应直接理解为所有实验都能减少 90% 扫描时间。
Figure 7 进一步检查了"谁训练 decoder、谁作为 alignment target"的影响。不同 source-target 组合得到的图像在语义和基本形状上总体一致,说明方法不完全依赖 Subj01 这个特定参考被试。
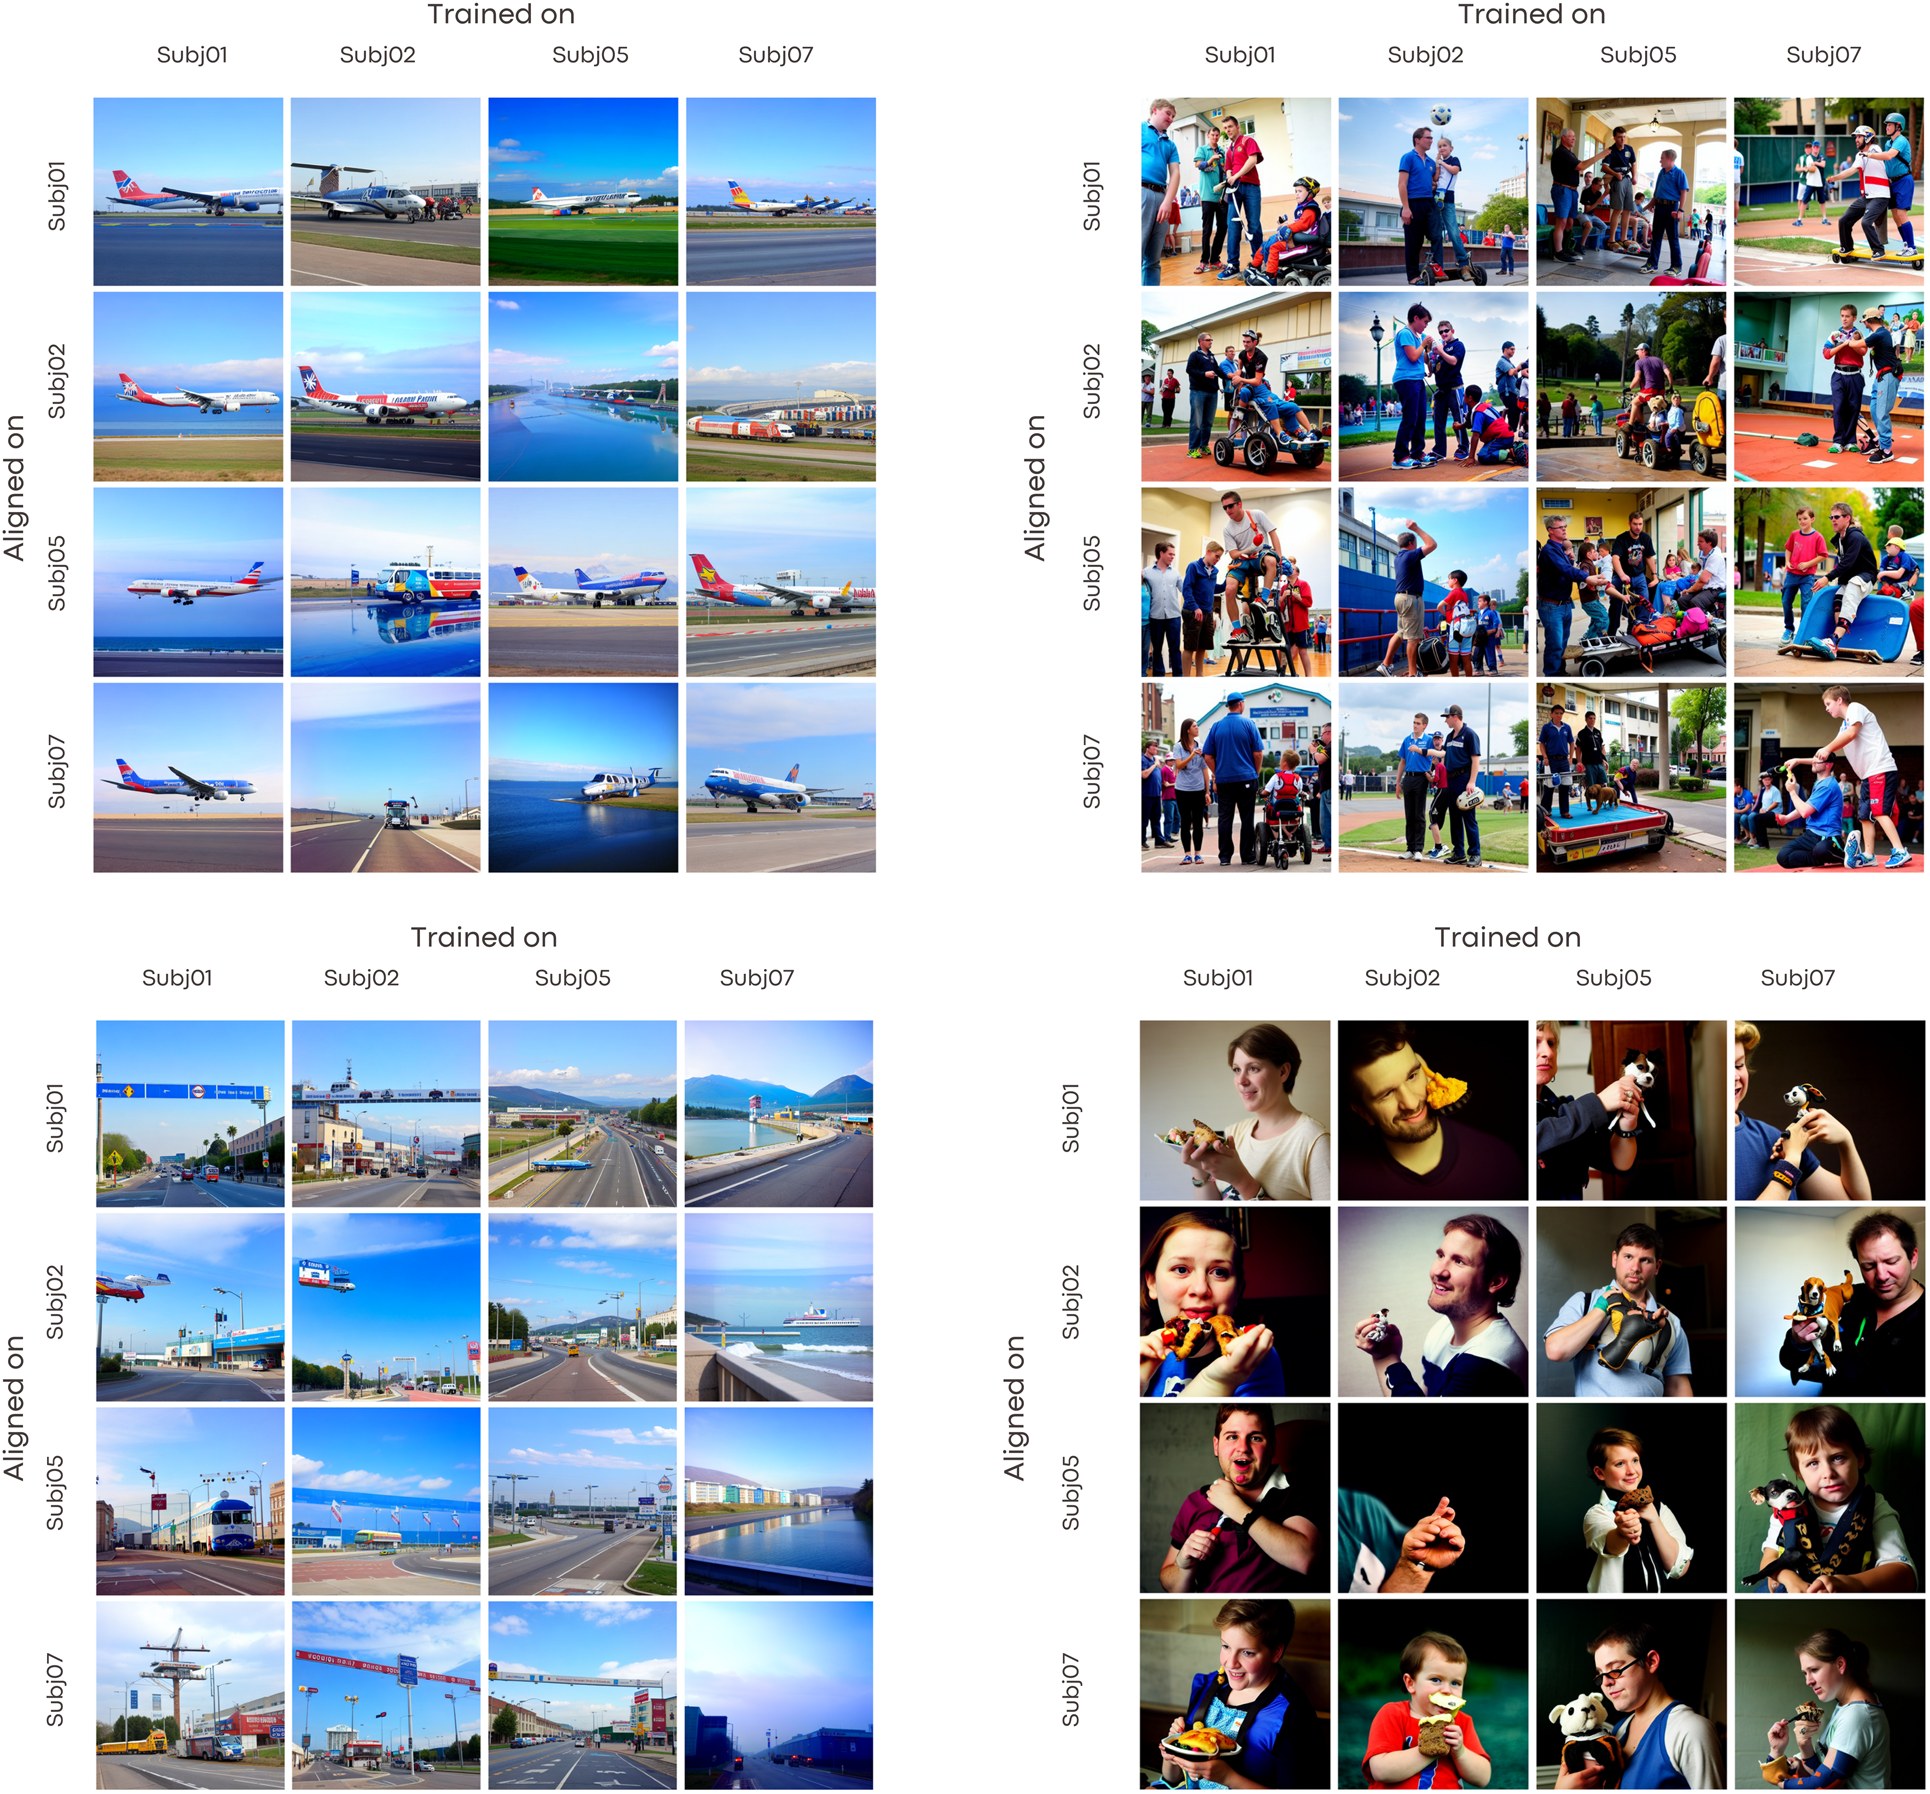
来源:原论文 Figure 7,PDF 第 11 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
6. 结果三:从 NSD 到 BOLD5000 和 THINGS
跨被试成功并不一定等于跨数据集成功,因为不同数据集还会改变磁场强度、空间分辨率、刺激分布、呈现时长和 HRF 相关处理。作者首先在 BOLD5000 与 NSD 之间做实验:BOLD5000 为 3T、每张图像呈现 1 秒并有较长 fixation,NSD 为 7T rapid event-related protocol;两者共享 1,000 张图像。
作者在 NSD Subj01 上训练 decoder,用共同刺激下的 Ridge Regression 把 BOLD5000 被试映射到 NSD 的功能空间,再用 NSD decoder 解码 BOLD5000 活动。Table 1 显示,BOLD5000 的 cross-data 指标整体高于 chance,部分指标与 within-data 结果相近。这里应注意,不同指标和 target/source 组合并非同一统计条件,不能把单个数值简单排序成普遍规律。
THINGS 实验更难,因为它没有与 NSD 完全相同的刺激。作者用图像 CLIP embedding 建立 1,000 张语义相似图像作为 alignment dataset,再把 THINGS 活动对齐到 NSD。由于刺激只是语义相近而非像素相同,within-subject 通常优于 cross-dataset,但 cross-dataset 仍高于 chance。
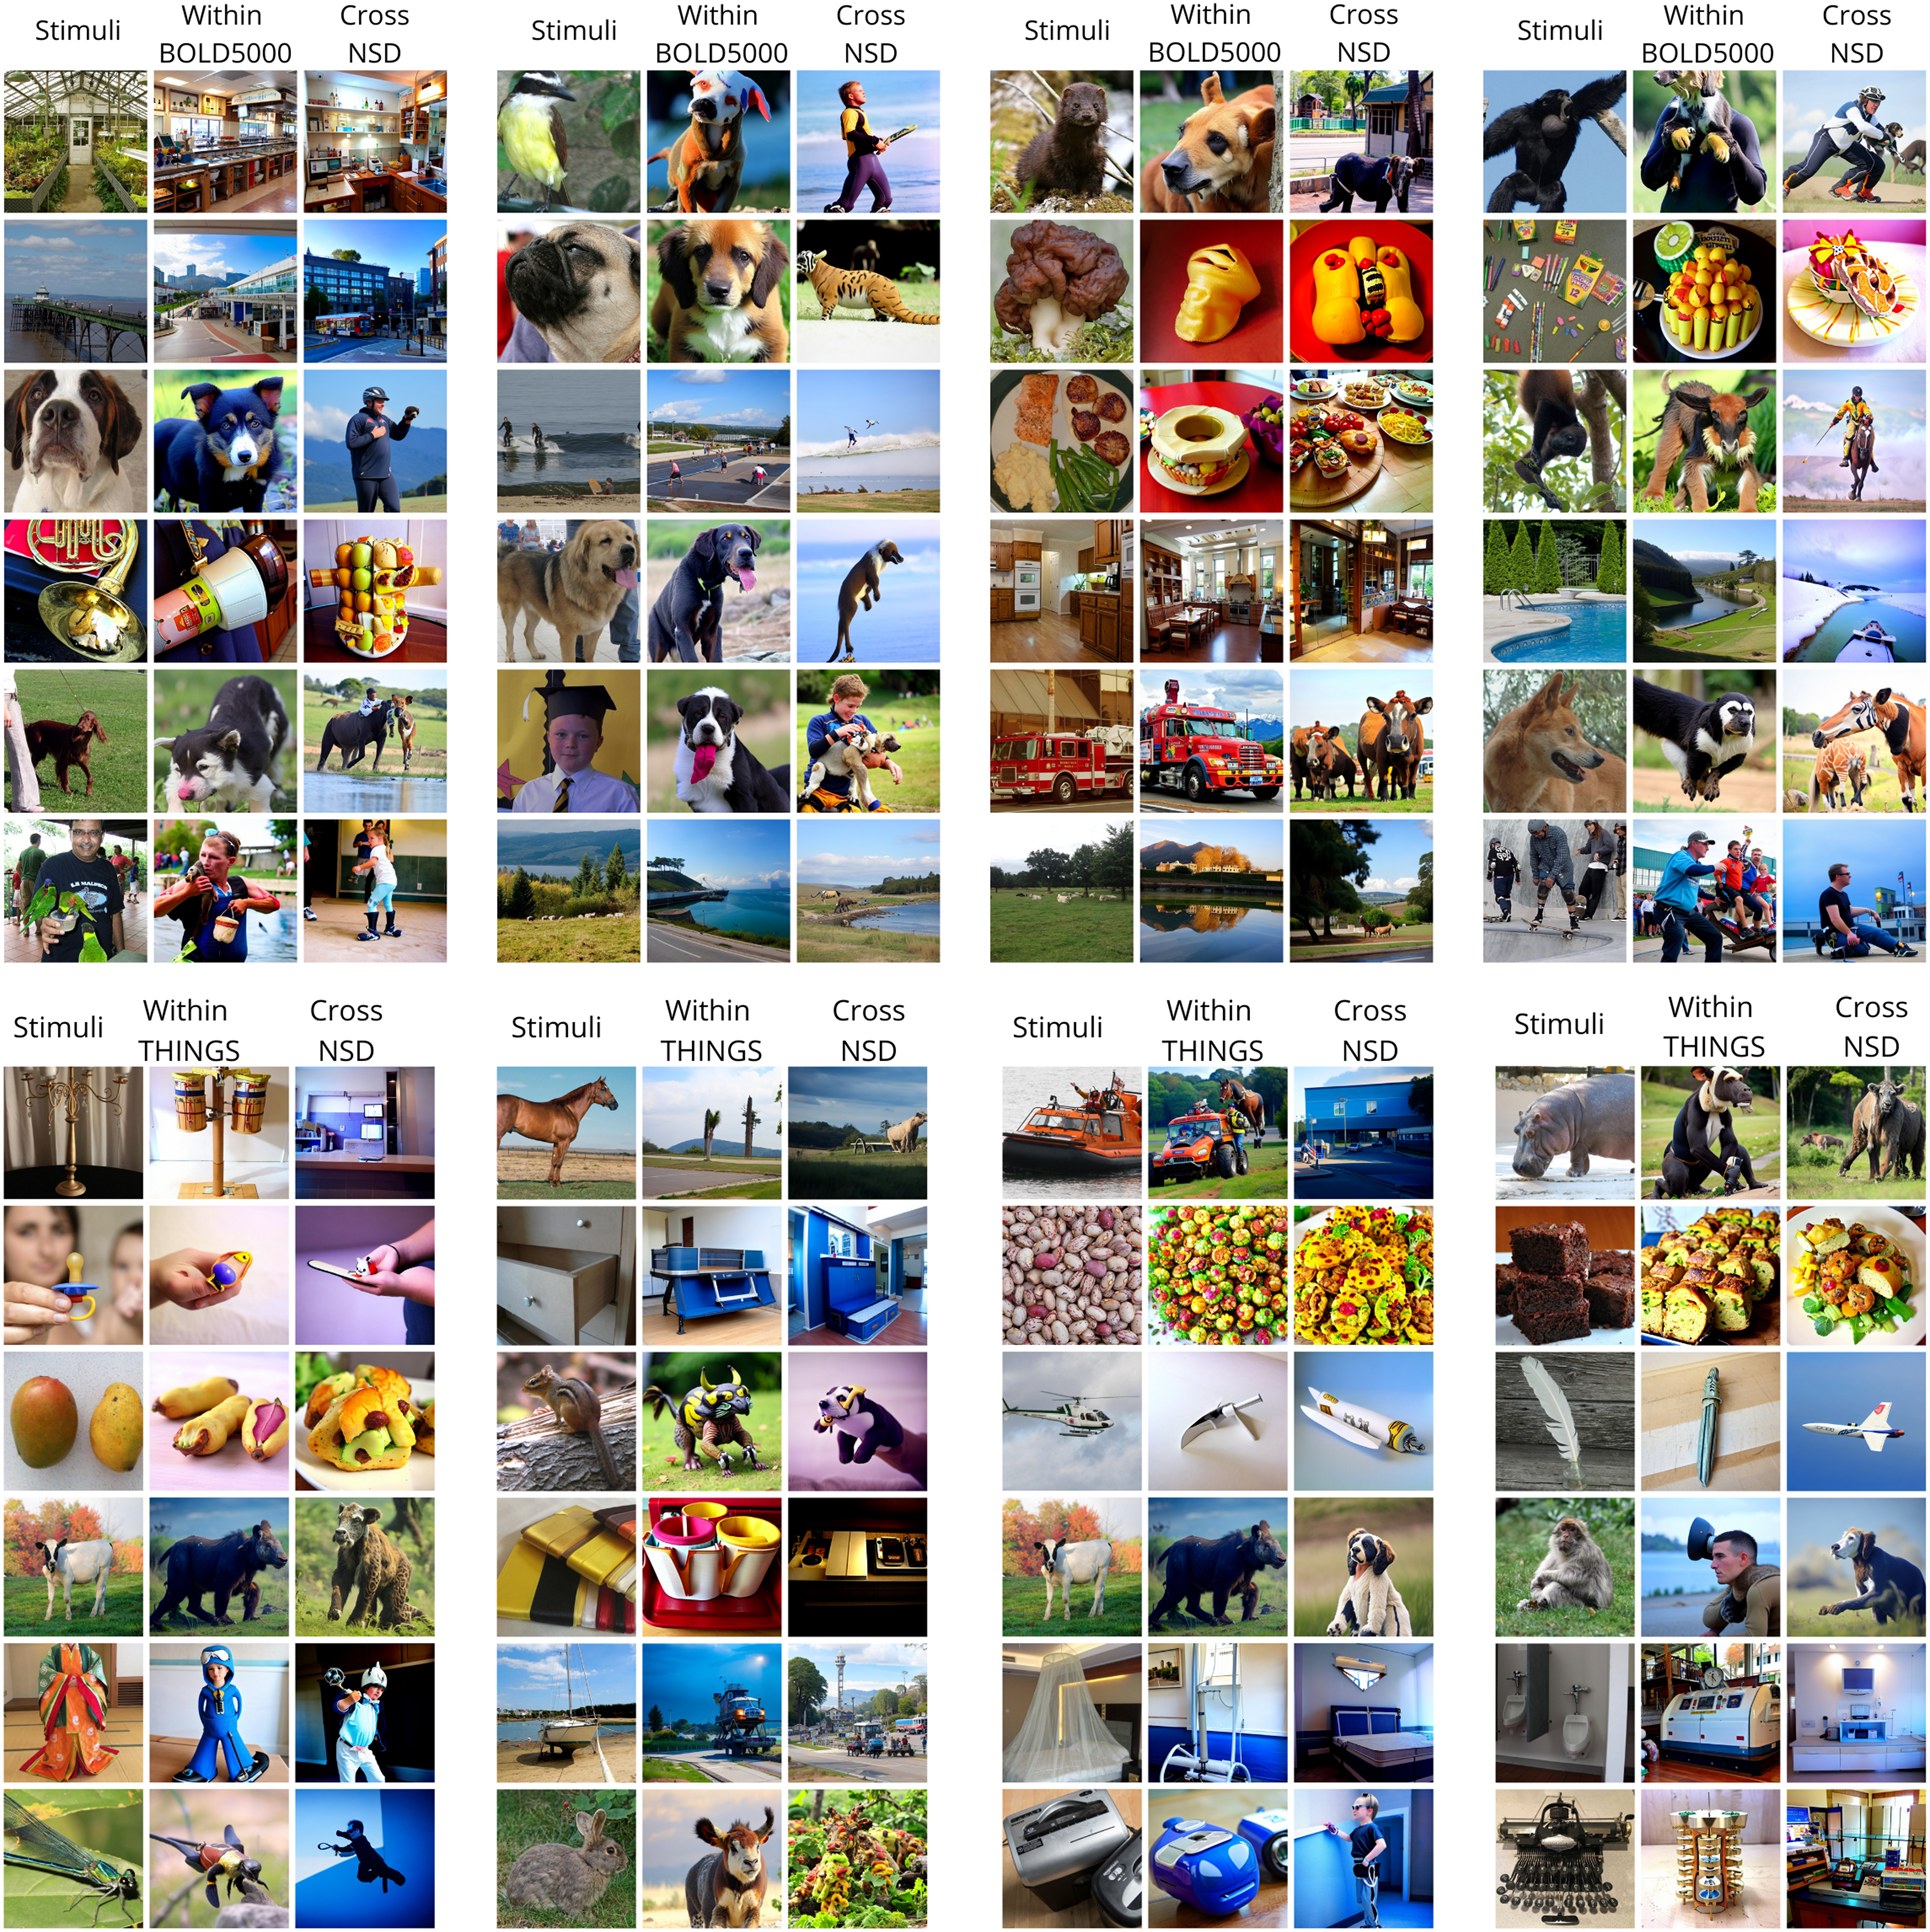
来源:原论文 Figure 9,PDF 第 13 页;图像为论文内嵌原图,DOI: 10.1162/imag_a_00170。
Figure 9 中 Cross NSD 重建往往比 BOLD5000 的 within-data 重建更接近刺激的语义内容。作者把这解释为共享表征和功能对齐带来的迁移,但也应注意:不同数据集的 decoder、图像生成模型、训练数据量和测试分布并不完全相同,因此最稳妥的结论是"跨数据集活动包含可被参考 decoder 利用的信息",而不是两个数据集已经完全等价。
7. 作者的解释、证据与我的评价
作者真正证明了什么?
数据支持以下结论:共同刺激可以作为功能对齐的监督信号;简单的 Ridge 映射在本实验中优于 anatomical alignment,并在不少指标上达到或接近 hyperalignment;跨被试解码的非对角线性能可以接近 within-subject 对角线;少量共同刺激能够显著降低新被试适配成本;共同或语义相近刺激还可以支持一定的跨数据集迁移。
哪些解释仍然是推断?
论文提出跨被试结果可能体现了共享的神经表征,也可能是对齐过程保留了共同视觉概念、滤掉了个体感知差异。作者进一步提出一种概念性分解:brain activity = concept + individual perception。这个想法很有启发,但当前结果不能单独证明大脑活动真的按此线性分解,也不能说明个体差异只是 noise。
此外,跨被试结果有时超过参考被试的 within-subject 结果,并不一定代表新被试更容易解码,可能与对齐映射的正则化、共同刺激的选择和评价集定义有关。应报告多次随机划分、subject-wise confidence interval 和预注册的 alignment/test split,才能更强地排除选择效应。
8. 局限、泄漏风险与可复现性
第一,NSD 的 beta 系数来自 run-level GLM,而一个 run 内的时间序列信息会参与 beta 估计。作者承认这可能造成 train/test 独立性被高估的风险,并指出 GLMsingle 的内部/嵌套交叉验证、正则化以及跨 run 重复刺激平均可以缓解,但不能让这个问题消失。复现时应明确 GLM 拟合范围、重复刺激是否跨 split、alignment images 是否与最终评价完全隔离。
第二,Ridge 的线性映射需要共同刺激,不能称为完全 zero-shot cross-subject decoding。它把昂贵的完整重新训练,替换成仍然需要采集的 calibration/alignment 阶段。952 张图像在 NSD 中约占 10%,在其他范式中所需数量可能完全不同。
第三,本文只覆盖视觉皮层、自然图像和四名 NSD 被试,外推到任务态 fMRI、语言、运动、疾病人群、不同扫描仪或不同 atlas 仍需验证。跨数据集实验虽然有价值,但 BOLD5000 和 THINGS 的刺激匹配、协议差异及样本量限制了强结论。
第四,Brain-Diffuser 是复杂的生成式下游管线。像素重建和感知指标可能受 VDVAE、CLIP、Versatile Diffusion 共同影响,所以 Direct CLIP 这类更靠近线性解码层的指标很重要。未来应同时报告对齐活动本身的 prediction error、跨被试表征相似度和独立的 stimulus identification。
9. 对脑解码研究的启发
- 先把适配问题和生成问题解耦。 如果已有强 decoder,新被试适配可以先学习输入空间映射,而不必立刻重训整个生成模型。
- 共同刺激是功能标尺。 对齐的监督不一定要来自疾病标签或复杂的 end-to-end loss;相同刺激下的脑反应本身就提供了跨被试对应关系。
- Ridge 是值得认真做的基线。 高维脑信号中,正则化线性变换可能比复杂非线性网络更稳定、更容易诊断,也更适合小样本 calibration。
- 评价要区分 within、cross-subject 和 cross-dataset。 还要明确哪些图像参与 decoder training、alignment learning 和 final testing,避免把共同刺激泄漏误报成泛化。
- 不要把"90% 减少扫描"写成普适承诺。 该结论依赖 NSD 的共同刺激比例、参考 decoder 质量、视觉 ROI、beta 估计和评价方式。真正临床或生态部署还需要更少的校准数据、跨设备验证和隐私/伦理评估。
总结
Through their eyes 的价值不在于提出一个更大的视觉生成模型,而在于把跨被试脑解码重新表述为"功能空间适配"。在 NSD 上,Ridge Regression 用共同刺激学习一个 source-to-target 线性变换,使固定的 Brain-Diffuser 能够处理新被试活动;在约 10% 共同数据下,结果接近单被试解码,且跨数据集到 BOLD5000、THINGS 的实验也显示了高于 chance 的迁移信息。
最可靠的结论是:个体脑活动之间存在足以支持视觉内容解码的共享结构,简单、正则化的功能对齐可以把这种共享结构变成可用的工程接口。最需要保留的谨慎是:这不是无校准的 mind reading,也不是已经建立了普适脑解码器;它仍依赖共同刺激、参考被试、复杂下游 decoder 和严格的数据独立性控制。
参考资料与图片来源
- Ferrante, M., Boccato, T., Ozcelik, F., VanRullen, R., & Toschi, N. (2024). Through their eyes: Multi-subject brain decoding with simple alignment techniques. Imaging Neuroscience , 2. DOI: 10.1162/imag_a_00170。
- Allen, E. J., et al. (2022). A massive 7T fMRI dataset to bridge cognitive neuroscience and artificial intelligence. Nature Neuroscience.
- Ozcelik, F., & VanRullen, R. (2023). Natural scene reconstruction from fMRI signals using generative latent diffusion. Scientific Reports.
- Haxby, J. V., et al. (2011, 2020). Hyperalignment and shared information in idiosyncratic cortical topographies。
本文 Figure 1、2、3、5、6、7、8、9 均直接来自该论文 PDF 的内嵌原图,未生成、重绘、增强或添加语义标注;每张图后均标明原始 Figure 编号和 PDF 页码。