7> 🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻
💕💕文末获取源码
文章目录
- 1、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-前言介绍
-
- 1.1背景
- 1.2课题功能、技术
- [1.3 意义](#1.3 意义)
- 2、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-研究内容
- 3、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-开发技术与环境
- 4、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-功能介绍
- 5、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-论文参考
- 6、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-成果展示
- 7、代码展示
- 8、结语(文末获取源码)
本次文章主要是介绍基于大数据处理的京东商品销售态势分析与可视化的设计与实现
1、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-前言介绍
1.1背景
随着电子商务平台的快速发展,京东平台上积累了海量的商品、店铺、品牌、价格、销量、评论和用户评价等数据。这些数据不仅反映了消费者的购买偏好和市场需求变化,也能够体现不同店铺、品牌及商品之间的竞争关系。然而,传统依靠人工统计和静态报表的分析方式存在数据处理效率低、信息展示不直观、指标关联性分析不足等问题,难以从海量商品数据中快速发现销售规律和市场趋势。同时,商品销量、价格、评论数、店铺评分以及促销信息之间存在较为复杂的关系,单纯依靠单一指标难以准确评价商品竞争力。因此,有必要开发一个基于大数据处理的京东商品销售态势分析与可视化系统,对多维度商品数据进行统一处理、分析与展示,为商品运营、品牌管理和市场决策提供更加直观、及时的数据支持。
1.2课题功能、技术
本课题以Python为主要开发语言,采用Hadoop、Spark和Hive构建大数据处理与分析环境,对京东商品数据进行清洗、转换、统计和聚合;使用MySQL保存系统业务数据及分析结果,并通过Django搭建后端服务,实现数据接口、业务逻辑和权限管理等功能;前端采用Vue框架进行页面设计,结合ECharts实现多种交互式图表和大屏可视化展示。在系统功能方面,主要包括销量分布分析、店铺竞争分析、时间趋势分析、品牌竞争分析以及综合数据大屏等模块。其中,销量分布模块实现分类销量对比、高销量商品Top、销量与评论数关系、颜色销量偏好及销量等级分布分析;店铺和品牌模块支持均价、销量、评分、商品数量、市场占有率等指标分析;同时利用K-means聚类算法构建商品竞争力画像,对商品进行分类和对比。
1.3 意义
本课题的研究与实现能够将分散、复杂的京东商品数据转化为清晰的统计结果和可视化信息,帮助用户快速了解商品销售规模、价格变化、品牌竞争格局以及店铺经营情况。通过月度趋势、周内热度、销量排名、评分关系和词云等多种图表,可以增强数据分析结果的直观性和可读性;通过K-means聚类分析,还能够从多个指标综合识别高竞争力商品、潜力商品和低活跃商品,为商品运营和精准营销提供参考。系统不仅能够提升电商数据处理和分析效率,也为企业制定选品策略、价格策略、促销方案和品牌发展计划提供数据依据,对电子商务领域的数据驱动决策具有一定的应用价值和实践意义。
2、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-研究内容
(1)数据采集与清洗:通过网络爬虫或公开数据集获取京东商品信息,采集商品名称、分类、品牌、价格、销量、评论数、评分、店铺和时间等字段,并利用Python、Spark完成去重、缺失值处理、异常值过滤及格式统一,为后续分析提供可靠数据。
(2)数据分析与可视化:利用Hive和Spark对商品、店铺、品牌及时间等维度进行统计分析,计算销量、均价、评分、折扣和市场占有率等指标,并通过Django接口传输数据,结合Vue与ECharts实现折线图、柱状图、饼图、词云和数据大屏展示。
(3)模型设计与训练:选取商品销量、价格、评论数、评分和折扣力度等指标构建特征集合,采用标准化方法消除量纲差异,使用K-means算法对商品进行聚类训练,根据各聚类中心的特征表现划分商品竞争力等级。
(4)系统功能设计:系统采用前后端分离架构,后端基于Django实现数据接口和业务逻辑,前端使用Vue完成页面交互,设置销量分布、店铺竞争、时间趋势、品牌竞争和综合大屏等模块,满足多维度商品销售态势分析需求。
(5)系统测试与优化:通过功能测试、接口测试、数据准确性测试和页面兼容性测试,验证系统各模块运行是否正常,并针对数据查询效率、图表加载速度、聚类结果合理性及页面交互体验进行优化,提升系统的稳定性和实用性。
3、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-开发技术与环境
- 开发语言:Python
- 大数据技术:hadoop、spark、hive
- 框架:Django后端框架、Vue前端框架、Echarts可视化
- 机器学习算法:K-means聚类分析
- 软件工具:Pycharm
- 数据库:MySQL
4、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-功能介绍
1个角色:管理员
可视化分析:
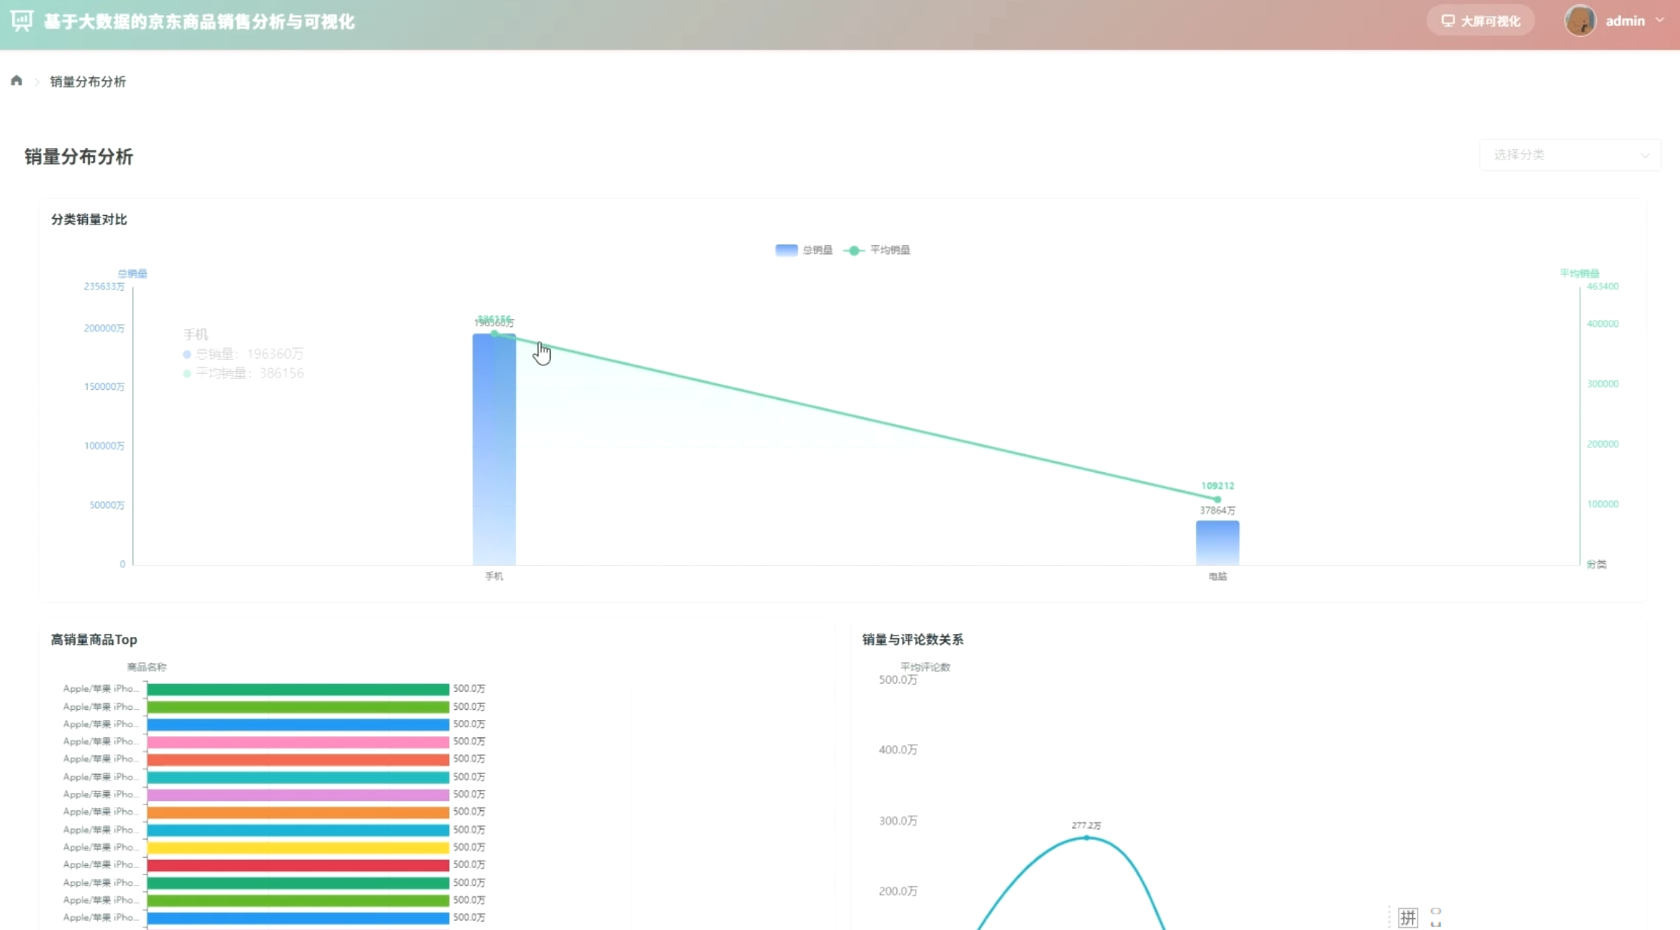
销量分布分析:分类销量对比分析、高销量商品Top分析、销量与评论数关系分析、颜色销量偏好分析、销量等级分布分析
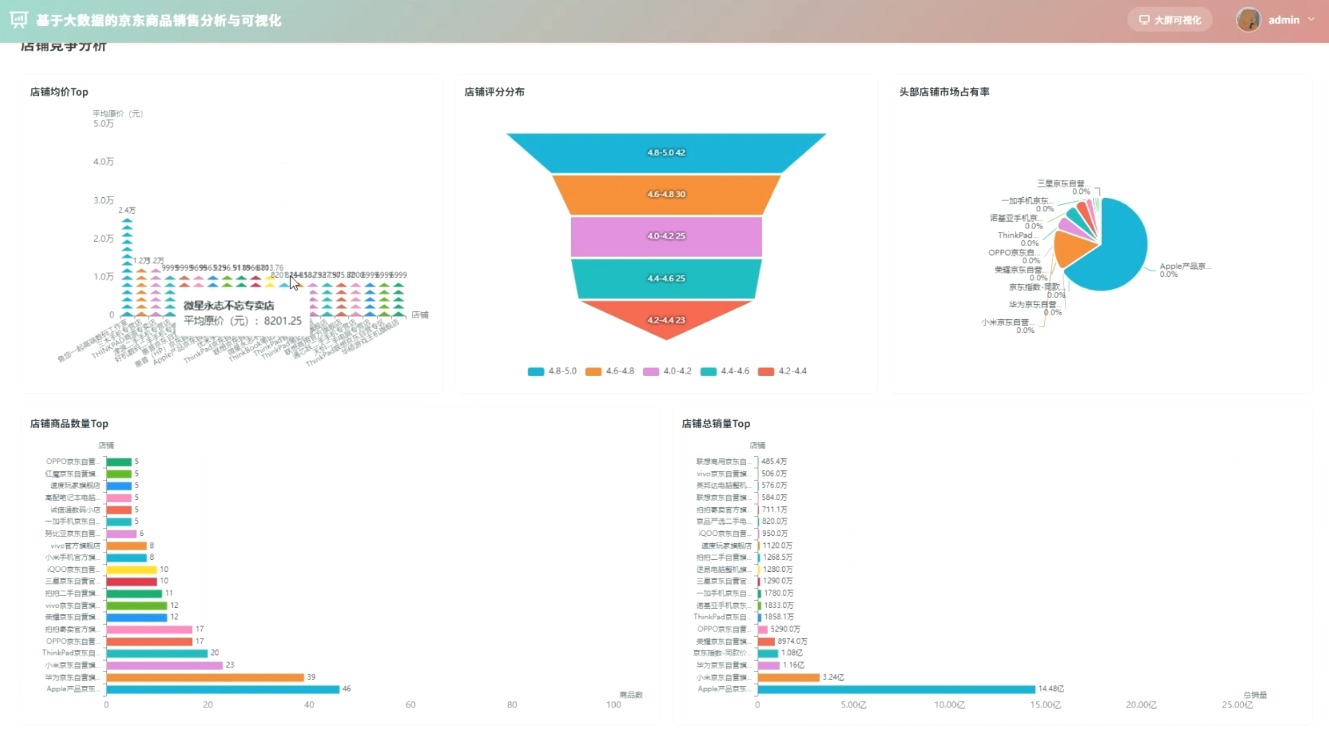
店铺竞争分析:店铺均价Top分析、店铺评分分布分析、头部店铺市场占有率分析、店铺商品数量Top分析、店铺总销量Top分析
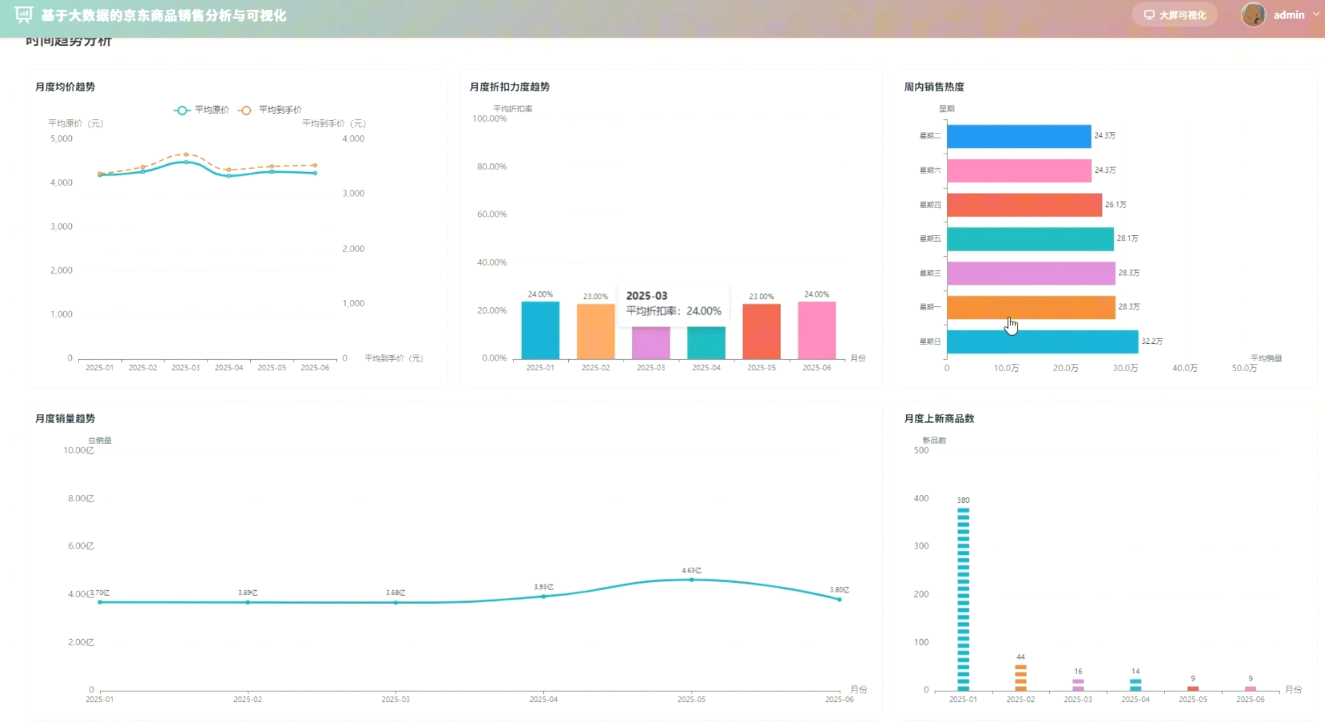
时间趋势分析:月度均价趋势分析、月度折扣力度趋势分析、周内销售热度分析、月度上新商品数分析
品牌竞争分析:品牌均价对比分析、品牌销量Top分析品牌口碑分析、各分类品牌分布分析
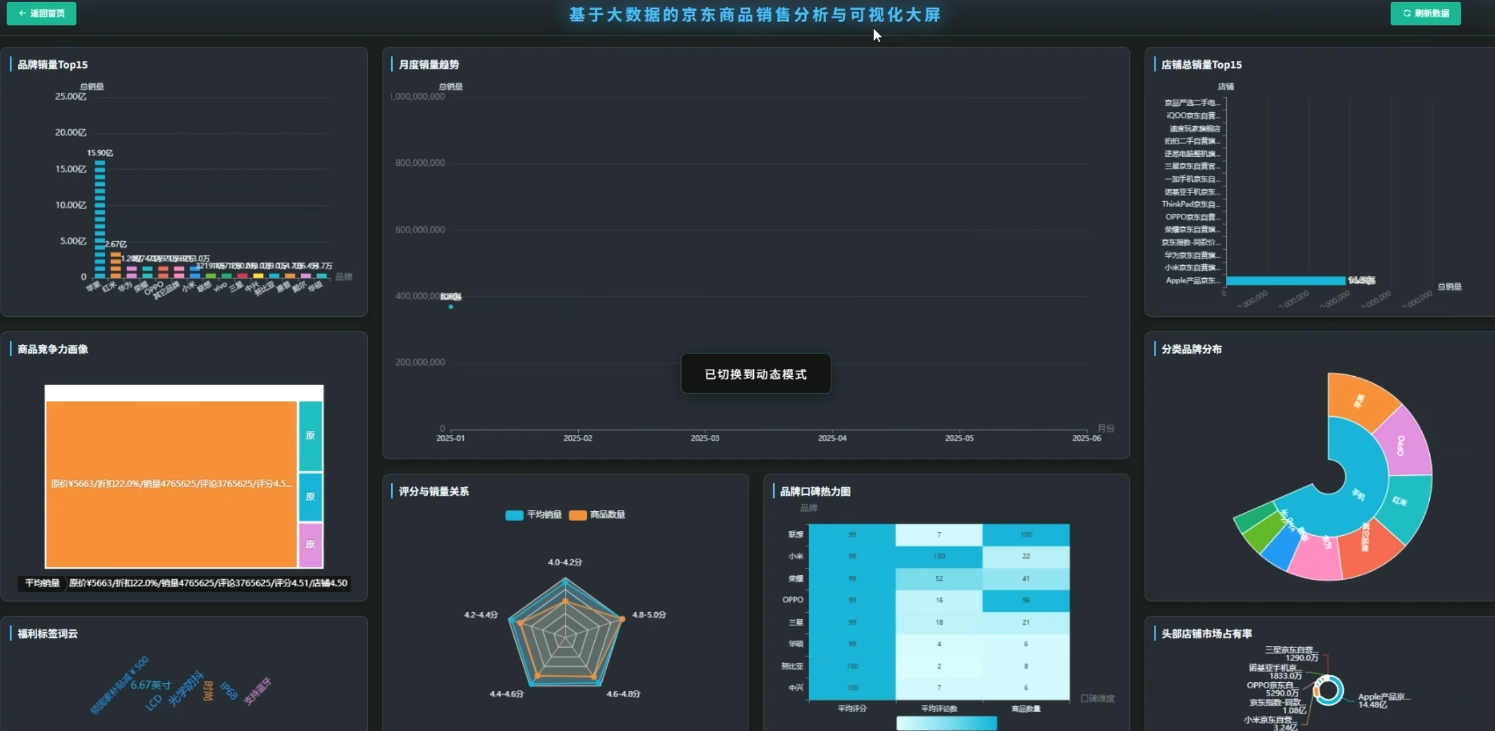
大屏可视化分析:品牌销量Top15分析、月度销量趋势分析、店铺总销量Top15分析、商品竞争力画像分析、分类品牌分布分析、福利标签词云分析、评分与销量关系分析
5、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-论文参考
6、基于大数据处理的京东商品销售态势分析与可视化设计设计与实现-成果展示
6.2演示图片
☀️销量分布分析☀️
☀️店铺竞争分析☀️
☀️时间趋势分析☀️
☀️大屏可视化☀️
7、代码展示
1.月度销量趋势分析功能【代码如下(示例):】
bash
# sales_trend_service.py
from pyspark.sql import SparkSession
from pyspark.sql.functions import (
    col, sum, count, avg, date_format,
    when, regexp_replace
)

spark = SparkSession.builder \
    .appName("JdMonthlySalesTrend") \
    .enableHiveSupport() \
    .getOrCreate()

def get_monthly_sales_trend():
    # 从Hive中读取京东商品销售明细数据
    detail_df = spark.table("jd_goods_detail")

    # 清洗日期、销量和价格字段
    clean_df = detail_df \
        .withColumn("sale_date", col("sale_date").cast("date")) \
        .withColumn("sales", regexp_replace(col("sales"), ",", "").cast("double")) \
        .withColumn("price", col("price").cast("double"))

    # 过滤无效数据,避免空值影响统计结果
    clean_df = clean_df.filter(
        (col("sale_date").isNotNull()) &
        (col("sales").isNotNull()) &
        (col("sales") >= 0)
    )

    # 提取月份信息,例如2024-01、2024-02
    clean_df = clean_df.withColumn(
        "month",
        date_format(col("sale_date"), "yyyy-MM")
    )

    # 按月份统计总销量、商品数量和平均价格
    result_df = clean_df.groupBy("month").agg(
        sum("sales").alias("total_sales"),
        count("goods_id").alias("goods_count"),
        avg("price").alias("average_price")
    )

    # 按月份升序排列,保证前端折线图顺序正确
    result_df = result_df.orderBy("month")

    # 对统计结果进行格式化处理
    result_df = result_df.withColumn(
        "total_sales",
        col("total_sales").cast("long")
    )

    result_df = result_df.withColumn(
        "average_price",
        col("average_price").cast("double")
    )

    # 转换为字典列表,供Django接口返回
    data = [
        {
            "month": row["month"],
            "total_sales": row["total_sales"] or 0,
            "goods_count": row["goods_count"] or 0,
            "average_price": round(row["average_price"] or 0, 2)
        }
        for row in result_df.collect()
    ]

    return data
2.商品竞争力画像功能【代码如下(示例):】
bash
# goods_cluster_service.py
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

def goods_competitiveness_cluster(goods_data):
    # 将查询结果转换为DataFrame
    df = pd.DataFrame(goods_data)

    # 选择影响商品竞争力的核心指标
    feature_columns = [
        "sales",
        "price",
        "comment_count",
        "score",
        "discount"
    ]

    # 删除核心指标为空的数据
    df = df.dropna(subset=feature_columns).copy()

    # 对异常值进行简单处理,避免极端数据影响聚类结果
    df["sales"] = df["sales"].clip(lower=0)
    df["comment_count"] = df["comment_count"].clip(lower=0)
    df["price"] = df["price"].clip(lower=0)
    df["score"] = df["score"].clip(0, 5)
    df["discount"] = df["discount"].clip(0, 1)

    # 对特征进行标准化,使不同量纲指标具有可比性
    scaler = StandardScaler()
    feature_matrix = scaler.fit_transform(df[feature_columns])

    # 设置聚类数量,将商品划分为四类
    model = KMeans(
        n_clusters=4,
        random_state=42,
        n_init=10,
        max_iter=300
    )

    # 训练模型并生成聚类标签
    df["cluster"] = model.fit_predict(feature_matrix)

    # 获取每个聚类的指标均值,便于解释聚类结果
    cluster_summary = df.groupby("cluster")[feature_columns] \
        .mean() \
        .round(2) \
        .reset_index()

    # 根据销量和评分对聚类结果进行初步命名
    cluster_summary["cluster_name"] = "一般商品"
    cluster_summary.loc[
        (cluster_summary["sales"] >= cluster_summary["sales"].mean()) &
        (cluster_summary["score"] >= cluster_summary["score"].mean()),
        "cluster_name"
    ] = "高竞争力商品"

    cluster_summary.loc[
        (cluster_summary["sales"] < cluster_summary["sales"].mean()) &
        (cluster_summary["discount"] >= cluster_summary["discount"].mean()),
        "cluster_name"
    ] = "促销潜力商品"

    cluster_summary.loc[
        (cluster_summary["sales"] < cluster_summary["sales"].mean()) &
        (cluster_summary["score"] < cluster_summary["score"].mean()),
        "cluster_name"
    ] = "低活跃商品"

    # 将聚类名称回写到商品明细中
    name_map = dict(
        zip(
            cluster_summary["cluster"],
            cluster_summary["cluster_name"]
        )
    }
8、结语(文末获取源码)
💕💕
💟💟如果大家有任何疑虑,或者对这个系统感兴趣,欢迎点赞收藏、留言交流啦!
💟💟欢迎在下方位置详细交流。
🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻