文章目录
前言
本专栏文章为《LeetCode 热题 100》的刷题题解,相关内容如有侵权,立即删除。
一、题目
1、原题链接
2、题目描述
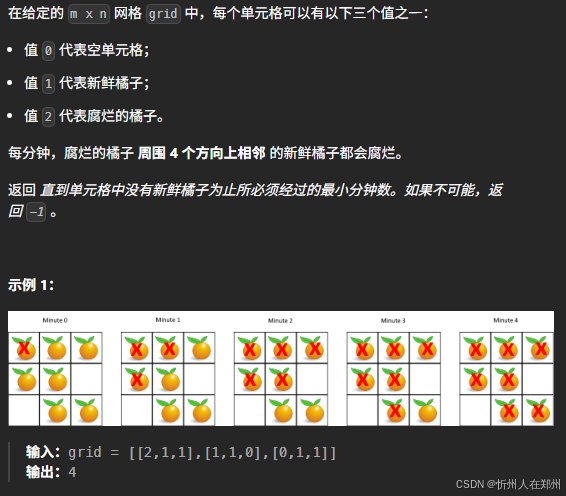
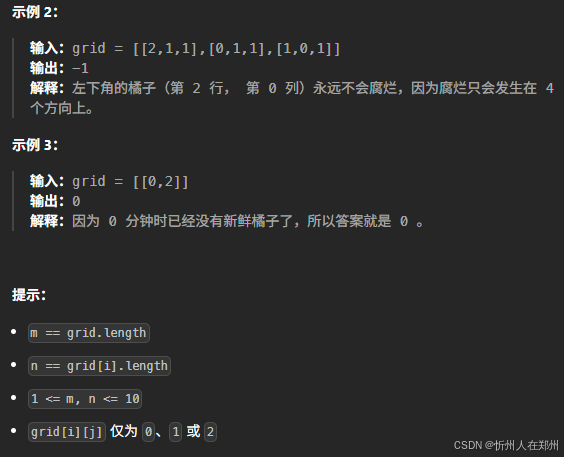
二、个人思路整理
1、思路分析
核心方法是多源广度优先搜索。
具体步骤:
-
多源起点:腐烂是同时从所有初始腐烂的橘子开始向四周扩散的。因此不能逐个进行单源搜索,而需要一开始就把所有初始为 2 的腐烂橘子坐标全部入队。
-
统计新鲜橘子数量:在遍历网格初始化队列的同时,统计新鲜橘子(值为 1)的总数
fresh_count。若初始
fresh_count == 0,直接返回0分钟。 -
按层扩散(BFS):
-
每一轮循环代表过去 1 分钟。
-
记录当前队列的大小
size,依次弹出这批橘子,向上下左右 4 个方向扩散。 -
若相邻位置是新鲜橘子(值为 1):
-
将其置为腐烂(改成 2,避免重复入队)。
-
fresh_count--。 -
将新腐烂的橘子坐标加入队列。
-
-
只有当本轮确实腐烂了新的橘子时(即
fresh_count > 0且队列非空),经过的分钟数minutes才累加。
-
-
结果判定:
-
BFS 结束后,若
fresh_count == 0,说明全部腐烂,返回minutes; -
若
fresh_count > 0,说明有新鲜橘子被隔绝无法腐烂,返回-1。
-
2、解题代码
cpp
class Solution {
public:
    int orangesRotting(vector<vector<int>>& grid) {
        int m = grid.size();
        int n = grid[0].size();
        int fresh_count = 0;
        queue<pair<int, int>> q;

        // 1. 初始化:收集所有腐烂橘子入队,并统计新鲜橘子个数
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                if (grid[i][j] == 2) {
                    q.push({i, j});
                }
                if (grid[i][j] == 1) {
                    fresh_count++;
                }
            }
        }

        // 初始就没有新鲜橘子,直接耗时 0
        if (fresh_count == 0) {
            return 0;
        }

        int minutes = 0;
        int dx[4] = {-1, 1, 0, 0};
        int dy[4] = {0, 0, -1, 1};

        // 2. 多源 BFS 按层扩散
        while (!q.empty() && fresh_count > 0) {
            int size = q.size();
            minutes++;   // 每一层代表1分钟

            for (int k = 0; k < size; k++) {
                auto [x, y] = q.front();
                q.pop();

                for (int d = 0; d < 4; d++) {
                    int nx = x + dx[d];
                    int ny = y + dy[d];

                    // 越界或不是新鲜橘子则跳过
                    if (nx >= 0 && nx < m && ny >= 0 && ny < n && grid[nx][ny] == 1) {
                        grid[nx][ny] = 2;      // 标记为已腐烂,防止重复访问
                        fresh_count--;
                        q.push({nx, ny});
                    }
                }
            }
        }

        // 3. 判断是否还有未被感染的新鲜橘子
        return fresh_count == 0 ? minutes : -1;
    }
};
复杂度分析
- 时间复杂度: O ( m × n ) O(m \times n) O(m×n)。每个单元格最多被访问和入队常数次。
- 空间复杂度: O ( m × n ) O(m \times n) O(m×n)。队列中最多同时存放 O ( m × n ) O(m \times n) O(m×n) 个坐标。
三、知识风暴
多源广度优先搜索(Multi-source BFS) 是本题的核心解法。与单源 BFS 不同,本题的腐烂过程是同时从所有初始腐烂的橘子开始的,因此需要把所有腐烂橘子作为起点统一入队,再按层向外扩散。理解多源 BFS 的分层思想,对掌握本题至关重要。
算法核心思想:
- 多源起点 :腐烂是同时发生的,不能逐个进行单源搜索,而应一开始就把所有初始为 2 的腐烂橘子坐标全部入队,让它们在同一时刻向四周扩散。
- 按层扩散 :每一轮循环代表过去 1 分钟。记录当前队列大小
size,只弹出这一批橘子,向上下左右 4 个方向扩散,保证"分钟数"与"层数"一一对应。 - 原地标记 :把新鲜橘子置为 2(腐烂),既避免重复入队,又省去了额外的
visited数组,空间复杂度更优。
常见对比:单源 BFS vs 多源 BFS
- 单源 BFS:从一个起点出发,求到其他点的最短距离,队列初始只有一个元素。
- 多源 BFS:从多个起点同时出发,求"所有起点到目标点的最短距离",队列初始包含所有起点。本题中,所有腐烂橘子同时扩散,天然契合多源 BFS 模型。
- 共同点:两者都借助队列按层遍历,区别仅在于初始入队的节点数量。多源 BFS 可看作"虚拟超级源点"连接所有起点后的单源 BFS。
"按层扩散"标记思想:
- 核心思想 :每一轮循环只处理当前队列中的节点(即同一分钟新腐烂的橘子),通过
size变量固定本轮范围,避免把下一分钟才腐烂的橘子混入本轮计数。 - 与本题的联系 :每经过一轮循环,
minutes加 1,代表又过去 1 分钟。只有本轮确实腐烂了新的橘子(fresh_count > 0且队列非空),分钟数才累加。 - 注意事项 :若在 BFS 过程中直接修改
grid为 2,需确保不会把"本轮新腐烂"的橘子当作"下一轮起点"重复扩散------这正是按层处理(先记录size)的意义所在。
使用要点:
- 方向数组 :用
int dx[4] = {-1, 1, 0, 0}; int dy[4] = {0, 0, -1, 1};统一表示上下左右四个方向,配合循环遍历,可避免重复书写四行扩散逻辑。 - 边界检查:扩散前务必判断行列下标是否越界,以及当前格子是否为新鲜橘子(值为 1),这是防止重复访问和越界的关键。
- 计数时机 :新鲜橘子计数器
fresh_count--必须放在"发现新鲜橘子并置为腐烂"的瞬间,同时入队,保证每个橘子只被感染一次。 - 结果判定 :BFS 结束后,若
fresh_count == 0说明全部腐烂,返回minutes;若仍有剩余,说明有新鲜橘子被隔绝,返回-1。
算法变体与扩展:
- 岛屿数量(LeetCode 200):单源 DFS/BFS 遍历连通分量,与本题的多源 BFS 形成对比,可体会"单源 vs 多源"的差异。
- 被围绕的区域(LeetCode 130) :从边界出发标记不被包围的
'O',再翻转其余'O',是"从边界反向搜索"的经典应用。 - 太平洋大西洋水流问题(LeetCode 417):从边界反向 DFS,标记能到达两个海洋的格子,进一步体会"逆向搜索"思想。
- 地图分析(LeetCode 1162):多源 BFS 求"离所有陆地最远的海洋",与本题同属多源 BFS 的典型应用,可加深对分层遍历的理解。
相关 LeetCode 例题:
- 200. 岛屿数量(单源 DFS/BFS 统计连通块)
- 130. 被围绕的区域(边界反向搜索)
- 417. 太平洋大西洋水流问题(多源逆向 DFS)
- 1162. 地图分析(多源 BFS 分层扩散)