一、什么是 Kruskal 算法?
Kruskal 算法是一种最小生成树算法 ,由 Joseph Kruskal 在 1956 年提出。它的核心思想是每次选择最短的边,将两个连通分量合并,直到所有节点都连通,最终得到一棵总权重最小的生成树。
简单来说,Kruskal 算法就像 "用最少的钱连接所有城市":
- 你有 23 座城市,要修公路把它们全部连通;
- 每次先修最短的公路,连接两个还没连通的城市;
- 跳过那些会形成环路的公路,直到所有城市都连通;
- 这样修出来的公路总长度最短,也就是最小生成树。
二、最小生成树的核心概念
最小生成树(Minimum Spanning Tree,简称 MST)是指在一个连通的带权无向图中,选择 n-1 条边,将所有 n 个节点连通,且总权重最小的子图。
最小生成树的特点:
- 包含所有节点;
- 没有环路;
- 总权重最小;
- 边数为 n-1。
三、Kruskal 算法的核心步骤
Kruskal 算法的核心步骤可以分为以下几步:
- 排序:将所有边按权重从小到大排序;
- 初始化:每个节点自己是一个连通分量;
- 选择边:依次选择最短的边,判断两个节点是否在同一个连通分量;
- 合并:如果不在同一个连通分量,合并两个连通分量,将边加入最小生成树;
- 重复:直到所有节点都连通。
四、Kruskal 算法的关键:并查集
Kruskal 算法的核心是并查集(Union-Find),它用于快速判断两个节点是否在同一个连通分量,以及合并两个连通分量。
并查集的核心操作:
- find:查找节点的根节点;
- union:合并两个连通分量。
五、Kruskal 算法的代码实现
1. Python 版本(直观易懂)
class UnionFind:
    def __init__(self, size):
        self.parent = list(range(size))

    def find(self, x):
        if self.parent[x] != x:
            self.parent[x] = self.find(self.parent[x])  # 路径压缩
        return self.parent[x]

    def union(self, x, y):
        x_root = self.find(x)
        y_root = self.find(y)
        if x_root != y_root:
            self.parent[y_root] = x_root
            return True
        return False

def kruskal(edges, num_nodes):
    # 按权重从小到大排序
    edges.sort(key=lambda x: x[2])
    uf = UnionFind(num_nodes)
    mst = []
    total_weight = 0

    for u, v, weight in edges:
        if uf.union(u, v):
            mst.append((u, v, weight))
            total_weight += weight
            # 已经连通所有节点
            if len(mst) == num_nodes - 1:
                break

    return mst, total_weight

# 测试:城市连接问题
# 城市编号:0=北京,1=石家庄,2=太原,3=广州,4=深圳,5=重庆,6=贵阳,7=郑州,8=合肥,9=济南,10=台北
edges = [
    (0, 1, 89),   # 北京-石家庄
    (1, 2, 60),   # 石家庄-太原
    (3, 4, 32),   # 广州-深圳
    (5, 6, 106),  # 重庆-贵阳
    (7, 8, 153),  # 郑州-合肥
    (8, 9, 175),  # 合肥-济南
    (0, 2, 138),  # 北京-太原(已连通,跳过)
    (9, 1, 104),  # 济南-石家庄
    (10, 4, 243), # 台北-深圳
    (0, 11, 223), # 北京-沈阳
]

mst, total_weight = kruskal(edges, 12)
print("最小生成树边:", mst)
print("总权重:", total_weight)
2. C 语言版本(更贴近底层)
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

#define MAX_EDGES 100
#define MAX_NODES 23

// 边结构体
typedef struct {
    int u, v, weight;
} Edge;

// 并查集结构体
typedef struct {
    int parent[MAX_NODES];
} UnionFind;

// 初始化并查集
void initUnionFind(UnionFind* uf, int size) {
    for (int i = 0; i < size; i++) {
        uf->parent[i] = i;
    }
}

// 查找根节点(路径压缩)
int find(UnionFind* uf, int x) {
    if (uf->parent[x] != x) {
        uf->parent[x] = find(uf, uf->parent[x]);
    }
    return uf->parent[x];
}

// 合并两个连通分量
int unionSets(UnionFind* uf, int x, int y) {
    int x_root = find(uf, x);
    int y_root = find(uf, y);
    if (x_root != y_root) {
        uf->parent[y_root] = x_root;
        return 1;
    }
    return 0;
}

// 比较函数,用于排序边
int compareEdges(const void* a, const void* b) {
    return ((Edge*)a)->weight - ((Edge*)b)->weight;
}

// Kruskal算法
void kruskal(Edge edges[], int num_edges, int num_nodes) {
    // 按权重从小到大排序
    qsort(edges, num_edges, sizeof(Edge), compareEdges);

    UnionFind uf;
    initUnionFind(&uf, num_nodes);

    Edge mst[MAX_NODES];
    int mst_size = 0;
    int total_weight = 0;

    for (int i = 0; i < num_edges; i++) {
        int u = edges[i].u;
        int v = edges[i].v;
        int weight = edges[i].weight;

        if (unionSets(&uf, u, v)) {
            mst[mst_size++] = edges[i];
            total_weight += weight;
            // 已经连通所有节点
            if (mst_size == num_nodes - 1) {
                break;
            }
        }
    }

    // 打印结果
    printf("最小生成树边:\n");
    for (int i = 0; i < mst_size; i++) {
        printf("%d-%d,权重:%d\n", mst[i].u, mst[i].v, mst[i].weight);
    }
    printf("总权重:%d\n", total_weight);
}

int main() {
    // 城市连接问题
    Edge edges[] = {
        {0, 1, 89},   // 北京-石家庄
        {1, 2, 60},   // 石家庄-太原
        {3, 4, 32},   // 广州-深圳
        {5, 6, 106},  // 重庆-贵阳
        {7, 8, 153},  // 郑州-合肥
        {8, 9, 175},  // 合肥-济南
        {0, 2, 138},  // 北京-太原(已连通,跳过)
        {9, 1, 104},  // 济南-石家庄
        {10, 4, 243}, // 台北-深圳
        {0, 11, 223}, // 北京-沈阳
    };
    int num_edges = sizeof(edges) / sizeof(edges[0]);
    int num_nodes = 12;

    kruskal(edges, num_edges, num_nodes);
    return 0;
}
六、Kruskal 算法的特点
- 时间复杂度:O (m log m),其中 m 是边数,主要由排序操作决定;
- 空间复杂度:O (n),需要存储并查集;
- 适用场景:边数较少的稀疏图;
- 是否含环:不会形成环,因为每次只合并两个不同的连通分量。
七、Kruskal 算法的优化
为了提高 Kruskal 算法的效率,可以进行以下优化:
- 路径压缩:在并查集的 find 操作中进行路径压缩,减少查找时间;
- 按秩合并:在并查集的 union 操作中按秩合并,减少树的高度;
- 快速排序:使用快速排序代替其他排序算法,提高排序效率。
八、Kruskal 算法的实际应用场景
Kruskal 算法是一种非常基础且重要的算法,常见场景包括:
- 网络设计:设计公路网、电网、通信网,最小化建设成本;
- 集群计算:将多个节点连接成一个集群,最小化通信成本;
- 图像处理:图像分割,将相似的像素合并成一个区域;
- 社交网络:找到最小的社交连接,将所有用户连通。
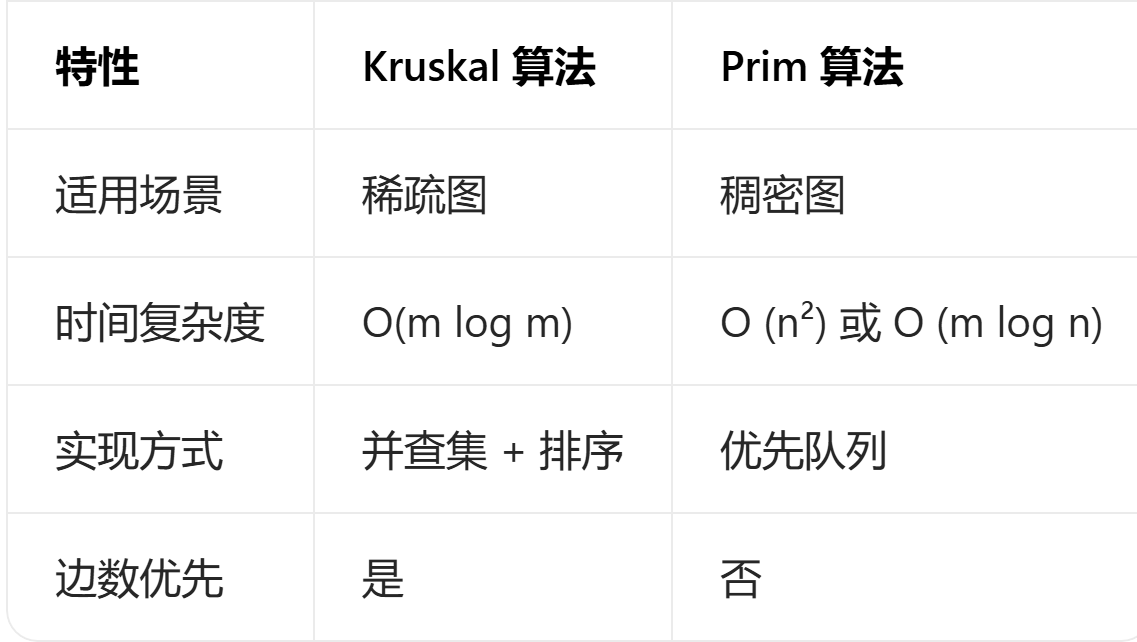
九、Kruskal 算法 vs Prim 算法
Kruskal 算法和 Prim 算法是两种最常用的最小生成树算法,它们的区别如下:
十、总结
Kruskal 算法是一种最小生成树算法,它通过每次选择最短的边,合并两个连通分量,直到所有节点都连通,最终得到一棵总权重最小的生成树。
Kruskal 算法的核心是并查集,它可以快速判断两个节点是否在同一个连通分量,以及合并两个连通分量。
在实际应用中,Kruskal 算法广泛应用于网络设计、集群计算、图像处理等领域,是一种非常基础且重要的算法。
希望这篇文章能帮助你理解 Kruskal 算法的原理和实现!