文章目录
前言
本专栏文章为《LeetCode 热题 100》的刷题题解,相关内容如有侵权,立即删除。
一、题目
1、原题链接
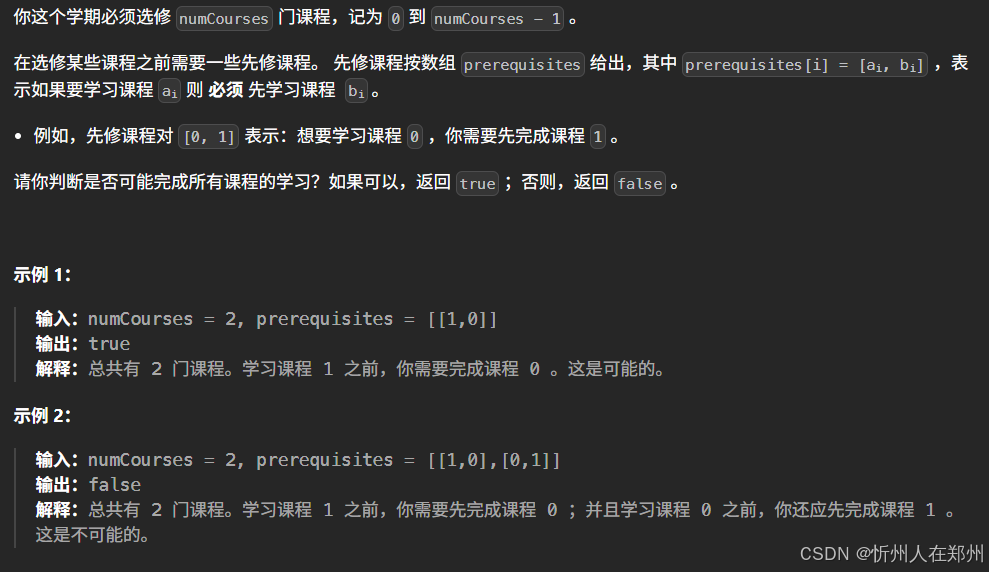
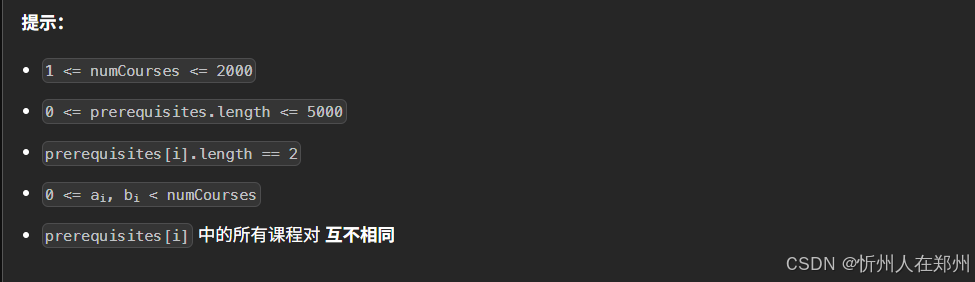
2、题目描述
二、个人思路整理
1、思路分析
思路1:广度优先搜索 BFS(Kahn 算法 / 入度表法)
核心逻辑:
- 构建图与统计入度:
- 每门课程对应一个节点。
- 对于每对先修关系 a i , b i a_i, b_i ai,bi(学 a i a_i ai 前必须先学 b i b_i bi),建立有向边 b i → a i b_i \to a_i bi→ai。
- 统计每个节点的入度(即有多少门先修课需要提前完成)。
- 初始化队列: 将所有入度为
0的节点(没有任何先修课的课程)推入队列。 - BFS 拓扑遍历:
- 每次从队列中取出一个课程节点,已修课程计数加 1。
- 遍历该课程的所有后继节点,将它们的入度减 1(表示前置依赖已解决)。
- 若某个后继节点的入度减为
0,将其加入队列。
- 判断结果: 若最终弹出的节点总数等于
numCourses,返回true;否则说明存在环,返回false。
思路2:深度优先搜索 DFS(三色标记法)
核心逻辑:
使用数组 visited 记录节点状态:
0(未访问):尚未遍历该节点。1(访问中):当前 DFS 路径上的祖先节点。如果 DFS 过程中再次遇到状态为1的节点,说明找到了环。2(已完成):以该节点为起点的所有路径均已遍历完毕且无环,后续若再次遍历到该节点可直接跳过。
2、解题代码
思路1:广度优先搜索 BFS(Kahn 算法 / 入度表法)
cpp
class Solution {
public:
    bool canFinish(int numCourses, vector<vector<int>>& prerequisites) {
        // 1. 定义邻接表与入度数组
        // adj[u] 存储所有依赖课程 u 的后续课程 v
        vector<vector<int>> adj(numCourses);
        // inDegree[v] 记录课程 v 的先修课程数量(入度)
        vector<int> inDegree(numCourses, 0);

        // 2. 构建有向图并统计入度
        // prerequisites 中的每一项为 [ai, bi],表示学习 ai 之前必须先修 bi(即存在有向边 bi -> ai)
        for (const auto& edge : prerequisites) {
            int course = edge[0];   // 目标课程
            int pre = edge[1];      // 先修课程
            adj[pre].push_back(course);
            inDegree[course]++;
        }

        // 3. 将所有入度为 0 的节点(即没有任何先修课要求的课程)加入队列
        queue<int> q;
        for (int i = 0; i < numCourses; i++) {
            if (inDegree[i] == 0) {
                q.push(i);
            }
        }

        // 4. 执行 BFS 拓扑排序
        int completed = 0;    // 记录成功修完的课程总数
        while (!q.empty()) {
            int curr = q.front();
            q.pop();
            completed++;

            // 遍历当前课程的所有后续课程
            for (int nextCourses : adj[curr]) {
                inDegree[nextCourses]--;     // 对应后继课程的先修依赖减1
                // 如果后继课程的所有先修课都已修完(入度为 0),则可以加入队列开始修读
                if (inDegree[nextCourses] == 0) {
                    q.push(nextCourses);
                }
            }
        }
        // 5. 判断是否能够修完所有课程:
        // 若修完的课程数等于总课程数,说明不存在环;否则说明图中存在换,无法全部完成
        return completed == numCourses;
    }
};
复杂度分析
- 时间复杂度:时间复杂度: O ( V + E ) O(V + E) O(V+E),其中 V = numCourses V = \text{numCourses} V=numCourses 为课程数, E = prerequisites.length E = \text{prerequisites.length} E=prerequisites.length 为依赖关系数。建图和遍历每个节点与边各一次。
- 空间复杂度: O ( V + E ) O(V + E) O(V+E),邻接表占用 O ( V + E ) O(V + E) O(V+E),入度表/状态数组及队列/递归栈占用 O ( V ) O(V) O(V)。
思路2:深度优先搜索 DFS(三色标记法)
cpp
class Solution {
public:
    // DFS 辅助函数:检测从节点 u 出发是否存在环
    // visited 状态说明:0 = 未访问,1 = 正在访问(当前 DFS 递归调用栈中),2 = 已安全访问完毕(无环)
    bool hasCycle(int u, const vector<vector<int>>& adj, vector<int>& visited) {
        // 将当前节点标记为 1 (正在访问)
        visited[u] = 1;

        for (int v : adj[u]) {
            // 如果遇到状态为 1 的后继几点,说明碰到了当前递归栈上的祖先节点,存在环
            if (visited[v] == 1) {
                return true;
            }
            // 如果遇到未访问的节点,继续深入递归;若发现环则向上直接返回 true
            if (visited[v] == 0 && hasCycle(v, adj, visited)) {
                return true;
            }
            // 若 visited[v] = 2, 说明该节点之前已验证过无环,直接跳过即可
        }
        // 当前节点的所有分支均已探索完毕且无环,标记为 2 (安全状态)
        visited[u] = 2;
        return false;
    }
    bool canFinish(int numCourses, vector<vector<int>>& prerequisites) {
        // 1. 构建邻接表:edge[1] -> edge[0](先修课程 -> 目标课程)
        vector<vector<int>> adj(numCourses);
        for (const auto& edge : prerequisites) {
            adj[edge[1]].push_back(edge[0]);
        }

        // 2. 初始化访问状态数组,初始全为 0(未访问)
        vector<int> visited(numCourses, 0);

        // 3. 遍历每一个节点作为起点进行 DFS 检测(处理图非连通的情况)
        for (int i = 0; i < numCourses; i++) {
            if (visited[i] == 0) {
                if (hasCycle(i, adj, visited)) {
                    return false;    // 检测到环,无法完成所有课程
                }
            }
        }

        // 4. 所有节点及分支均无环,可以完成所有课程
        return true;
    }
};
复杂度分析
- 时间复杂度:时间复杂度: O ( V + E ) O(V + E) O(V+E),其中 V = numCourses V = \text{numCourses} V=numCourses 为课程数, E = prerequisites.length E = \text{prerequisites.length} E=prerequisites.length 为依赖关系数。建图和遍历每个节点与边各一次。
- 空间复杂度: O ( V + E ) O(V + E) O(V+E),邻接表占用 O ( V + E ) O(V + E) O(V+E),入度表/状态数组及队列/递归栈占用 O ( V ) O(V) O(V)。
三、知识风暴
拓扑排序(Topological Sorting) 是本题的核心解法。课程之间的先修关系天然构成一张有向图,只有不存在环时才能完成全部课程。理解拓扑排序的两种实现(Kahn 算法与 DFS 三色标记法),对掌握本题至关重要。
算法核心思想:
- 有向图建模 :把每门课程看作一个节点,先修关系 a i , b i a_i, b_i ai,bi 建立有向边 b i → a i b_i \to a_i bi→ai,表示必须先学 b i b_i bi 才能学 a i a_i ai。
- 环检测本质 :若图中存在环,则环上的课程互为先修、永远无法开始,因此
canFinish的本质就是判断有向图是否无环(DAG)。 - 两种实现殊途同归 :BFS(Kahn 算法)通过不断删除入度为 0 的节点来拓扑排序;DFS 通过三色标记检测递归路径上是否出现回边。两者都能在 O ( V + E ) O(V+E) O(V+E) 内完成判断。
常见对比:BFS(Kahn 算法) vs DFS(三色标记法)
- BFS(Kahn 算法):从入度为 0 的节点出发,逐层"剥离"无依赖节点。若最终能处理的节点数等于总课程数,说明无环;否则存在环。实现直观,且天然给出一种合法的选课顺序。
- DFS(三色标记法) :从每个未访问节点出发递归遍历,用
0/1/2三色标记节点状态。若在递归栈上再次遇到状态为1的节点,说明存在环。适合处理图不连通的情况,代码更简洁。 - 共同点 :两者都只需遍历每个节点和每条边一次,时间复杂度均为 O ( V + E ) O(V+E) O(V+E)。区别在于 BFS 侧重"入度消减",DFS 侧重"路径回溯"。
"入度消减"标记思想:
- 核心思想:每修完一门先修课,就把所有依赖它的后继课程入度减 1。当某门课入度降为 0 时,说明它的所有先修课都已修完,可以入队开始修读。
- 与本题的联系 :
completed计数器记录已修完的课程数。若最终completed == numCourses,说明所有课程都能被安排;否则说明存在环,无法完成。 - 注意事项:入度减 1 的操作必须发生在"弹出先修课程"时,且只有当入度恰好减为 0 才入队,避免重复入队或漏掉依赖关系。
使用要点:
- 邻接表构建 :
adj[pre].push_back(course)建立先修课程到后继课程的映射,配合inDegree[course]++统计入度,是 Kahn 算法的标准建图方式。 - 队列初始化:第一轮把所有入度为 0 的课程全部入队,它们是没有先修依赖、可以立即开始的课程。
- 环的判定 :BFS 结束后若
completed != numCourses,说明有课程因环而永远无法入队;DFS 中遇到状态为1的节点则直接返回true表示有环。 - 图不连通的处理:DFS 解法中,外层循环遍历所有节点作为起点,确保非连通图(如多门独立课程)也能被完整检测。
算法变体与扩展:
- 课程表 II(LeetCode 210):在本题基础上要求输出一种具体的选课顺序,正是 Kahn 算法中节点出队的顺序,可加深对拓扑排序的理解。
- 课程表 III(LeetCode 630):引入每门课的截止时间与持续时间,转化为贪心 + 优先队列问题,是拓扑排序的进阶变体。
- 外星词典(LeetCode 269):根据单词顺序推断字母之间的先后关系,再通过拓扑排序判断字典序是否合法,是"隐式建图 + 拓扑排序"的经典应用。
- 项目管理(LeetCode 1203):在课程表基础上增加"组内/组间"两级依赖,需要先对组做拓扑排序再对组内排序,是拓扑排序的复杂综合应用。
相关 LeetCode 例题:
- 210. 课程表 II(拓扑排序输出具体顺序)
- 630. 课程表 III(贪心 + 优先队列)
- 269. 外星词典(隐式建图 + 拓扑排序)
- 1203. 项目管理(两级拓扑排序)